GPT-5.6 Sol vs Claude Opus 5: 2026년 AI 코딩 도구 성능, 요금, 통합 비교
- AI 코딩 시장은 GPT-5.6 Sol과 Claude Opus 5 / Fable 5를 중심으로 치열하게 경쟁하고 있습니다.
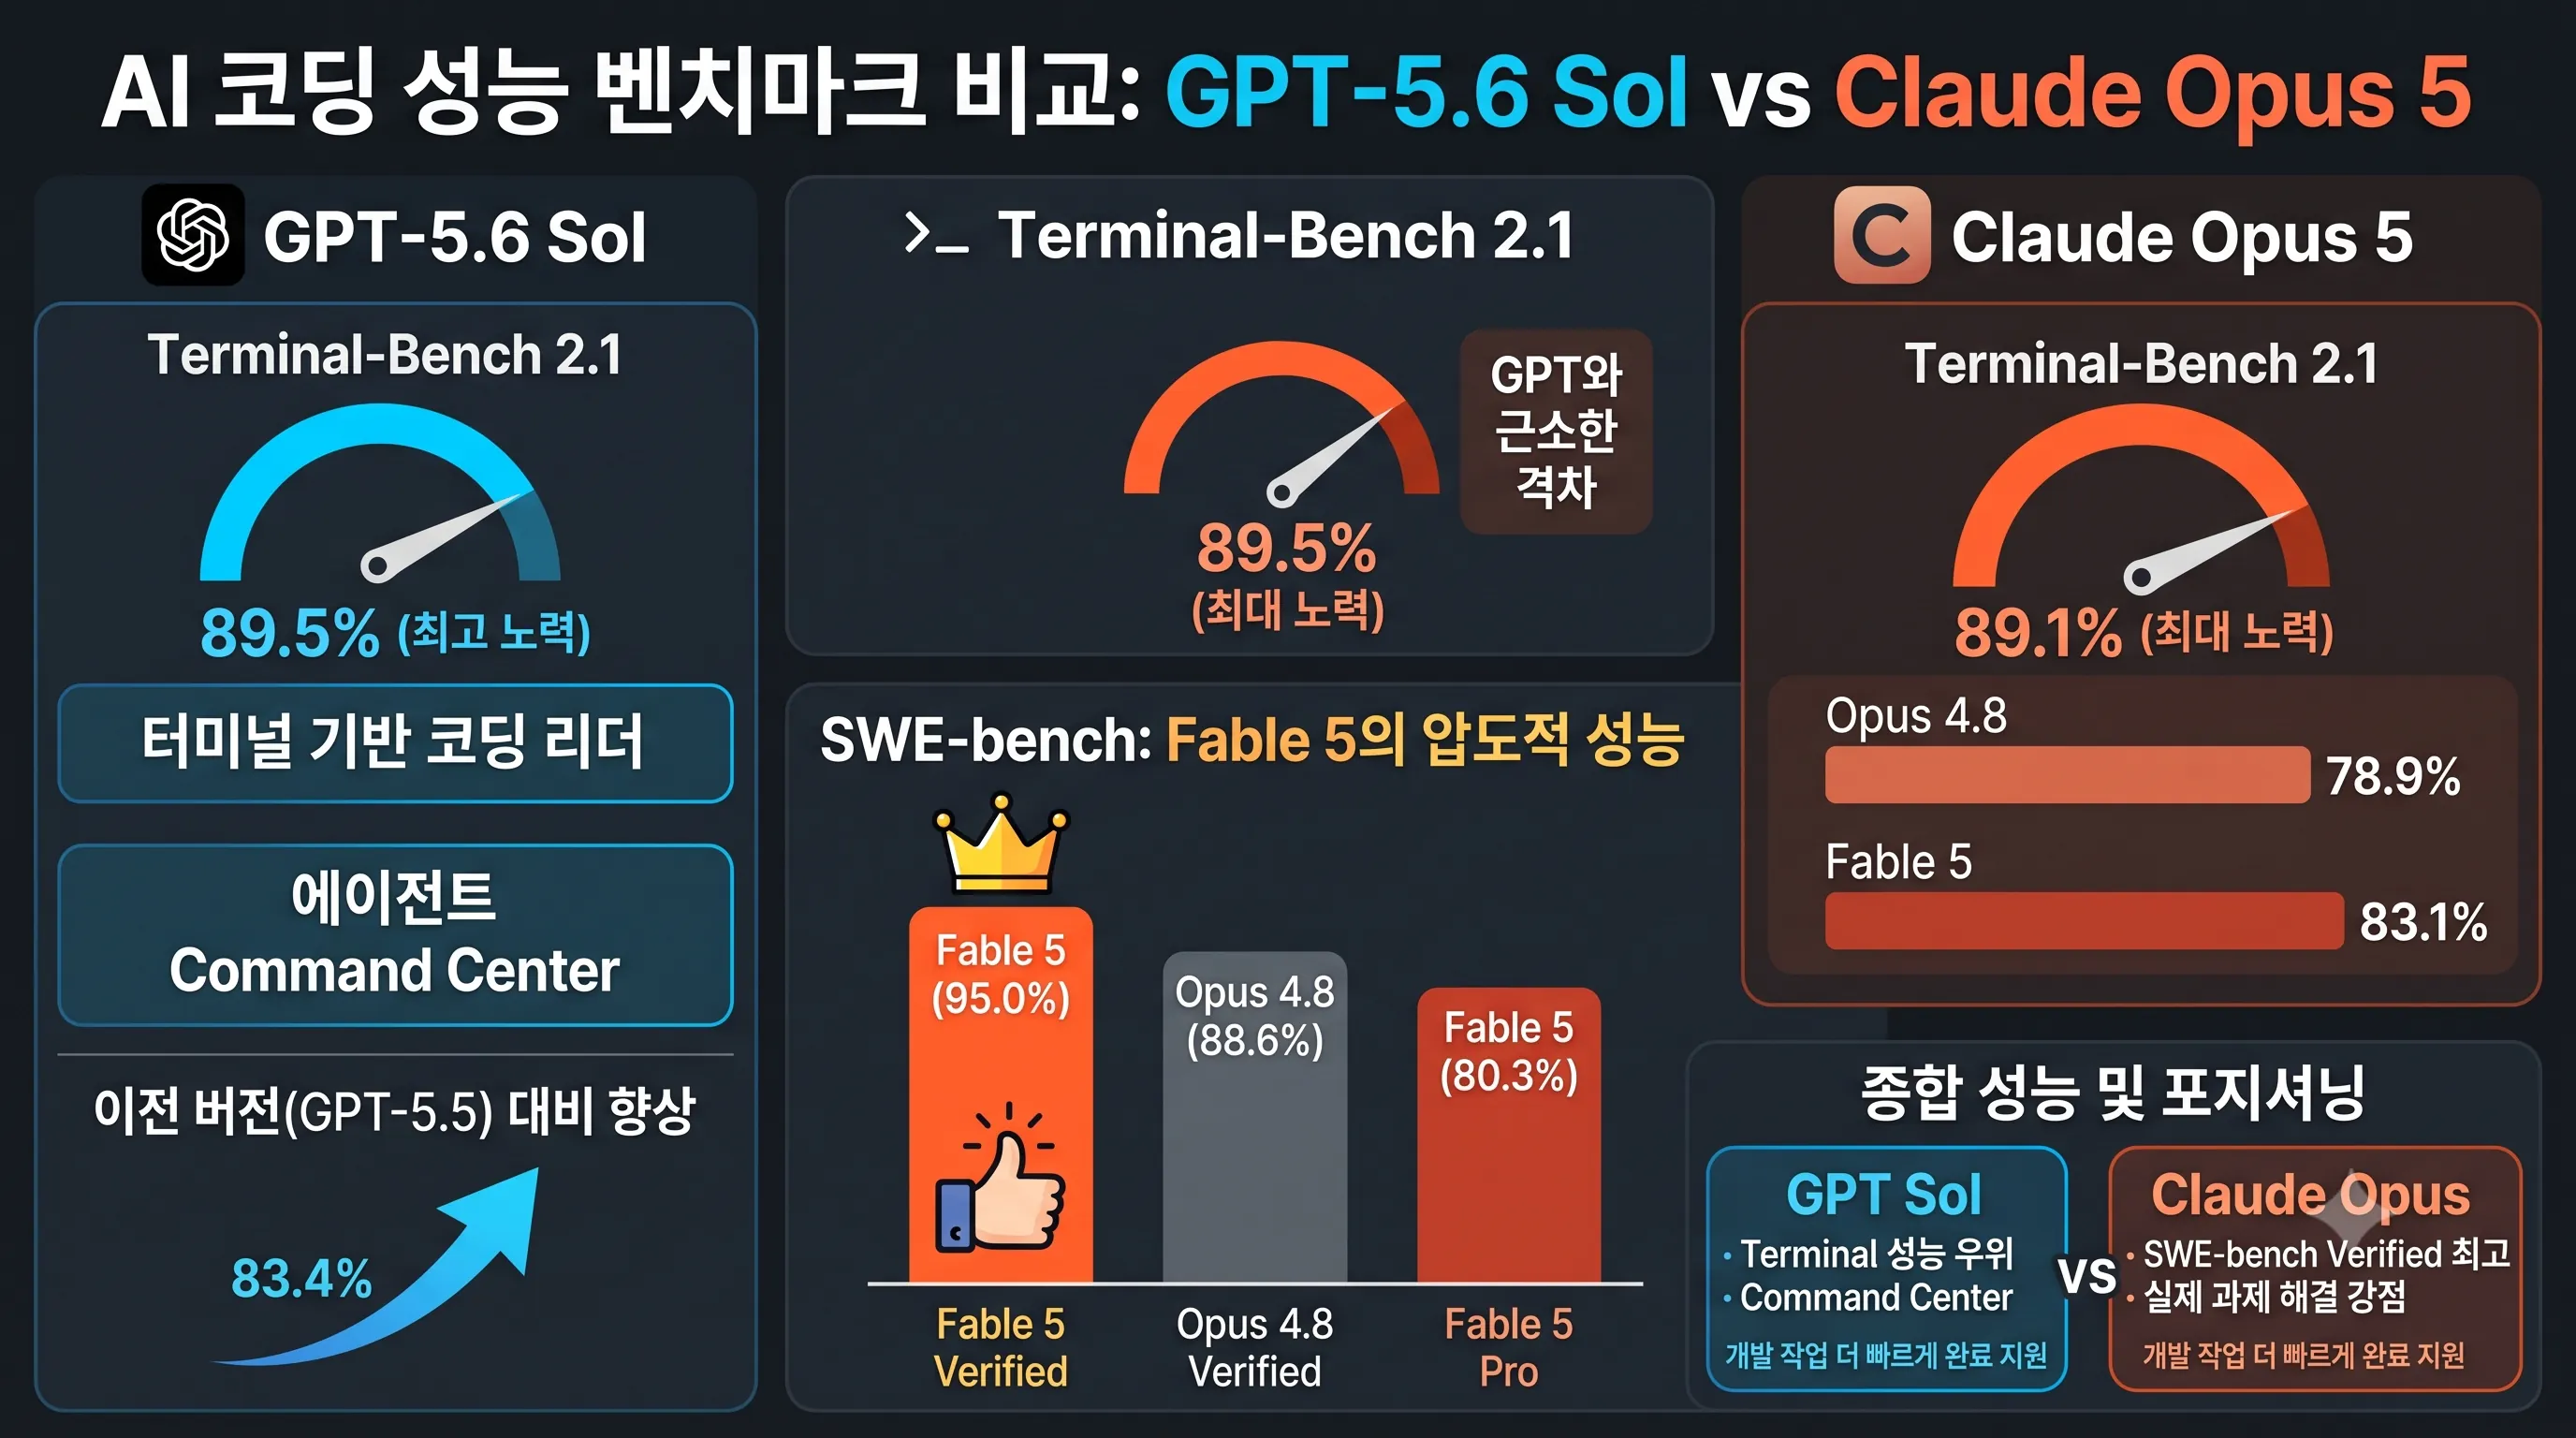
- Terminal-Bench 2.1에서 GPT-5.6 Sol은 89.5%로 선두를 달리고 있으며, Claude Opus 5는 89.1%로 근소한 차이를 보입니다.
- SWE-bench Verified에서는 Fable 5가 95.0%라는 압도적인 점수로 리더십을 확보했습니다.
- 월간 구독료는 개인 개발자 기준 월 $20부터 시작하며, GPT-5.6 Sol는 '5시간 창 제한'을, Claude Opus 5 / Fable 5는 '주간 시간 한도'로 사용량을 관리합니다.
- 주력 모델 1M 토큰당 비용은 GPT-5.6 Sol이 입력 $5/출력 $30, Claude Opus 5는 입력 $5/출력 $25, Fable 5는 입력 $10/출력 $50입니다.
- GPT-5.6 Sol는 CLI, IDE 확장, 웹 기반 클라우드 에이전트, iOS 앱 등 광범위한 서피스를 지원하며 'Agentic 코딩 Command Center'를 지향합니다.
- Claude Opus 5 / Fable 5는 3,000개 이상 MCP 통합 및 Amazon Bedrock, Google Vertex AI, Microsoft Foundry 연계를 통해 광범위한 플랫폼 접근성과 유연성을 강점으로 내세웁니다.
- 핵심 모델들은 1M 토큰 내외의 컨텍스트 창과 최대 128k 토큰 출력을 지원하며, GPT-5.6 Terra/Luna 및 Sonnet 5는 최근 가격 인하 또는 신규 출시되었습니다.
1. AI 코딩 성능 벤치마크 비교: GPT-5.6 Sol vs Claude Opus 5
AI 코딩 벤치마크 경쟁 구도
2026년 8월 현재, AI 코딩 도구 시장은 GPT-5.6 Sol과 Claude Opus 5를 필두로 치열한 성능 경쟁을 벌이고 있습니다.
이 두 모델은 개발 작업의 효율성을 극대화하기 위한 핵심적인 AI 모델로 평가받으며, 각각 Terminal-Bench 2.1과 SWE-bench와 같은 주요 벤치마크에서 인상적인 성과를 기록하고 있습니다.
특히 정량적인 벤치마크 점수를 통해 각 모델의 강점과 성능 진화 과정을 명확히 파악할 수 있습니다.
Terminal-Bench 2.1 점수 비교: 미세한 격차 속 리더십
Terminal-Bench 2.1은 AI 코딩 어시스턴트의 터미널 기반 성능을 측정하는 주요 벤치마크로, 두 핵심 모델의 경쟁 구도를 선명하게 보여줍니다.
현재 GPT-5.6 Sol은 89.5%라는 높은 점수(xhigh effort 기준)로 이 벤치마크에서 리더의 자리를 차지하고 있습니다.
이는 'Agentic 코딩을 위한 Command Center'로서의 역할과 '최고의 Terminal-Bench 점수'라는 평가를 뒷받침하는 수치입니다.
반면, 2026년 7월 24일부터 기본 모델로 제공되고 있는 Claude Opus 5는 최대 노력(max effort) 기준으로 89.1%를 기록하며 GPT-5.6 Sol과 매우 근소한 차이로 경쟁하고 있습니다.
이러한 수치는 두 모델 모두 터미널 환경에서 고도의 코딩 지원 능력을 제공함을 시사합니다.
이전 버전과의 비교를 통해 성능 진화 과정도 확연히 드러납니다.
GPT-5.5는 83.4%를 기록했으며, Opus 4.8은 78.9% (±2.5)에 머물렀습니다.
또한 Claude의 다른 모델인 Fable 5는 Terminal-Bench 2.1에서 83.1%의 점수를 보였습니다.
이는 지난 1년여간 AI 코딩 모델의 터미널 벤치마크 성능이 크게 향상되었음을 보여주는 중요한 지표입니다.
SWE-bench의 리더: Fable 5의 압도적 성능
코딩 도구의 실제 소프트웨어 엔지니어링 작업 해결 능력을 평가하는 SWE-bench에서는 Claude 진영의 Fable 5 모델이 독보적인 리더십을 발휘하고 있습니다.
2026년 7월 1일부터 재이용이 가능해진 Fable 5는 SWE-bench Verified에서 95.0%라는 경이로운 점수를 기록하며 이 분야의 선두를 굳건히 지키고 있습니다.
이는 Fable 5가 'SWE-bench에서 가장 강력한 모델'이라는 평가를 받는 핵심적인 이유입니다.
또한 SWE-bench Pro에서도 80.3%의 높은 점수를 기록하며 그 역량을 입증했습니다.
이전 버전인 Opus 4.8은 SWE-bench Verified에서 88.6%, SWE-bench Pro에서 69.2%를 기록했습니다.
이러한 수치는 Fable 5가 복잡하고 실제적인 소프트웨어 개발 과제 해결에 있어 이전 세대 모델들을 훨씬 뛰어넘는 성능을 제공함을 나타냅니다.
현재 GPT-5.6 Sol의 SWE-bench 점수는 JSON 데이터에 직접적으로 명시되어 있지 않으나, Claude 계열의 Fable 5가 이 벤치마크에서 강력한 우위를 점하고 있다는 사실은 주목할 만합니다.
종합 성능 분석 및 시장 포지셔닝
종합적으로 볼 때, GPT-5.6 Sol은 Terminal-Bench 2.1에서 89.5%로 선두를 달리고 있으며, 터미널 기반의 에이전트 코딩 환경에서 강력한 성능을 제공하는 'Command Center'로서의 입지를 공고히 하고 있습니다.
반면 Claude Opus 5는 Terminal-Bench 2.1에서 89.1%로 GPT-5.6 Sol에 근접하는 우수한 성능을 보여주고 있으며, 특히 Fable 5를 통해 SWE-bench에서 95.0%라는 압도적인 점수로 실제 개발 과제 해결 능력에서 최강자의 면모를 과시합니다.
두 모델 모두 '개발 작업 더 빠르게 완료 지원'이라는 공통된 사용자 혜택을 제공하며, 각자의 강점을 바탕으로 2026년 개발자 도구 시장을 지배하는 핵심 플레이어로서 자리매김하고 있습니다.
이러한 벤치마크 결과는 개발자들이 특정 작업에 더 적합한 AI 코딩 도구를 선택하는 데 중요한 기준이 될 것입니다.
2. 개발자 예산 가이드: 요금제 및 토큰 사용량 한도 심층 분석
개발자 예산 가이드: 요금제 개요 및 월간 구독료 비교
2026년 8월 24일 현재, 개발 도구 시장을 선도하는 두 주요 플레이어인 GPT-5.6 Sol와 Claude Opus 5 / Fable 5는 각기 다른 요금제 구조와 사용량 한도를 제시하며 개발자들의 예산 책정에 중요한 고려 사항을 제공하고 있습니다.
| 서비스 | 요금제 | 월간 구독료 | 비고 |
|---|---|---|---|
| GPT-5.6 Sol | ChatGPT Plus | $20 | 개인 개발자용 |
| GPT-5.6 Sol | Pro 5x | $100부터 | 팀 및 기업 사용자용 |
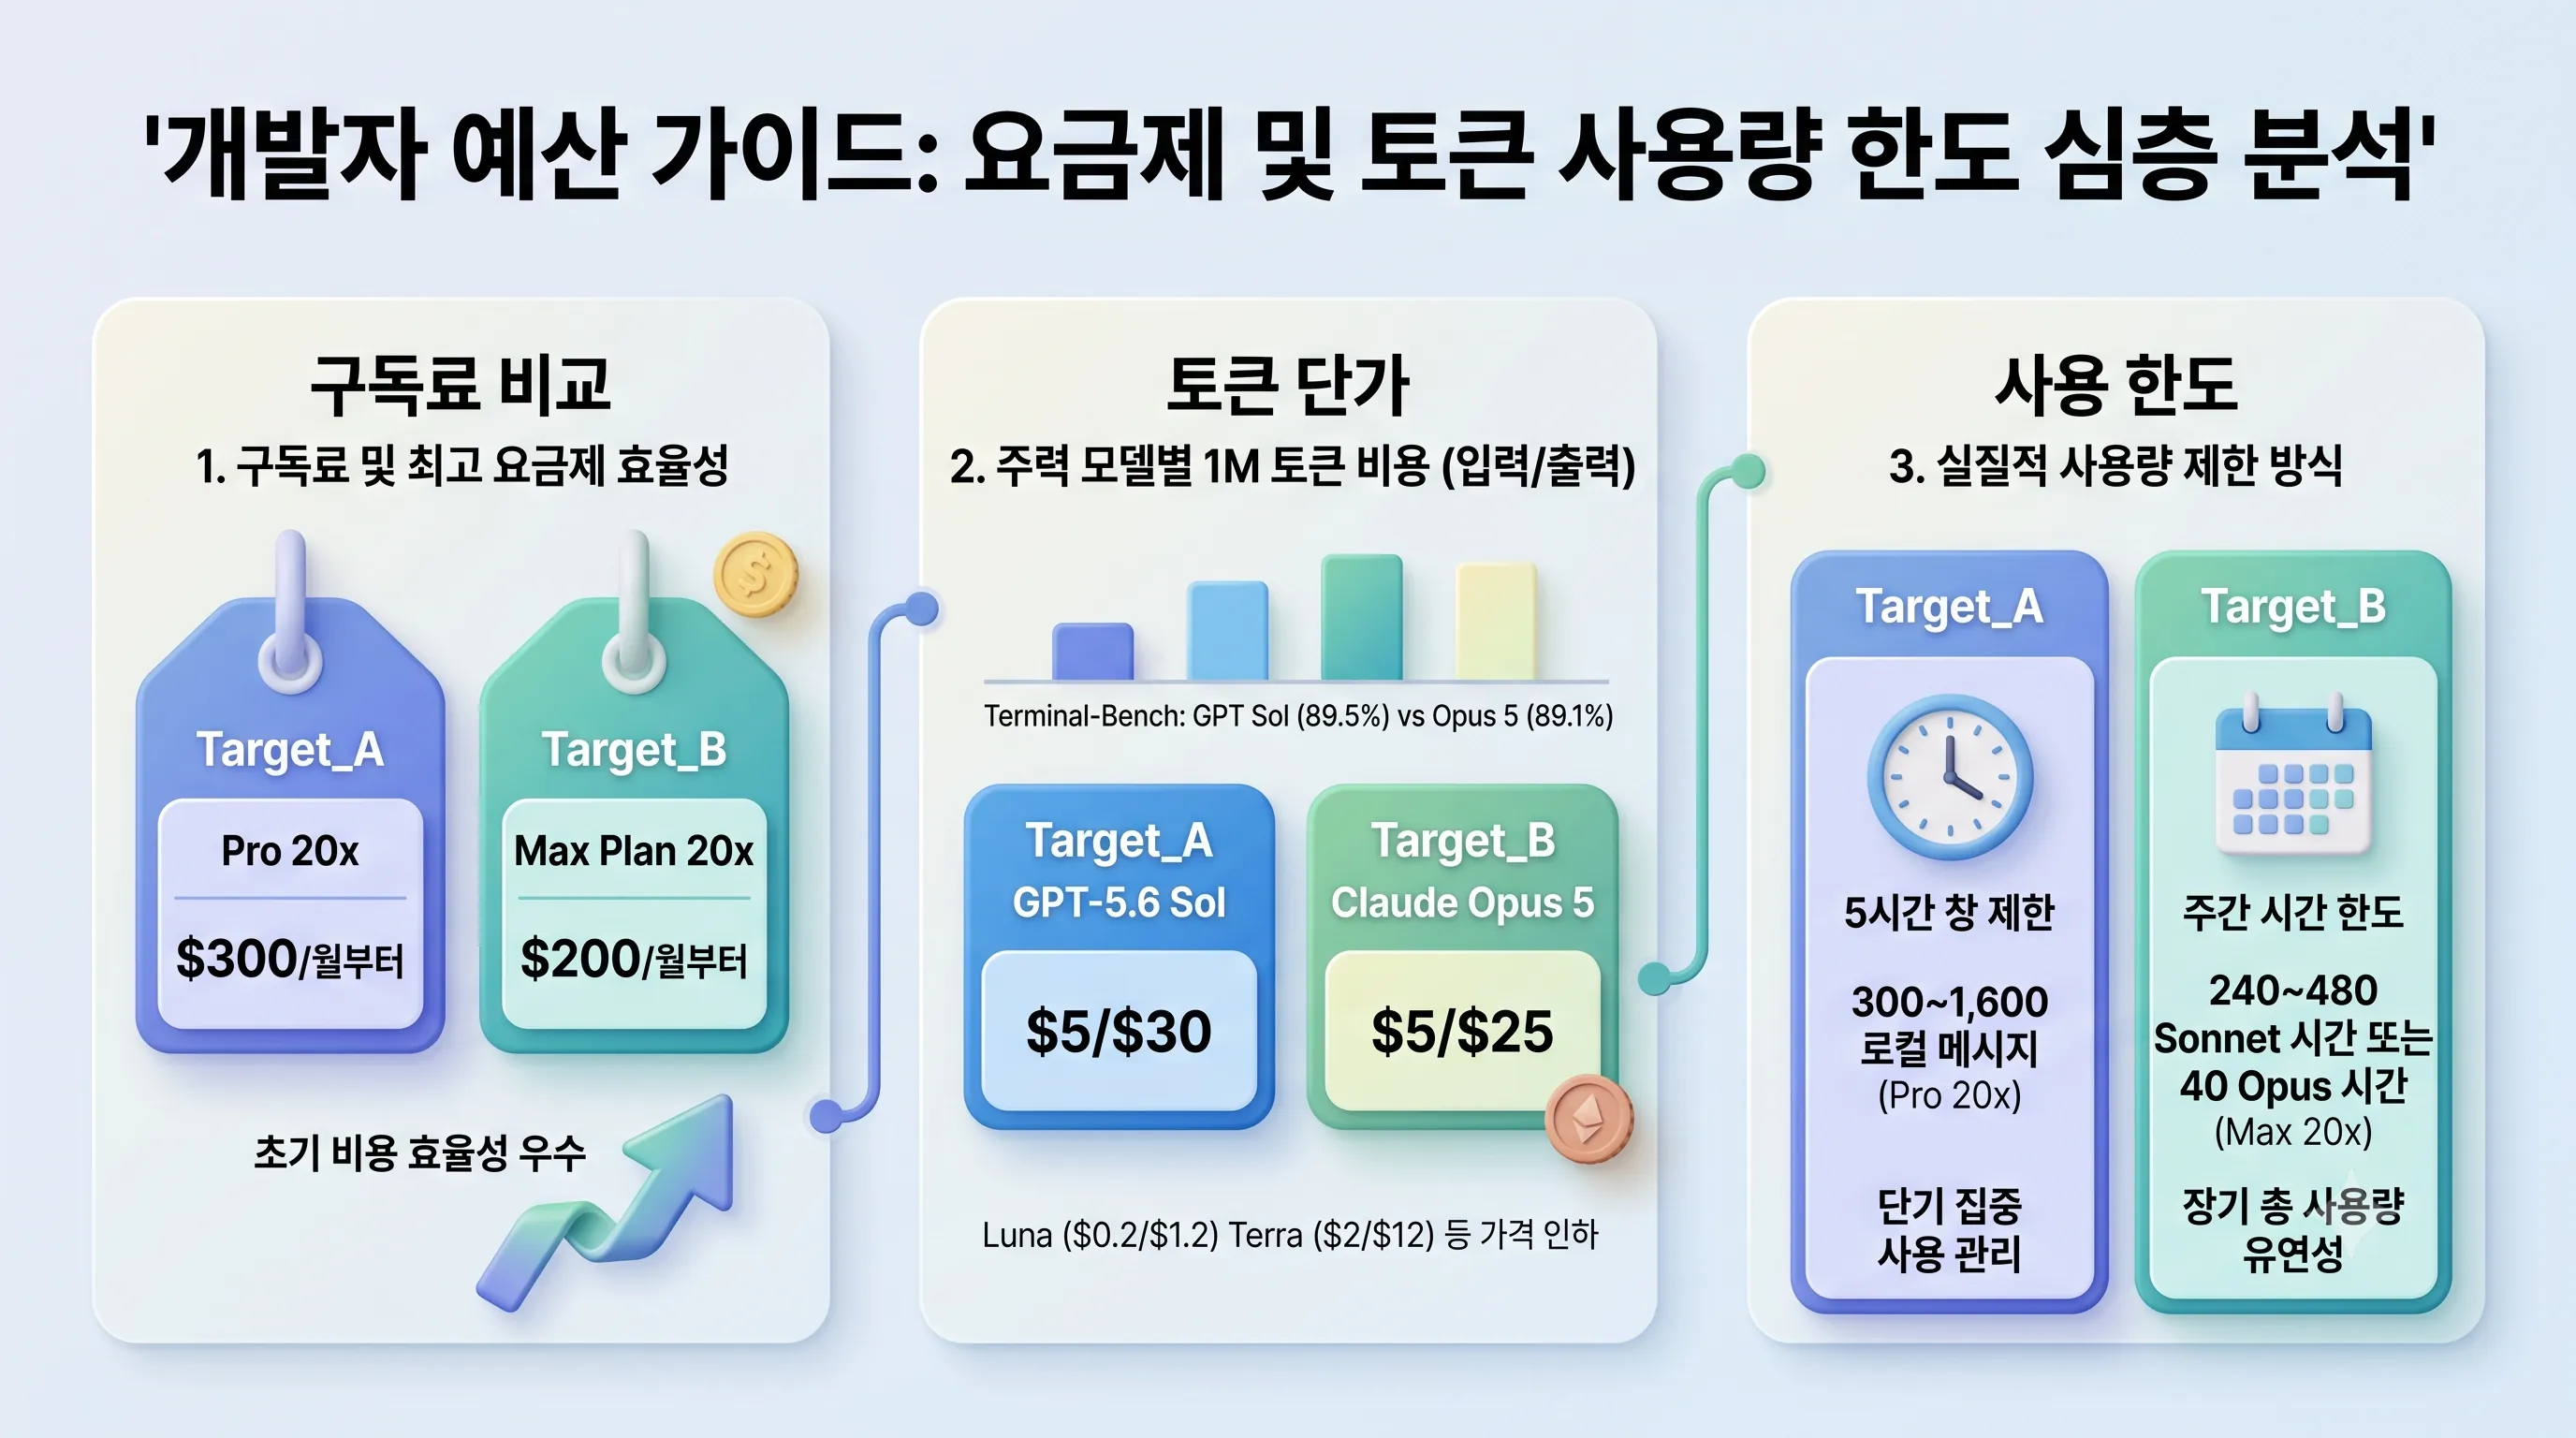
| GPT-5.6 Sol | Pro 20x | $300부터 | 팀 및 기업 사용자용 |
| GPT-5.6 Sol | Business Plan | 종량제 | Plus 레벨 제한 |
| GPT-5.6 Sol | Enterprise Plan | 고정 요금 | 제한 없음 |
| Claude Opus 5 / Fable 5 | Pro Plan | $20 | (연간 선불 시 $17/$200 선불) |
| Claude Opus 5 / Fable 5 | Max Plan 5x | $100부터 | 고급 사용자 및 팀 |
| Claude Opus 5 / Fable 5 | Max Plan 20x | $200부터 | 고급 사용자 및 팀 (GPT-5.6 Sol Pro 20x 대비 초기 비용 효율성 강조) |
특히 최고 사양 요금제인 'Max Plan 20x'의 경우, Claude Opus 5 / Fable 5가 월 $200부터 시작하여 GPT-5.6 Sol의 'Pro 20x'의 월 $300부터보다 상대적으로 낮은 초기 비용으로 더 높은 수준의 서비스를 제공할 수 있다는 점은 예산 효율성을 고려하는 개발팀에게 중요한 비교 지점이 될 수 있습니다.
또한 GPT-5.6 Sol는 종량제 방식의 'Business Plan' (Plus 레벨 제한)과 고정 요금으로 제한 없는 'Enterprise Plan'을 별도로 운영하고 있습니다.
주력 모델별 1M 토큰당 입/출력 비용 심층 분석
개발 예산에서 가장 큰 비중을 차지할 수 있는 부분은 바로 AI 모델의 토큰 사용량에 따른 비용입니다.
| 서비스 | 모델 | 입력 (1M 토큰당) | 출력 (1M 토큰당) | 비고 |
|---|---|---|---|---|
| GPT-5.6 Sol | GPT-5.6 Sol | $5 | $30 | 가장 강력한 모델 |
| GPT-5.6 Sol | GPT-5.6 Terra | $2 | $12 | 2026년 7월 30일 가격 인하 적용, 효율성 중심 |
| GPT-5.6 Sol | GPT-5.6 Luna | $0.20 | $1.20 | 2026년 7월 30일 가격 인하 적용, 가장 경제적 |
| Claude Opus 5 / Fable 5 | Claude Opus 5 | $5 | $25 | 2026년 7월 24일부터 기본 모델 |
| Claude Opus 5 / Fable 5 | Fable 5 | $10 | $50 | SWE-bench Verified 리더 (95.0%), 최고 단가 |
| Claude Opus 5 / Fable 5 | Sonnet 5 | $2 | $10 | 2026년 6월 30일 출시, 표준 요금 모델 |
두 서비스의 주력 모델별 토큰 단가를 비교해 보면, GPT-5.6 Sol의 GPT-5.6 Sol (입력 $5 / 출력 $30)과 Claude Opus 5 / Fable 5의 Claude Opus 5 (입력 $5 / 출력 $25)는 입력 단가는 동일하지만 출력 단가에서 Claude Opus 5 / Fable 5가 다소 저렴한 것을 알 수 있습니다.
고성능 모델 중에서는 GPT-5.6 Sol의 GPT-5.6 Terra (입력 $2 / 출력 $12)가 Claude Opus 5 / Fable 5의 Sonnet 5 (입력 $2 / 출력 $10)와 유사한 입력 단가에 출력 단가는 다소 높은 편입니다.
반면, 최고 성능을 요구하는 작업에서는 GPT-5.6 Sol의 GPT-5.6 Sol과 Claude Opus 5 / Fable 5의 Fable 5를 비교할 수 있으며, Fable 5가 훨씬 높은 단가(입력 $10 / 출력 $50)를 책정하고 있어 특정 전문 작업에 대한 가치를 반영하고 있습니다.
개발자는 자신의 작업 특성과 필요한 AI 모델의 성능 수준을 면밀히 검토하여 가장 비용 효율적인 모델을 선택해야 합니다.
예를 들어, Terminal Bench 2.1 점수에서 GPT-5.6 Sol의 GPT-5.6 Sol이 89.5%를 기록하며 리더 위치를 확보하고 있으며, Claude Opus 5 / Fable 5의 Claude Opus 5 또한 89.1%를 기록하며 비슷한 수준의 성능을 제공하는 것으로 나타났습니다.
실질적 사용 한도 심층 비교: '5시간 창 제한'과 '주간 시간 한도'
요금제 선택 시 월정액과 토큰 비용만큼 중요한 것이 바로 '사용량 한도'입니다.
두 서비스는 서로 다른 방식으로 사용량 제한을 두어 개발자들의 실제 워크플로우에 영향을 미칩니다.
| 서비스 | 요금제 | 사용량 한도 | 비고 |
|---|---|---|---|
| GPT-5.6 Sol | ChatGPT Plus | 5시간 창 제한: 15~80 로컬 메시지, 5 클라우드 태스크, 5 코드 리뷰 | 단기 집중 사용 관리 |
| GPT-5.6 Sol | Pro 5x | 5시간 창 제한: 80~400 로컬 메시지 | |
| GPT-5.6 Sol | Pro 20x | 5시간 창 제한: 300~1,600 로컬 메시지 | |
| Claude Opus 5 / Fable 5 | Pro Plan | 주당 약 40~80 Sonnet 시간 | 장기 총 사용량 관리 |
| Claude Opus 5 / Fable 5 | Max Plan 5x | 주당 약 140~280 Sonnet 시간 | |
| Claude Opus 5 / Fable 5 | Max Plan 20x | 주당 약 240~480 Sonnet 시간 또는 약 40 Opus 시간 |
GPT-5.6 Sol는 '5시간 창 메시지/태스크 제한'이라는 독특한 방식을 채택하고 있습니다.
이는 5시간의 롤링 창(rolling window) 내에서 사용 가능한 메시지 또는 태스크의 총량에 제한을 두는 방식입니다.
'ChatGPT Plus' 요금제의 경우, 15~80개의 로컬 메시지, 5개의 클라우드 태스크, 5개의 코드 리뷰로 제한됩니다.
상위 요금제인 'Pro 5x'는 80~400개의 로컬 메시지, 'Pro 20x'는 300~1,600개의 로컬 메시지를 5시간 창 내에서 사용할 수 있습니다.
이러한 제한은 단시간 내에 집중적으로 많은 요청을 보내는 것을 통제하며, 사용자가 꾸준히 작업을 이어갈 수 있도록 유도합니다.
특히 '클라우드 태스크'와 '코드 리뷰'에 대한 제한은 GPT-5.6 Sol의 핵심 기능인 'Fire-and-forget 클라우드 태스크'를 활용하는 빈도에 직접적인 영향을 미칩니다.
만약 5시간 이내에 주어진 한도를 초과하면, 추가 사용을 위해 해당 창이 만료될 때까지 기다려야 할 수 있습니다.
반면 Claude Opus 5 / Fable 5는 '주간 Sonnet 시간 한도'라는 방식으로 사용량 제한을 둡니다.
이는 일주일이라는 기간 동안 특정 모델(주로 Sonnet)을 사용할 수 있는 총 시간(또는 그에 상응하는 사용량)에 상한선을 두는 방식입니다.
'Pro Plan' 사용자는 주당 약 40~80 Sonnet 시간을 사용할 수 있습니다.
'Max Plan 5x'는 주당 약 140~280 Sonnet 시간으로 대폭 증가하며,
최상위 요금제인 'Max Plan 20x'는 주당 약 240~480 Sonnet 시간 또는 약 40 Opus 시간을 제공합니다.
이러한 '주간 시간 한도'는 Claude Opus 5 / Fable 5의 강점 중 하나인 '자율 세션 길이'를 고려할 때 더욱 유연하게 해석될 수 있습니다.
사용자는 한 주 동안의 총 사용량을 계획하여 필요한 시점에 집중적으로 사용하거나, 분산하여 사용할 수 있습니다.
특히 'Max Plan 20x'에서 Opus 모델 사용 시간이 별도로 할당되는 점은 최고 성능의 모델 사용이 필요한 개발자에게 중요한 메리트입니다.
하지만 주간 한도를 초과할 경우, 다음 주까지 기다리거나 추가 요금제를 고려해야 할 수 있습니다.
두 방식의 실질적인 차이점을 요약하자면, GPT-5.6 Sol의 '5시간 창 제한'은 단기적인 버스트 사용을 관리하는 데 중점을 둡니다.
이는 특정 시간 동안 과도한 API 호출이나 메시지 전송을 방지하고, 모든 사용자가 안정적인 서비스를 이용하도록 보장하는 데 목적이 있습니다.
반면 Claude Opus 5 / Fable 5의 '주간 시간 한도'는 장기적인 총 사용량을 관리하는 데 중점을 둡니다.
이는 개발자가 일주일 단위로 자신의 워크플로우를 계획하고, 필요한 경우 주중 특정 시점에 더 많은 리소스를 할당할 수 있는 유연성을 제공합니다.
개발팀의 작업 방식(단시간 내 집중적 사용 vs. 주 단위로 분산된 사용)과 필요한 AI 모델의 성능 수준을 고려하여 어떤 제한 방식이 더 적합한지 판단하는 것이 중요합니다.
개발자별 예산 가이드라인: 최적의 선택을 위한 고려사항
결론적으로, 개발자 예산 가이드의 핵심은 단순히 가장 저렴한 요금제를 선택하는 것이 아니라, 자신의 개발 환경과 작업 특성에 맞는 최적의 효율성을 찾는 것입니다.
만약 개발 작업의 빈도가 높고, 짧은 시간 내에 여러 번의 메시지 교환이나 클라우드 태스크 실행이 필요한 경우 GPT-5.6 Sol의 '5시간 창 제한'이 제약으로 느껴질 수 있습니다.
반면, 긴 코드를 처리하거나 자율적인 AI 세션이 필요한 경우, Claude Opus 5 / Fable 5의 '자율 세션 길이'와 '주간 시간 한도'가 더 큰 자유도를 제공할 수 있습니다.
특히 Claude Opus 5 / Fable 5는 '3,000+ MCP 통합'과 '긴 컨텍스트 작업(1M 토큰)에 적합'하다는 강점을 가지고 있어, 대규모 프로젝트나 복잡한 시스템 통합을 수행하는 개발자에게 유리할 수 있습니다.
GPT-5.6 Sol는 '최고의 Terminal-Bench 점수'와 'Fire-and-forget 클라우드 태스크' 기능을 통해 에이전틱 코딩 워크플로우를 지원하는 데 강점을 보입니다.
따라서 개발팀은 월간 구독료, 1M 토큰당 비용, 그리고 실질적인 사용량 제한 방식 외에도 각 서비스가 제공하는 핵심 기능과 성능 지표(예: Terminal Bench 2.1 점수, SWE-bench 점수)를 종합적으로 고려하여 예산을 책정하고 최적의 AI 개발 도구를 선택해야 합니다.
3. 워크플로우 통합 및 확장성: IDE 연동부터 클라우드 연계까지
전반적인 개발 환경 지원 범위와 통합 전략
최신 AI 기반 개발 도구들은 개발자의 다양한 작업 환경에 얼마나 유연하게 통합될 수 있는지가 핵심 경쟁력으로 부상하고 있다.
GPT-5.6 Sol와 Claude Opus 5 / Fable 5는 모두 CLI(Command Line Interface), IDE(Integrated Development Environment) 확장 프로그램, 그리고 독립형 데스크톱 애플리케이션 등 개발자가 실제 코딩 작업을 수행하는 주요 환경들을 지원하며 넓은 접점을 확보하고 있다.
특히 GPT-5.6 Sol는 CLI 외에도 VS Code, Cursor, Windsurf와 같은 주요 IDE에 확장 기능을 제공하며, 웹 기반의 클라우드 에이전트(chatgpt.com/codex)와 iOS 모바일 앱까지 지원하여 가장 광범위한 서피스를 아우르는 전략을 취하고 있다.
이는 개발자가 어떤 기기나 환경에 있든 GPT-5.6 Sol의 강력한 AI 코딩 모델과 워크플로우를 활용할 수 있도록 돕는다는 점에서 주목할 만하다.
반면 Claude Opus 5 / Fable 5는 Shell 환경과 VS Code, JetBrains 등 주력 IDE 연동을 통해 개발 생산성을 높이는 데 집중하고 있으며, macOS 및 Windows 데스크톱 앱을 통해 운영체제 전반에 걸친 지원을 강화하고 있다.
이러한 방식은 개발자가 주로 사용하는 핵심 도구와의 심층적인 통합을 통해 안정적인 개발 경험을 제공하는 데 중점을 둔다.
GPT-5.6 Sol의 에이전트 기반 워크플로우 통합: Worktrees와 클라우드 환경
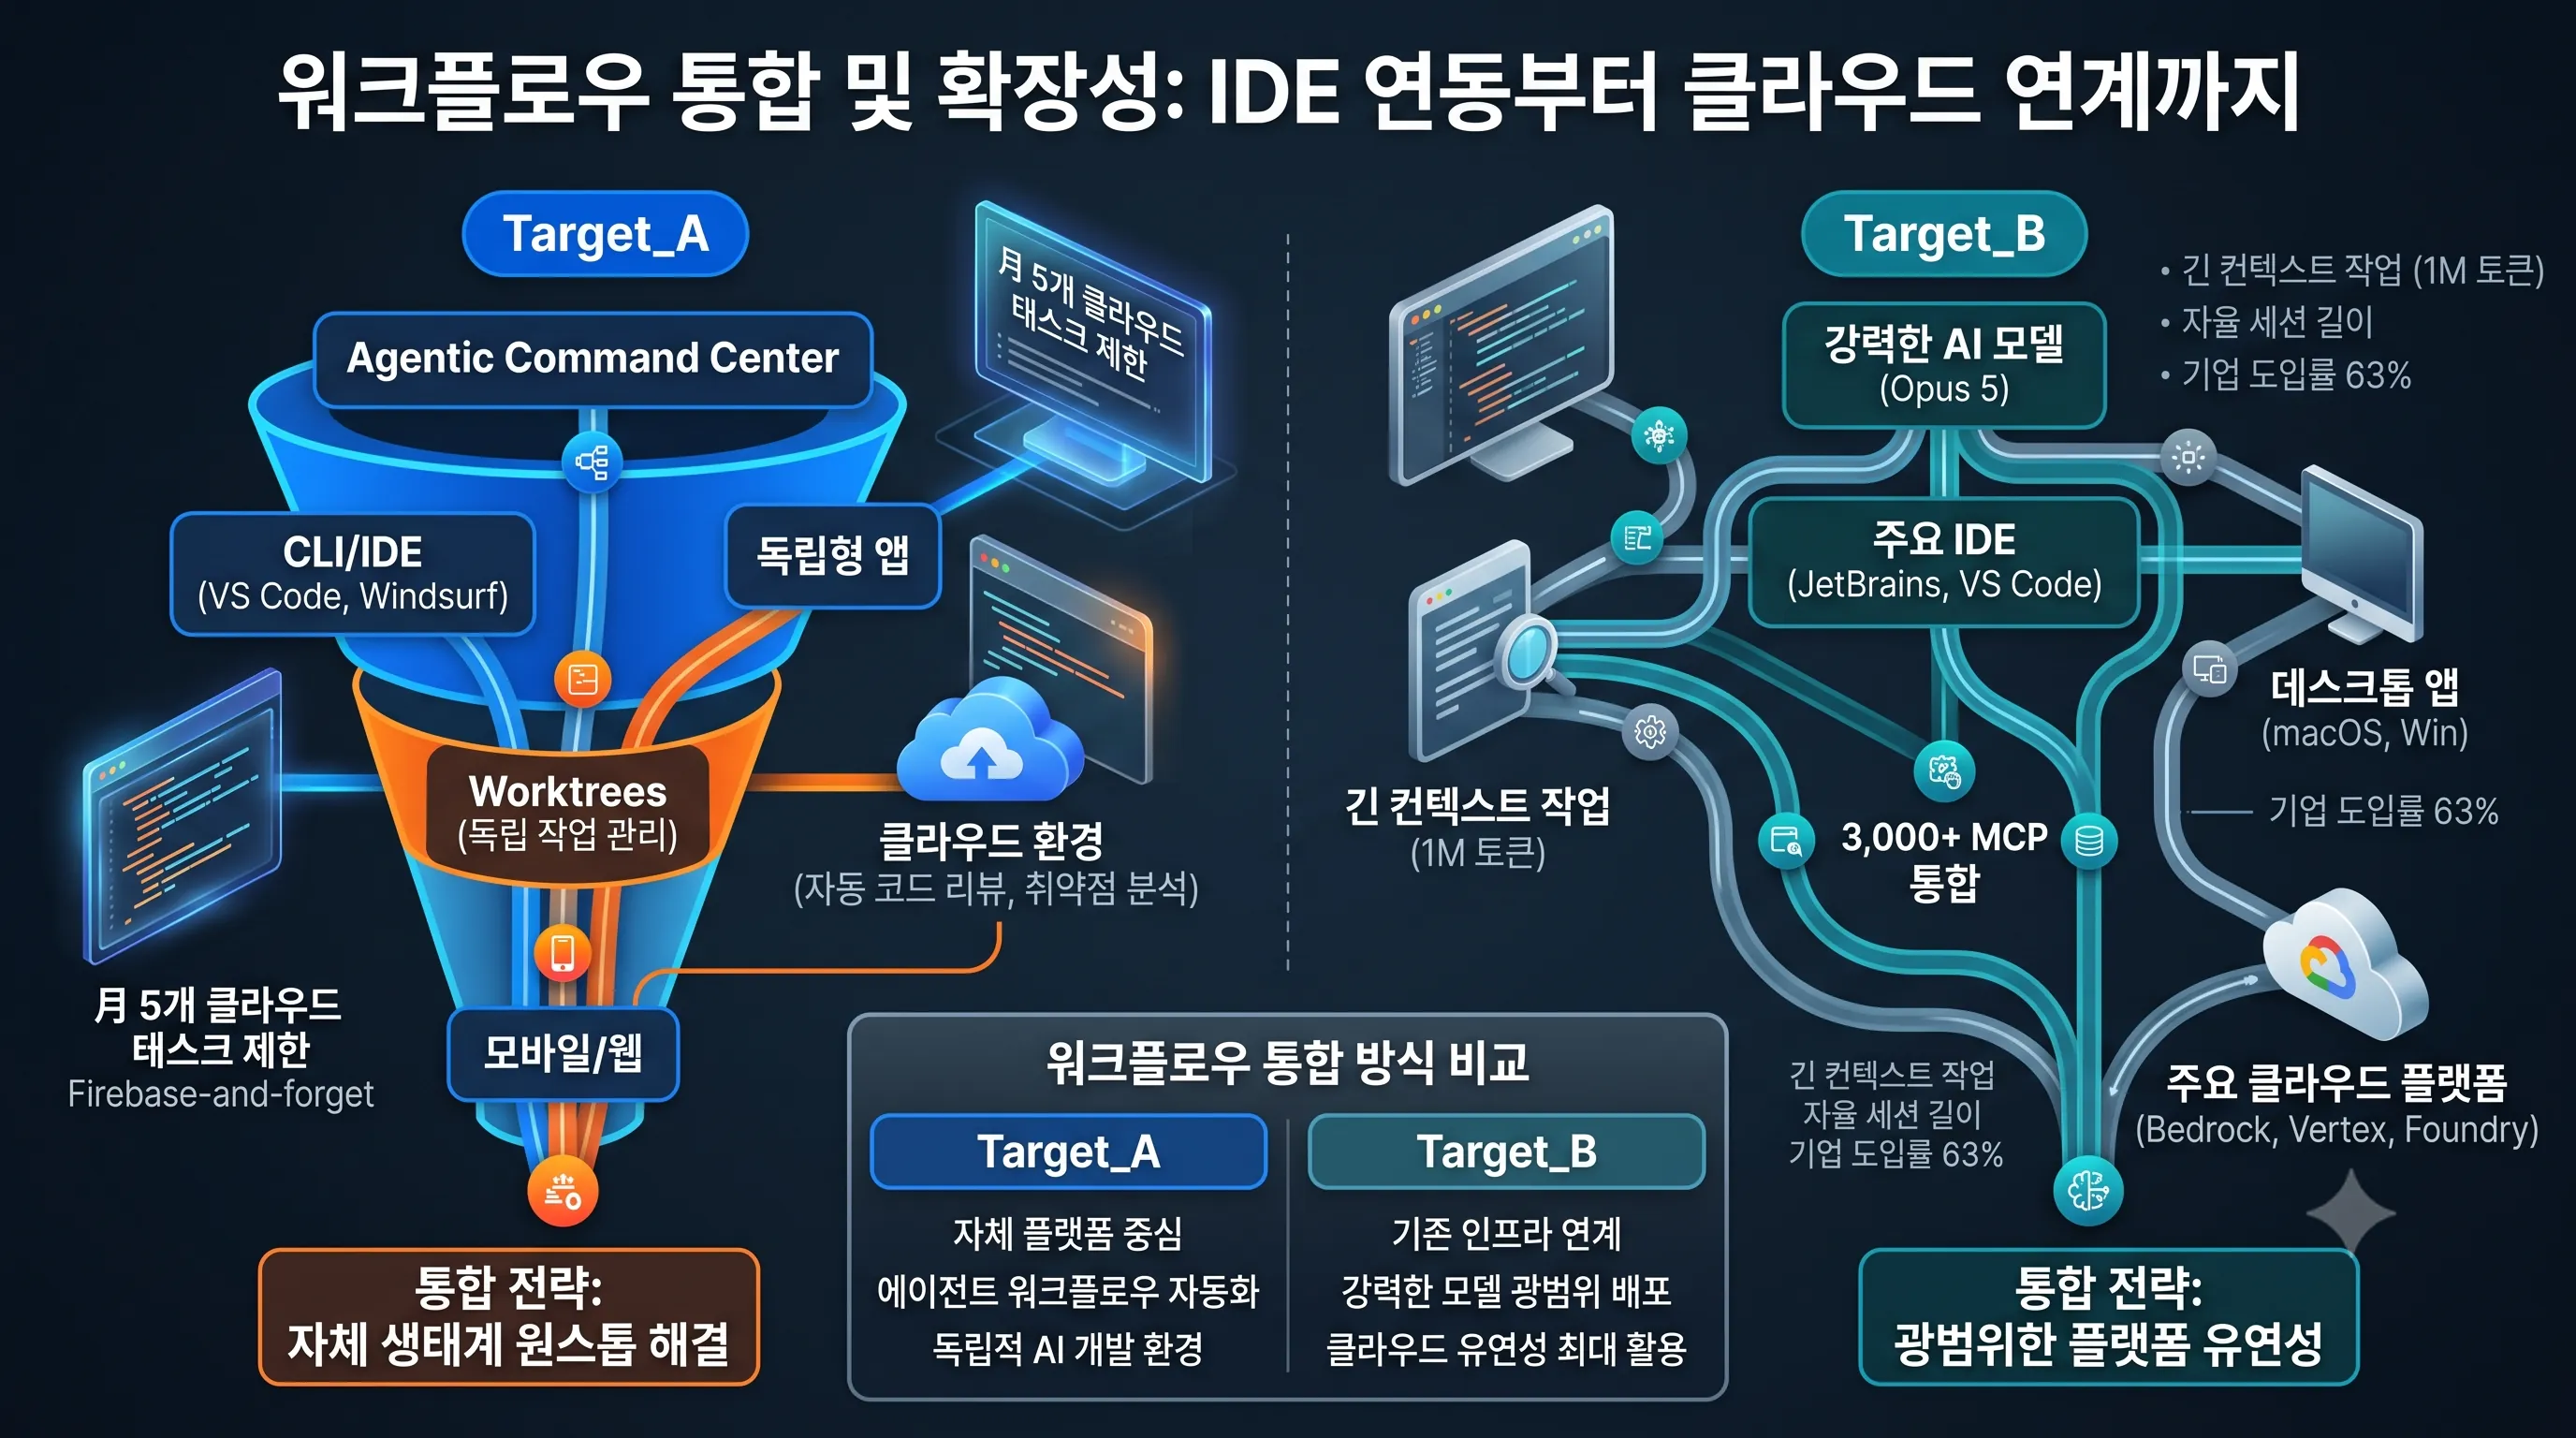
GPT-5.6 Sol의 워크플로우 통합 및 확장성 전략의 핵심은 'Agentic 코딩을 위한 Command Center'로서의 역할에 있다.
이 도구는 개발 워크플로우 전반에 걸쳐 병렬 작업을 지원하며, 개발자가 복잡한 작업을 보다 효율적으로 관리할 수 있도록 설계되었다.
특히 '내장 Worktrees' 기능은 여러 코드 변경 사항을 동시에 관리해야 하는 개발자에게 상당한 이점을 제공한다.
Git Worktrees와 유사하게, 개발자는 주 프로젝트 브랜치에 영향을 주지 않으면서 새로운 실험이나 기능 개발을 독립적인 작업 환경에서 진행할 수 있어, 문맥 전환 비용을 최소화하고 생산성을 극대화한다.
또한, GPT-5.6 Sol의 '클라우드 환경'은 서버리스 컴퓨팅 자원을 활용하여 '자동 코드 리뷰'와 같은 고부하 작업을 백그라운드에서 실행할 수 있게 한다.
이는 개발자가 로컬 머신의 자원 제약 없이 AI 기반의 복잡한 작업을 수행할 수 있도록 하며, Slack과 같은 협업 도구와의 연동을 통해 팀 내 커뮤니케이션 및 워크플로우 통합을 강화한다.
2026년 8월 4일 기준으로 소스 코드 취약점 분석 및 패치 기능까지 지원하며 보안 워크플로우에도 깊이 관여하고 있다.
그러나 API Key 모드로 사용 시 클라우드 기능이 비활성화된다는 제한은, 클라우드 기반의 강력한 기능을 활용하고자 하는 사용자에게는 구독형 모델의 선택을 사실상 강제하는 전략으로 해석될 수 있다.
예를 들어, ChatGPT Plus 구독자는 월 5개의 클라우드 태스크와 5개의 코드 리뷰 제한을 받는다.
Claude Opus 5 / Fable 5의 광범위한 플랫폼 접근성 및 유연성
Claude Opus 5 / Fable 5는 통합 및 확장성 측면에서 '광범위한 플랫폼 접근성'과 '유연성'을 강점으로 내세우고 있다.
특히 '3,000+ MCP(Managed Cloud Provider) 통합'이라는 수치는 Claude Opus 5 / Fable 5가 단순한 개발 도구를 넘어, 클라우드 생태계 전반에 걸쳐 강력한 영향력을 행사하고 있음을 보여준다.
이는 기업 환경에서 다양한 클라우드 서비스를 활용하는 개발팀에게 일관된 AI 지원 경험을 제공할 수 있다는 점에서 큰 이점으로 작용한다.
더 나아가, Claude Opus 5 / Fable 5는 Amazon Bedrock, Google Vertex AI, 그리고 Microsoft Foundry와 같은 주요 클라우드 AI 플랫폼을 통한 접근성을 제공하여, 기업 고객들이 기존에 사용하던 클라우드 인프라 내에서 Claude Opus 5 / Fable 5의 강력한 AI 모델(예: 2026년 7월 24일부터 기본 모델로 채택된 Claude Opus 5)을 활용할 수 있도록 지원한다.
이는 클라우드 벤더 종속성을 최소화하면서도 최고 수준의 AI 코딩 역량을 도입하려는 기업들에게 매력적인 옵션이다.
또한 '자율 세션 길이'는 개발자가 AI와 상호작용하는 방식에 있어 획기적인 유연성을 제공한다.
이는 AI가 단순한 단일 질의 응답을 넘어, 개발자의 의도를 지속적으로 파악하고 장기적인 관점에서 코딩 작업을 지원할 수 있음을 의미하며, 긴 컨텍스트 작업(1M 토큰)에 특히 강점을 보인다.
2026년 6월 Black Duck 연구에 따르면 개발팀 중 63%가 Claude Opus 5 / Fable 5를 도입했다는 점은 이러한 유연성과 통합 능력이 이미 기업 환경에서 폭넓게 인정받고 있음을 방증한다.
생태계 전략 및 확장성 비교 분석
두 도구의 생태계 전략을 비교해보면, GPT-5.6 Sol는 'Agentic 코딩을 위한 Command Center'로서 자체 클라우드 환경과 내장 기능을 통해 종합적인 워크플로우 자동화를 지향한다.
이는 사용자가 GPT-5.6 Sol의 플랫폼 내에서 코드 작성, 리뷰, 리팩토링, 보안 분석까지 원스톱으로 해결할 수 있도록 설계되어, 특정 클라우드 벤더에 종속되지 않는 독립적인 AI 개발 환경을 구축하는 데 유리하다.
이러한 접근 방식은 Firebase-and-forget 클라우드 태스크와 같은 기능을 통해 개발자의 개입을 최소화하면서 작업을 완료하는 데 초점을 맞춘다.
반면 Claude Opus 5 / Fable 5는 '강력한 AI 모델의 광범위한 배포'와 '기존 클라우드 인프라와의 연계'에 집중하는 전략을 채택한다.
3,000개 이상의 MCP 통합 및 Bedrock, Vertex AI, Microsoft Foundry와 같은 주요 클라우드 플랫폼을 통한 접근성 제공은, 이미 특정 클라우드 환경에 깊이 의존하는 기업 고객들이 Claude Opus 5 / Fable 5의 AI 기능을 기존 워크플로우에 매끄럽게 통합할 수 있도록 돕는다.
이는 클라우드 환경의 유연성과 확장성을 최대로 활용하면서 AI 코딩 역량을 추가하려는 시장 요구에 부응하는 전략이다.
결론적으로 GPT-5.6 Sol는 자체 생태계 내에서 강력한 에이전트 기반 워크플로우를 구축하여 개발 효율성을 높이는 데 주력하는 반면, Claude Opus 5 / Fable 5는 다양한 클라우드 플랫폼과의 협력을 통해 AI 모델의 접근성과 활용성을 극대화하여 기업 시장에서의 영향력을 확장하고 있다고 볼 수 있다.
두 전략 모두 개발자 생산성 향상이라는 목표를 공유하지만, 통합의 깊이와 확장성의 방향성에서 뚜렷한 차이를 보인다.
4. 핵심 AI 모델 스펙 및 업데이트 히스토리
오늘날 첨단 AI 코딩 도구 시장을 선도하는 두 축, GPT-5.6 Sol과 Claude Opus 5는 각 서비스의 핵심 동력원으로서 개발자들의 작업 방식을 혁신하고 있습니다.
이 두 모델은 기술적 사양 면에서 유사하면서도 차별화된 업데이트 히스토리를 통해 시장 경쟁을 심화시키고 있습니다.
핵심 모델 기술 사양 비교
GPT-5.6 Sol과 Claude Opus 5는 현재 최상위 AI 모델로서 방대한 컨텍스트 처리 능력을 자랑합니다.
| 서비스 | 모델 | 컨텍스트 창 크기 | 최대 출력 토큰 |
|---|---|---|---|
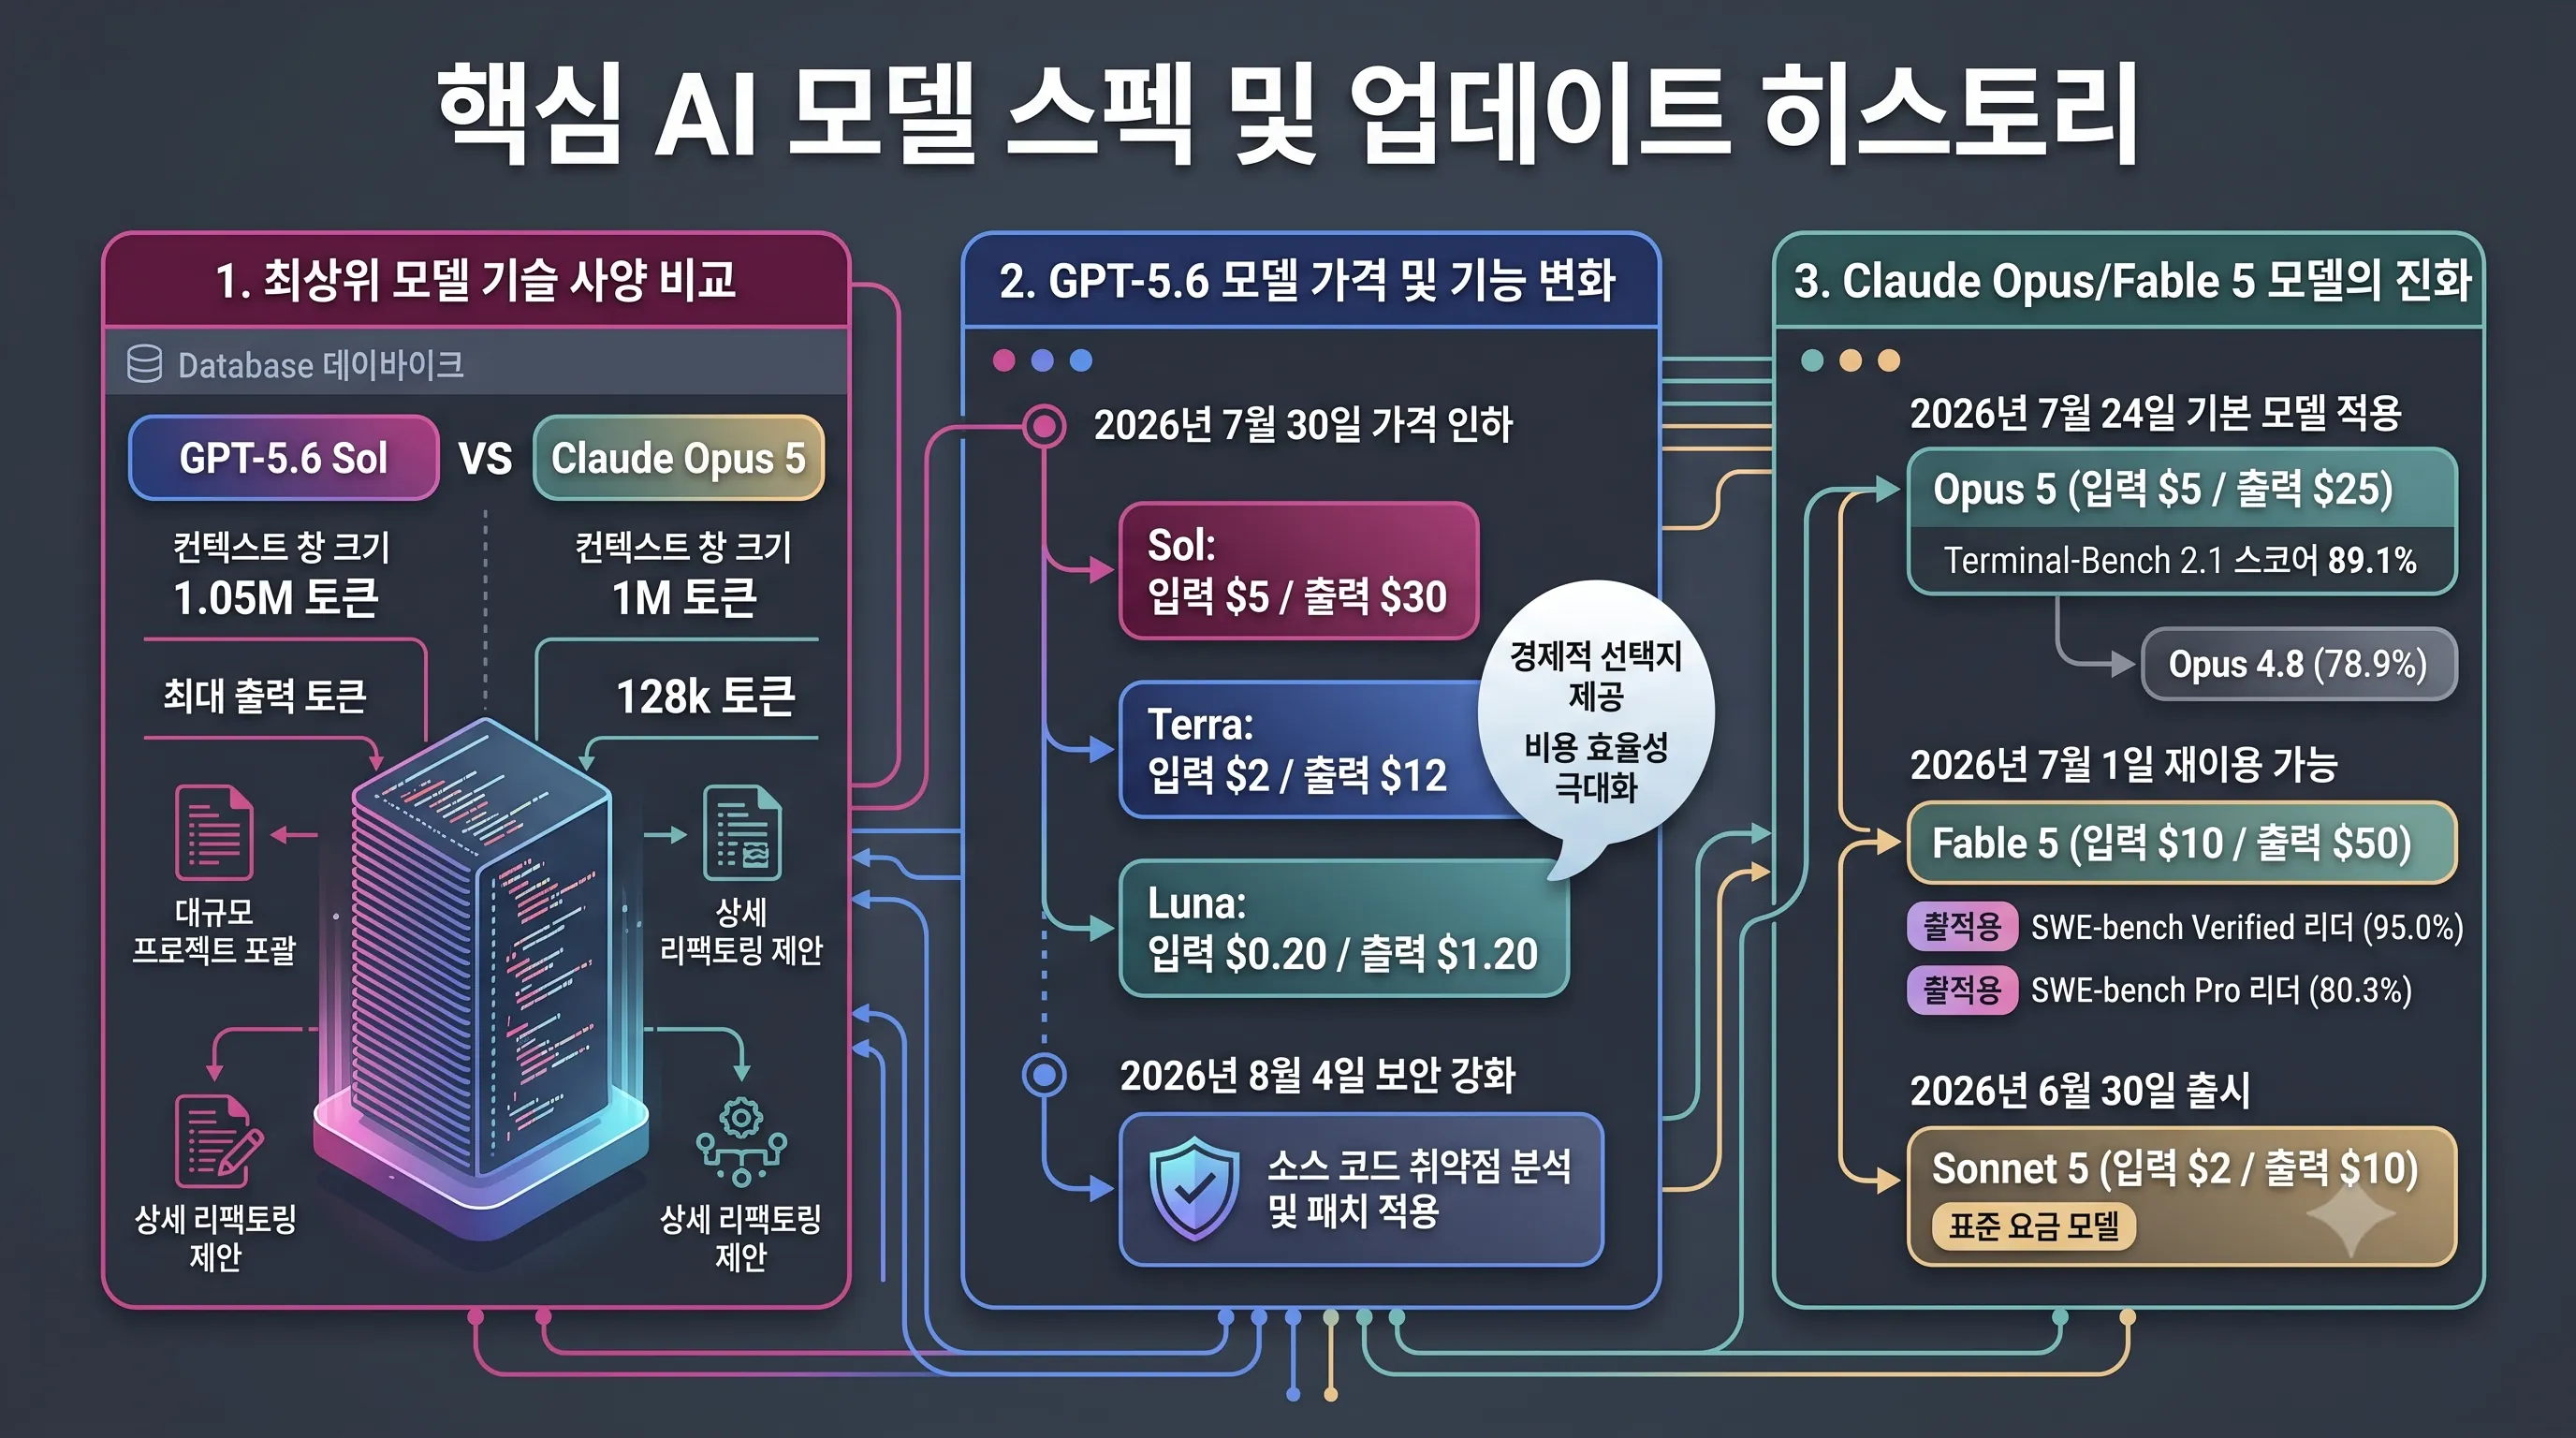
| GPT-5.6 Sol | GPT-5.6 Sol | 1.05M 토큰 | 128k 토큰 |
| Claude Opus 5 / Fable 5 | Claude Opus 5 | 1M 토큰 | 128k 토큰 |
GPT-5.6 Sol은 1.05M 토큰의 컨텍스트 창 크기를 제공하며, 이는 복잡한 대규모 코드베이스나 광범위한 문서 작업을 처리하는 데 필요한 강력한 기반이 됩니다.
반면 Claude Opus 5는 1M 토큰의 컨텍스트 창을 지원하여 GPT-5.6 Sol과 거의 동등한 수준의 장문 처리 능력을 갖추고 있습니다.
두 모델 모두 최대 128k 토큰의 출력을 지원하여 사용자가 긴 코드 블록, 상세한 리팩토링 제안, 또는 포괄적인 문서 초안을 받아볼 수 있도록 합니다.
이러한 대규모 컨텍스트 및 출력 능력은 개발자가 전체 프로젝트를 포괄하는 수준의 자율적인 AI 에이전트 기능을 활용할 수 있게 하는 핵심 요소입니다.
GPT-5.6 모델 업데이트 및 가격 정책 변화
GPT-5.6 모델 라인업은 지속적인 기술 발전과 함께 사용자 접근성을 높이기 위한 가격 정책 조정을 단행해 왔습니다.
현재 기본 모델인 GPT-5.6 Sol은 입력 1M 토큰당 $5, 출력 1M 토큰당 $30의 요금으로 운영되고 있습니다.
주목할 만한 변화는 2026년 7월 30일에 적용된 GPT-5.6 Terra와 GPT-5.6 Luna 모델의 가격 인하입니다.
GPT-5.6 Terra는 1M 토큰당 입력 $2, 출력 $12로 가격이 인하되어, Sol 모델 대비 훨씬 경제적인 비용으로 고성능 AI 기능을 이용할 수 있게 되었습니다.
또한 경량 모델인 GPT-5.6 Luna는 1M 토큰당 입력 $0.20, 출력 $1.20라는 파격적인 가격으로 책정되어, 비용 효율성을 극대화한 선택지를 제공합니다.
이러한 가격 인하는 특정 작업 부하와 비용 요구 사항에 따라 개발자들이 더욱 유연하게 모델을 선택할 수 있도록 지원하며, AI 코딩 도구의 대중화를 가속화하는 데 기여하고 있습니다.
기능적 측면에서는 2026년 8월 4일을 기준으로 소스 코드 취약점 분석 및 패치 기능이 GPT-5.6 기반 서비스에 적용되어, 보안 기능을 한층 강화하였습니다.
Claude Opus 5 및 Fable 5 모델의 진화와 가격 동향
클로드(Claude) 생태계 또한 기술 발전과 함께 모델 라인업을 꾸준히 확장해 왔습니다.
2026년 7월 24일부터 Claude Opus 5가 새로운 기본 모델로 적용되어, 1M 토큰당 입력 $5, 출력 $25의 요금으로 제공되고 있습니다.
Opus 5는 Opus 4.8 (Terminal-Bench 2.1 스코어 78.9%) 대비 향상된 성능을 보여주며, 현재 터미널 벤치 2.1 스코어에서 89.1%(max effort)를 기록하고 있습니다.
특히 주목해야 할 모델은 Fable 5입니다.
2026년 7월 1일부터 Fable 5는 SWE-bench Verified 리더(95.0%) 및 SWE-bench Pro 리더(80.3%)로 재이용 가능해졌습니다.
Fable 5는 1M 토큰당 입력 $10, 출력 $50로 Opus 5보다 높은 요율을 보이지만, 최상위 벤치마크 성능을 필요로 하는 작업에 특화되어 있습니다.
또한, 2026년 6월 30일에는 표준 요금 모델인 Sonnet 5가 출시되어 1M 토큰당 입력 $2, 출력 $10로 더 넓은 범위의 사용자들이 Claude의 AI 코딩 기능을 접할 수 있게 되었습니다.
이러한 모델 업데이트와 다각화된 가격 정책은 사용자들에게 성능과 비용 효율성 사이에서 폭넓은 선택권을 제공하며, 다양한 개발 환경과 요구 사항에 맞춰 최적의 솔루션을 구축할 수 있도록 지원하고 있습니다.
참고 자료 / 출처
- https://www.morphllm.com/best-ai-coding-agents-2026
- ChatGPT Codex 모드 | 소프트웨어 엔지니어링을 위한 AI 코딩 ... - OpenAI
- Codex in ChatGPT | AI Coding Agents for Software Engineering
- ChatGPT Codex 모드 | 소프트웨어 엔지니어링을 위한 AI 코딩 에이전트
- Codex 가격
- Codex - 나무위키
- Claude Code vs Cursor vs Codex 2026 - Benchmarks, Real Pricing, and …
- Claude Code vs Cursor vs Codex: 2026 SWE-bench Pro Scorecard
- Claude Code vs Cursor vs Codex: Best AI Coding Tool 2026
- Claude Code vs Codex vs Cursor vs OpenCode: An Honest 2026 …
- Claude Code vs Cursor vs Codex: The Honest Developer Comparison …
- Codex, Claude Code, or Cursor — Choosing an AI Coding Agent in Mid …
- Cursor vs Codex vs Claude Code (2026): Which Is Best?
관련 글