#비용 효율성
3개의 글
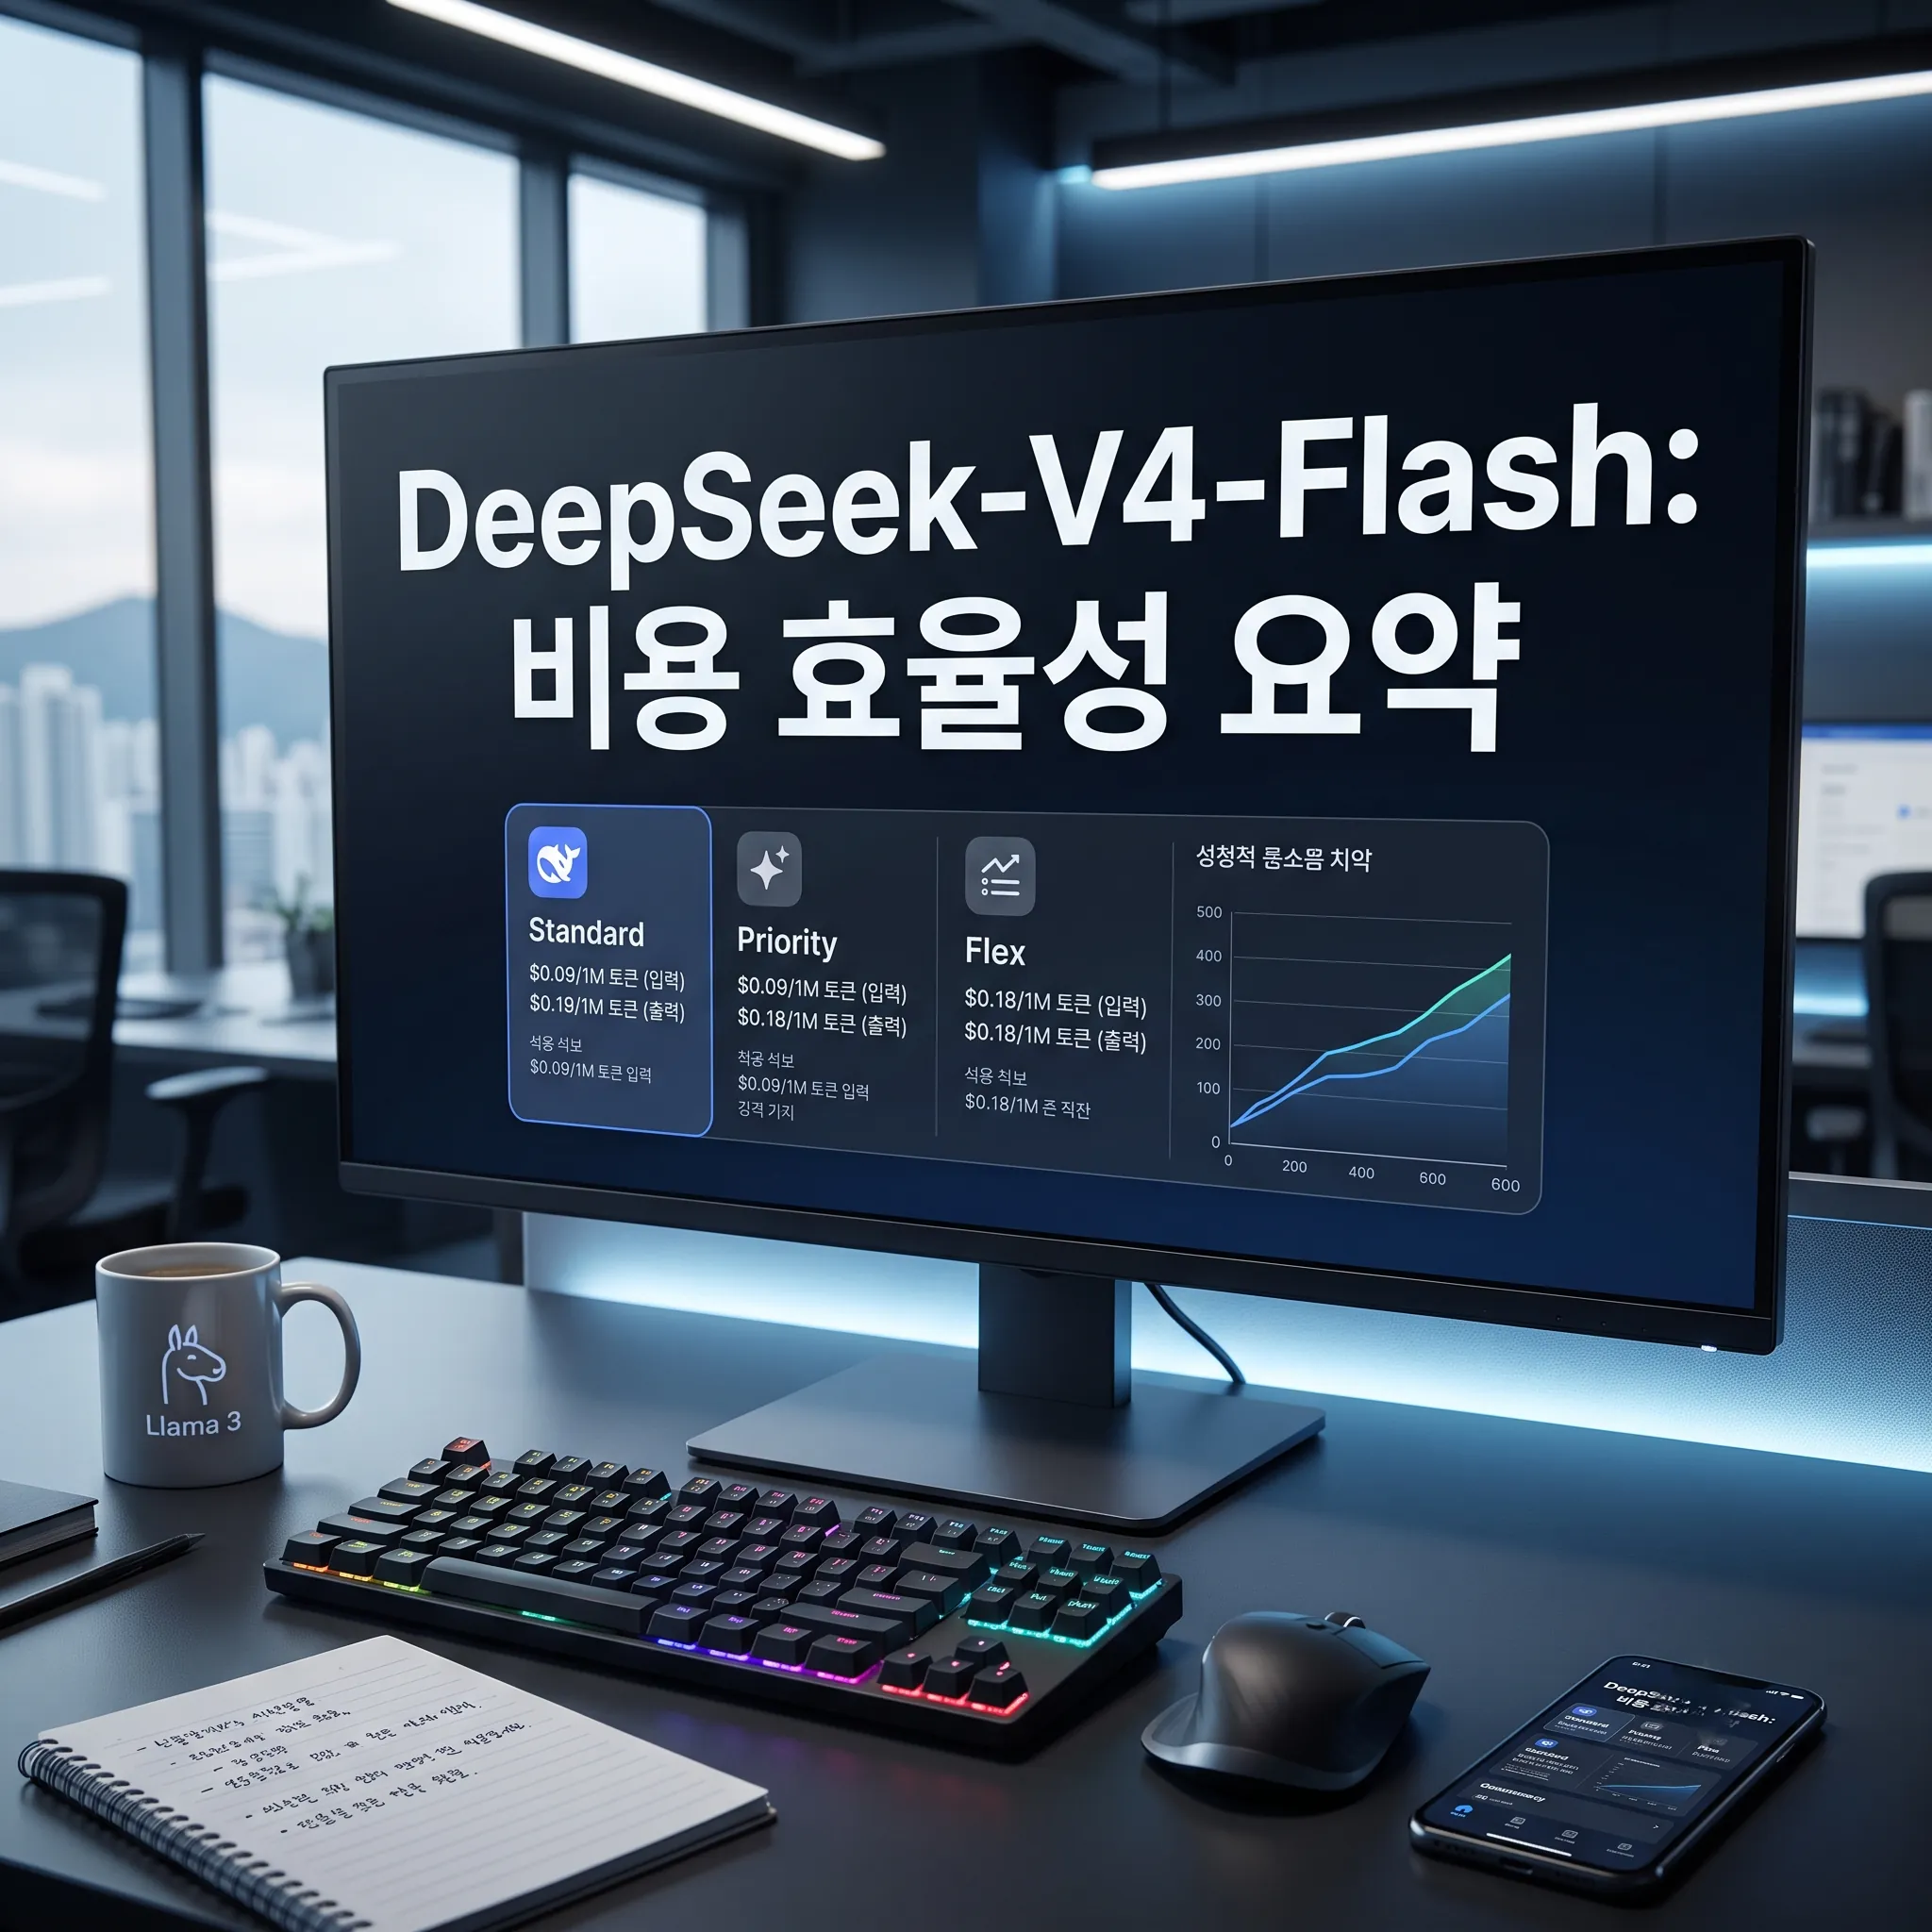
DeepSeek-V4-Flash: MoE 아키텍처, 성능, 요금제 비교 및 비용 효율성 분석
DeepSeek-V4-Flash는 MoE 아키텍처 기반의 초고속/고처리량 AI 모델입니다. 복잡한 추론 및 코딩에 최적화되었으며, Standard, Priority, Flex 3가지 요금제로 비용 효율적인 AI 활용 전략을 제시합니다.
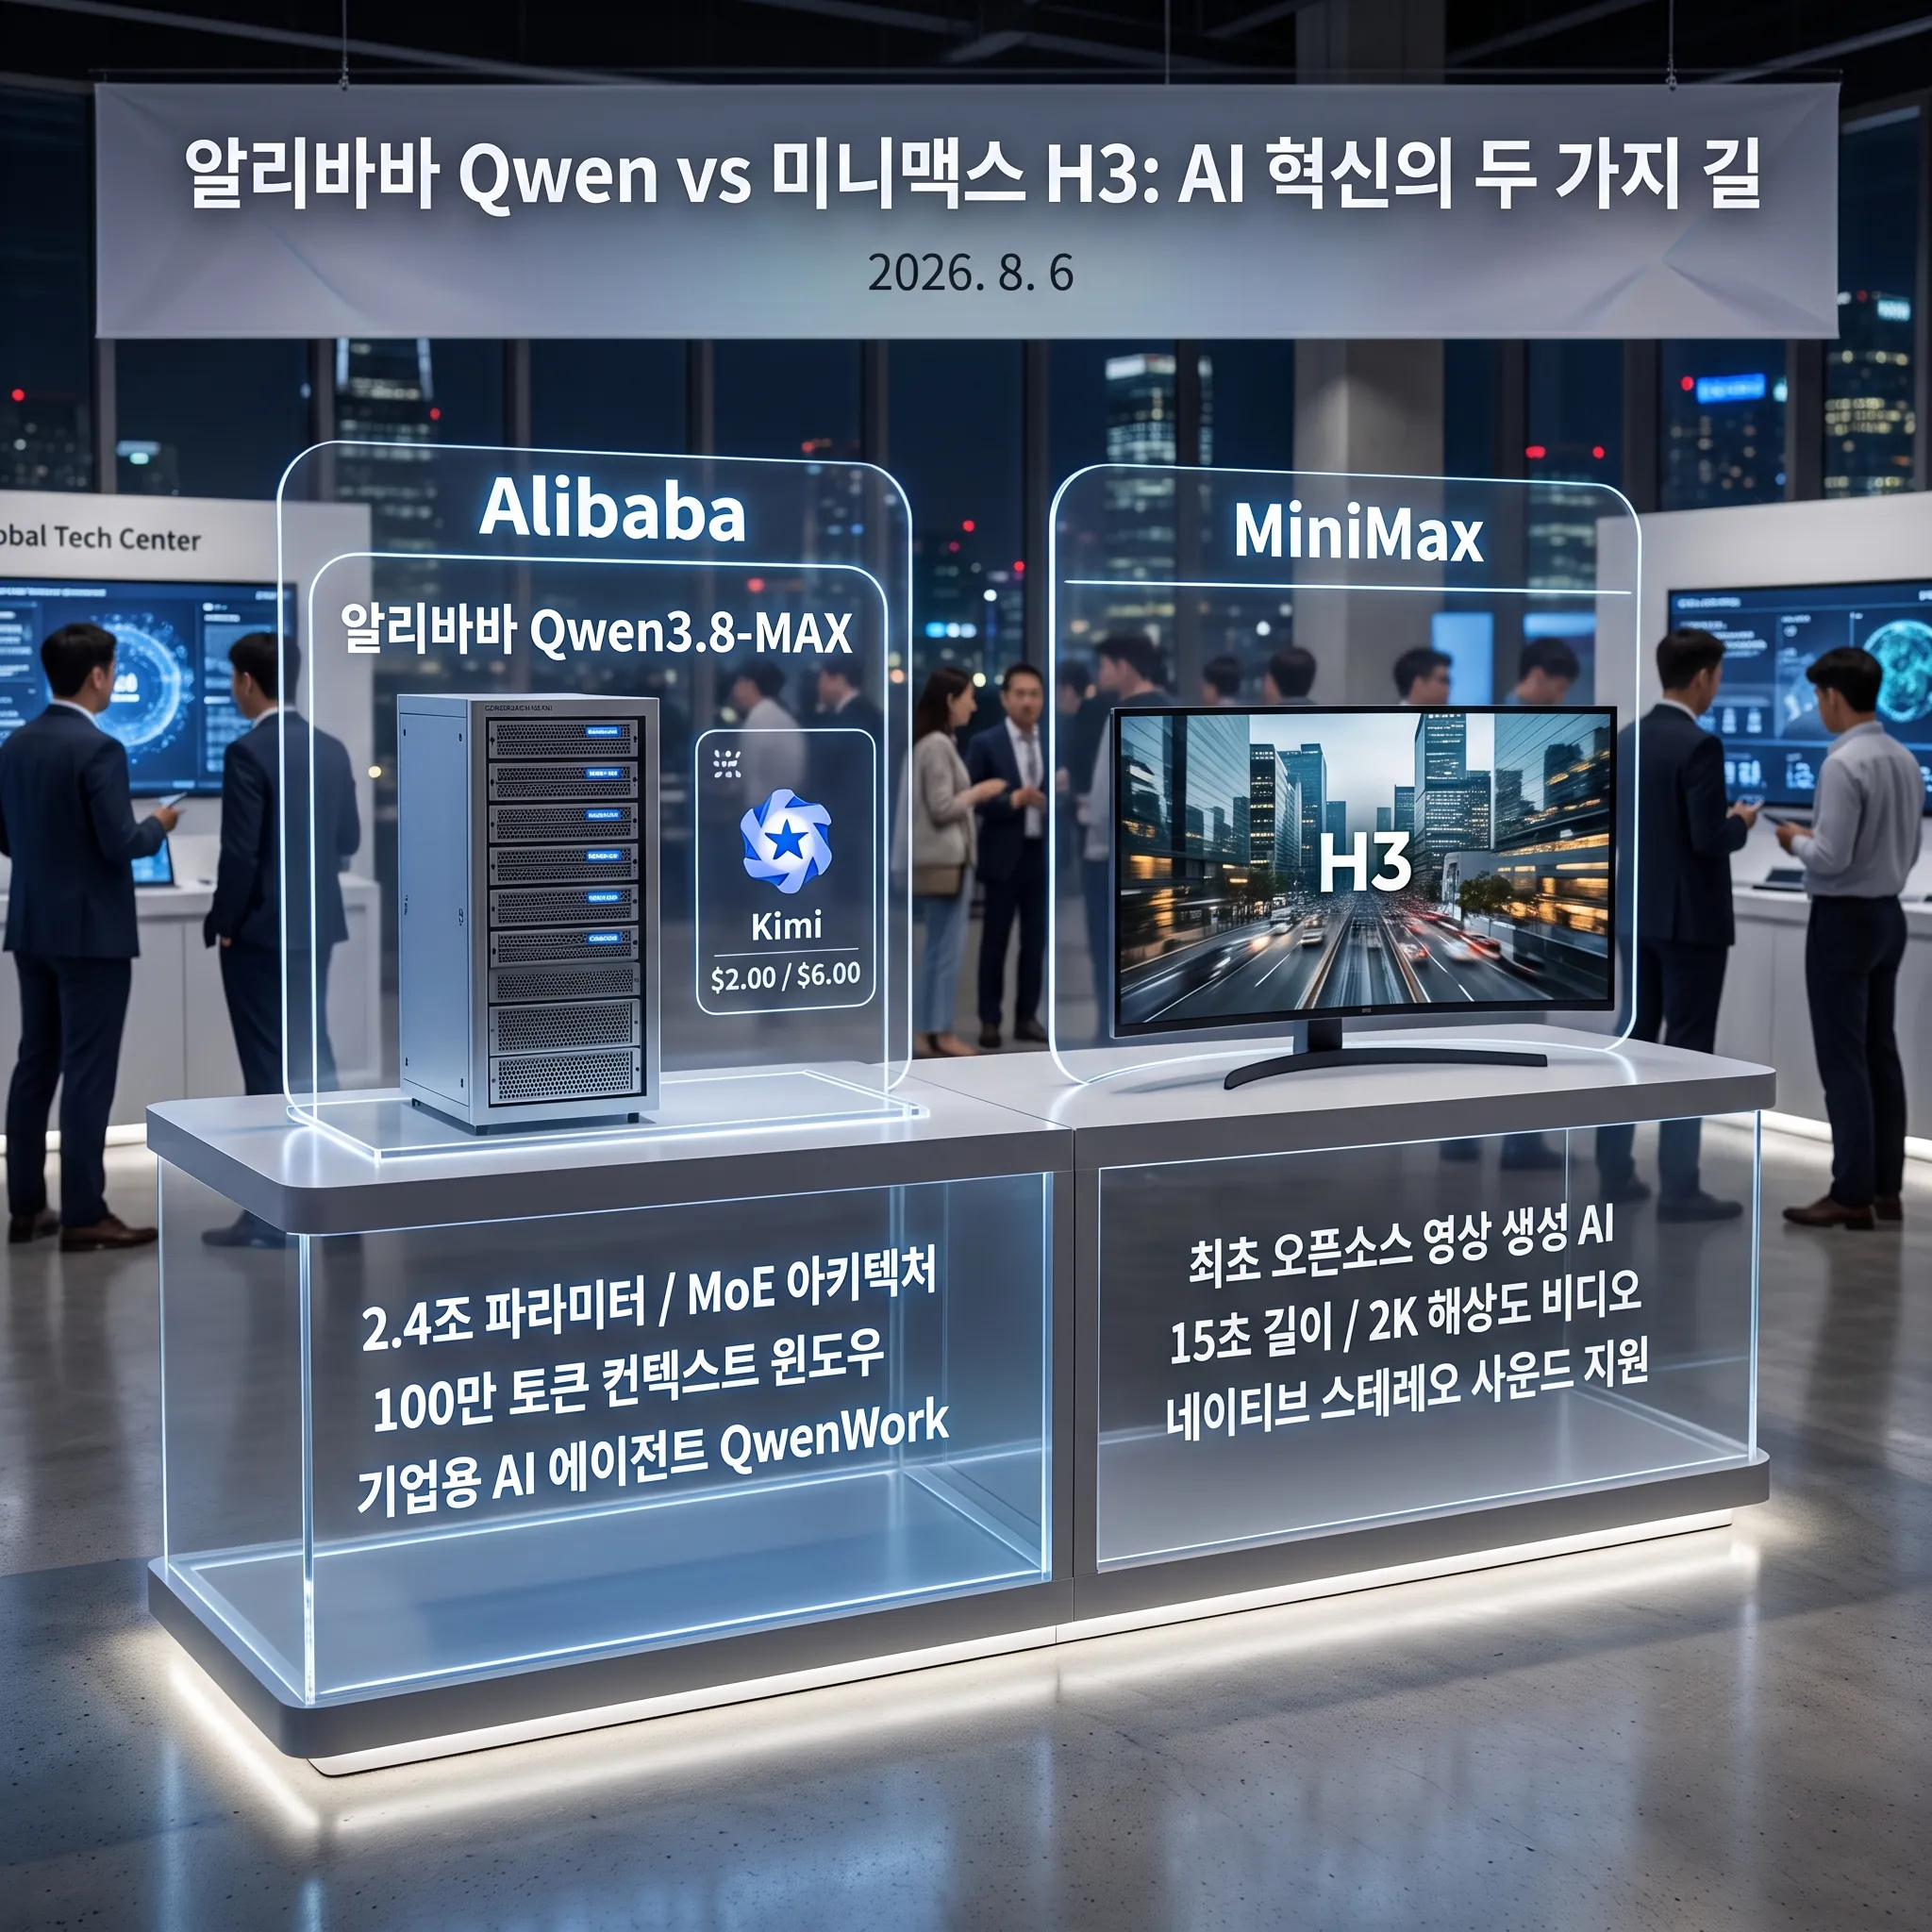
알리바바 Qwen3.8-Max vs 미니맥스 H3: AI의 두 길, 기업 LLM vs 오픈소스 영상
알리바바 Qwen3.8-Max와 미니맥스 H3의 AI 혁신을 분석합니다. 초거대 LLM의 기업 자동화 전략과 오픈소스 영상 AI의 콘텐츠 제작 대중화, 비용 및 실무 적용 시나리오까지 심층 비교.
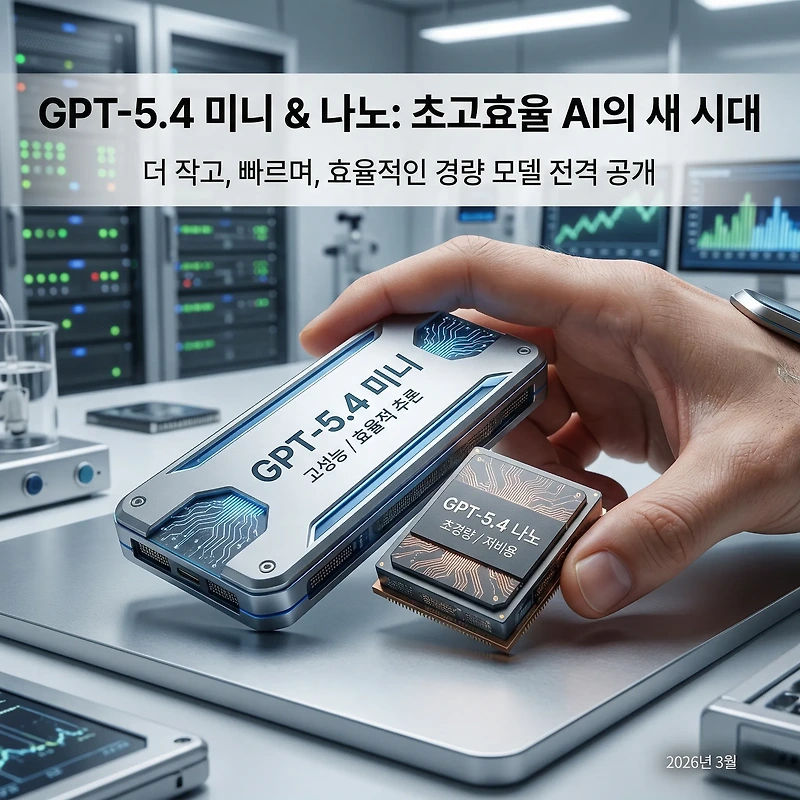
GPT-5.4 미니 & 나노: 더 작고, 빠르고, 효율적인 AI 혁신!
GPT-5.4 미니 & 나노 모델: 초고효율 AI의 새 시대 2026년 3월 17일, 더 작고, 빠르며, 효율적인 경량 AI 모델인 GPT-5.4 mini와 GPT-5.4 nano가 공식 출시되었습니다. GPT-5.4 nano는 초당 최대 200 토큰, GPT-5.4 mini는 초당...