전체 방문자
—
오늘 : —
어제 : —
1개의 글
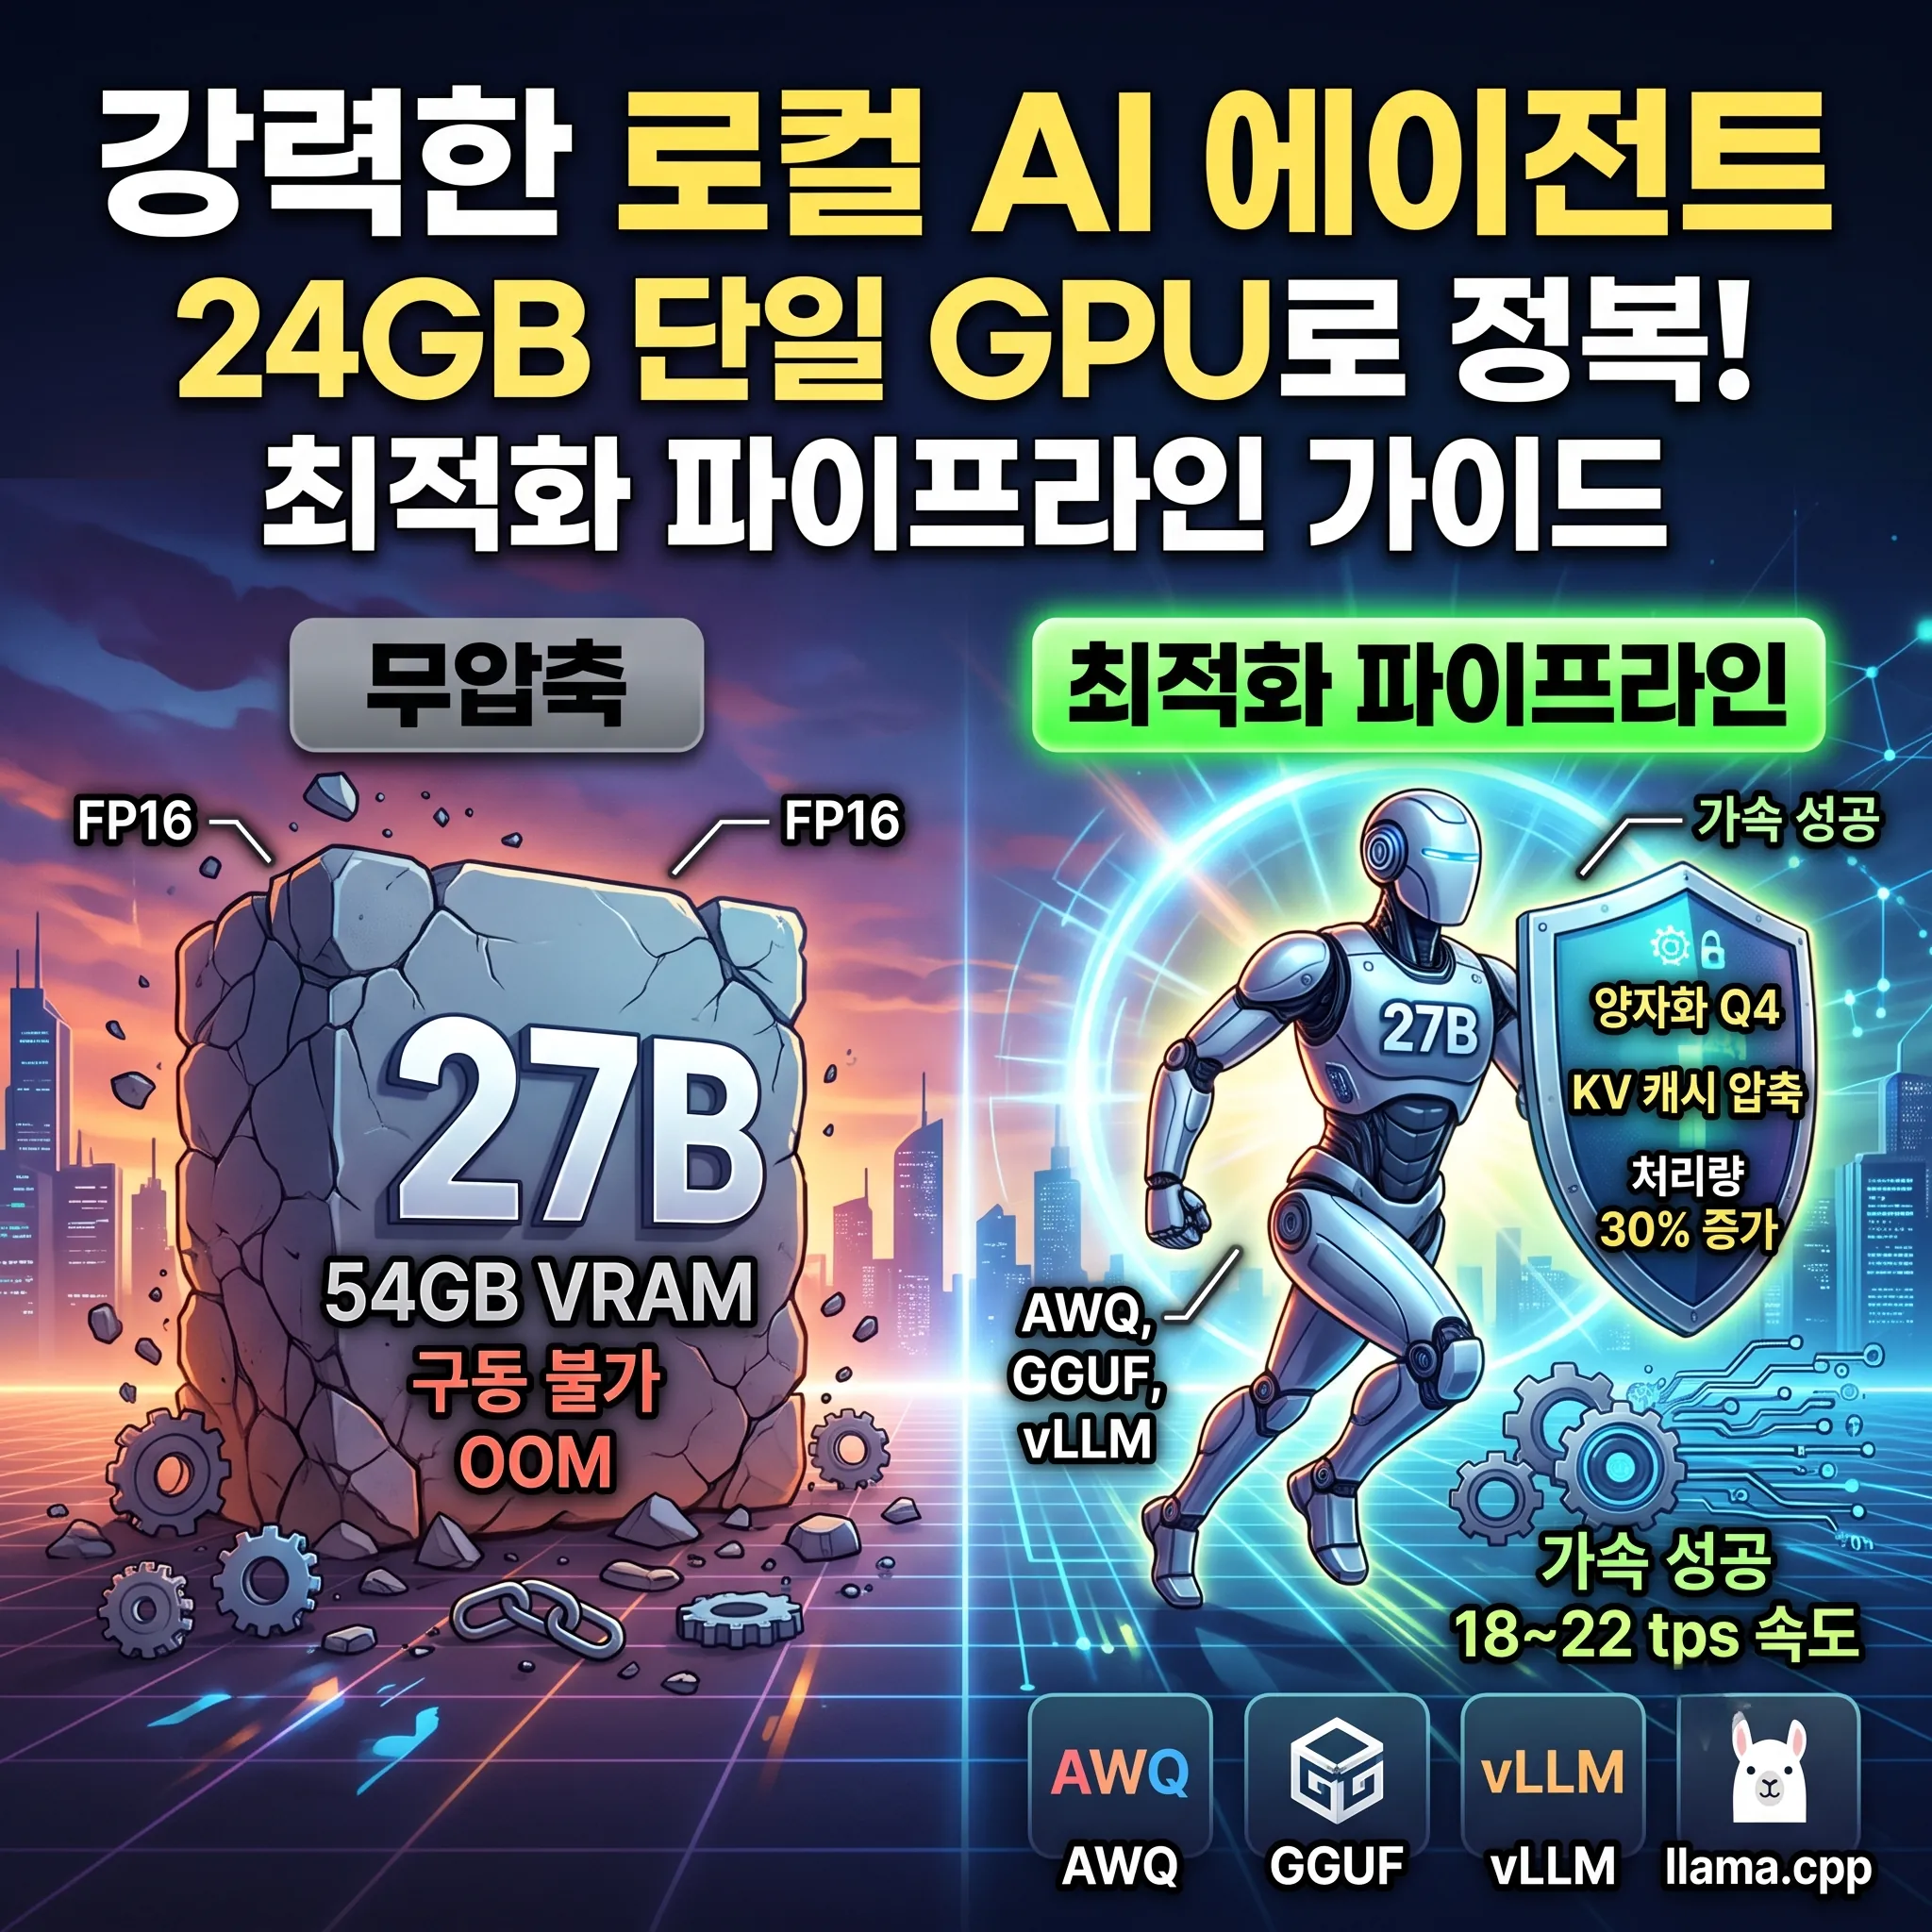
단일 24GB GPU 환경에서 27B 대형 언어 모델을 VRAM OOM 없이 구동하는 3단계 최적화 파이프라인과 vLLM, llama.cpp 실무 설정법을 다룹니다. 로컬 워크스테이션에서 대형 모델을 운영하려는 개발자와 연구자를 위한 기술 가이드입니다.