단일 GPU로 27B 모델 쾌적하게 돌리는 법: VRAM 절약과 지연시간(Latency) 단축 팁
- 3단계 VRAM 최적화 파이프라인: GGUF Q4_K_M 양자화(16.5GB 점유)와 FP8/INT8 KV 캐싱, FlashAttention-2를 연계해 24GB 단일 GPU에서 18~22 tps 속도 및 처리량 30% 향상을 달성합니다.
- 가중치 양자화 기술 비교: 상위 1% 핵심 가중치를 보존해 VRAM을 약 70% 절감하는 AWQ, 2차 미분 기반 GPTQ, Ada Lovelace 및 H100에서 가속되는 FP8(A8W8) 기술을 제공합니다.
- vLLM 디코딩 메모리 최적화: Copy-on-Write 기반 프롬프트 블록 공유로 최대 30.5% 메모리를 절감하고, 공통 접두사 재사용을 통해 처리량을 최대 3.58배 가속합니다.
- vLLM 실무 파라미터 튜닝: AWQ 및 FP8 모델별 CLI 구성과 함께
--kv-cache-dtype fp8설정을 적용하여 8K 이상 장문 컨텍스트 메모리를 절반으로 압축합니다. - llama.cpp GGUF 경량 런타임: 순수 C/C++ GGML 기반 엔진을 통해 1.5-bit~8-bit 정수 양자화를 폭넓게 지원하며 Hugging Face 연계 즉시 서빙을 지원합니다.
- 로컬 워크스테이션 배포 기법: Ollama 기반 27B 오픈소스 모델 구동 시 q8_0 KV 캐시 양자화와 Linux Swap 연계를 통해 추론 지연시간 단축 및 OOM을 방어합니다.
27B 규모의 대형 언어 모델은 뛰어난 추론 능력과 작업 수행력을 갖추고 있어 로컬 연구와 실무 서비스 환경 모두에서 핵심적인 모델군으로 주목받고 있습니다.
그러나 압축되지 않은 고정밀도 상태의 27B 모델은 단일 24GB GPU 환경에서 즉각적인 메모리 부족(OOM)을 유발하므로 정교한 최적화 전략 없이는 구동조차 쉽지 않습니다.
최근에는 단순한 모델 가중치 경량화를 넘어 KV Cache 압축, 고효율 어텐션 커널, 메모리 공유 기반 서빙 런타임을 종합적으로 연계하는 최적화 파이프라인이 필수로 자리 잡았습니다.
VRAM 점유량을 안전선 내부로 제한하면서도 토큰 생성 지연시간(Latency)을 최소화해 실시간 대화가 가능한 처리량을 확보하는 것이 핵심 과제입니다.
본 글에서는 단일 24GB GPU 환경에서 27B 모델을 쾌적하게 구동하기 위한 3단계 VRAM 최적화 기법과 vLLM, llama.cpp 등 주요 런타임의 실무 설정 노하우를 체계적으로 정리해 살펴봅니다.
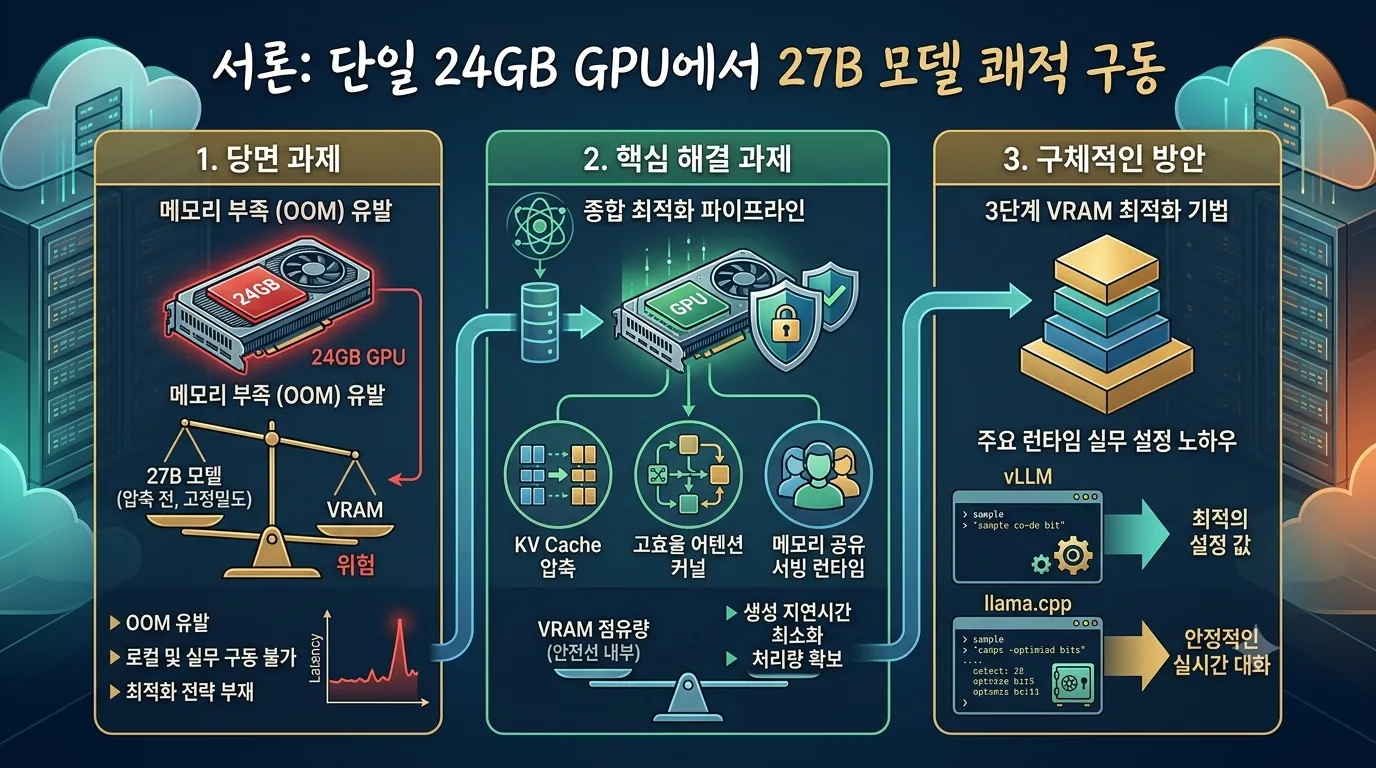
1. 24GB 단일 GPU에서 27B 모델 구동을 위한 3단계 VRAM 최적화 파이프라인
FP16 기본 모델의 VRAM 초과(54GB)와 24GB 단일 구동 불가 문제
인공지능 대형 언어 모델(LLM) 환경에서 파라미터 규모가 27B 수준에 도달하면 단일 소비자용 및 워크스테이션 GPU에서 구동할 때 극심한 메모리 병목 현상이 발생합니다.
Target A 분석에 따르면 압축을 전혀 거치지 않은 FP16 기본 27B 모델을 로드하기 위해서는 순수 가중치와 연산 버퍼를 합쳐 무려 약 54GB의 VRAM이 요구됩니다.
이로 인해 일반적인 24GB VRAM 단일 GPU 환경에서는 메모리 할당 즉시 OOM(Out of Memory) 오류가 발생하며 초당 토큰 생성 속도가 0 tps에 머물러 단일 구동이 완전히 불가능해집니다.
27B 모델은 고도화된 추론 능력과 언어 이해력을 갖추고 있으나 24GB 메모리 한계를 초과하는 용량 문제로 인해 멀티 GPU 클러스터를 구축하지 않고서는 서비스 배포가 어려웠습니다.
이러한 물리적 한계를 극복하기 위해서는 단순한 모델 축소가 아닌 가중치, 캐시, 커널 I/O를 통합 제어하는 3단계 최적화 파이프라인의 구축이 필수적입니다.
가중치 양자화·KV 캐시 압축·FlashAttention-2 3단계 최적화 수치
첫 번째 단계는 모델의 기초 용량을 대폭 줄이는 가중치 양자화 작업으로, GGUF Q4_K_M(4.5 bit) 방식을 적용합니다.
해당 양자화를 거치면 54GB에 달하던 기본 메모리 요구량이 약 16.5GB 점유율 수준으로 급감하며, 단일 24GB GPU 환경에서 초당 18~22 tps의 토큰 생성 속도를 안정적으로 기록합니다.
두 번째 단계는 장문 대화 시 급격히 증가하는 컨텍스트 메모리를 관리하는 FP8/INT8 KV Caching 기법의 도입입니다.
이 방식을 적용하면 8k 컨텍스트 길이를 기준으로 메모리 사용량을 약 2.5GB 점유 수준으로 제한할 수 있으며, 데이터 입출력 병목을 해소하여 추론 지연시간을 20% 단축하는 효과를 거둡니다.
세 번째 단계는 어텐션 연산 시 발생하는 불필요한 GPU 메모리 읽기·쓰기를 최소화하는 FlashAttention-2 메모리 최적화 커널의 적용입니다.
해당 커널 최적화를 통해 시스템 여유 공간을 안전하게 확보하는 동시에 전체 토큰 처리량을 30% 향상시켜 추론 효율을 극대화합니다.
| 최적화 단계 | 적용 기술 및 규격 | VRAM 점유량 | 성능 및 속도 지표 |
|---|---|---|---|
| 기준 상태 (무압축) | FP16 기본 27B 모델 | 약 54GB (OOM 발생) | 구동 불가 (0 tps) |
| 1단계: 가중치 양자화 | GGUF Q4_K_M (4.5 bit) | 약 16.5GB | 18~22 tps 기록 |
| 2단계: 캐시 압축 | FP8/INT8 KV Caching (8k 기준) | 약 2.5GB | 지연시간 20% 단축 |
| 3단계: 커널 최적화 | FlashAttention-2 | 시스템 여유 버퍼 확보 | 처리량 30% 향상 |
| 최종 최적화 통합 | 3단계 파이프라인 통합 적용 | 총 약 19.5GB | 실시간 대화 구동 가능 |
최종 19.5GB 점유율 달성과 실시간 대화 추론 성능 확보
가중치 양자화, KV Cache 압축, FlashAttention-2 연산 커널 최적화가 결합된 결과 27B 모델의 전체 메모리 요구량은 총 약 19.5GB로 억제됩니다.
이는 24GB 단일 GPU의 하드웨어 한계 내에서 약 4.5GB의 안전 마진을 확보한 수치이며, 장시간 실행 시에도 메모리 누수나 버퍼 오버플로우 없이 안정적인 실시간 대화 구동을 가능하게 만듭니다.
단일 GPU 기반 서빙 아키텍처에서 27B 급 고성능 언어 모델을 지연 없이 배포하기 위한 실질적 기술 표준이 완성되었습니다.
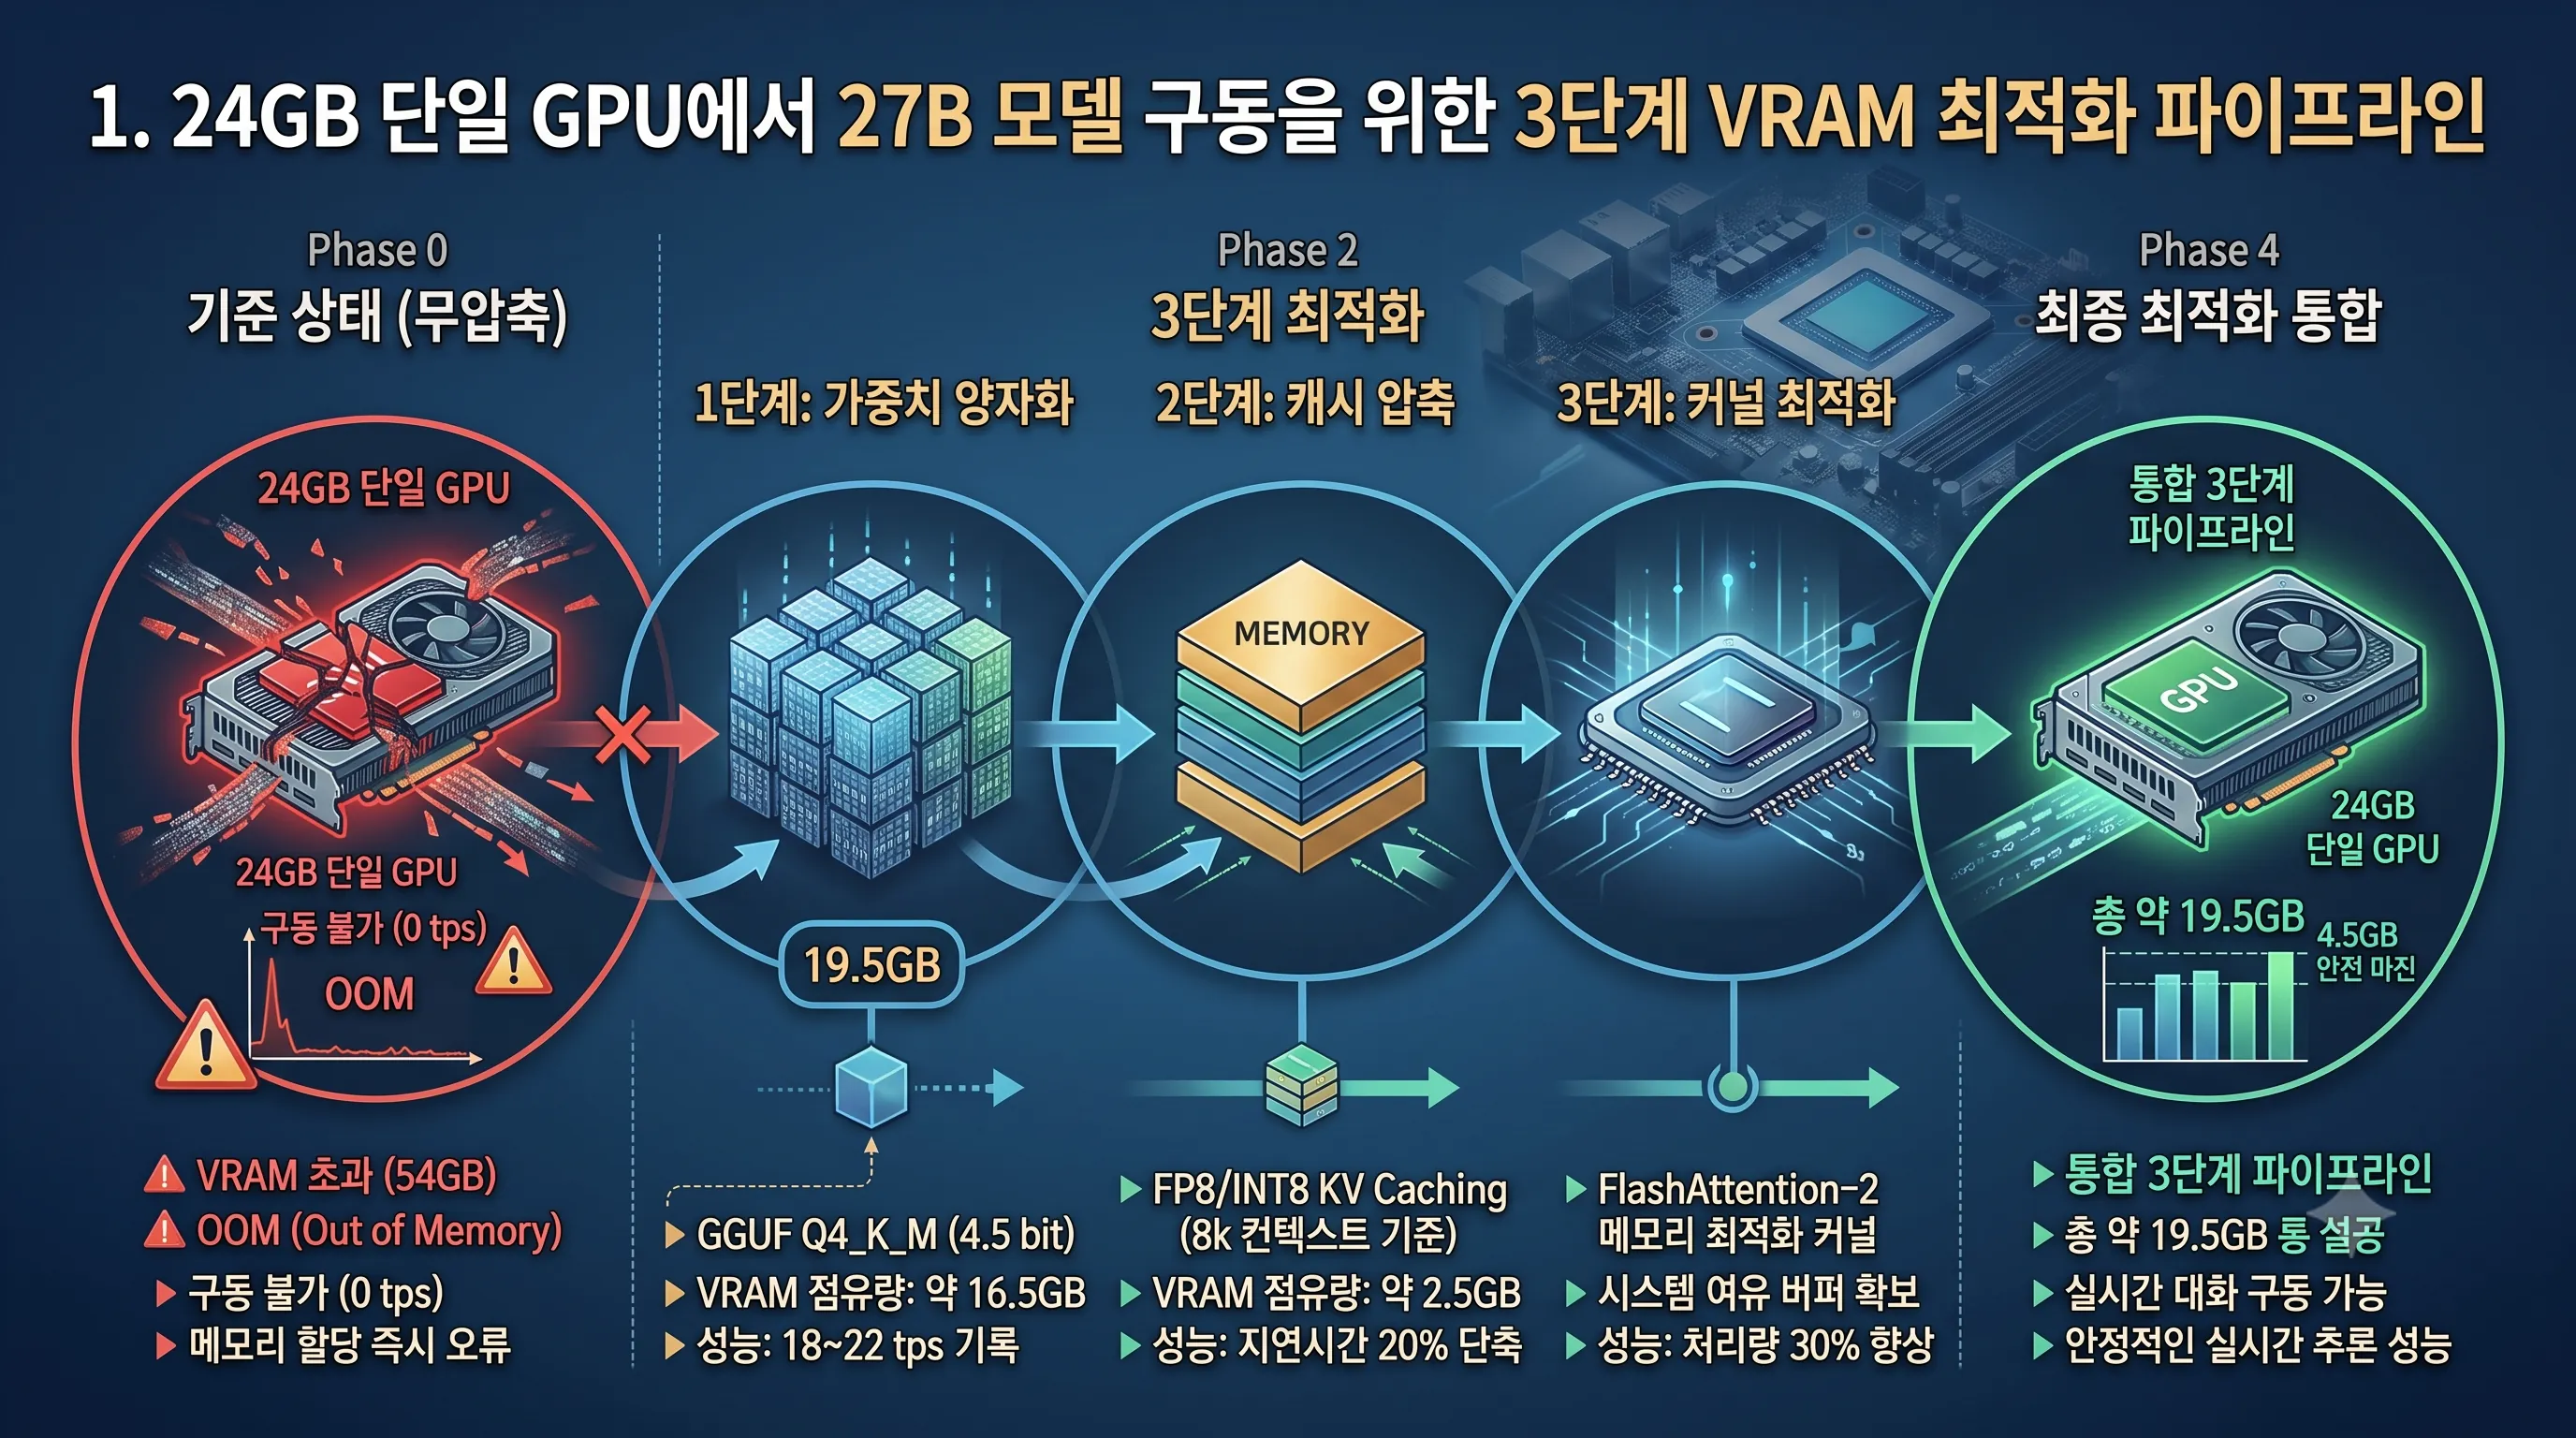
2. 가중치 양자화 기술 심층 비교: AWQ, GPTQ, FP8, GGUF
AWQ와 GPTQ의 가중치 압축 원리 및 VRAM 절감 효과
27B 규모의 거대언어모델(LLM)을 단일 소비자용 GPU 환경에서 구동할 때 가장 큰 걸림돌은 VRAM 용량과 메모리 대역폭의 한계입니다.
이를 극복하기 위해 널리 활용되는 AWQ(Activation-aware Weight Quantization)는 전체 파라미터 중 활성화 값에 결정적인 영향을 미치는 상위 1% 핵심 가중치만을 선별해 원본 정밀도로 보존하는 4비트 양자화 기술입니다.
비중이 큰 극소수 가중치를 보호함으로써 모델의 전반적인 정확도 손실을 극소화하는 동시에, 기존 FP16/BF16 대비 VRAM 점유율 약 70% 절감 효과를 제공하여 RTX 3090 및 RTX 4090과 같은 단일 GPU 서빙 환경에 최적화되어 있습니다.
반면 GPTQ(Generative Pre-trained Transformer Quantization)는 2차 미분(헤시안 행렬) 정보를 기반으로 가중치를 순차적으로 양자화하고 양자화 오차를 보정하여 높은 압축률을 달성하는 4비트 사후 양자화(PTQ) 방식입니다.
두 방식 모두 27B급 파라미터를 단일 24GB VRAM 환경에 적재할 수 있도록 지원하며, 연산 과정에서 가중치 로드에 소요되는 메모리 대역폭 병목을 획기적으로 완화합니다.
최신 GPU 아키텍처를 위한 FP8(E4M3/E5M2) 연산 가속
차세대 하드웨어 환경에서는 8비트 부동소수점 포맷인 FP8 양자화가 새로운 표준으로 주목받고 있습니다.
FP8은 수치의 정밀도를 우선시하는 E4M3 형식과 더 넓은 표현 범위를 확보하는 E5M2 두 가지 형식을 지원하며, 활성화와 가중치 모두 8비트로 처리하는 A8W8 연산을 수행합니다.
이를 통해 FP16 대비 메모리 사용량을 50% 절감하면서도 정밀도 손실을 거의 발생시키지 않는 강력한 이점을 지닙니다.
다만 FP8의 지연시간 단축 효과를 완전히 끌어내기 위해서는 네이티브 FP8 텐서 코어를 갖춘 하드웨어 아키텍처가 필수적입니다.
엔비디아의 Ada Lovelace 아키텍처 기반 RTX 4090이나 데이터센터용 H100 GPU 환경에서는 속도 저하 없이 FP8 연산 가속을 온전히 활용할 수 있어, 27B 모델을 고속으로 추론하는 데 탁월한 효율을 제공합니다.
단순 INT4의 한계와 고급 PTQ 기법 도입 필요성
단순한 라운딩 방식을 적용한 INT4 양자화는 INT8 대비 메모리 사용량을 50% 추가 절감할 수 있어 VRAM 대역폭 병목 해소에 유리하지만, 파라미터 절삭에 따른 치명적인 정확도 저하가 발생한다는 구조적 한계를 지닙니다.
이러한 성능 하락을 방지하고 추론 품질을 안정적으로 유지하기 위해 정교한 오차 보정이 적용된 AWQ나 GPTQ 같은 고급 PTQ(Post-Training Quantization) 기법을 도입하는 것이 필수적입니다.
Hugging Face 생태계에서는 HfQuantizer API 및 BitsAndBytesConfig 설정을 통해 W4 및 INT8 가중치 로드를 간편하게 구성할 수 있습니다.
사용자는 보유한 GPU 아키텍처와 허용 가능한 연산 정밀도에 맞춰 최적의 양자화 설정을 유연하게 선택하여 모델을 서빙할 수 있습니다.
| 양자화 방식 | 연산 포맷 및 정밀도 | 메모리(VRAM) 절감 효과 | 주요 특징 및 하드웨어 적합성 |
|---|---|---|---|
| AWQ | 4-bit (상위 1% 원본 보존) | 약 70% 절감 | 정확도 손실 극소화, RTX 3090/4090 단일 GPU 최적화 |
| GPTQ | 4-bit (2차 미분 기반 보정) | 약 70% 절감 | 헤시안 기반 가중치 재조정으로 높은 압축률 제공 |
| FP8 | 8-bit (E4M3 / E5M2, A8W8) | 50% 절감 | RTX 4090 및 H100 등 네이티브 텐서 코어 가속 필수 |
| INT4 | 4-bit (기본 정수형) | INT8 대비 50% 추가 절감 | 대역폭 병목 완화, 정확도 보존을 위해 고급 PTQ 기법 필요 |
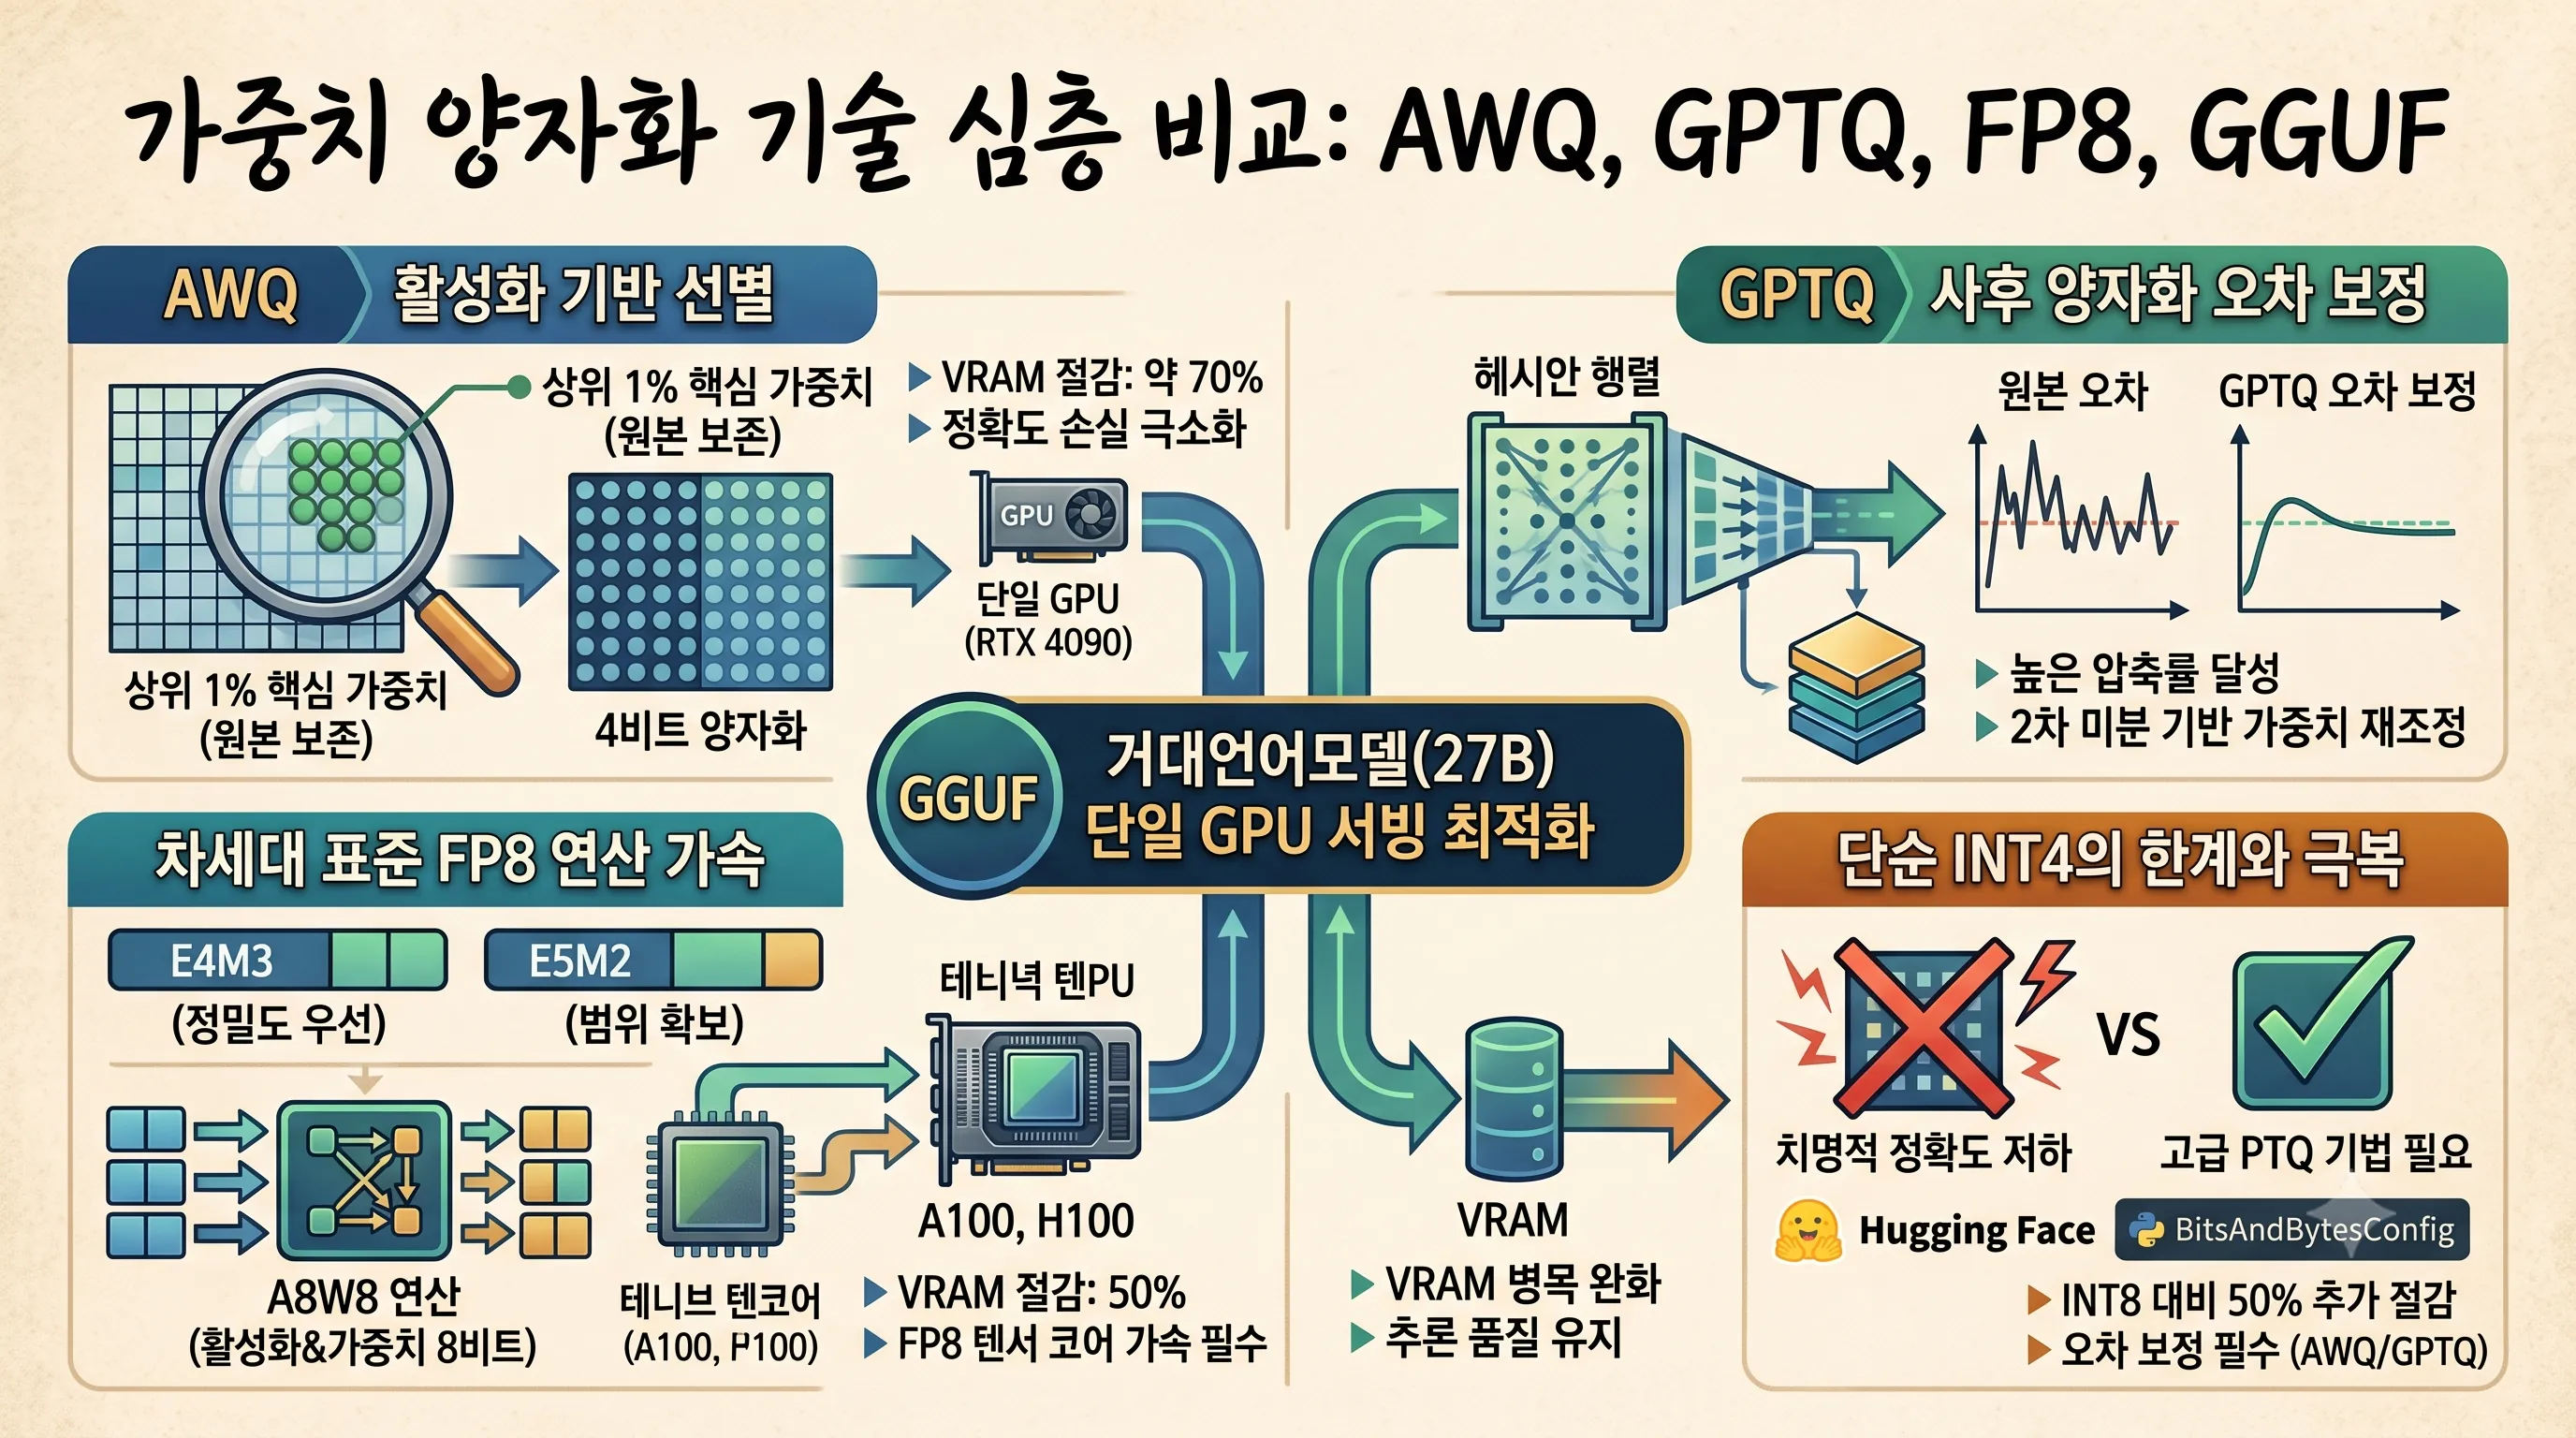
3. vLLM 고급 디코딩 최적화와 메모리 프리엠션 및 스왑 메커니즘
Copy-on-Write 기반 프롬프트 블록 공유와 디코딩 메모리 절감
단일 GPU 환경에서 27B 규모의 대형 언어 모델을 원활하게 구동하기 위해서는 KV Cache가 차지하는 VRAM 공간을 극적으로 최적화해야 합니다.
vLLM은 프롬프트 단계에서 생성된 물리 블록을 여러 출력 시퀀스가 공유하도록 설계하여 불필요한 메모리 중복을 원천 차단합니다.
이 과정에서 핵심 역할을 수행하는 것이 바로 참조 카운트(Reference Count) 기반의 Copy-on-Write(CoW) 메커니즘입니다.
각 시퀀스가 공통 프롬프트를 참조하는 동안에는 단일 물리 블록만 유지되며, 새로운 토큰이 생성되어 분기가 일어나는 시점에만 해당 블록을 복사하여 수정합니다.
이러한 블록 공유 아키텍처는 병렬 샘플링 환경에서 6.1%~9.8%의 메모리 절감 효과를 거두며, ShareGPT 데이터셋 기준으로는 최대 30.5%에 달하는 VRAM 절약을 달성했습니다.
이와 같은 수치는 2309.06180v1.pdf 연구를 통해 실증된 결과로, 단일 GPU 내에서 27B 모델 추론 시 메모리 병목을 해소하고 동시 처리 가능한 시퀀스 수를 비약적으로 늘리는 기반이 됩니다.
빔 서치 및 공통 접두사 재사용을 통한 추론 처리량 가속
복잡한 디코딩 알고리즘인 빔 서치(Beam Search)를 수행할 때도 블록 공유 기술은 막대한 메모리 효율을 제공합니다.
빔 후보군 간의 공통 토큰 블록을 공유함으로써 일반적인 환경에서 37.6%~55.2%의 메모리를 절약하며, ShareGPT 기준으로는 최대 66.3%까지 메모리 사용량을 줄입니다.
결과적으로 단일 GPU의 한정된 VRAM 내에서도 다수의 빔 후보를 유지하며 높은 정밀도의 디코딩을 안정적으로 유지할 수 있습니다.
또한 다중 턴 대화나 퓨샷 러닝에서 나타나는 공통 프롬프트(Shared Prefix)를 재사용하는 구조 역시 추론 속도 개선에 결정적입니다.
5-shot 접두사를 공유하는 환경에서 해당 메커니즘을 적용한 결과, Orca 대비 최대 3.58배의 처리량(Throughput) 향상을 기록했습니다.
반복적인 프롬프트 프리필 연산을 생략하고 물리 블록을 즉각 연결함으로써 초기 지연시간(TTFT)과 전체 추론 지연시간을 크게 단축시킵니다.
| 디코딩 및 프롬프트 환경 | 메모리 절감율 (일반) | 메모리 절감율 (ShareGPT 기준) | 처리량(Throughput) 향상 |
|---|---|---|---|
| 병렬 샘플링 | 6.1%~9.8% | 최대 30.5% | - |
| 빔 서치(Beam Search) | 37.6%~55.2% | 최대 66.3% | - |
| 5-shot 공통 접두사 공유 | - | - | Orca 대비 최대 3.58배 |
VRAM 한계 상황에서의 CPU RAM 스왑 정책과 PCIe 대역폭 고려사항
동시 요청이 급증하여 순간적으로 VRAM 용량을 초과할 경우 시스템 중단을 방지하기 위해 프리엠션(Preemption) 및 스왑 정책이 작동합니다.
vLLM은 FCFS(First-Come, First-Served) 우선순위를 바탕으로 시퀀스 그룹 단위의 All-or-Nothing 정책을 적용하여 일부 시퀀스를 CPU RAM으로 스와핑하거나 재계산(Recomputation)을 수행합니다.
시퀀스 그룹 전체를 원자적으로 다룸으로써 디코딩 일관성을 유지하고 불완전한 상태로 남는 메모리 누수를 원천 차단합니다.
다만 메모리 스왑 과정에서 블록 크기 설정에 따른 PCIe 대역폭 오버헤드를 반드시 주의해야 합니다.
작은 블록 크기를 채택할 경우 잘게 쪼개진 소용량 데이터의 호스트-디바이스 전송이 빈번해져 대역폭 병목이 발생하고 스와핑 오버헤드가 급증할 수 있습니다.
따라서 27B 모델을 단일 GPU에서 운용할 때는 I/O 오버헤드와 블록 공유 효율의 균형을 맞춘 적정 블록 크기 설정이 필수적입니다.
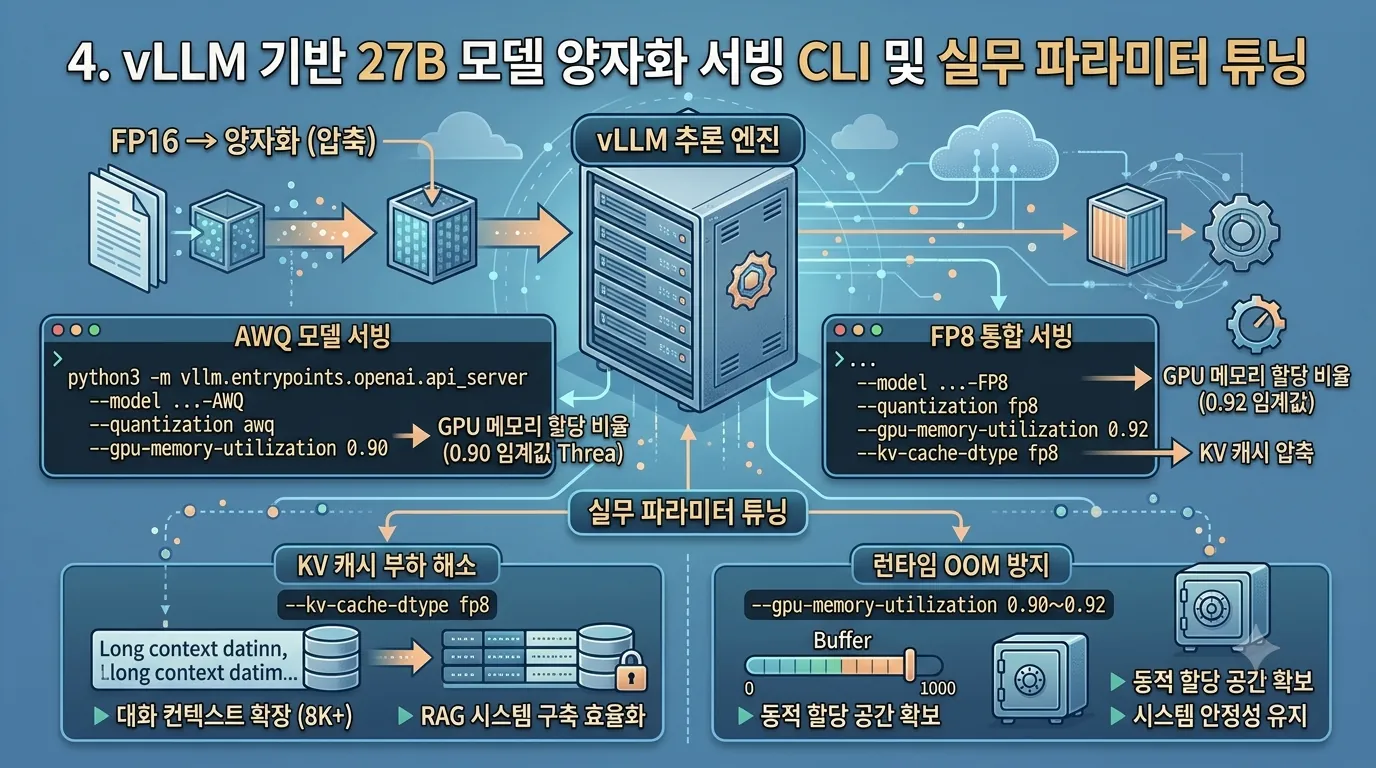
4. vLLM 기반 27B 모델 양자화 서빙 CLI 및 실무 파라미터 튜닝
AWQ 및 FP8 모델별 vLLM 구동 CLI 명령어 구성
단일 GPU 환경에서 27B 대규모 언어 모델을 원활하게 배포하기 위해서는 고성능 추론 엔진인 vLLM을 활용한 정밀한 파라미터 튜닝이 필수적입니다.
실무 환경에서는 python3 -m vllm.entrypoints.openai.api_server 모듈을 실행하여 기존 인프라와 즉각 연동 가능한 OpenAI 호환 REST API 엔드포인트를 손쉽게 구축할 수 있습니다.
이를 통해 애플리케이션 계층의 코드 변경을 최소화하면서 양자화 모델 기반의 고속 추론 서빙 파이프라인을 확보하게 됩니다.
모델의 양자화 방식에 따라 최적화된 CLI 명령어를 구성해야 합니다.
Target A 자료에 명시된 4비트 기반의 solidrust/gemma-2-27b-it-AWQ 모델을 서빙할 때는 가중치 압축 방식을 지정하는 --quantization awq 플래그와 함께 안정적인 8K 토큰 처리를 위한 --max-model-len 8192를 적용합니다.
이와 함께 GPU 메모리 점유율을 제어하는 --gpu-memory-utilization 0.90을 설정하여 초기 구동 및 메모리 풀을 안정화합니다.
반면 8비트 부동소수점 형식을 사용하는 neuralmagic/gemma-2-27b-it-FP8 모델을 구동할 때는 양자화 플래그를 --quantization fp8로 지정합니다.
이 구성에서는 연산 정밀도 유지와 더불어 메모리 활용성을 극대화하기 위해 --gpu-memory-utilization 0.92와 후술할 KV 캐시 압축 파라미터를 동시에 지정하여 처리 효율을 극대화합니다.
| 구분 | AWQ 서빙 구성 | FP8 통합 서빙 구성 |
|---|---|---|
| 대상 모델 | solidrust/gemma-2-27b-it-AWQ | neuralmagic/gemma-2-27b-it-FP8 |
| 양자화 파라미터 | --quantization awq | --quantization fp8 |
| GPU 메모리 할당 비율 | --gpu-memory-utilization 0.90 | --gpu-memory-utilization 0.92 |
| 추가 최적화 설정 | --max-model-len 8192 | --kv-cache-dtype fp8 |
--kv-cache-dtype fp8 설정을 통한 대화 컨텍스트 확장
27B 규모의 거대 모델을 단일 GPU에서 구동할 때 발생하는 주요 병목 중 하나는 문맥 길이가 길어질수록 급격히 증가하는 KV 캐시(Key-Value Cache) 메모리 부하입니다.
Target A에 따르면 vLLM 서빙 시 --kv-cache-dtype fp8 파라미터를 적용하면 모델 가중치뿐만 아니라 대화 기록(KV)이 저장되는 메모리 공간을 절반으로 압축할 수 있습니다.
이러한 캐시 압축 기법을 도입함으로써 제한된 VRAM 내에서도 8K 이상 장문 컨텍스트를 무리 없이 수용할 수 있는 여유 공간이 확보됩니다.
장기 대화 이력을 유지하거나 방대한 문서를 한 번에 입력해야 하는 RAG(검색 증강 생성) 시스템 구축 시 지연시간을 낮추고 동시 요청 처리량을 대폭 확대하는 핵심 파라미터로 동작합니다.
런타임 OOM 방지를 위한 GPU 메모리 할당 비율(0.90~0.92) 최적화
vLLM 엔진은 기동 시 지정된 비율만큼 GPU 메모리를 사전 할당하여 자체 블록 할당자(PagedAttention) 풀을 구성합니다.
그러나 gpu-memory-utilization 값을 지나치게 높게 설정할 경우 실제 추론 과정에서 발생하는 동적 액티베이션 및 시스템 임시 할당 공간이 부족해져 치명적인 런타임 OOM(Out Of Memory) 오류가 발생할 위험이 존재합니다.
따라서 시스템 안정성을 유지하기 위해서는 AWQ 모델 서빙 시 0.90 수준, FP8 통합 모델 서빙 시 0.92 수준으로 GPU 메모리 할당 비율을 정밀하게 제한해야 합니다.
이와 같은 임계값 제어는 동적 텐서 연산에 필요한 버퍼 공간을 안정적으로 남겨두어 장시간 서빙 중에도 서버 다운타임 없는 쾌적한 추론 환경을 보장합니다.
5. llama.cpp GGUF 런타임을 활용한 경량화 추론 및 하이브리드 오프로딩
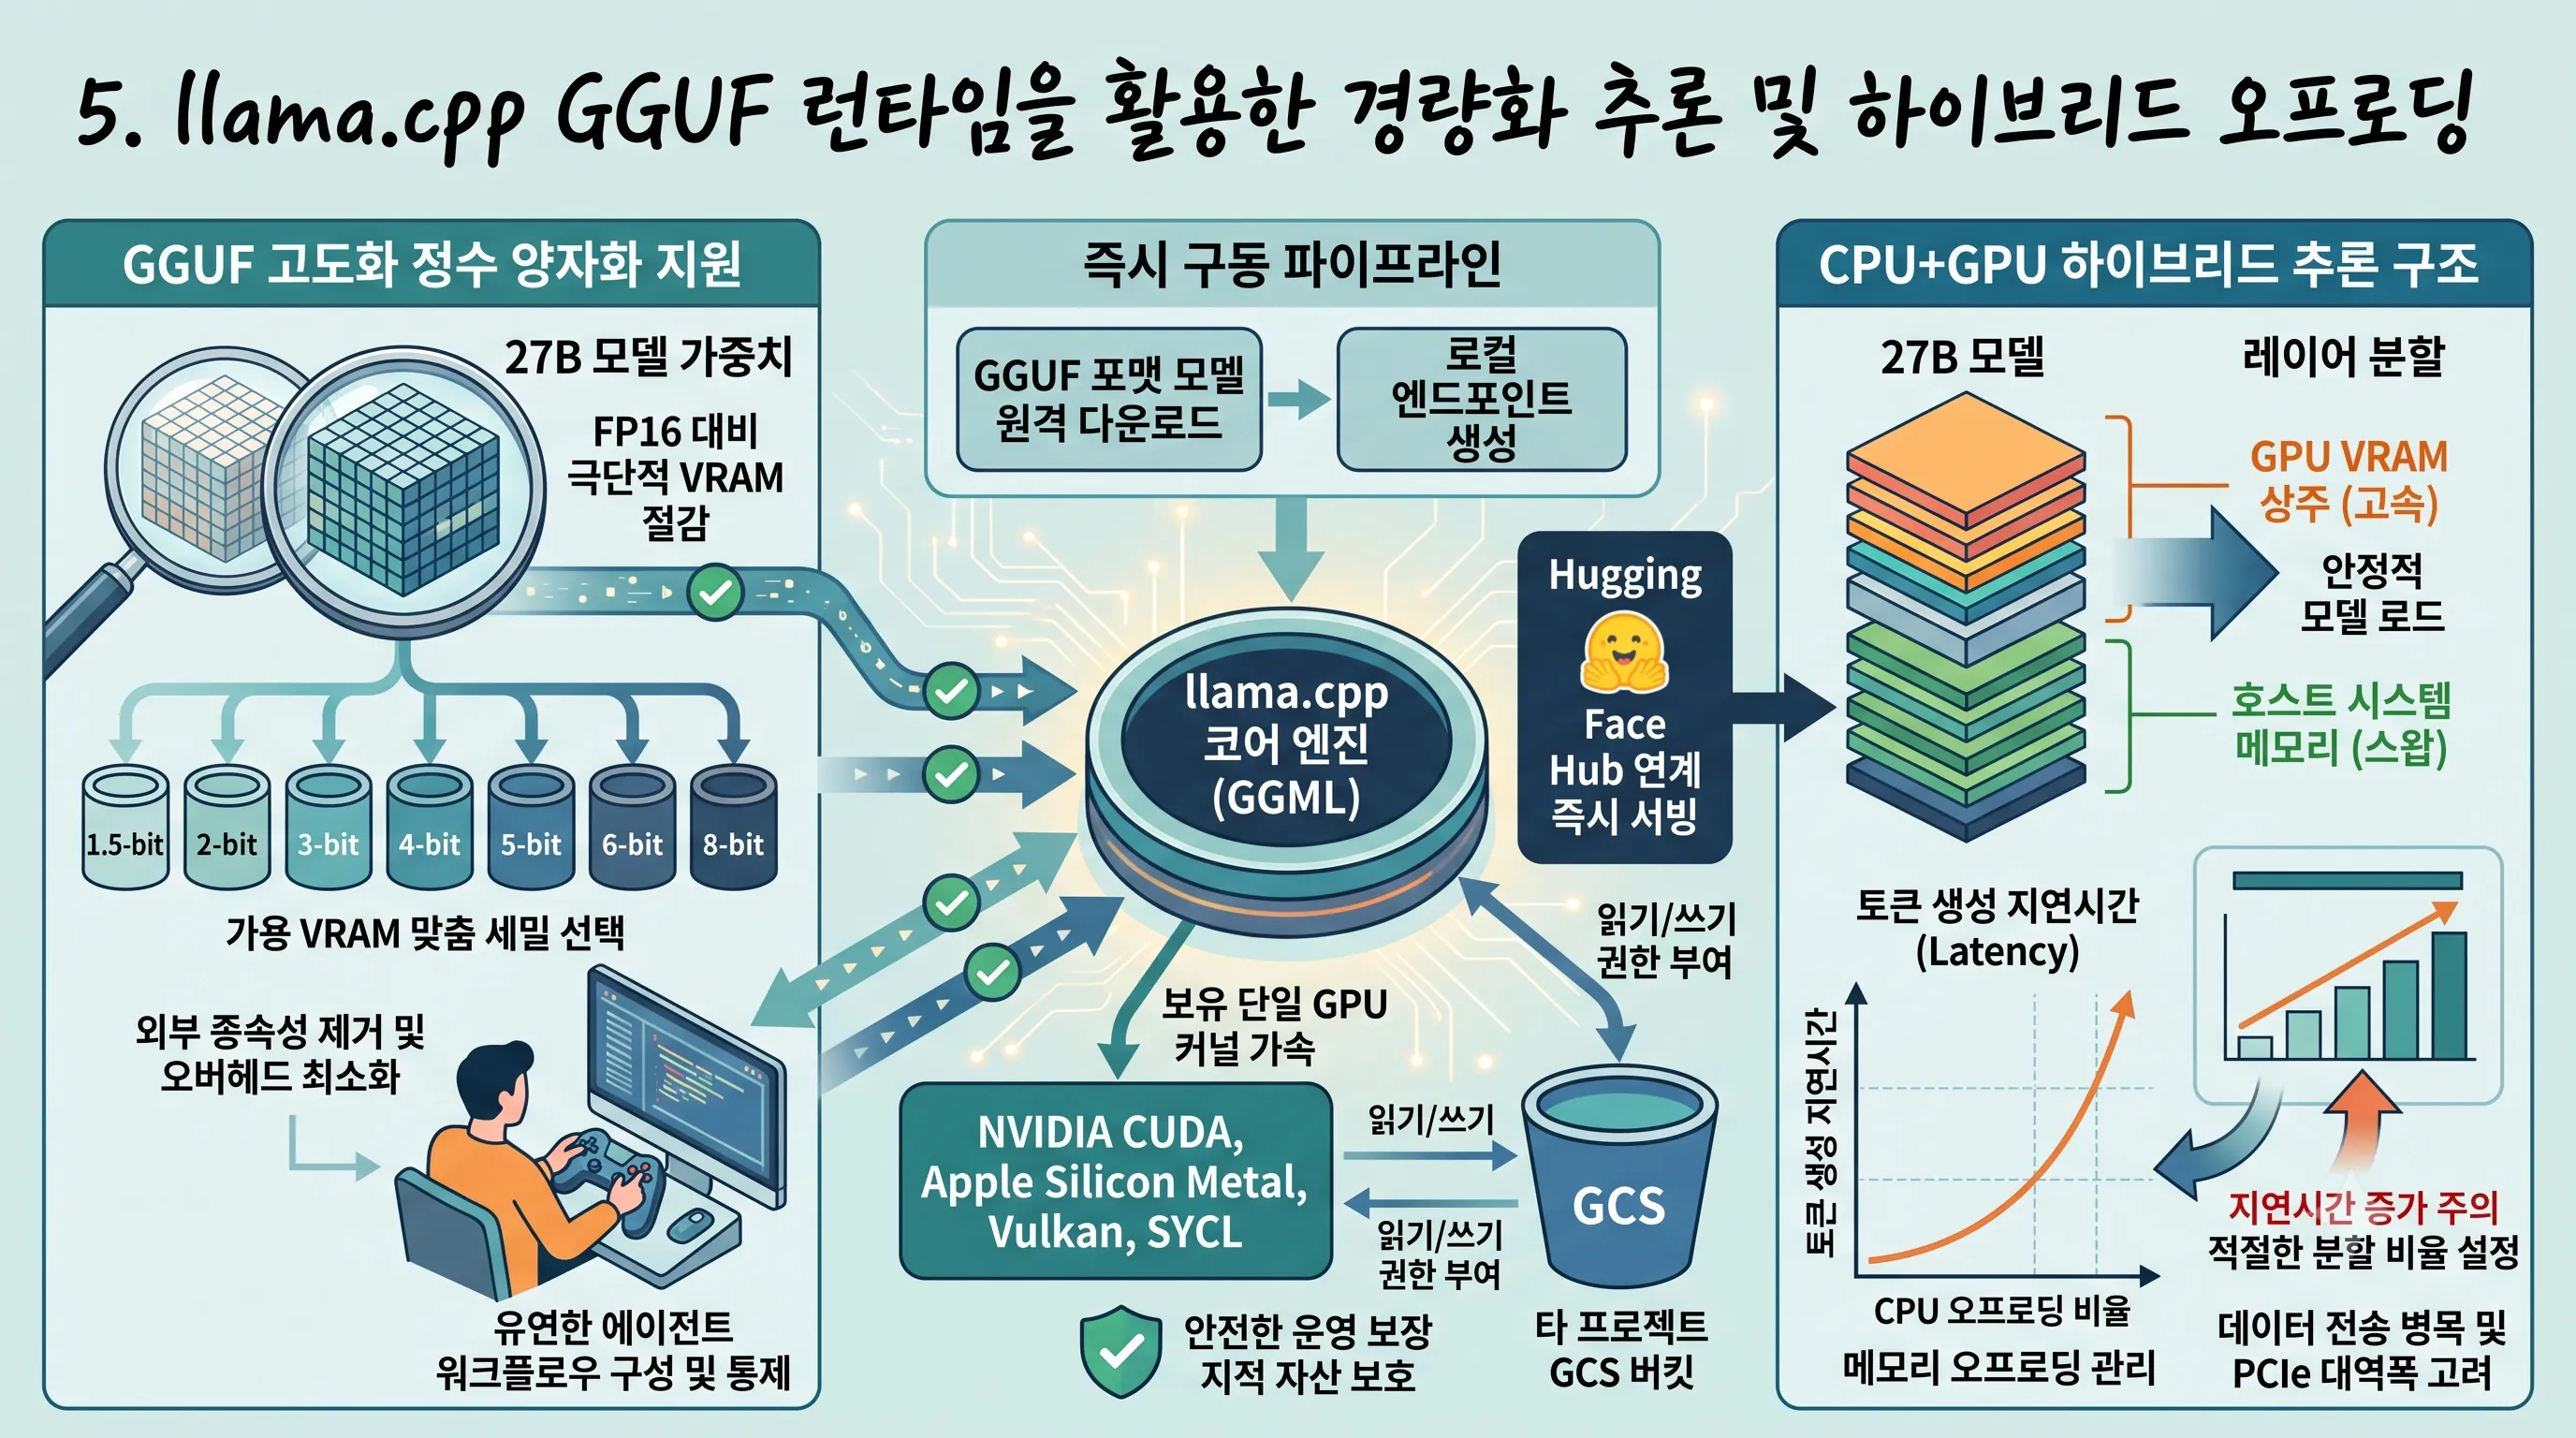
순수 C/C++ 기반 GGML 구조와 다양한 비트 단위 양자화 포맷
단일 가속 환경에서 27B 규모의 대규모 언어 모델을 원활하게 구동하기 위해서는 런타임 자체의 불필요한 시스템 자원 낭비를 줄이는 아키텍처가 필수적입니다.
llama.cpp는 별도의 무거운 런타임 의존성이 없는 순수 C/C++(GGML 라이브러리) 기반으로 설계되어 단일 시스템의 메모리와 CPU 리소스 오버헤드를 극적으로 최소화합니다.
이러한 경량 베이스라인 구조 덕분에 파이썬 기반 추론 스택 대비 기본 시스템 상주 용량을 획기적으로 낮추며 단일 GPU 자원을 모델 추론 연산에 온전히 집중시킬 수 있습니다.
메모리 점유율을 비약적으로 축소하는 핵심 기술은 GGUF 포맷이 제공하는 고도화된 정수 양자화 지원입니다.
공식 프로젝트(https://github.com/ggml-org/llama.cpp) 명세에 따르면, llama.cpp는 1.5-bit, 2-bit, 3-bit, 4-bit, 5-bit, 6-bit, 8-bit에 이르는 광범위한 정수 양자화 포맷을 포괄적으로 지원합니다.
따라서 27B 모델을 단일 고정 비트로 변환하는 데 그치지 않고, 가용 VRAM 용량에 맞추어 다양한 양자화 단계를 세밀하게 선택함으로써 메모리 제약을 효과적으로 우회할 수 있습니다.
| 구분 | 주요 기술 사양 및 지원 포맷 | 시스템 이점 |
|---|---|---|
| 런타임 코어 엔진 | 순수 C/C++ 기반 GGML 라이브러리 | 외부 종속성 제거 및 시스템 리소스 오버헤드 최소화 |
| 양자화 범위 | 1.5-bit ~ 8-bit 정수 양자화 | 대형 모델 가중치 압축을 통한 극단적 VRAM 절감 |
| 가속 백엔드 | NVIDIA CUDA, Apple Silicon Metal, AMD HIP, Vulkan, SYCL | 이종 하드웨어 환경에서의 커스텀 커널 연산 가속 |
Hugging Face 모델 허브 연계 즉시 서빙 명령어
llama.cpp 런타임은 배포 및 서빙 워크플로를 단순화하기 위해 강력한 자체 실행 바이너리를 기본 제공합니다.
복잡한 환경 설정이나 수동 변환 과정 없이도 llama cli 및 llama serve 명령어를 통해 Hugging Face Hub에 등록된 GGUF 포맷 모델을 직접 다운로드하고 즉시 구동할 수 있습니다.
이를 통해 27B 모델의 원격 다운로드부터 로컬 엔드포인트 생성까지 단일 파이프라인으로 일원화되어 운영 효율성을 크게 향상시킵니다.
또한 이 런타임은 범용적인 하드웨어 환경을 완벽히 흡수하도록 설계되었습니다.
NVIDIA CUDA 커스텀 커널 가속뿐만 아니라 Apple Silicon Metal, AMD HIP, Vulkan, SYCL 등 다양한 백엔드를 기본 가속 엔진으로 지원합니다.
결과적으로 특정 하드웨어 제조사에 종속되지 않고 보유한 단일 GPU 자원의 커널 연산 잠재력을 최대한 끌어올릴 수 있습니다.
CPU+GPU 하이브리드 적재 전략과 메모리 오프로딩 지연시간 관리
단일 GPU의 물리적 VRAM 용량이 27B 모델 전체를 담기에 부족할 경우, 시스템 메모리를 보조 수단으로 병합하는 CPU+GPU 하이브리드 추론 구조가 작동합니다.
llama.cpp는 모델의 레이어를 분할하여 일부는 초고속 GPU VRAM에, 나머지 용량 초과분은 호스트 시스템 메모리에 나누어 적재하는 지능형 오프로딩 메커니즘을 지원합니다.
이 방식으로 단일 GPU의 메모리 상한선에 걸려 실행이 불가능했던 대형 모델도 중단 없이 안정적으로 로드할 수 있습니다.
그러나 하이브리드 분할 적재를 운용할 때는 데이터 전송 병목에 따른 지연시간 특성을 정밀하게 고려해야 합니다.
공식 프로젝트 문서(https://github.com/ggml-org/llama.cpp)가 명시하듯, CPU 오프로딩 비율이 증가할수록 PCIe 대역폭 및 시스템 메모리 대역폭의 물리적 한계로 인해 토큰 생성 지연시간(Latency)이 필연적으로 증가합니다.
따라서 쾌적한 추론 속도를 확보하기 위해서는 적절한 비트 양자화 단계를 결합하여 가능한 한 많은 레이어를 GPU VRAM에 상주시키고 호스트 메모리 전송량을 최소화하는 분할 비율 설정이 필수적입니다.
6. 단일 GPU 워크스테이션 환경 27B 모델 로컬 구동 및 메모리 연계 기법
Ollama 기반 27B 오픈소스 모델 로컬 환경 셋업
단일 24GB VRAM GPU 워크스테이션 환경에서 대형 언어 모델(LLM)을 원활하게 구동하는 것은 로컬 연구 개발의 핵심 과제로 꼽힙니다.
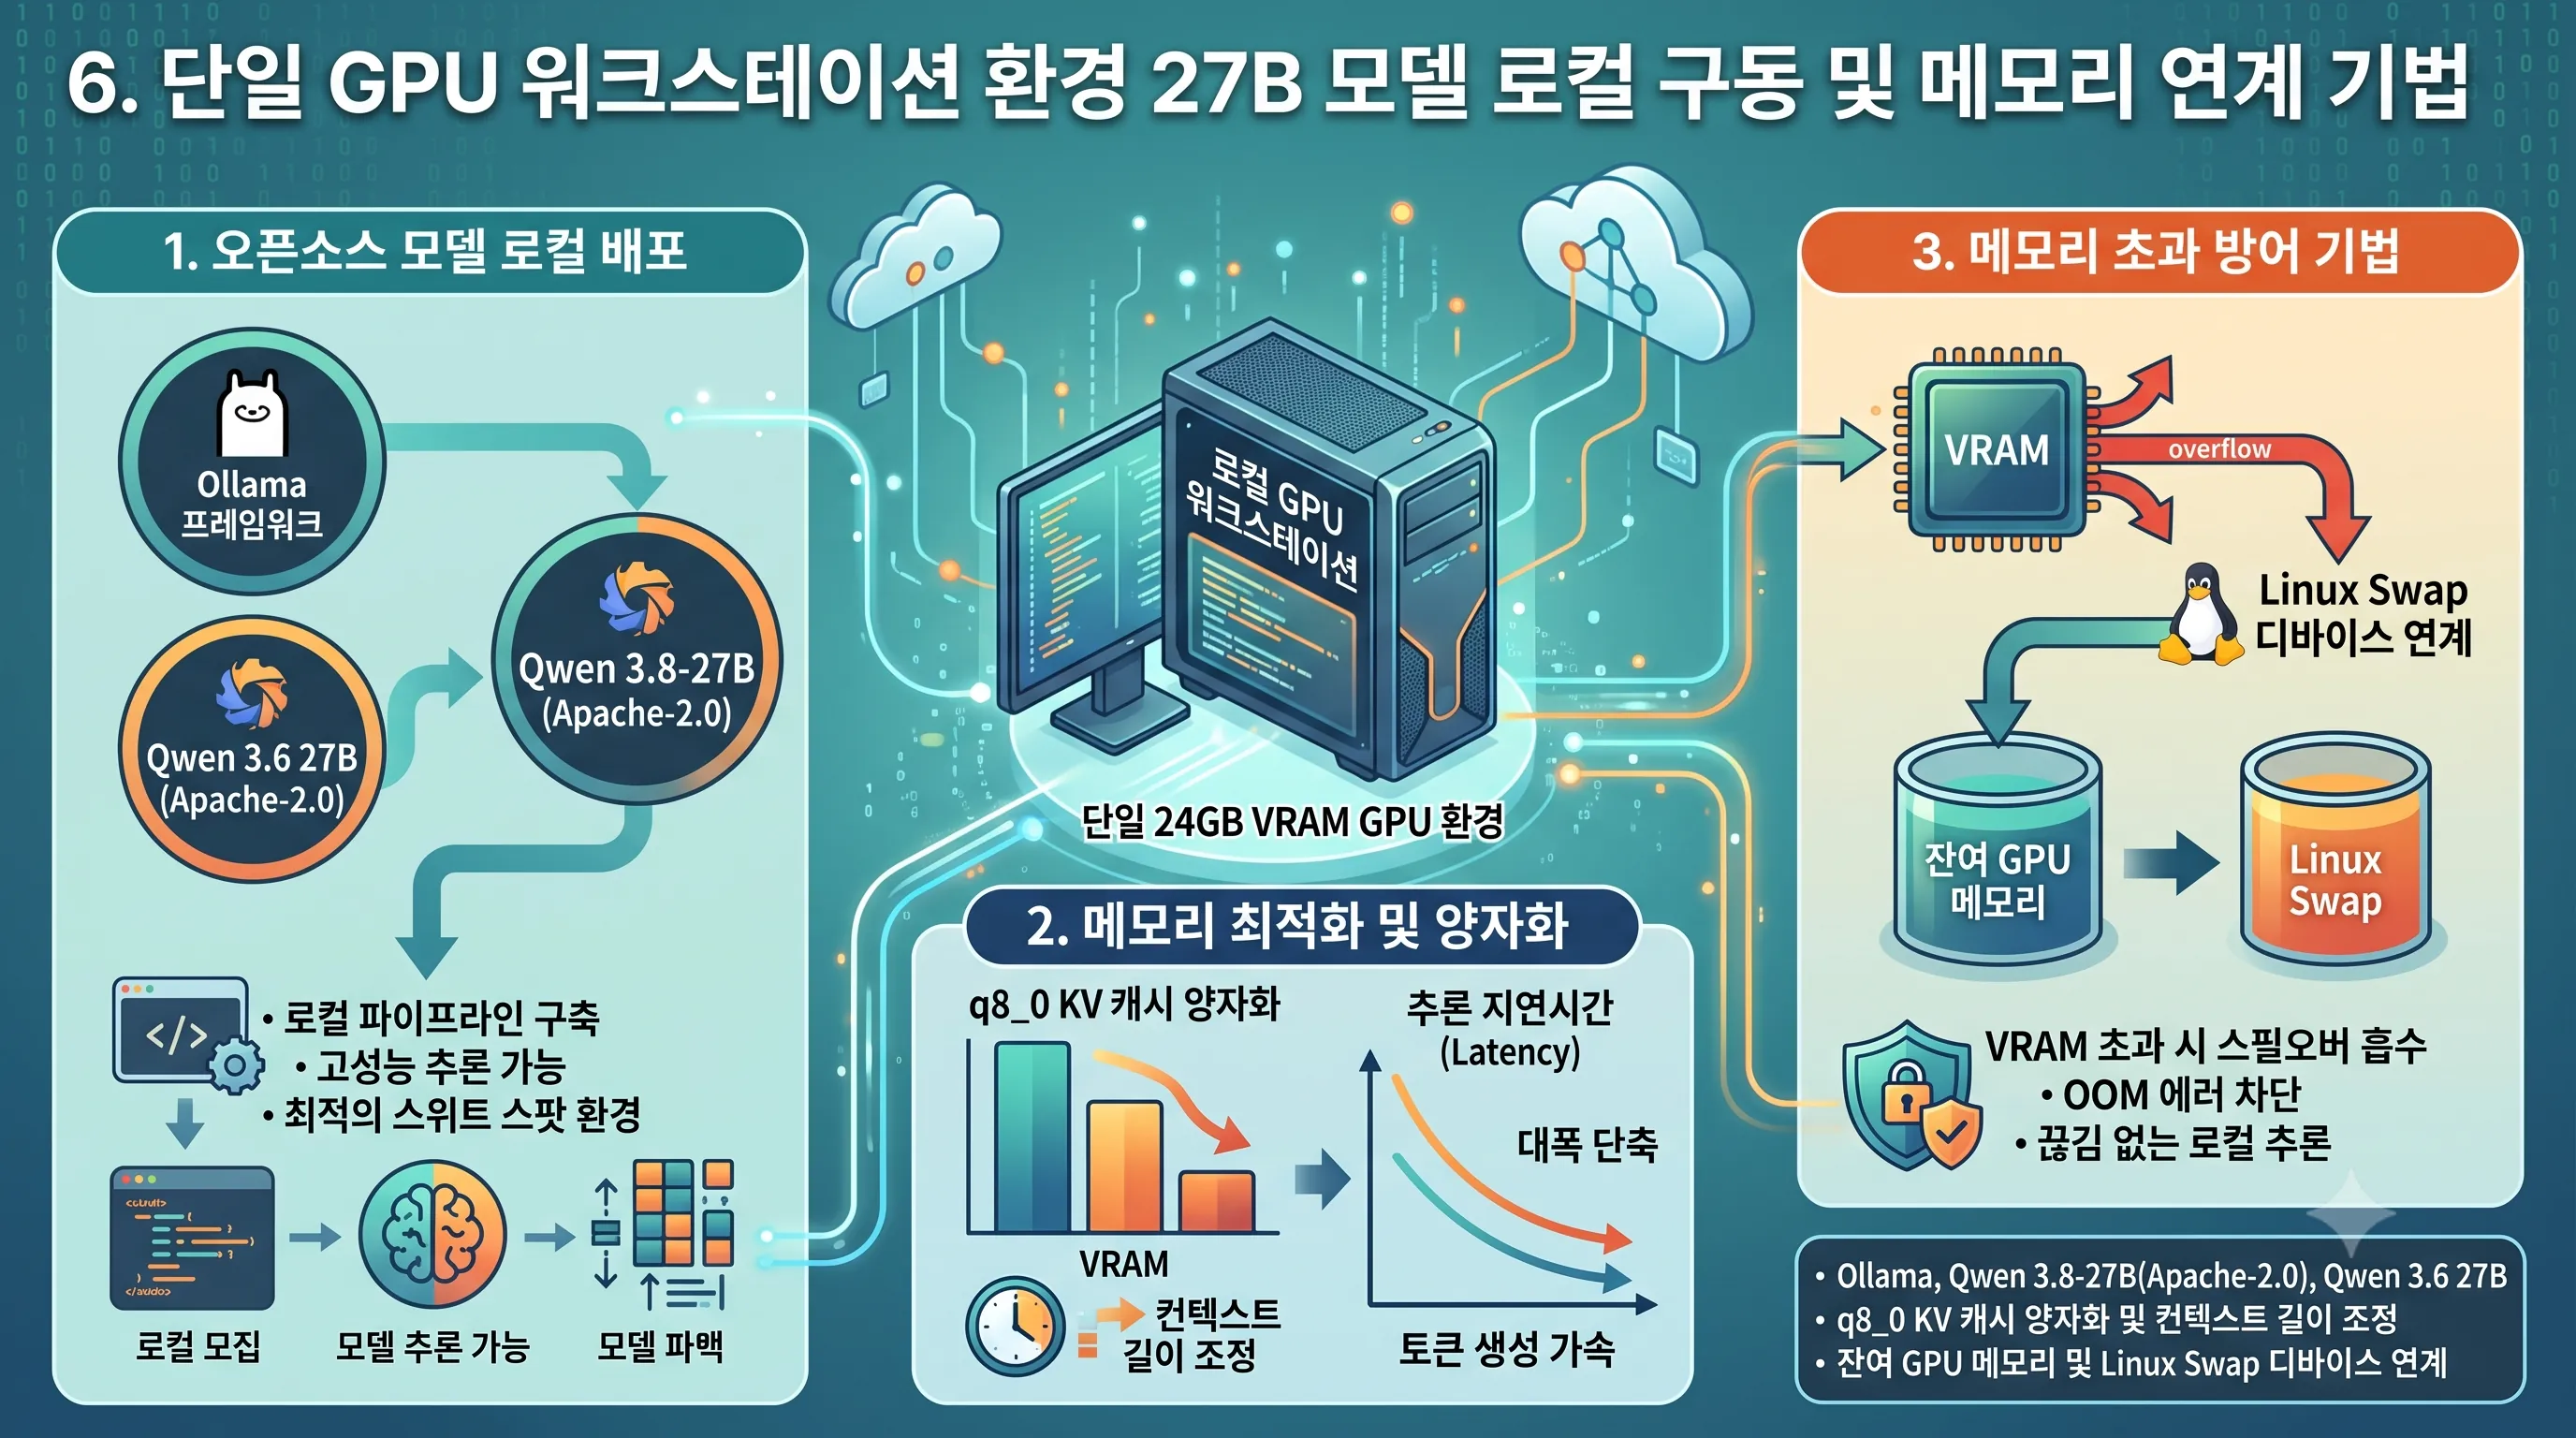
최근 Apache-2.0 오픈소스 라이선스 기반으로 정식 배포가 완료된 Qwen 3.8-27B 및 Qwen 3.6 27B 모델은 로컬 인프라에서도 고성능 추론을 가능하게 만드는 대표적인 선택지로 자리 잡았습니다.
경량화된 배포 프레임워크인 Ollama를 활용하면 단일 24GB GPU 인프라 내에서 27B급 파라미터를 탑재한 모델을 간편하게 로드하고 효율적인 로컬 파이프라인을 구축할 수 있습니다.
이러한 아키텍처는 모델의 성능과 VRAM 점유율, 그리고 추론 속도 간의 균형을 유지하면서 개발자가 실무에 즉각 투입할 수 있는 최적의 스위트 스팟 환경을 제공합니다.
KV 캐시 양자화(q8_0) 및 컨텍스트 길이 최적화
24GB VRAM이라는 물리적 한계 안에서 27B 모델을 쾌적하게 실행하기 위해서는 정밀한 메모리 관리와 양자화(Quantization) 기술의 적용이 필수적입니다.
추론 과정에서 동적으로 누적되는 어텐션 연산 부하를 완화하기 위해 q8_0 KV 캐시 양자화를 적용하여 메모리 사용량을 줄이고 추론 지연시간(Latency)을 대폭 단축할 수 있습니다.
이와 동시에 워크로드 특성에 맞춘 컨텍스트 길이 조정을 병행함으로써 불필요한 VRAM 사전 점유를 차단하고 안정적인 토큰 생성 속도를 유지할 수 있습니다.
이러한 기술적 조합은 단일 GPU 환경에서도 모델의 응답 속도를 극대화하여 쾌적한 인터랙티브 개발 경험을 보장합니다.
Linux Swap 연계를 통한 초과 메모리 병목 완화
대용량 프롬프트 처리나 장기 추론 작업 중 발생할 수 있는 VRAM 초과(Out of Memory) 현상을 방지하기 위해 정교한 메모리 연계 기법이 요구됩니다.
초과 VRAM 관리를 위해 시스템의 잔여 GPU 메모리와 Linux Swap 디바이스를 상호 연계하는 방식을 도입함으로써 메모리 스필오버(Spillover)를 유연하게 흡수할 수 있습니다.
물리 메모리 한계를 넘어서는 순간에도 프로세스가 강제 중단되지 않도록 보호하는 메모리 연계 활용 체계를 갖춤으로써 끊김 없는 로컬 추론 파이프라인을 유지하게 됩니다.
| 최적화 영역 | 적용 기술 및 모델 | 주요 역할 및 시스템 효과 |
|---|---|---|
| 모델 로컬 배포 | Ollama, Qwen 3.8-27B(Apache-2.0), Qwen 3.6 27B | 단일 24GB VRAM 워크스테이션 환경 내 27B 대형 모델 온디바이스 구동 |
| 추론 지연시간 개선 | q8_0 KV 캐시 양자화 및 컨텍스트 길이 조정 | VRAM 점유율 최적화 및 추론 Latency 단축을 통한 토큰 생성 가속 |
| 메모리 초과 방어 | 잔여 GPU 메모리 및 Linux Swap 디바이스 연계 | VRAM 초과 시 OOM 에러 차단 및 로컬 개발 환경의 연속성 보장 |
관련 글