#Ollama
4개의 글
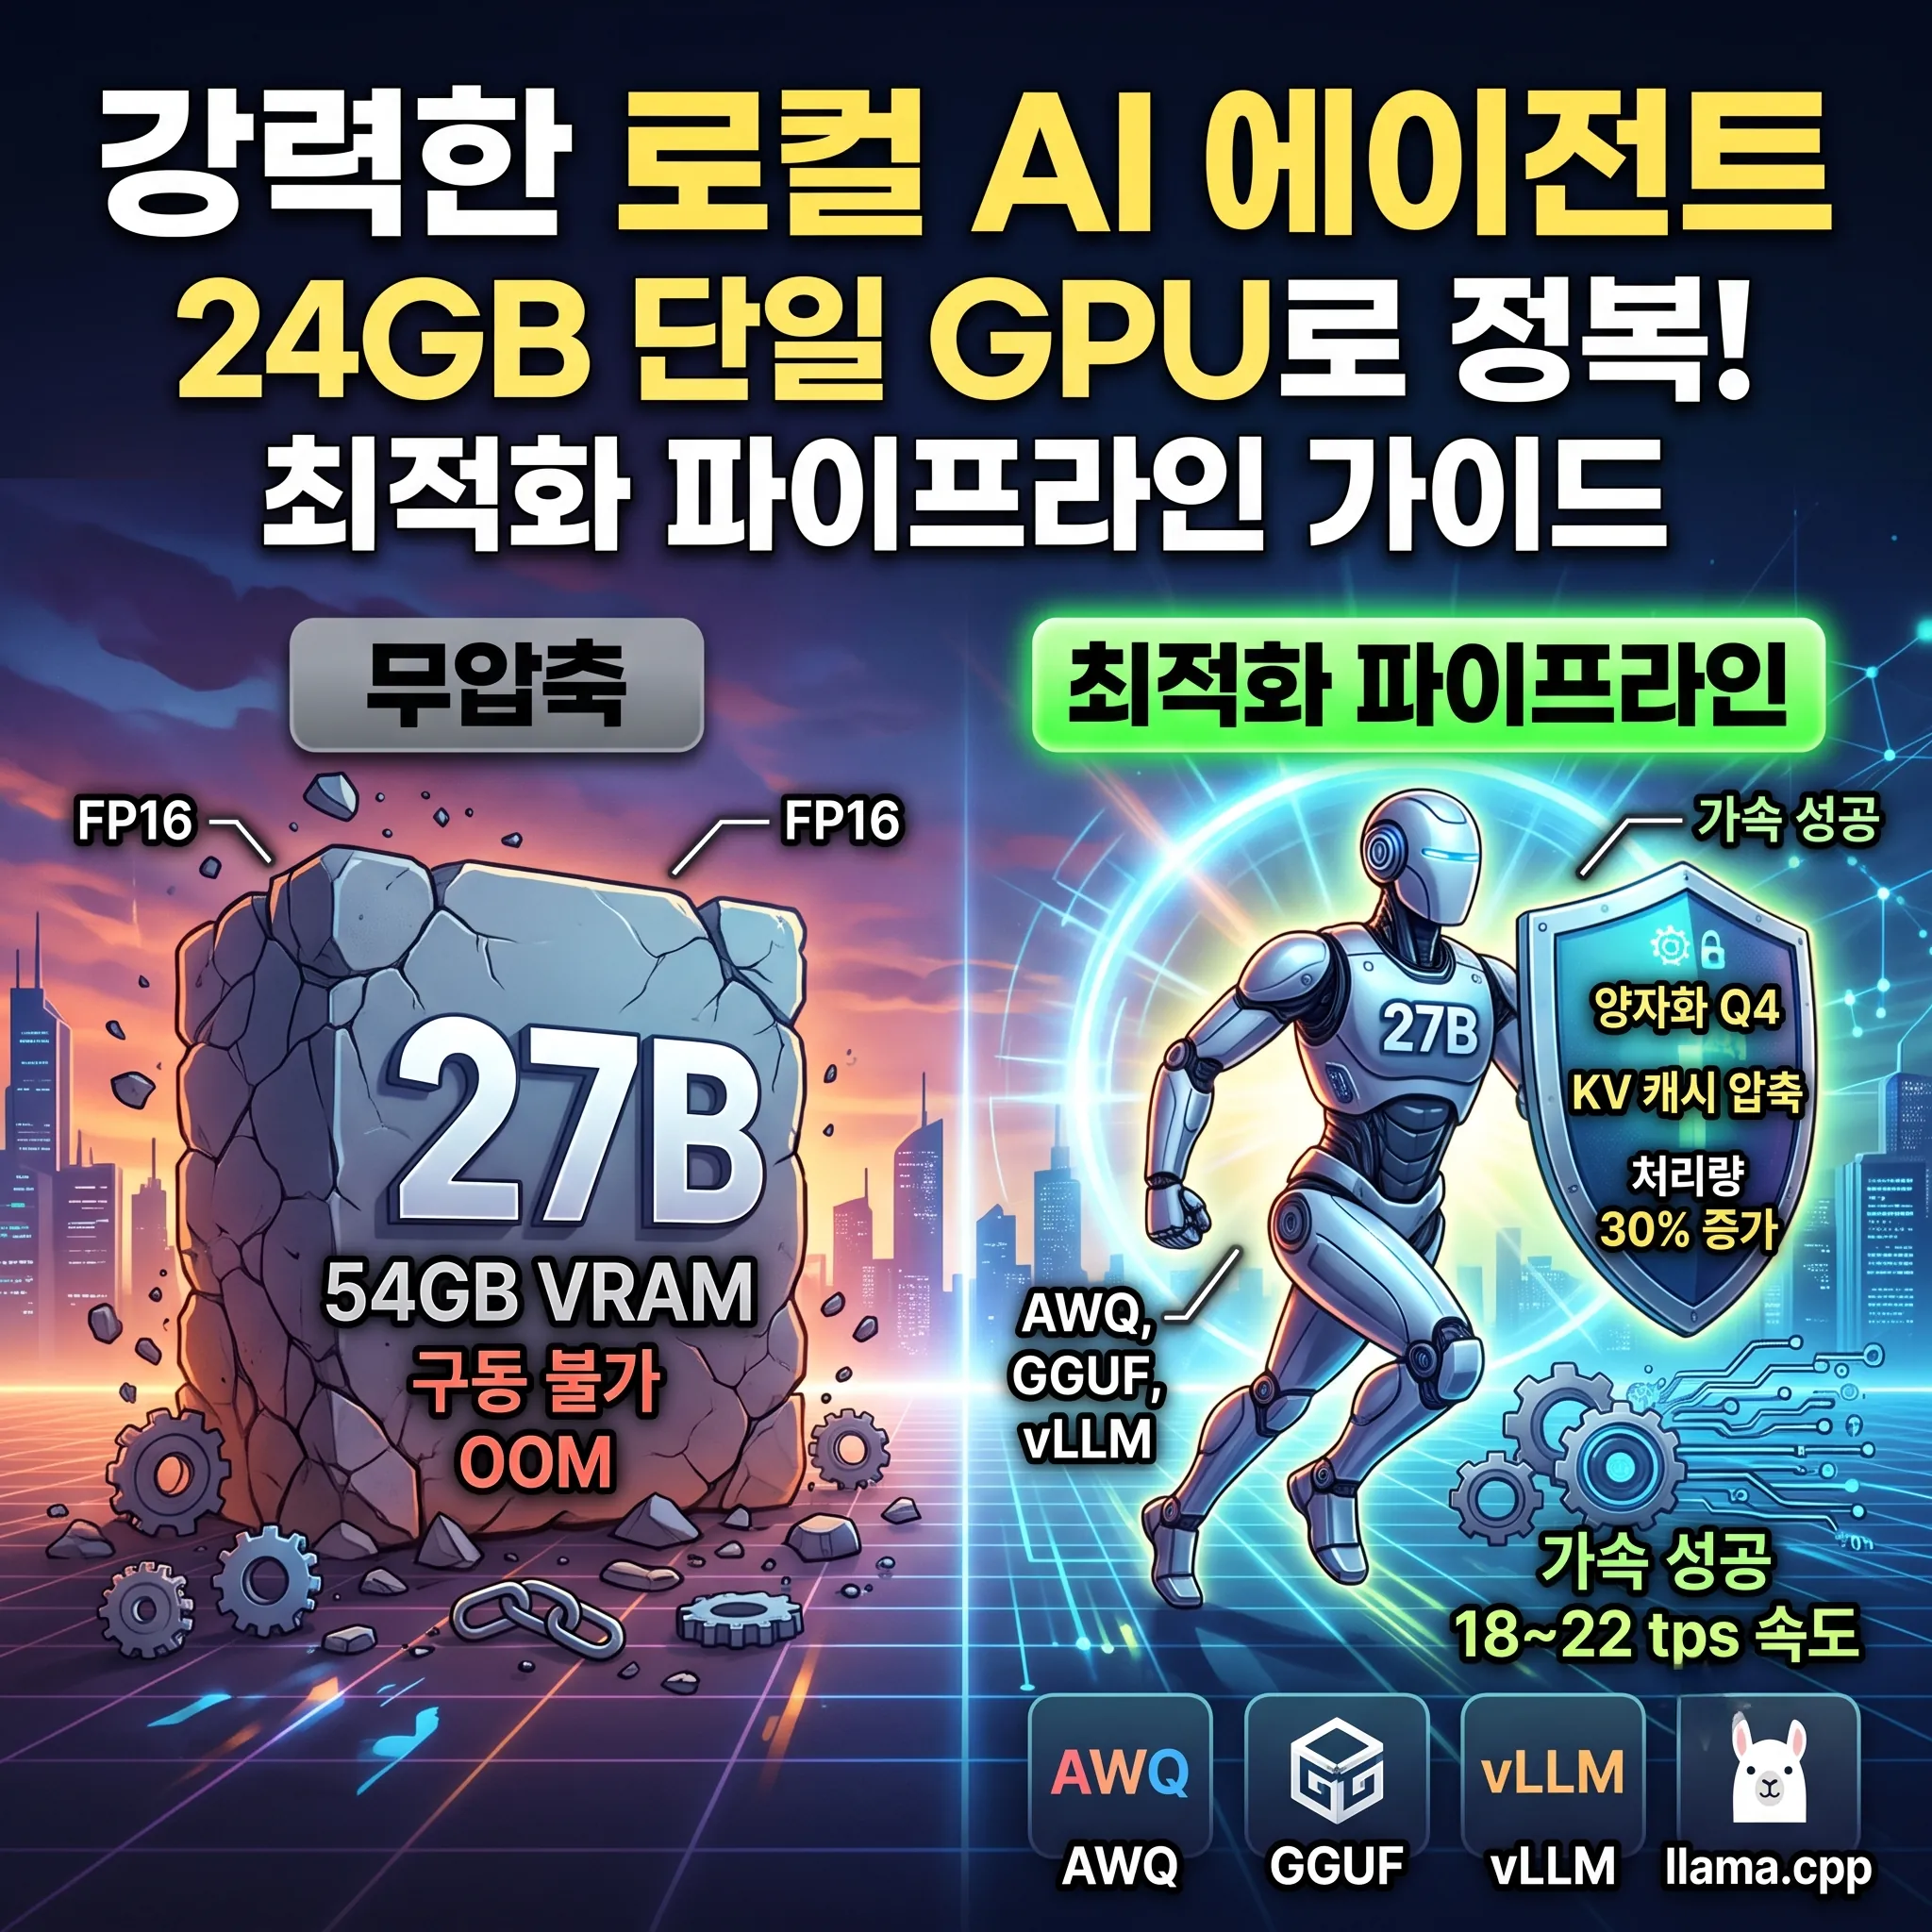
단일 GPU로 27B 모델 쾌적하게 돌리는 법: VRAM 절약과 지연시간(Latency) 단축 팁
단일 24GB GPU 환경에서 27B 대형 언어 모델을 VRAM OOM 없이 구동하는 3단계 최적화 파이프라인과 vLLM, llama.cpp 실무 설정법을 다룹니다. 로컬 워크스테이션에서 대형 모델을 운영하려는 개발자와 연구자를 위한 기술 가이드입니다.
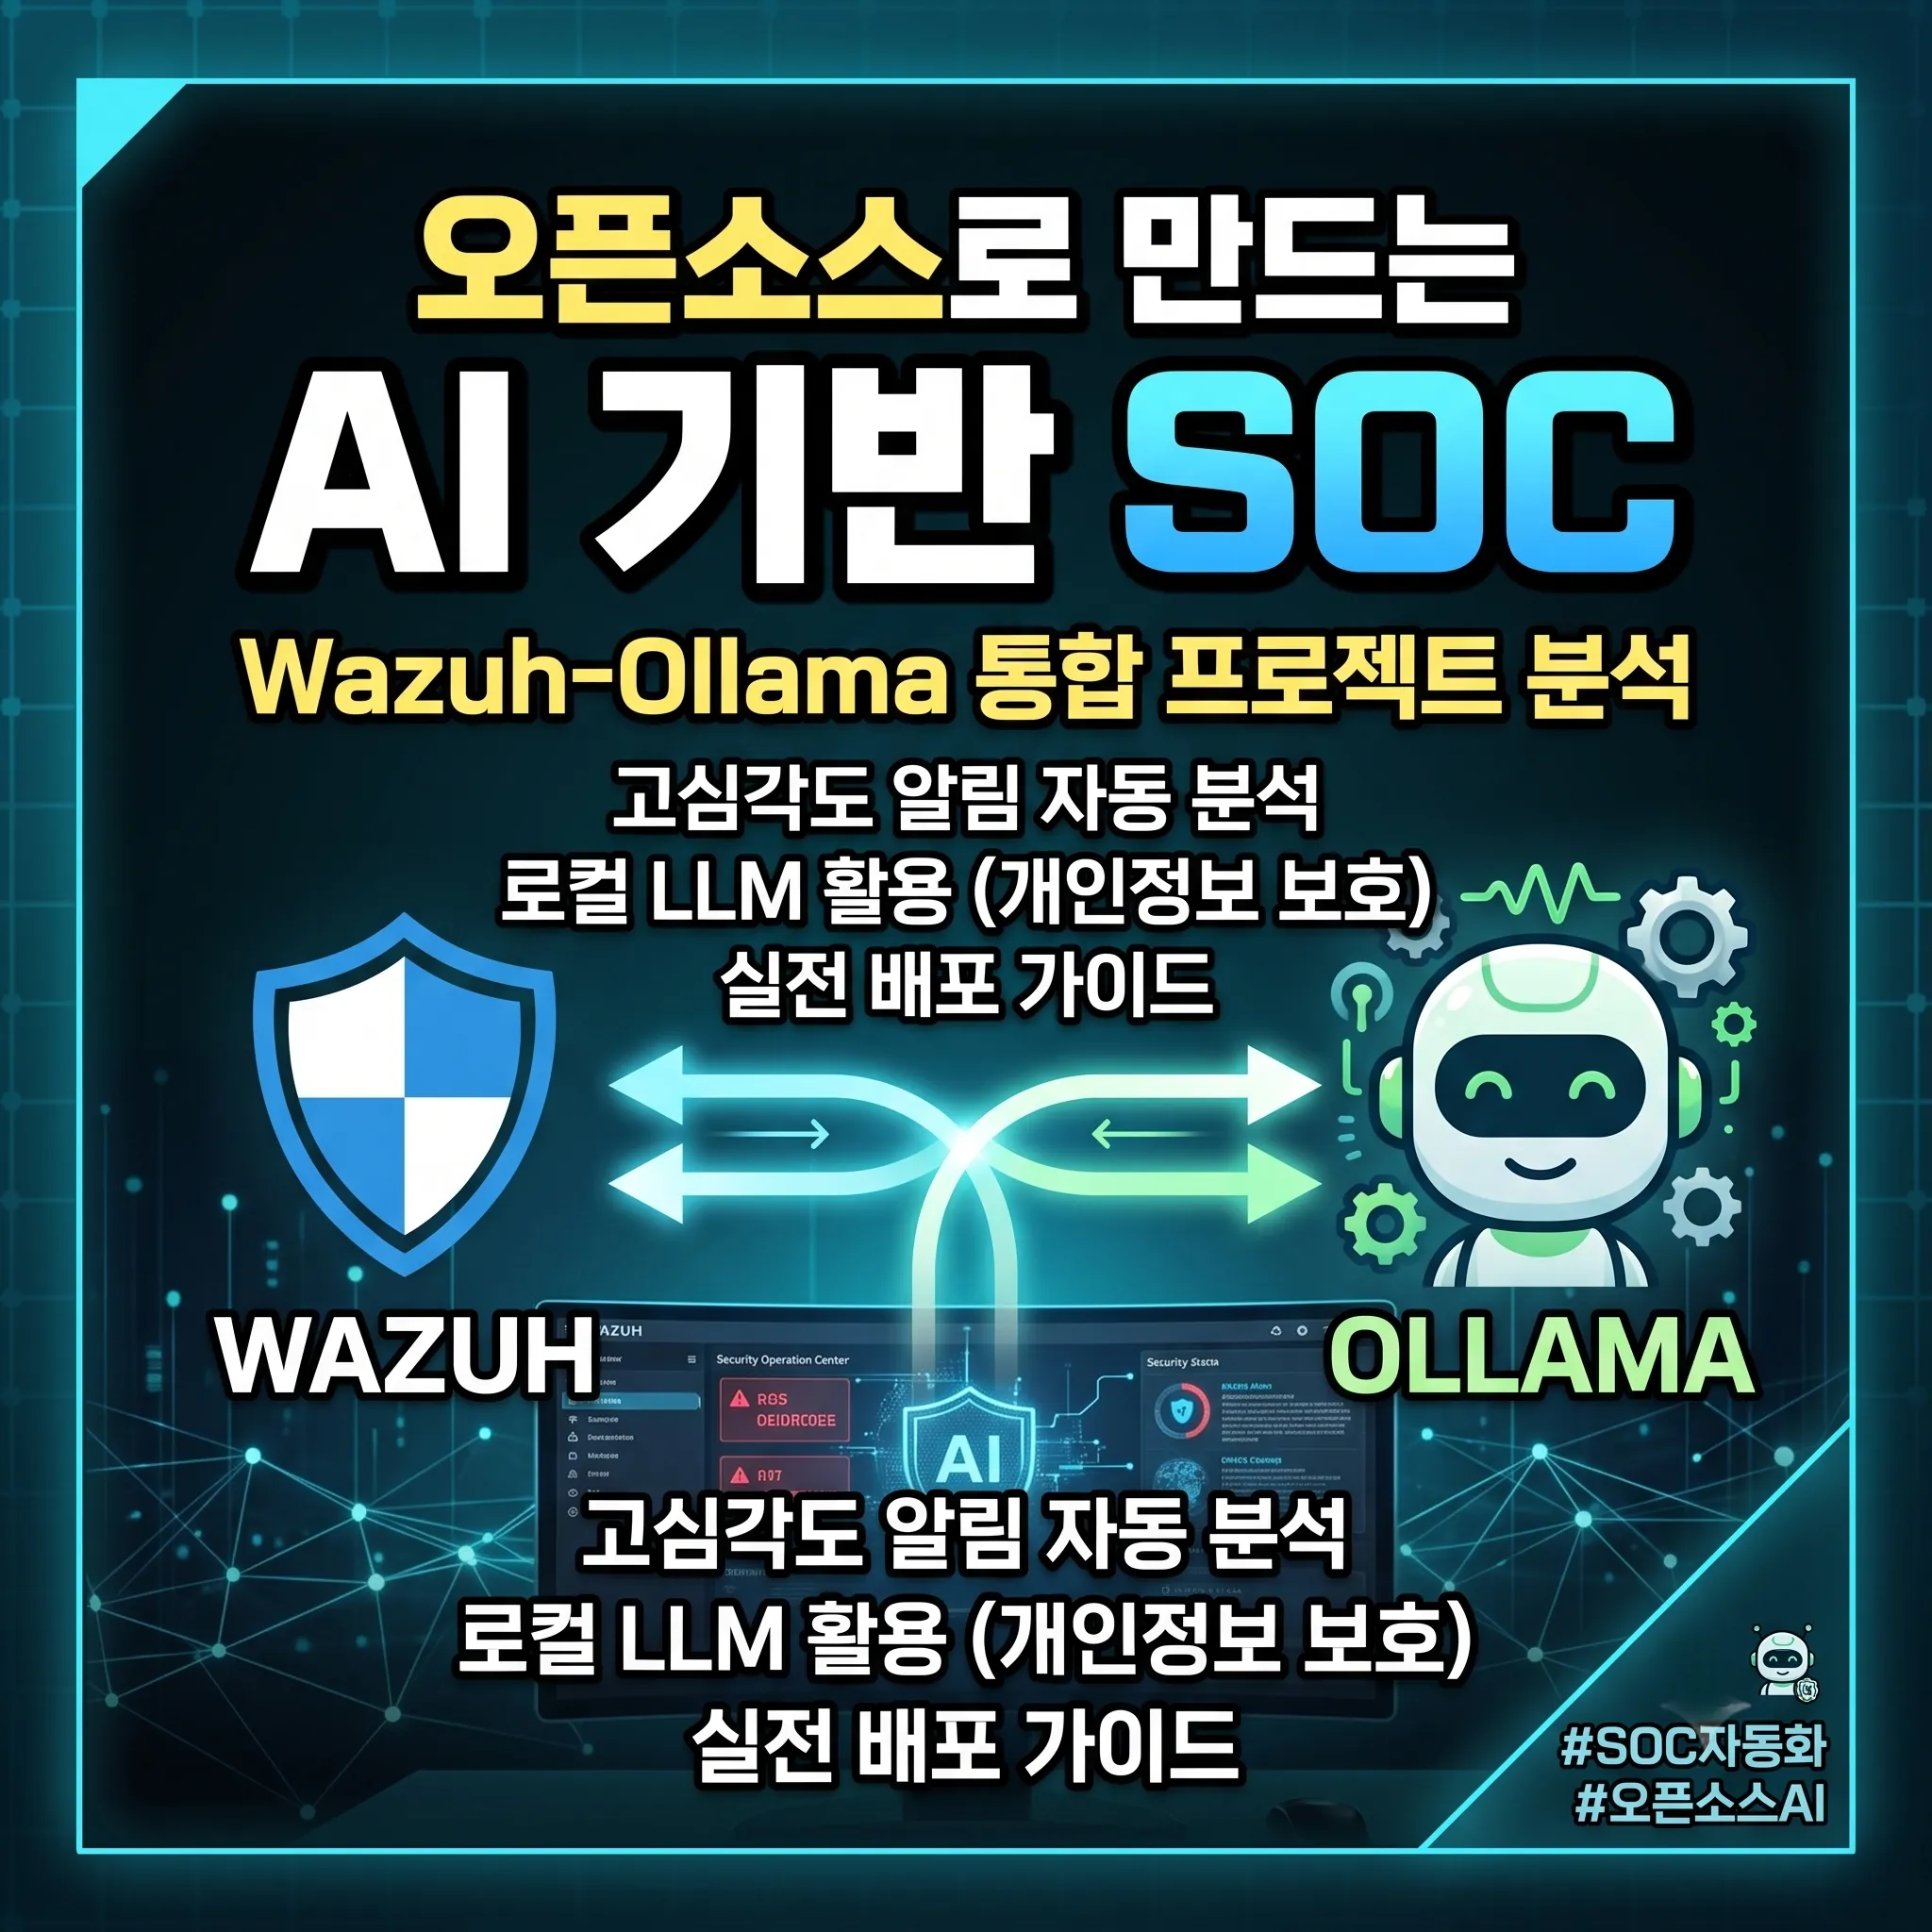
Wazuh-Ollama AI SOC: 로컬 LLM 보안 강화와 2026 AI 시장 핵심 분석
Wazuh-Ollama AI SOC로 보안 알림을 자동 분석하고 대응합니다. 로컬 LLM으로 데이터 주권 확보는 물론, 2026년 AI 시장 동향과 필수 무료 AI 툴까지 완벽 정리했습니다.
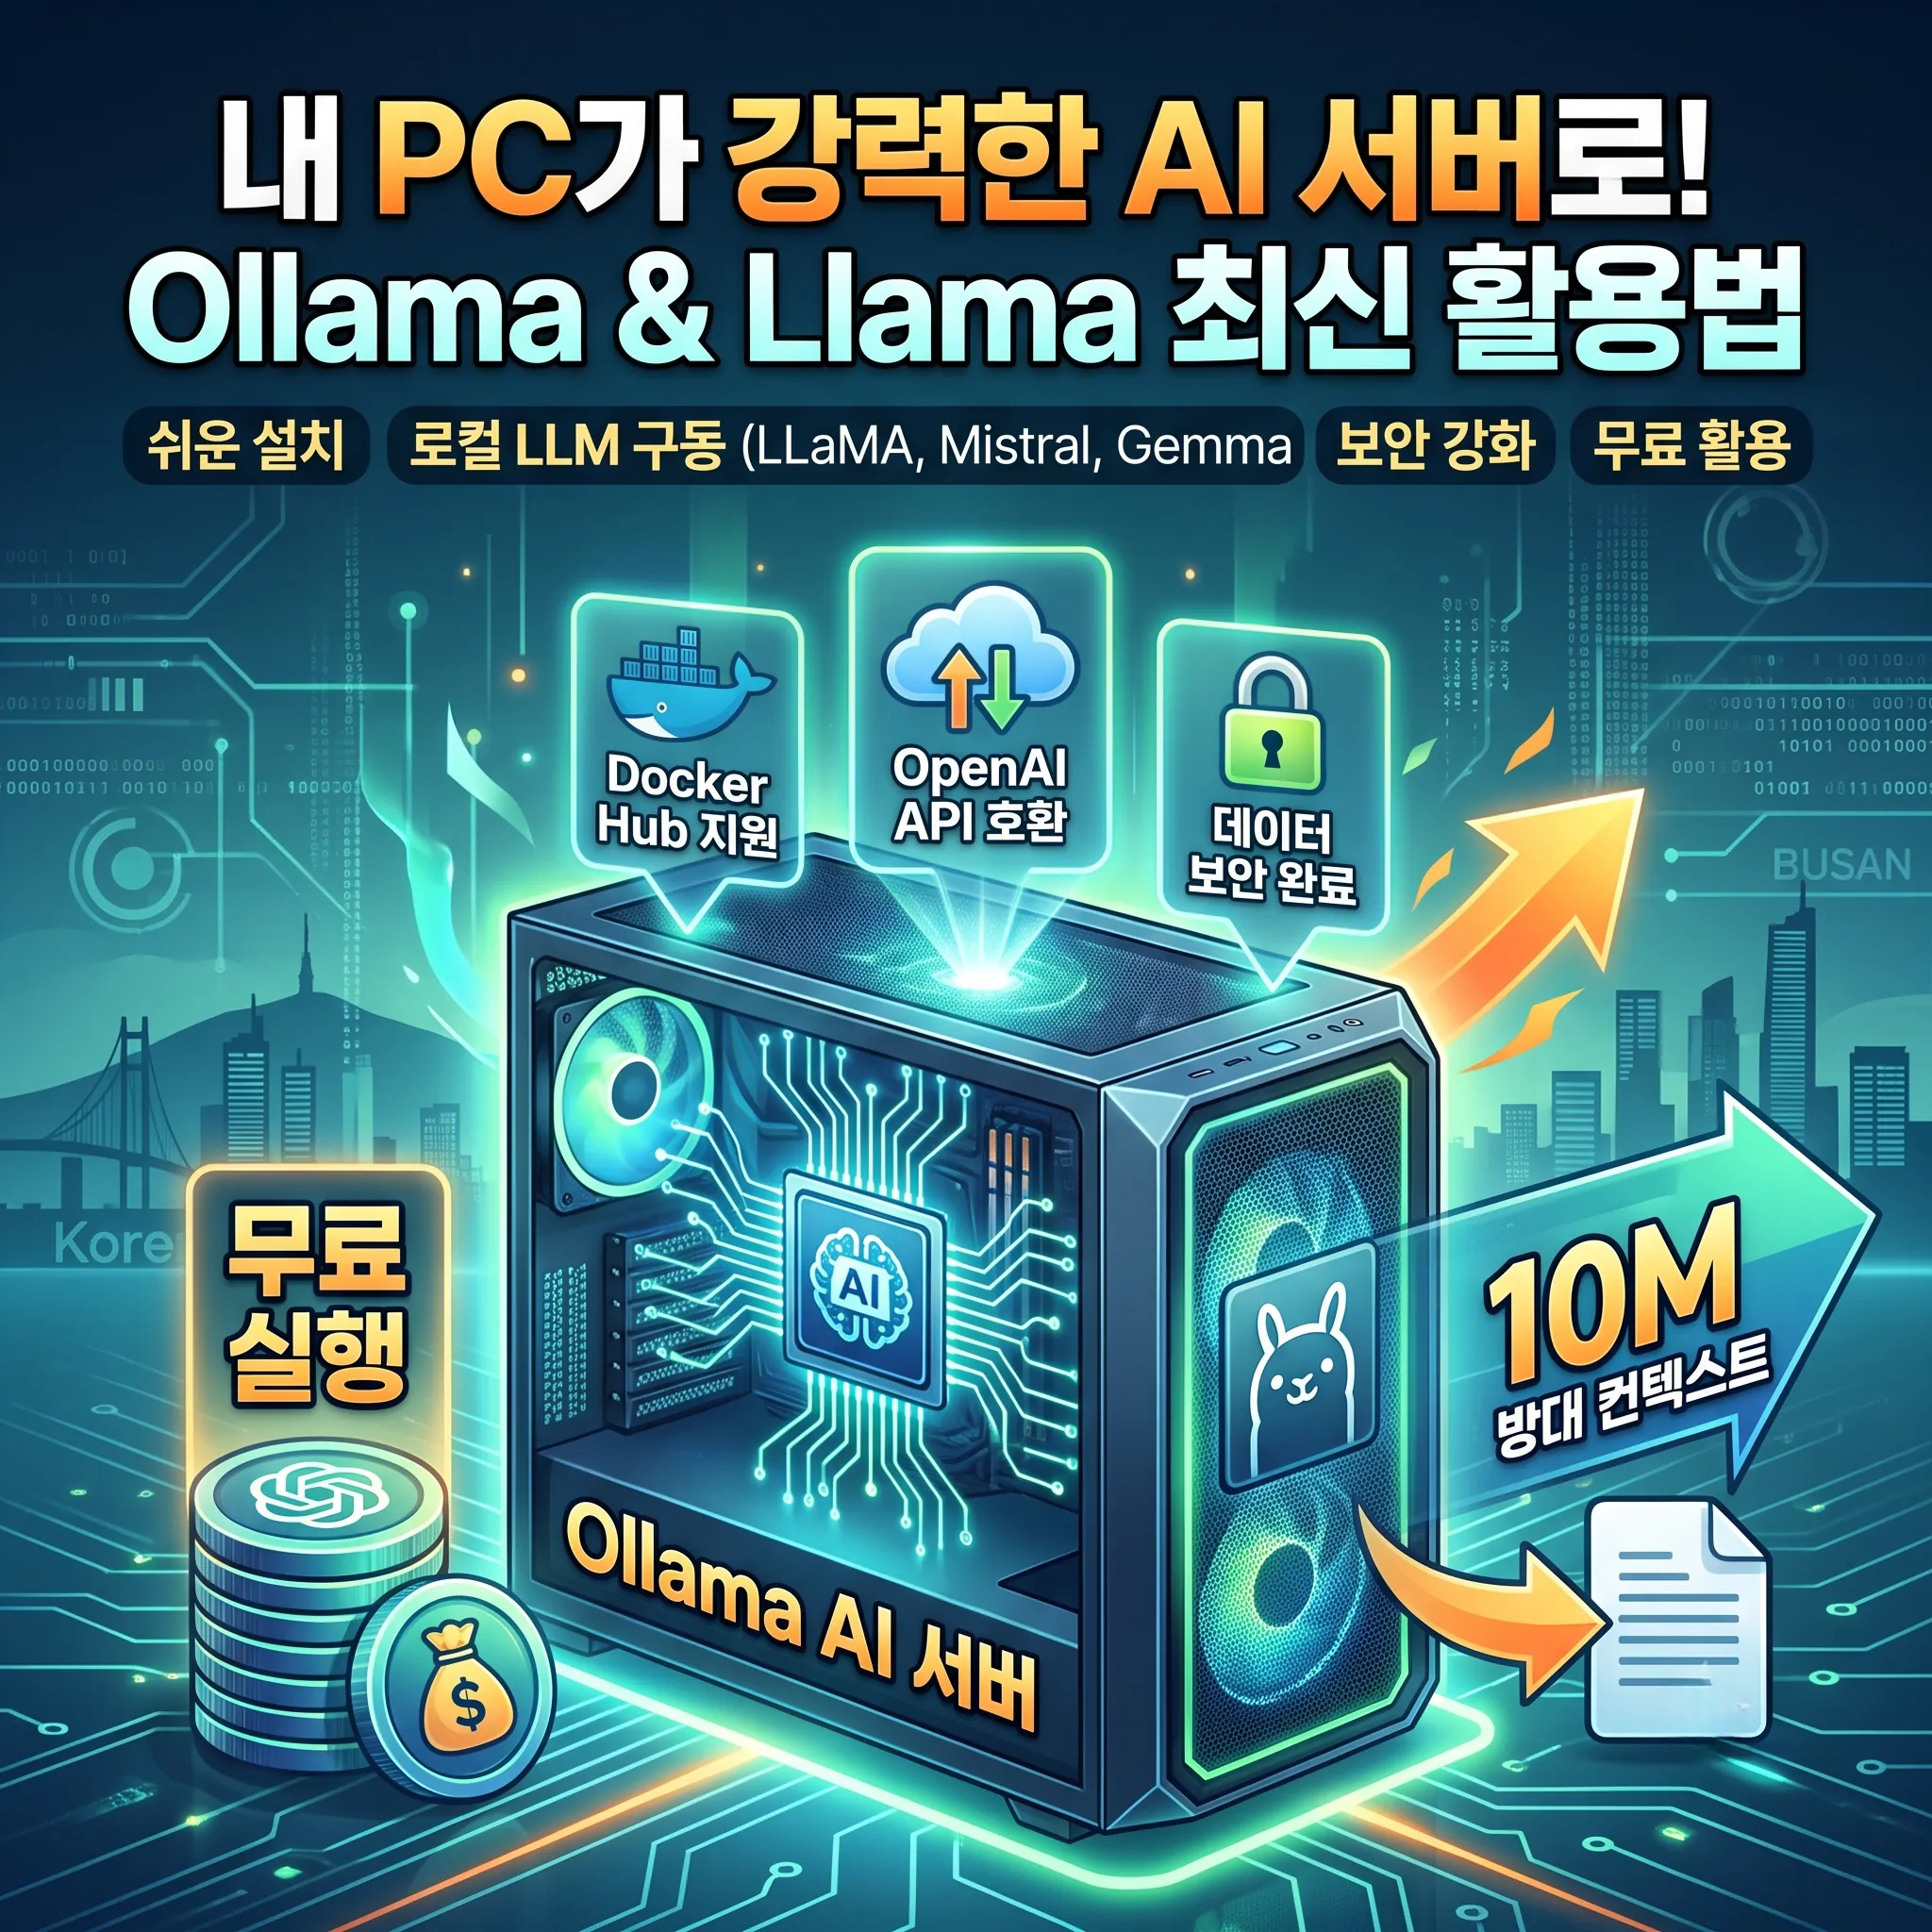
Ollama: 내 PC를 AI 서버로! Llama 3.1/4 무료 로컬 실행, 보안까지!
Ollama로 내 PC를 강력한 AI 서버로 변모시키세요! Llama 3.1 405B, Llama 4 멀티모달 모델을 무료로 로컬 실행하며 데이터 보안을 강화하고, OpenAI API 호환성 및 Docker 지원으로 개발 효율을 높입니다. AI 시대의 개인 컴퓨팅 혁신을 경험하세요.
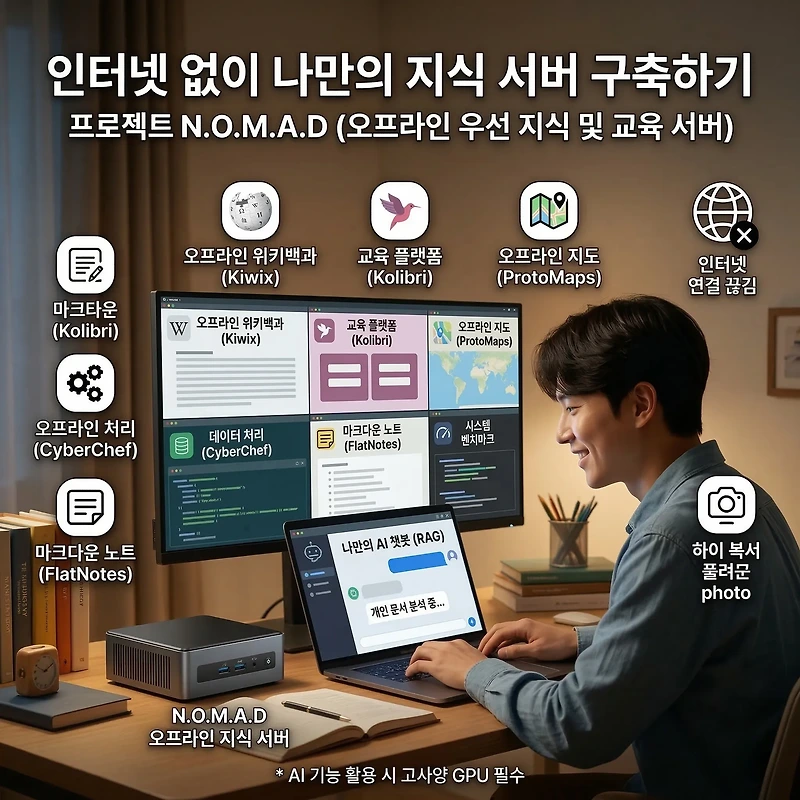
프로젝트 노마드(N.O.M.A.D): 인터넷 없는 AI 지식 서버 구축 가이드
프로젝트 노마드(N.O.M.A.D) 핵심 요약 오프라인 우선 지식 및 교육 서버: 인터넷 연결 없이 작동하는 오픈소스 솔루션으로, 디지털 격차 해소 및 안정적인 정보 접근성을 보장합니다. Apache License 2.0 기반으로 누구나 자유롭게 사용, 수정, 배포 가능합니다. 핵심...