#VRAM 최적화
2개의 글
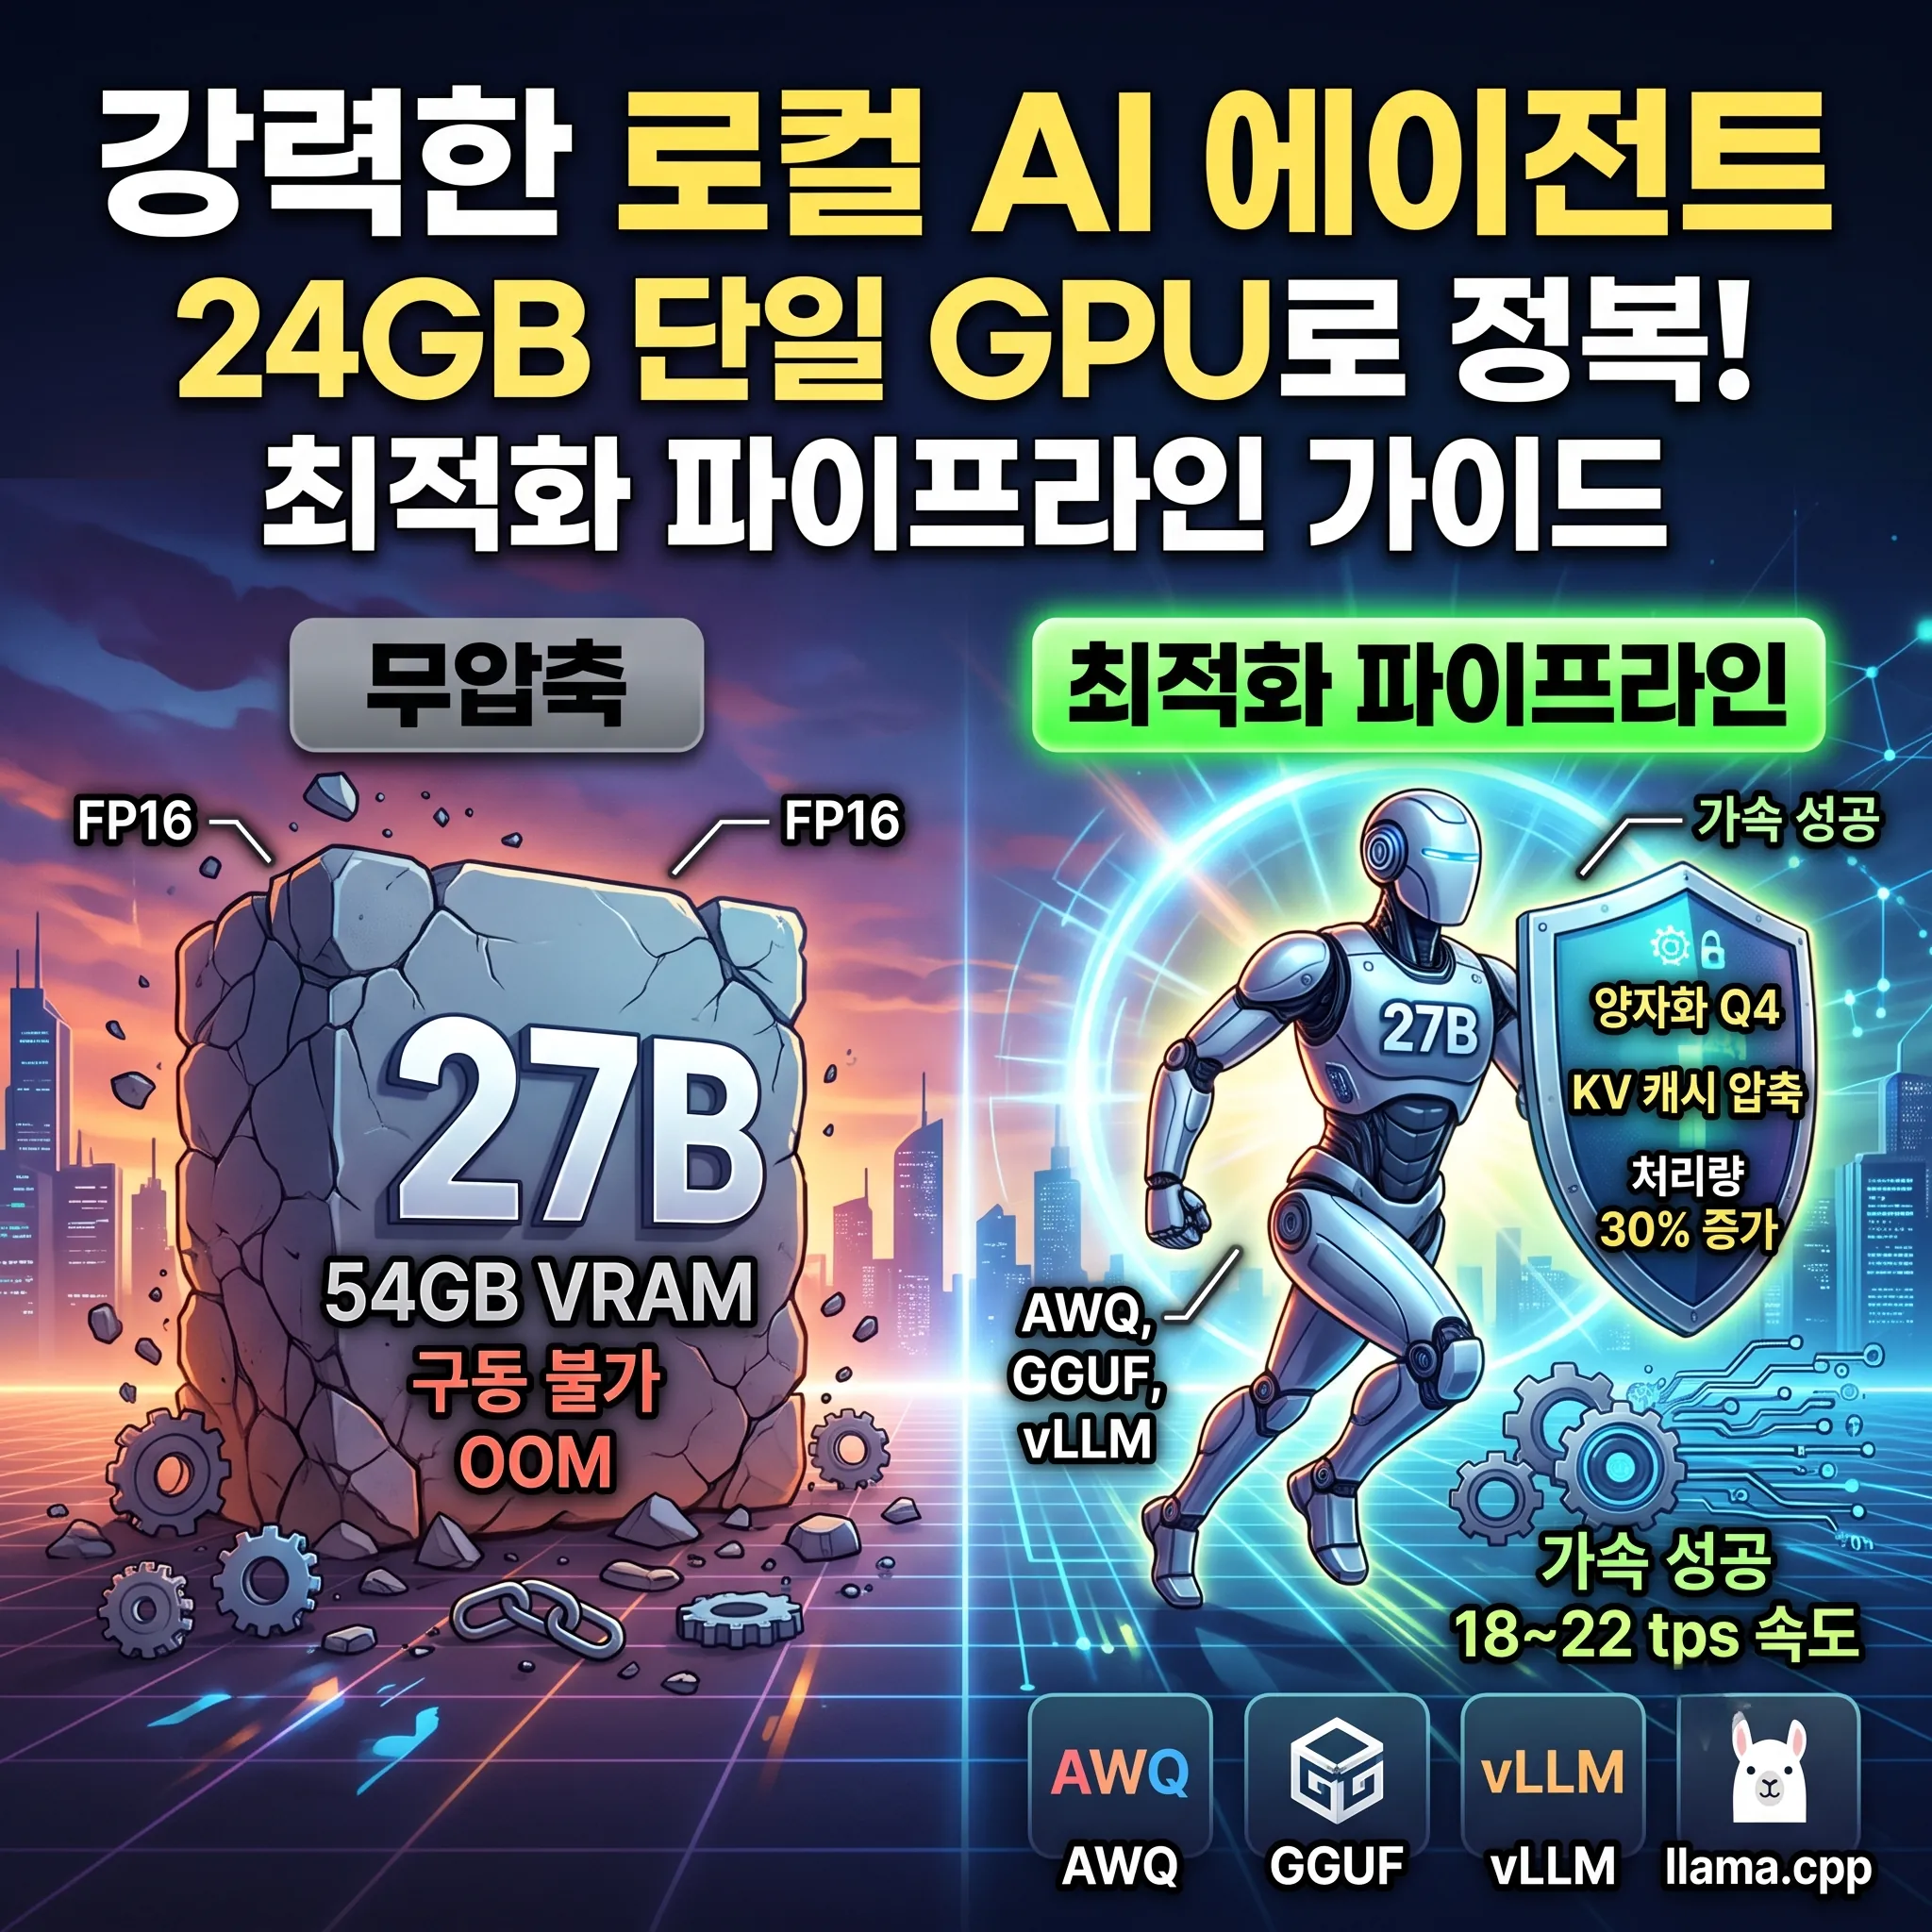
단일 GPU로 27B 모델 쾌적하게 돌리는 법: VRAM 절약과 지연시간(Latency) 단축 팁
단일 24GB GPU 환경에서 27B 대형 언어 모델을 VRAM OOM 없이 구동하는 3단계 최적화 파이프라인과 vLLM, llama.cpp 실무 설정법을 다룹니다. 로컬 워크스테이션에서 대형 모델을 운영하려는 개발자와 연구자를 위한 기술 가이드입니다.
AI 워크스테이션 '호갱' 탈출! 3분 만에 끝내는 VRAM 최적화 + 가성비 GPU 선택 '치트키'
2025년 겨울, 당신의 책상 밑에서 조용히 윙윙거리는 PC. 그것은 더 이상 단순한 게임기나 문서 작업 도구가 아닙니다. 이제 그것은 당신의 아이디어를 현실로 만드는 'AI 연금술의 도가니' 입니다. 로컬 환경에서 700억 개 이상의 파라미터를 가진 대규모 언어 모델(LLM)을 미세...