사내 구축용 초거대 오픈 모델 선택 가이드: 코딩, 문서 분석, 라이선스(Apache 2.0) 비교
- 법적 안전성(35%), 코딩 및 대규모 문서 분석(각 25%), 인프라 비용(15%)의 4대 가중치 평가 체계를 통해 워크로드별 최적 오픈 모델을 선별합니다.
- Apache 2.0 라이선스는 상용 제약이 없는 반면, Llama 계열 및 커스텀 라이선스는 MAU 7억 명 상한 및 모델 증류(Distillation) 금지 리스크를 수반합니다.
- vLLM 엔진은 PagedAttention, 연속 배칭, FP8 양자화 및 다차원 분산 병렬화를 지원하여 온프레미스 추론 처리량과 메모리 효율을 극대화합니다.
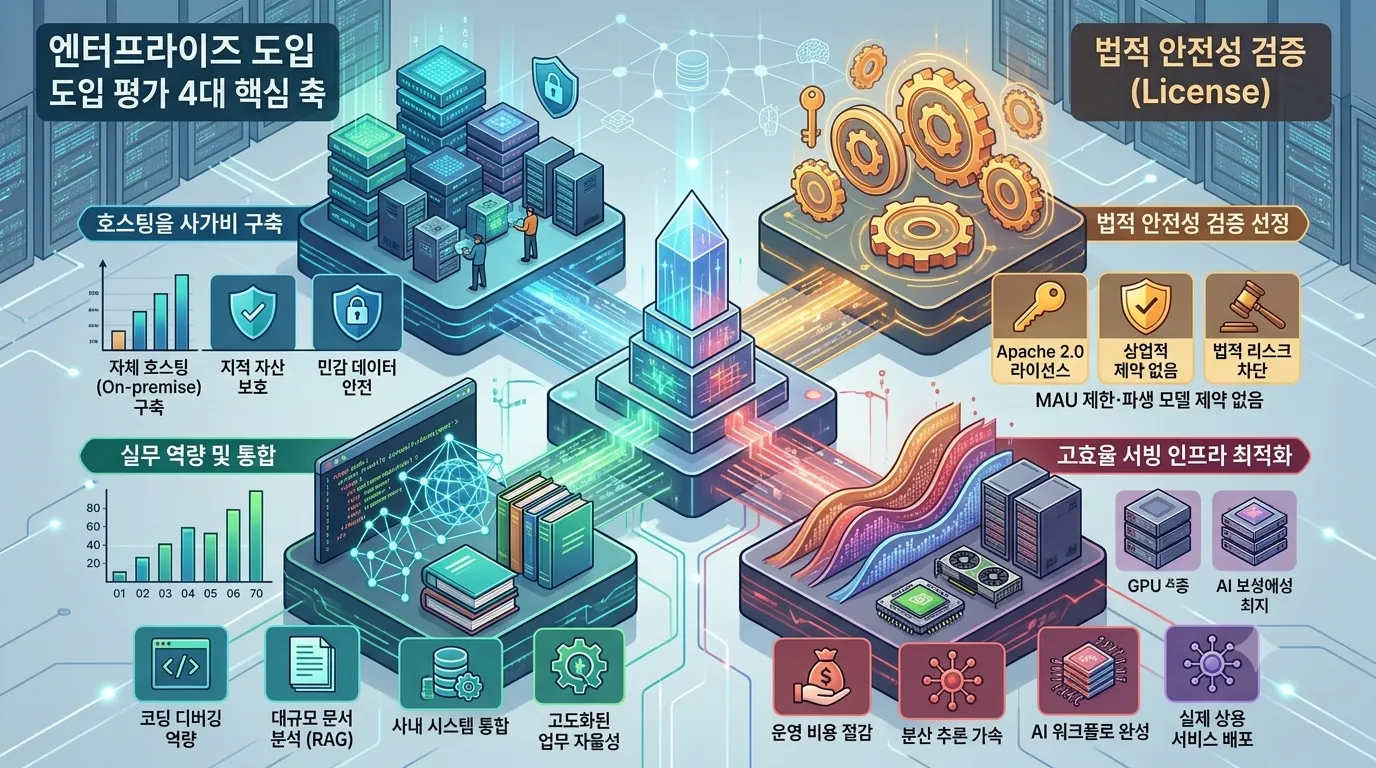
기업 내 핵심 지적 자산과 민감 데이터를 안전하게 보호하기 위해 자체 호스팅(On-premise) 기반 초거대 오픈 모델을 구축하려는 엔터프라이즈 수요가 빠르게 증가하고 있습니다.
단순한 벤치마크 점수 경쟁을 넘어, 실제 상용 서비스 배포와 사내 시스템 통합 과정에서 발생할 수 있는 법적 라이선스 리스크를 사전에 차단하고 고도화된 업무 자율성을 확보하는 것이 핵심 과제로 부상했습니다.
엔터프라이즈 환경에서 오픈소스 대형 언어 모델(LLM)을 성공적으로 안착시키기 위해서는 상업적 제약이 없는 라이선스 검증뿐만 아니라 코딩 디버깅 역량, 대규모 사내 문서 분석(RAG), 그리고 고효율 서빙 인프라 최적화가 종합적으로 맞물려야 합니다.
월간 활성 사용자(MAU) 제한이나 파생 모델 개발 제약과 같은 규제 요소를 면밀히 분석하고, 실제 운영 비용을 절감할 수 있는 추론 가속 기술을 체계적으로 검토해야 안정적인 AI 워크플로를 완성할 수 있습니다.
본 가이드에서는 엔터프라이즈 도입 평가 체계의 4대 핵심 축을 바탕으로 Apache 2.0 라이선스 기반 모델의 법적 안전성과 실무 개발·문서 분석 역량, 그리고 분산 추론 인프라 서빙 전략을 심층 비교합니다.
사내 인프라 환경과 비즈니스 요구에 부합하는 최적의 모델 아키텍처를 선별하는 명확한 기준을 제시합니다.
1. 사내 구축용 초거대 오픈 모델 도입 평가 체계 및 4대 가중치 체크리스트
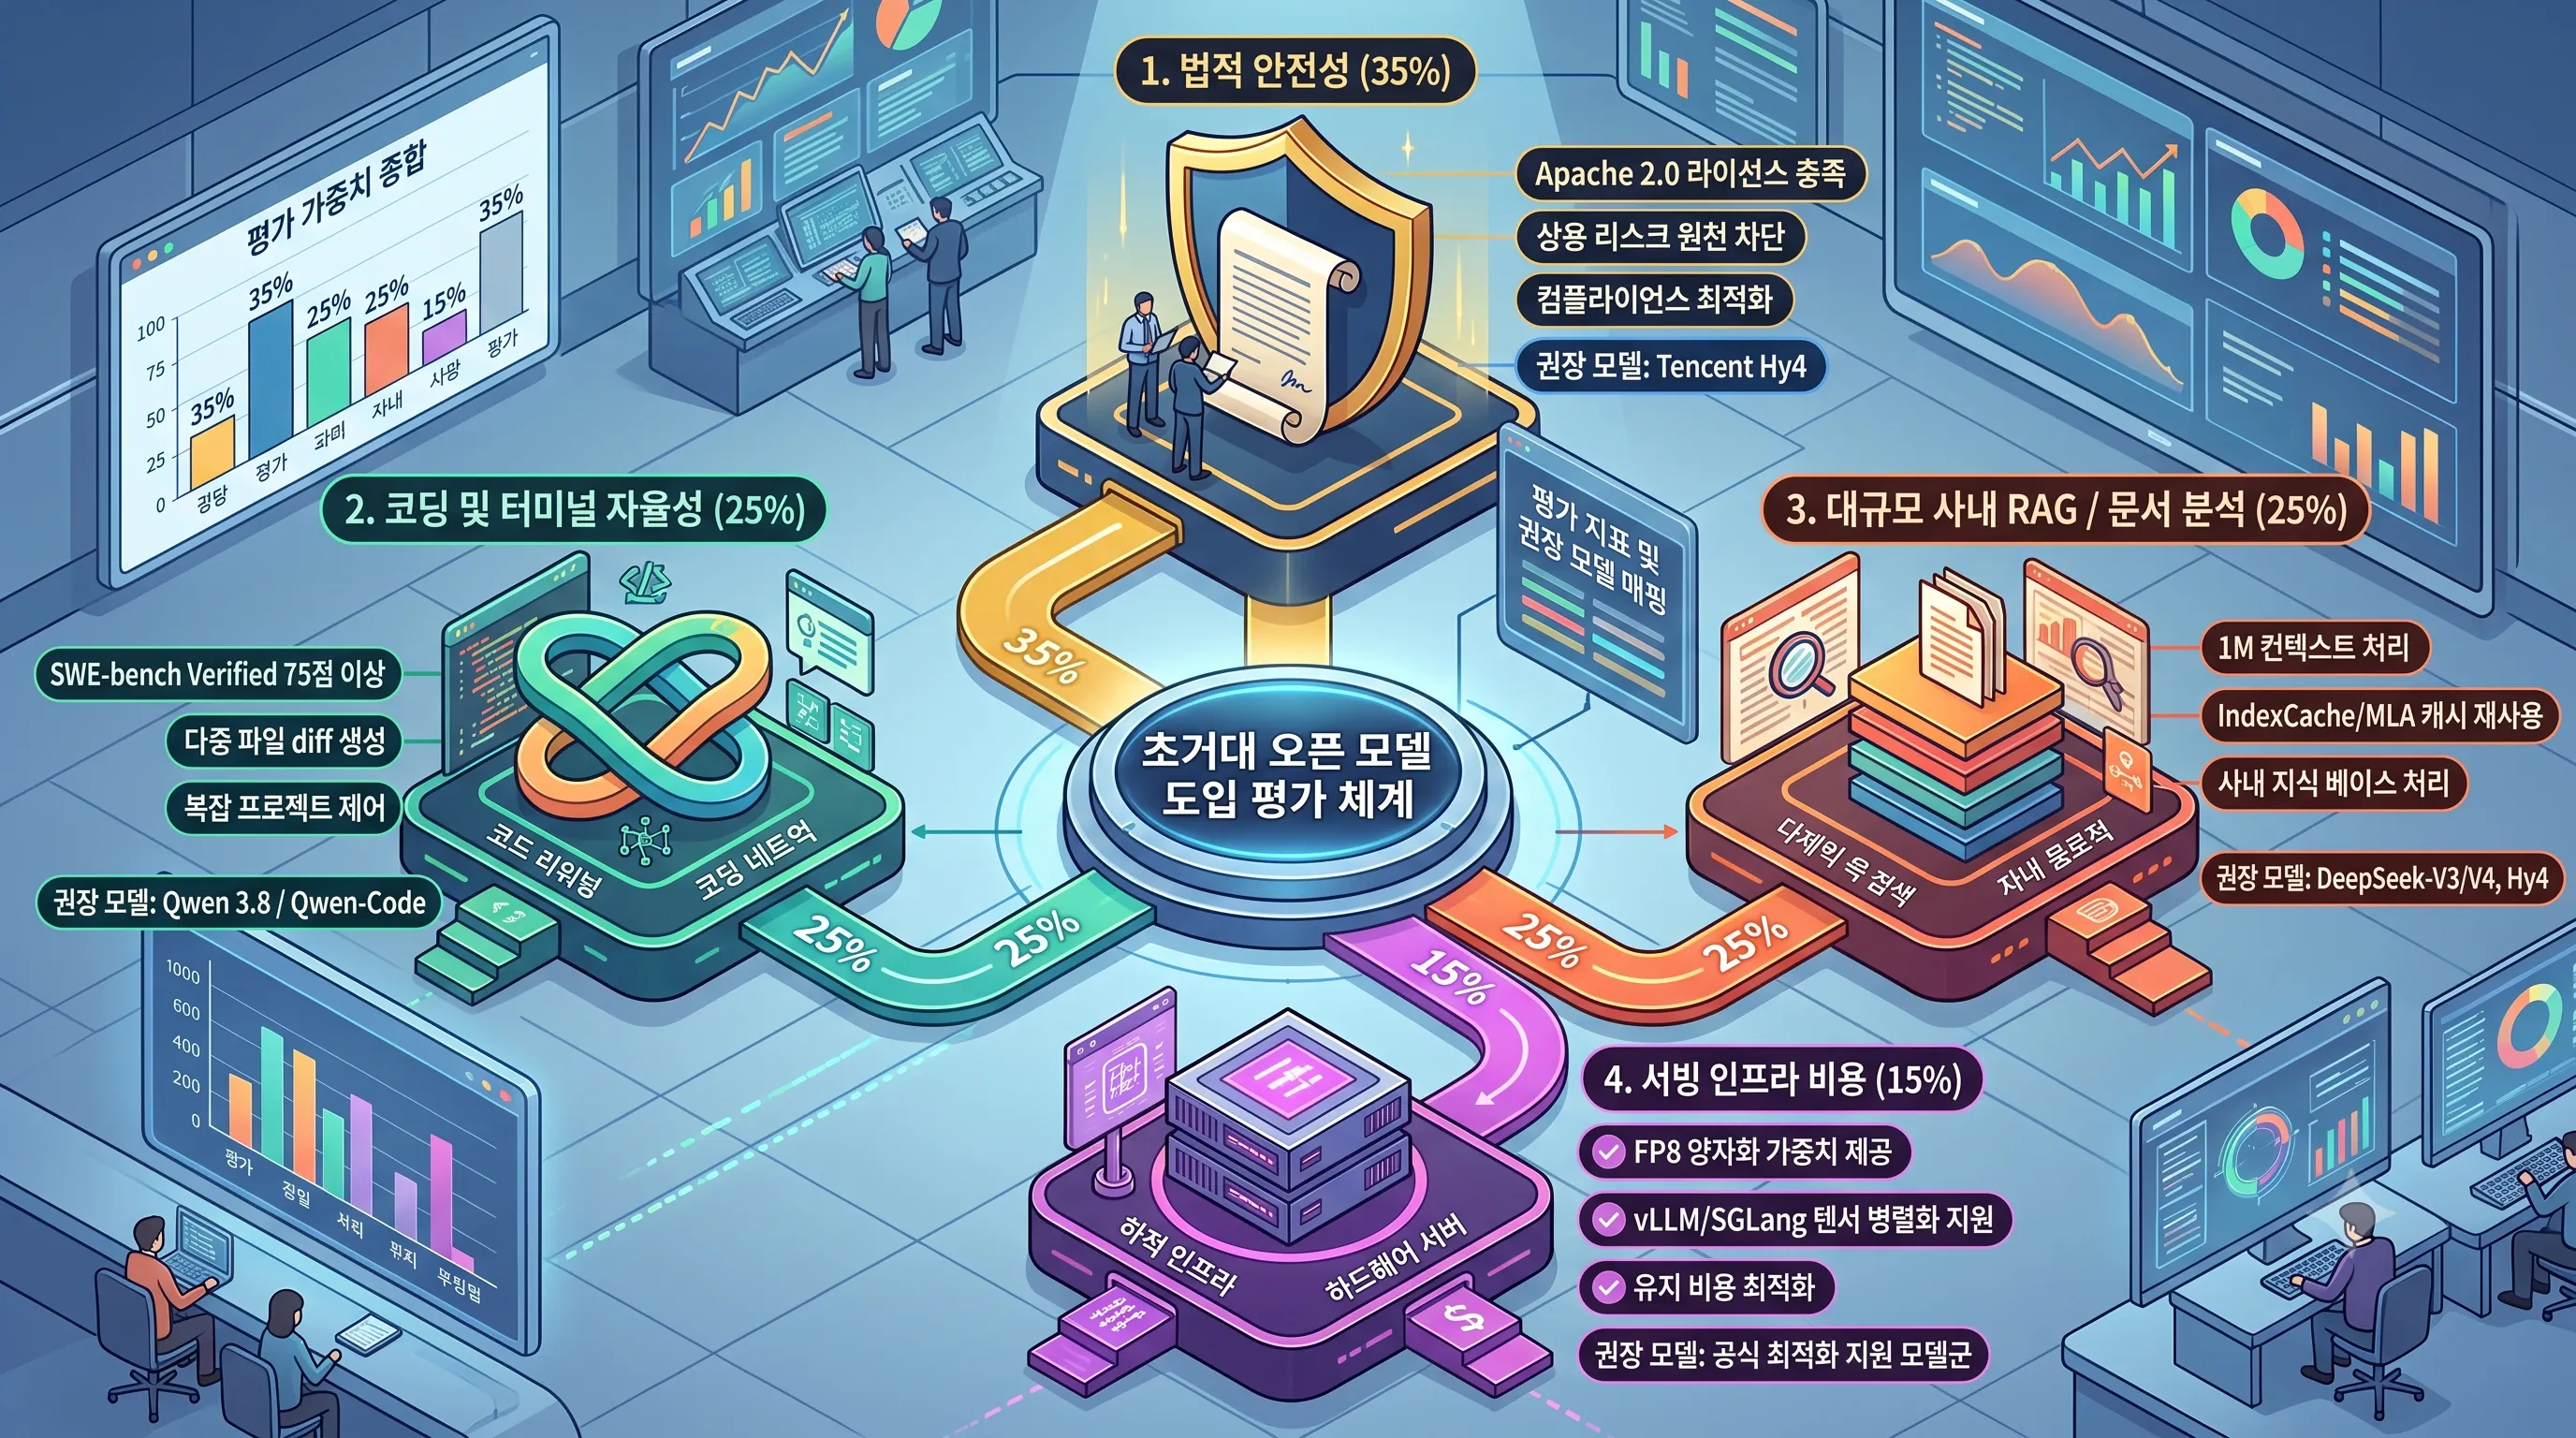
4대 평가 지표 및 가중치 배분 기준
엔터프라이즈 환경에서 자체 호스팅(On-premise) LLM을 성공적으로 안착시키기 위해서는 정교한 기술적·법적 검증 체계가 필수적입니다.
기업용 온프레미스 모델 도입 평가는 법적 리스크, 코딩 디버깅 역량, 초대용량 문서 처리, 인프라 서빙 최적화라는 4대 핵심 축을 바탕으로 가중치 구조를 설정합니다.
실무 배포 시 발생할 수 있는 컴플라이언스 문제와 하드웨어 비용, 실제 업무 생산성 기여도를 복합적으로 고려하여 가중치를 차등 배분합니다.
전체 평가 체계 중 가장 높은 비중을 차지하는 항목은 35%의 가중치가 부여된 법적 안전성입니다.
사내 핵심 자산 및 독점 코드를 다루는 엔터프라이즈 환경 특성상 상용 라이선스 위반 소지를 원천 차단하는 Apache 2.0 라이선스 충족 여부가 최우선 검토 지표로 작용합니다.
이어지는 핵심 업무 영역인 코딩 및 터미널 자율성과 대규모 사내 RAG 및 문서 분석 역량에는 각각 25%의 가중치를 균등하게 배정하여 실무 활용성을 검증합니다.
마지막으로 자체 인프라 구축 및 유지 비용을 좌우하는 서빙 인프라 비용 항목에는 15%의 가중치를 두어 총 100%의 종합 평가 프레임워크를 구성합니다.
워크로드별 필수 기술 스펙과 권장 모델 매핑
각 평가 지표는 사내 시스템 통합에 요구되는 명확한 세부 기술 스펙을 기반으로 평가됩니다.
코딩 및 터미널 자율성 영역에서는 SWE-bench Verified 75점 이상의 문제 해결 성능과 함께, 복잡한 프로젝트 구조를 제어할 수 있는 다중 파일 diff 생성 능력이 필수적으로 요구됩니다.
해당 영역의 권장 모델군으로는 정밀한 코드 생성 및 디버깅 성능을 검증받은 Qwen 3.8 / Qwen-Code가 채택됩니다.
사내 지식 관리와 직결되는 대규모 RAG 및 문서 분석 부문에서는 1M 컨텍스트 처리 지원과 더불어 연산 효율을 극대화하는 IndexCache 및 MLA 캐시 재사용 기술이 요구 스펙으로 지정되어 있습니다.
방대한 기술 문서와 사내 지식 베이스를 처리하는 워크로드에는 DeepSeek-V3/V4와 Hy4가 최적의 모델군으로 제시됩니다.
인프라 서빙 비용 최적화 부문은 제한된 GPU 자원 내에서 고성능을 유지하기 위해 FP8 양자화 가중치 제공 여부와 vLLM 및 SGLang 텐서 병렬화 공식 릴리스 지원 여부를 핵심 기준으로 삼습니다.
라이선스 리스크를 완벽하게 배제하면서 안정적인 상용 서비스를 운영하려는 엔터프라이즈 도입군에서는 Apache 2.0 기준을 완벽히 충족하는 Tencent Hy4가 법적 안전성 평가의 핵심 권장 모델로 매핑됩니다.
| 평가 핵심 축 | 가중치 | 필수 요구 스펙 및 기술 조건 | 권장 오픈 모델군 |
|---|---|---|---|
| 법적 안전성 | 35% | Apache 2.0 라이선스 기준 충족 | Tencent Hy4 |
| 코딩 및 터미널 자율성 | 25% | SWE-bench Verified 75점 이상, 다중 파일 diff 생성 | Qwen 3.8 / Qwen-Code |
| 대규모 사내 RAG / 문서 분석 | 25% | 1M 컨텍스트 처리, IndexCache/MLA 캐시 재사용 | DeepSeek-V3/V4, Hy4 |
| 서빙 인프라 비용 | 15% | FP8 양자화 가중치 제공, vLLM/SGLang 텐서 병렬화 지원 공식 릴리스 | 공식 최적화 지원 모델군 |
2. 엔터프라이즈 라이선스 규제 리스크 분석: Apache 2.0 vs Llama Community 및 커스텀 라이선스
Apache 2.0 라이선스의 법적 안전성과 핵심 재배포 요건
기업 내부 인프라에 초거대 언어 모델을 직접 구축하여 상용 프로덕트에 통합할 때 가장 먼저 검토해야 할 요소는 라이선스의 법적 구속력과 지속 가능성입니다.
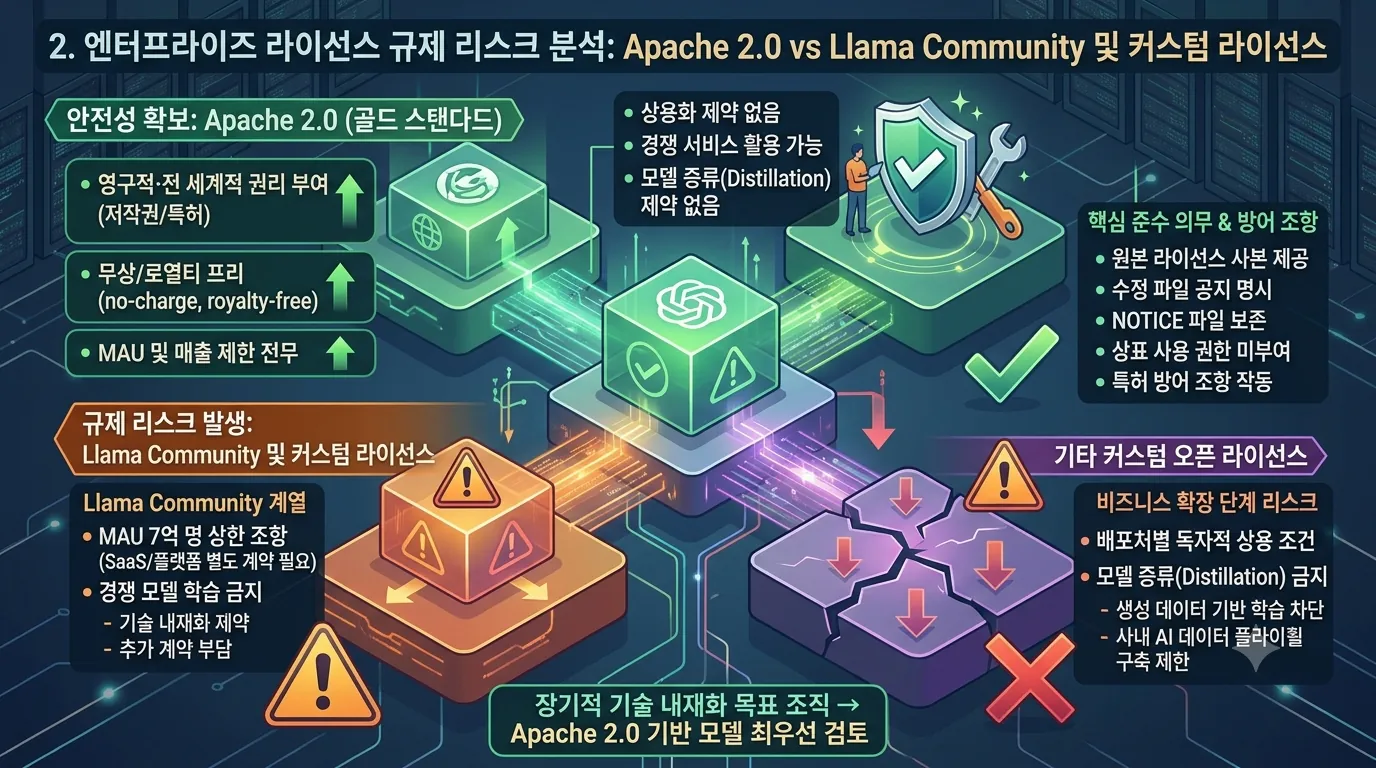
공식 오픈소스 규격인 Apache 2.0 라이선스(https://www.apache.org/licenses/LICENSE-2.0)는 사용자에게 영구적(perpetual), 전 세계적(worldwide), 비독점적(non-exclusive), 무상/로열티 프리(no-charge, royalty-free), 취소 불가(irrevocable) 저작권 및 특허 라이선스를 부여합니다.
이러한 명확한 권리 부여 덕분에 월간 활성 사용자(MAU) 규모나 연간 매출액, 파생 모델의 경쟁 서비스 활용 여부에 따른 법적 제약이 전무하여 엔터프라이즈 도입의 골드 스탠다드로 평가받고 있습니다.
Apache 2.0 기반 모델을 수정하거나 사내 서비스로 재배포할 때는 정해진 의무 사항을 준수해야 법적 분쟁을 방지할 수 있습니다.
주요 재배포 요건으로는 원본 라이선스 사본 제공, 소스코드 또는 가중치 파일 수정 시 수정 파일 공지 명시, 원본에 포함된 저작권·특허·상표·고지문(NOTICE) 보존 조건이 요구됩니다.
반면 상표(Trademark) 사용 권한은 기여자나 저작권자가 명시적으로 허용하지 않으므로 원작자의 브랜드명을 무단 도용할 수 없으며, 라이선스 제공자를 상대로 특허 침해 소송을 제기할 경우 부여된 특허 라이선스가 즉시 종료되는 특허 방어 조항이 작동합니다.
Llama Community 및 커스텀 오픈 라이선스의 상용 제약과 증류 금지 리스크
반면 완전한 오픈소스가 아닌 조건부 공개 모델들은 비즈니스 확장 단계에서 심각한 라이선스 컴플라이언스 리스크를 유발할 수 있습니다.
대표적으로 Llama Community License 계열은 월간 활성 사용자(MAU) 7억 명 상한 조항을 두고 있어, 글로벌 사용자 풀을 보유한 대규모 플랫폼이나 SaaS 기업이 도입할 경우 별도의 추가 상업 라이선스 계약을 체결해야 하는 부담이 발생합니다.
더불어 Llama Community 계열에 명시된 경쟁 모델 학습 금지 조항은 파생된 산출물로 타 기초 모델을 고도화하는 행위를 원천 차단하므로 엔터프라이즈의 차세대 독자 모델 구축에 잠재적 계약 리스크를 안깁니다.
일부 파운데이션 모델에 적용된 기타 커스텀 오픈 라이선스는 모델의 출력 데이터를 기반으로 다른 경량 모델을 학습시키는 모델 증류(Distillation) 금지 조항을 포함하고 있습니다.
초거대 교사 모델의 추론 결과를 사내 소형 특화 모델의 학습 데이터셋으로 재활용하려는 아키텍처에서는 이러한 제약이 핵심 병목으로 작용합니다.
결과적으로 모델 증류가 차단되면 지속적인 피드백 루프로 성능을 개선하는 사내 AI 데이터 플라이휠 구축이 크게 제한되므로, 장기적 기술 내재화를 목표로 하는 조직은 Apache 2.0 기반 모델을 최우선으로 검토해야 합니다.
| 라이선스 구분 | 기본 권리 및 상용화 제약 (MAU/매출) | 경쟁 모델 학습 및 증류(Distillation) | 핵심 준수 의무 및 방어 조항 |
|---|---|---|---|
| Apache 2.0 | 영구적·전 세계적·무상 특허/저작권 부여 (MAU 및 매출 제한 전무) | 경쟁 서비스 활용 및 모델 증류에 대한 제약 없음 | NOTICE 파일 및 라이선스 사본 보존, 수정 공지 명시, 특허 소송 제기 시 특허 라이선스 즉시 종료 |
| Llama Community | 월간 활성 사용자(MAU) 7억 명 초과 시 별도 상업 계약 필요 | 경쟁 모델 학습 금지 조항으로 인한 기술 내재화 제약 | 커뮤니티 가이드라인 준수 및 추가 라이선스 체결 의무 |
| 기타 커스텀 오픈 라이선스 | 배포처별 독자적 상용 조건 및 수익화 제약 부과 가능 | 생성 데이터 기반 모델 증류(Distillation) 금지 조항 존재 | 사내 AI 데이터 플라이휠 구축 제한 및 라이선스 위반 리스크 상존 |
3. 온프레미스 서빙 인프라 최적화: vLLM 고처리량 분산 추론 가속 기술
PagedAttention 및 메모리·배칭 가속 핵심 기술
사내 온프레미스 환경에서 초거대 언어 모델을 안정적으로 서빙하기 위해서는 제한된 하드웨어 자원을 극대화할 수 있는 추론 프레임워크 도입이 필수적입니다.
공식 프로젝트 저장소(github.com/vllm-project/vllm)에 공개된 vLLM은 Apache-2.0 라이선스를 기반으로 구축되어 상업적 온프레미스 환경에서도 라이선스 제약 없이 자유롭게 배포할 수 있는 고처리량·고효율 LLM 서빙 엔진입니다.
vLLM은 DeepSeek-V3, Qwen-MoE, Llama, Mixtral 등을 포함하여 200개 이상의 오픈소스 모델 아키텍처를 폭넓게 지원하며, 다양한 엔터프라이즈 워크로드에 신속하게 대응할 수 있는 기반을 제공합니다.
vLLM의 핵심 경쟁력은 대규모 동시 요청 환경에서 메모리 낭비를 최소화하고 처리량을 극대화하는 가속 메커니즘에 있습니다.
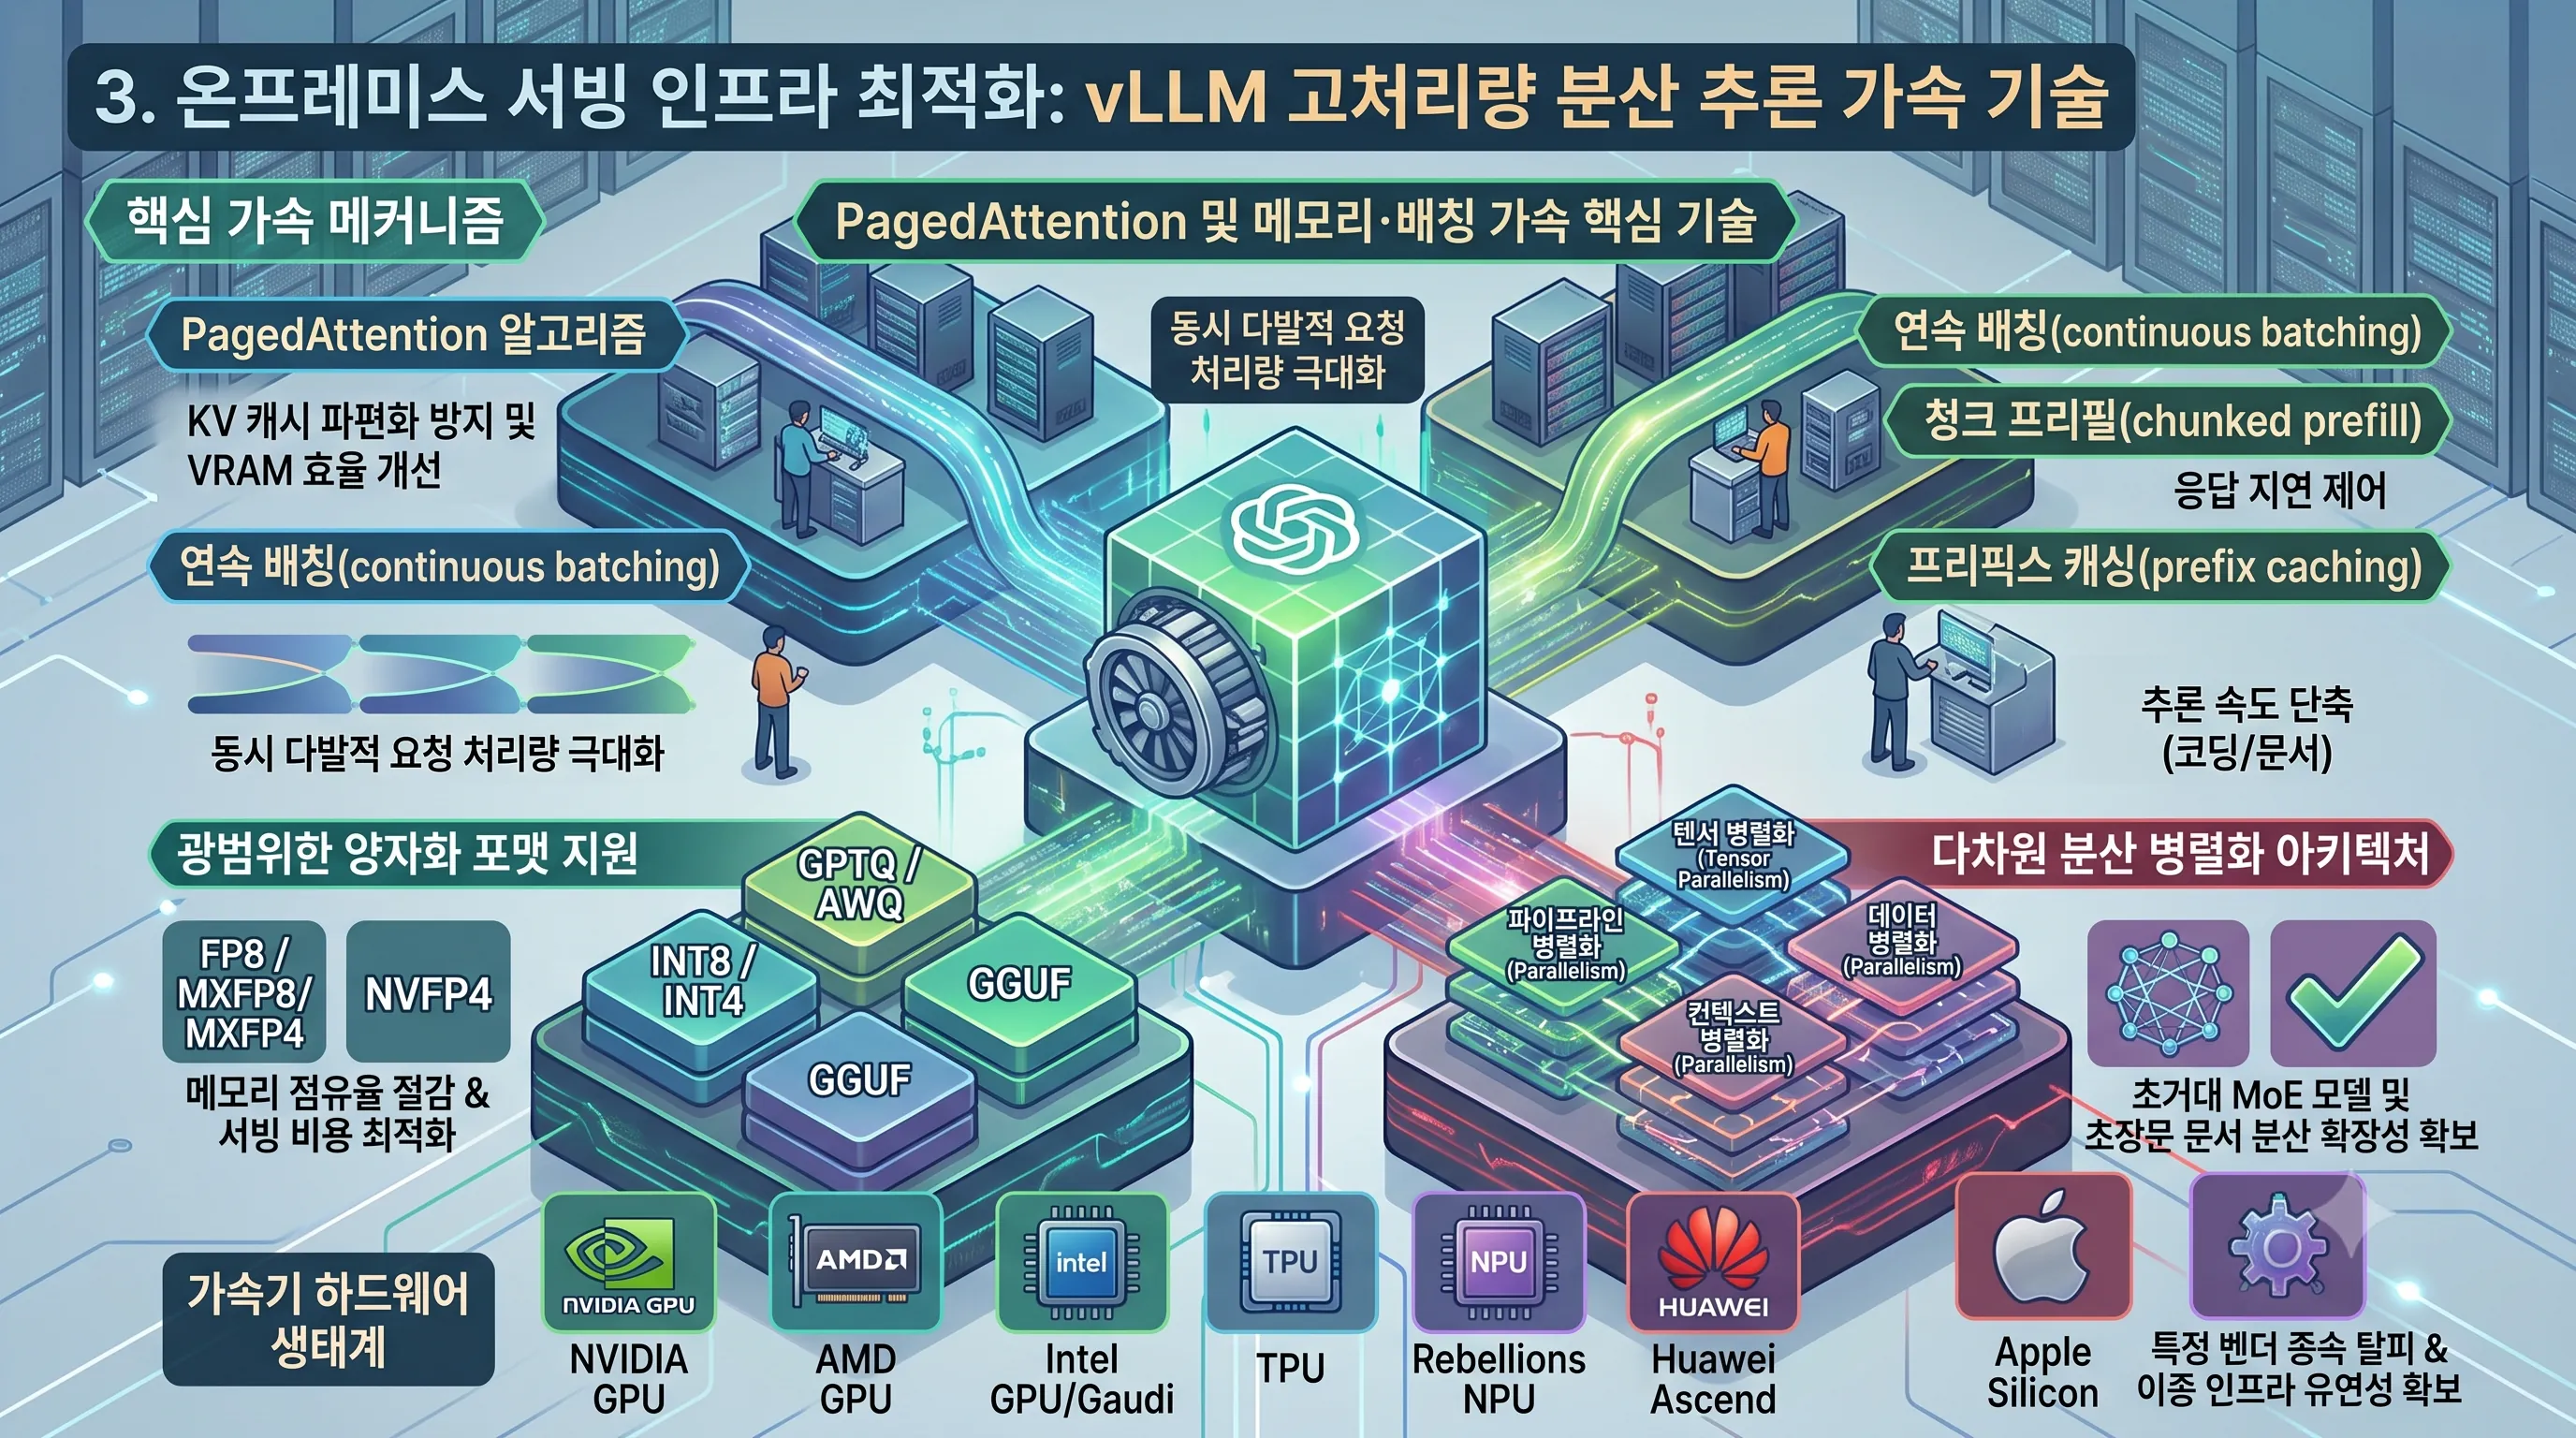
운영체제의 가상 메모리 페이징 기법에서 착안한 PagedAttention 알고리즘을 도입해 KV 캐시의 파편화를 근본적으로 줄이고 VRAM 사용 효율성을 대폭 개선했습니다.
여기에 요청이 들어오는 즉시 유연하게 처리 큐에 삽입하는 연속 배칭(continuous batching)과 긴 프롬프트를 분할 연산하여 응답 지연을 제어하는 청크 프리필(chunked prefill) 기술이 유기적으로 결합되어 서빙 파이프라인의 병목을 완화합니다.
또한, 반복되는 시스템 프롬프트나 문서 컨텍스트의 중복 연산을 줄여주는 프리픽스 캐싱(prefix caching)을 통해 코딩 어시스턴트 및 대용량 문서 분석 환경에서 추론 처리 속도를 크게 단축할 수 있습니다.
다양한 정밀도 양자화 포맷과 분산 병렬화(TP/PP/EP/CP) 아키텍처
초거대 모델을 단일 인스턴스 또는 클러스터 환경에 유연하게 올리기 위해 vLLM은 광범위한 양자화 포맷과 분산 병렬화 기술을 내장하고 있습니다.
정밀도 측면에서는 FP8을 비롯해 MXFP8/MXFP4, NVFP4와 같은 최신 부동소수점 포맷은 물론 INT8, INT4, GPTQ, AWQ, GGUF 등 산업계에서 검증된 다양한 양자화 방식을 완벽하게 지원합니다.
이를 통해 엔터프라이즈 환경에서는 서빙하고자 하는 모델의 크기와 가용 메모리 사양에 맞춰 최적의 정밀도 옵션을 선택하여 인프라 비용을 절감할 수 있습니다.
단일 가속기 메모리를 초과하는 초대형 파라미터 모델을 효율적으로 구동하기 위한 다차원 분산 병렬 처리 아키텍처도 강점입니다.
vLLM은 텐서 병렬화(Tensor Parallelism)와 파이프라인 병렬화(Pipeline Parallelism), 그리고 데이터 병렬화(Data Parallelism)를 기본적으로 지원합니다.
이에 더해 MoE 구조의 연산 부하를 효과적으로 분산하는 전문가 병렬화(Expert Parallelism)와 초장문 컨텍스트 처리를 위한 컨텍스트 병렬화(Context Parallelism)까지 포괄적으로 제공함으로써 방대한 분량의 사내 문서 분석이나 다중 턴 코딩 세션도 매끄럽게 처리합니다.
| 구분 | 주요 지원 기술 및 사양 | 서빙 최적화 효과 |
|---|---|---|
| 핵심 가속 메커니즘 | PagedAttention, 프리픽스 캐싱, 청크 프리필, 연속 배칭 | KV 캐시 메모리 파편화 방지, 동시 다발적 요청 처리량 극대화, 긴 프롬프트 연산 지연 최소화 |
| 지원 양자화 포맷 | FP8, MXFP8/MXFP4, NVFP4, INT8, INT4, GPTQ, AWQ, GGUF | 메모리 점유율 대폭 절감, 가속기 사양에 맞춘 정밀도 최적화 및 서빙 비용 절감 |
| 분산 병렬화 기법 | 텐서 병렬화, 파이프라인 병렬화, 데이터 병렬화, 전문가 병렬화(EP), 컨텍스트 병렬화 | 초거대 MoE 모델 및 초장문 문서 처리를 위한 멀티 가속기 분산 확장성 확보 |
| 가속기 하드웨어 생태계 | NVIDIA GPU, AMD GPU, Intel GPU/Gaudi, TPU, Rebellions NPU, Huawei Ascend, Apple Silicon | 특정 벤더 종속 탈피, 온프레미스 이종 하드웨어 인프라 유연성 확보 |
vLLM은 특정 하드웨어 벤더에 종속되지 않는 폭넓은 가속기 생태계를 구현하고 있습니다.
표준적인 NVIDIA GPU 및 AMD GPU 환경은 물론, Intel GPU/Gaudi, TPU, 국산 NPU인 Rebellions NPU, Huawei Ascend, 로컬 개발을 위한 Apple Silicon 등 다기종 가속기 지원을 적극적으로 확장해 왔습니다.
결과적으로 온프레미스 인프라를 구축하려는 기업은 Apache-2.0 라이선스 기반의 vLLM을 통해 하드웨어 선택의 폭을 넓히고, 최적화된 고처리량 LLM 서빙 파이프라인을 유연하게 구축할 수 있습니다.
관련 글