1M 컨텍스트 전역 리팩토링: Qwen 3.8 Max를 터미널 에이전트(Command Code)로 굴려본 실전 후기
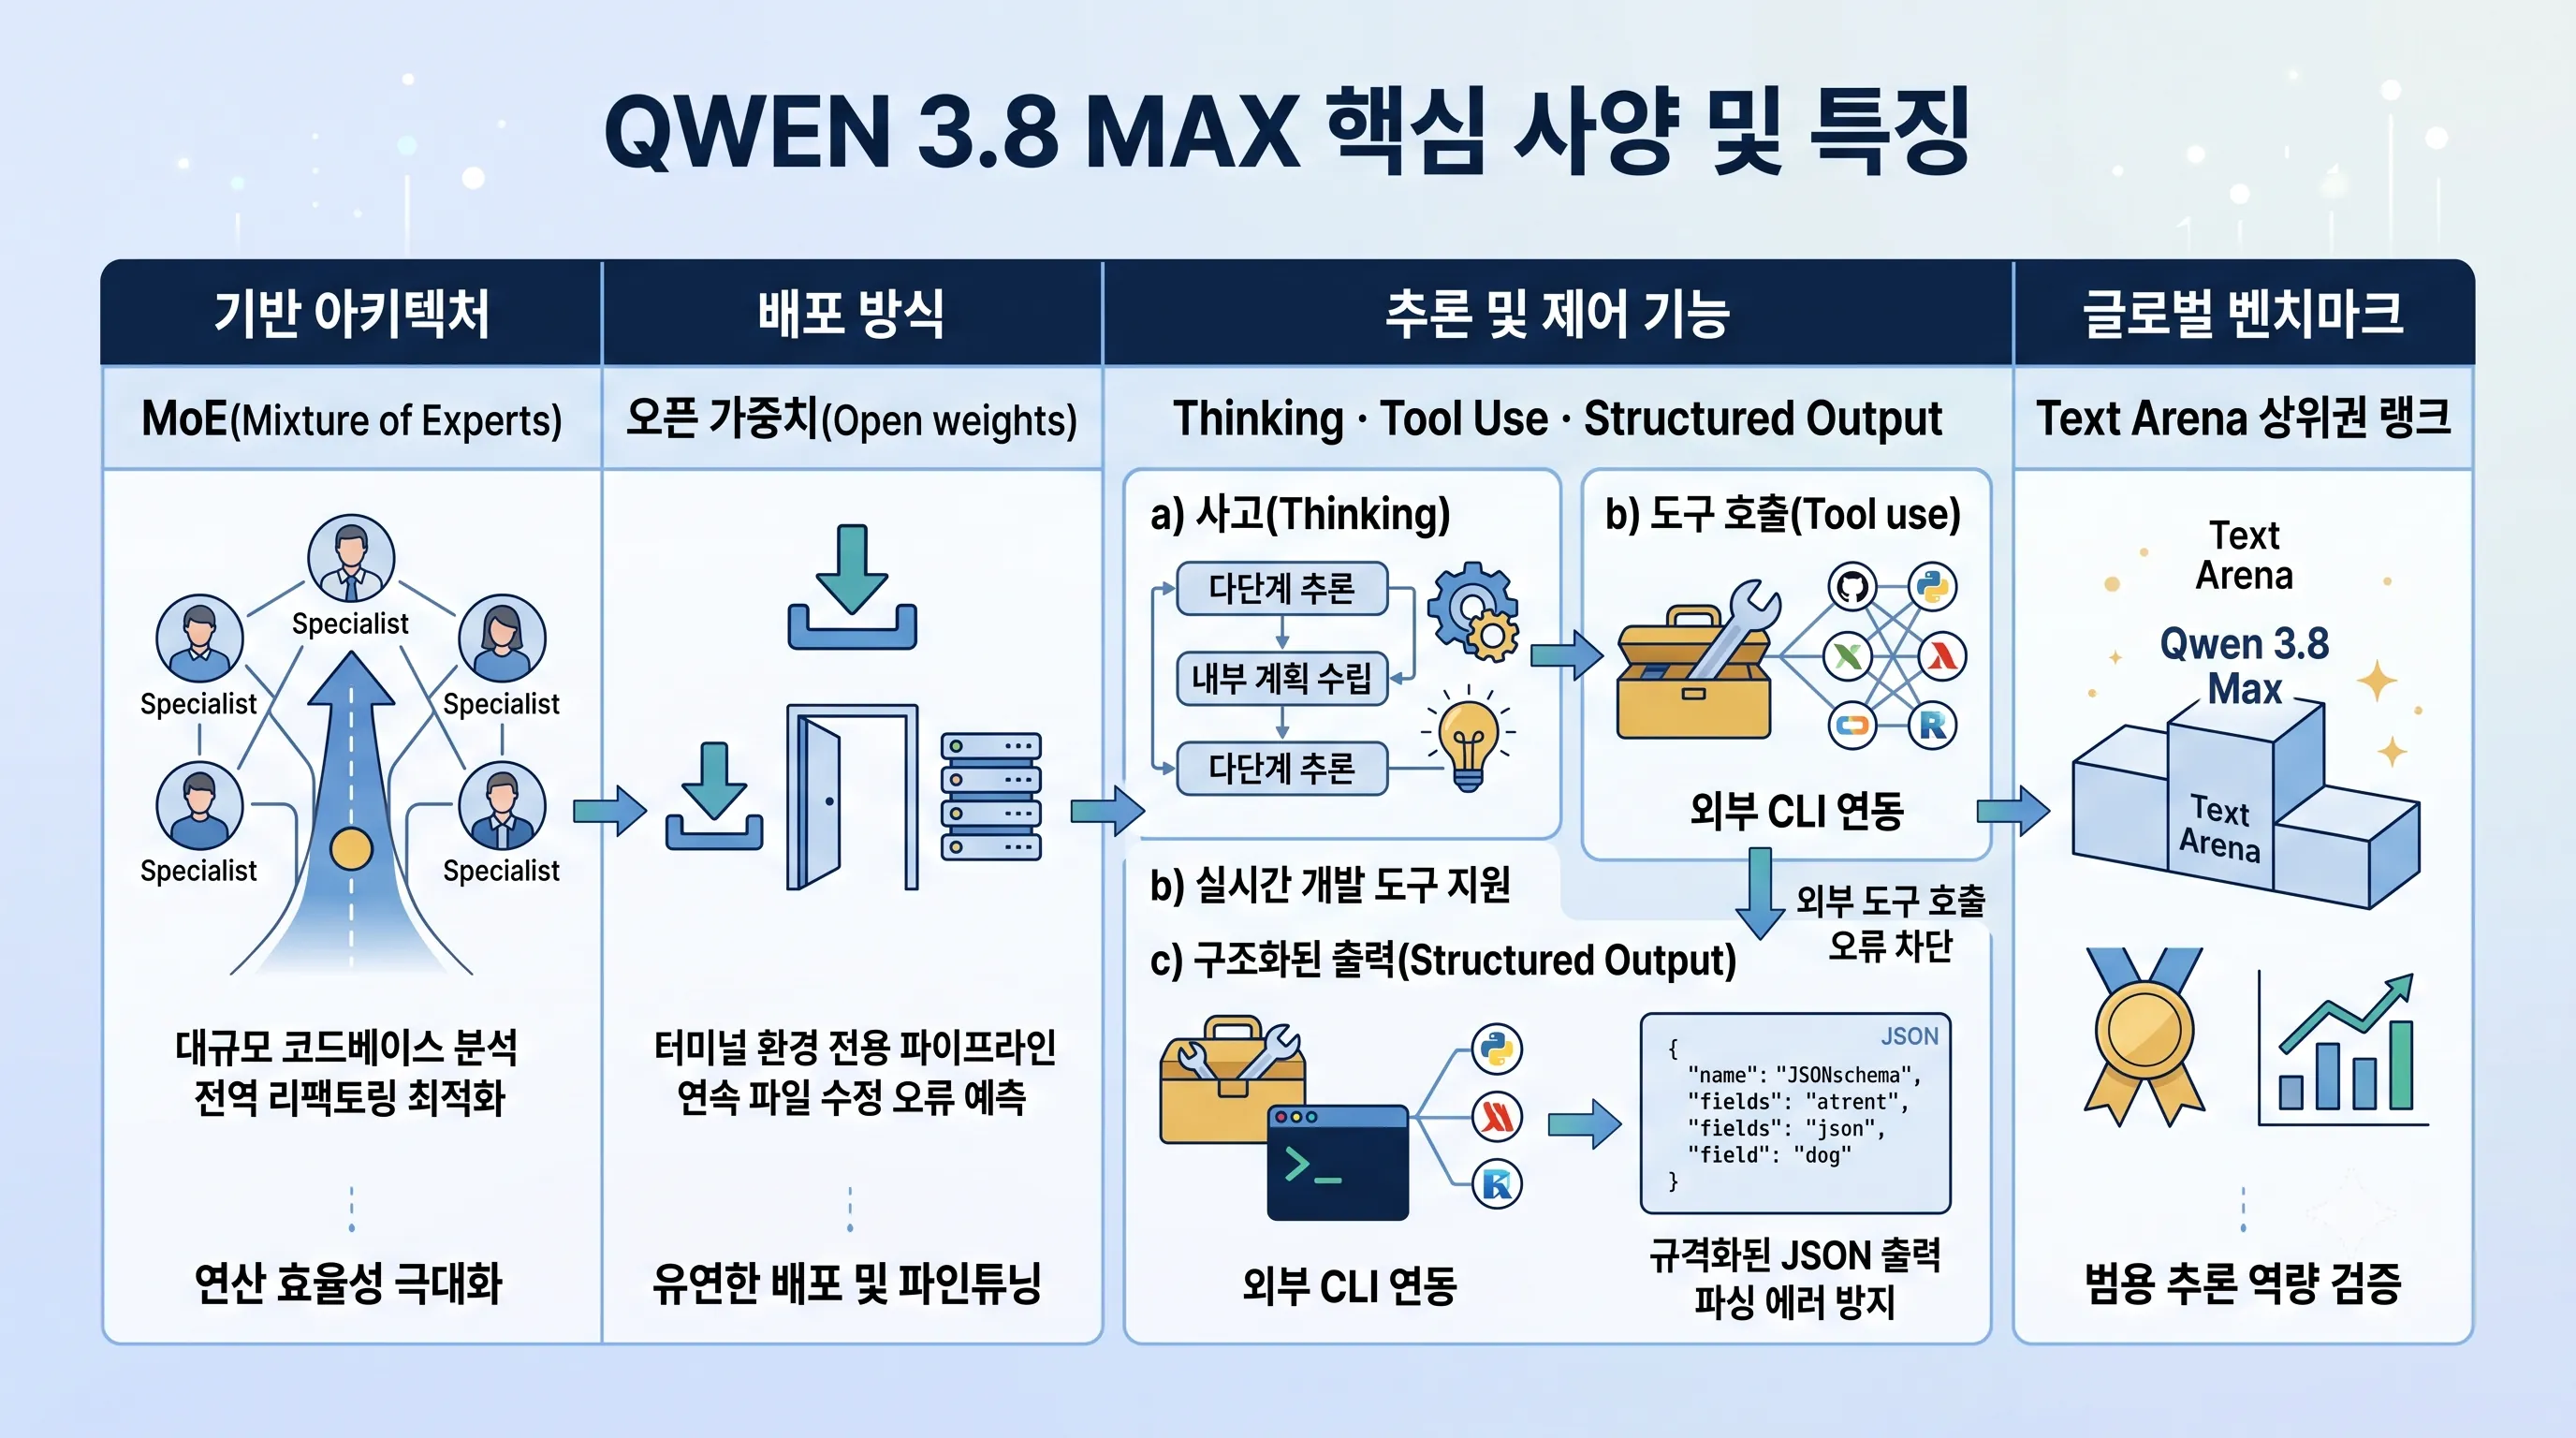
- MoE 아키텍처와 오픈 가중치 기반의 Qwen 3.8 Max는 자체적 Thinking 및 Tool Use 기능과 구조화된 출력을 바탕으로 Text Arena 랭킹 상위권에 진입했습니다.
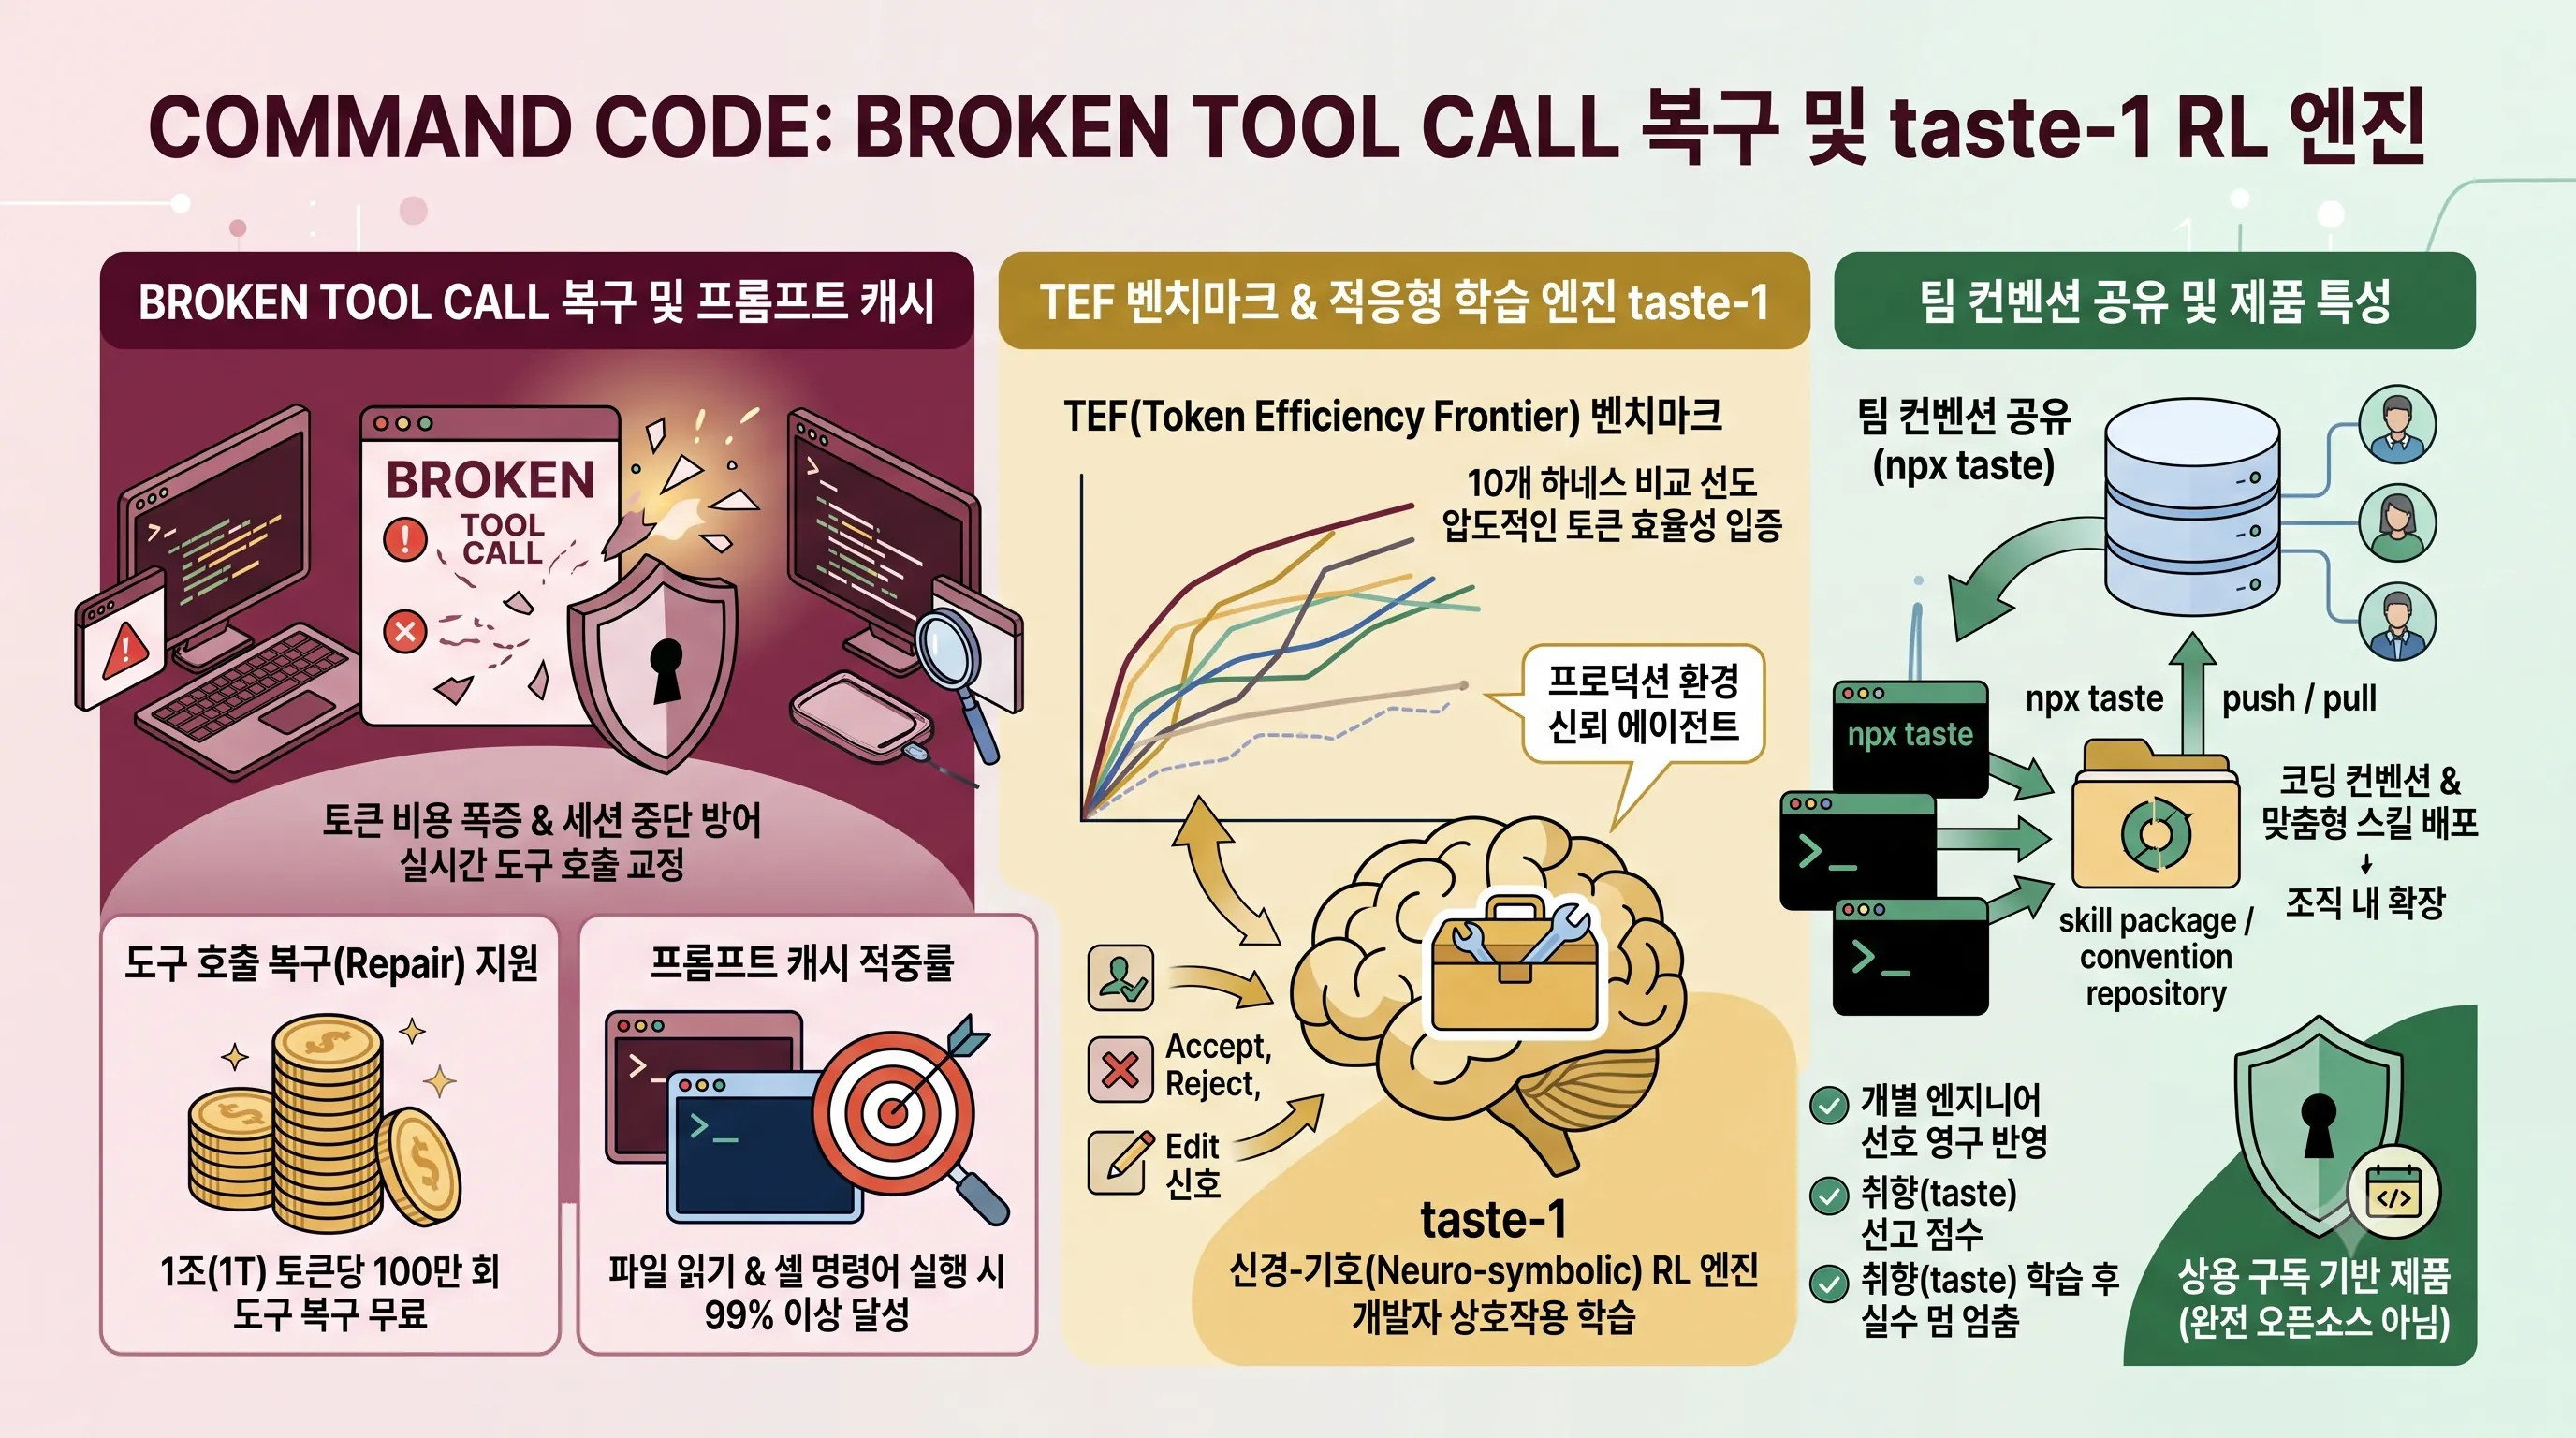
- Command Code 하네스는 1T 토큰당 100만 회 도구 복구와 99% 프롬프트 캐시 적중률을 제공하며, taste-1 RL 엔진 및
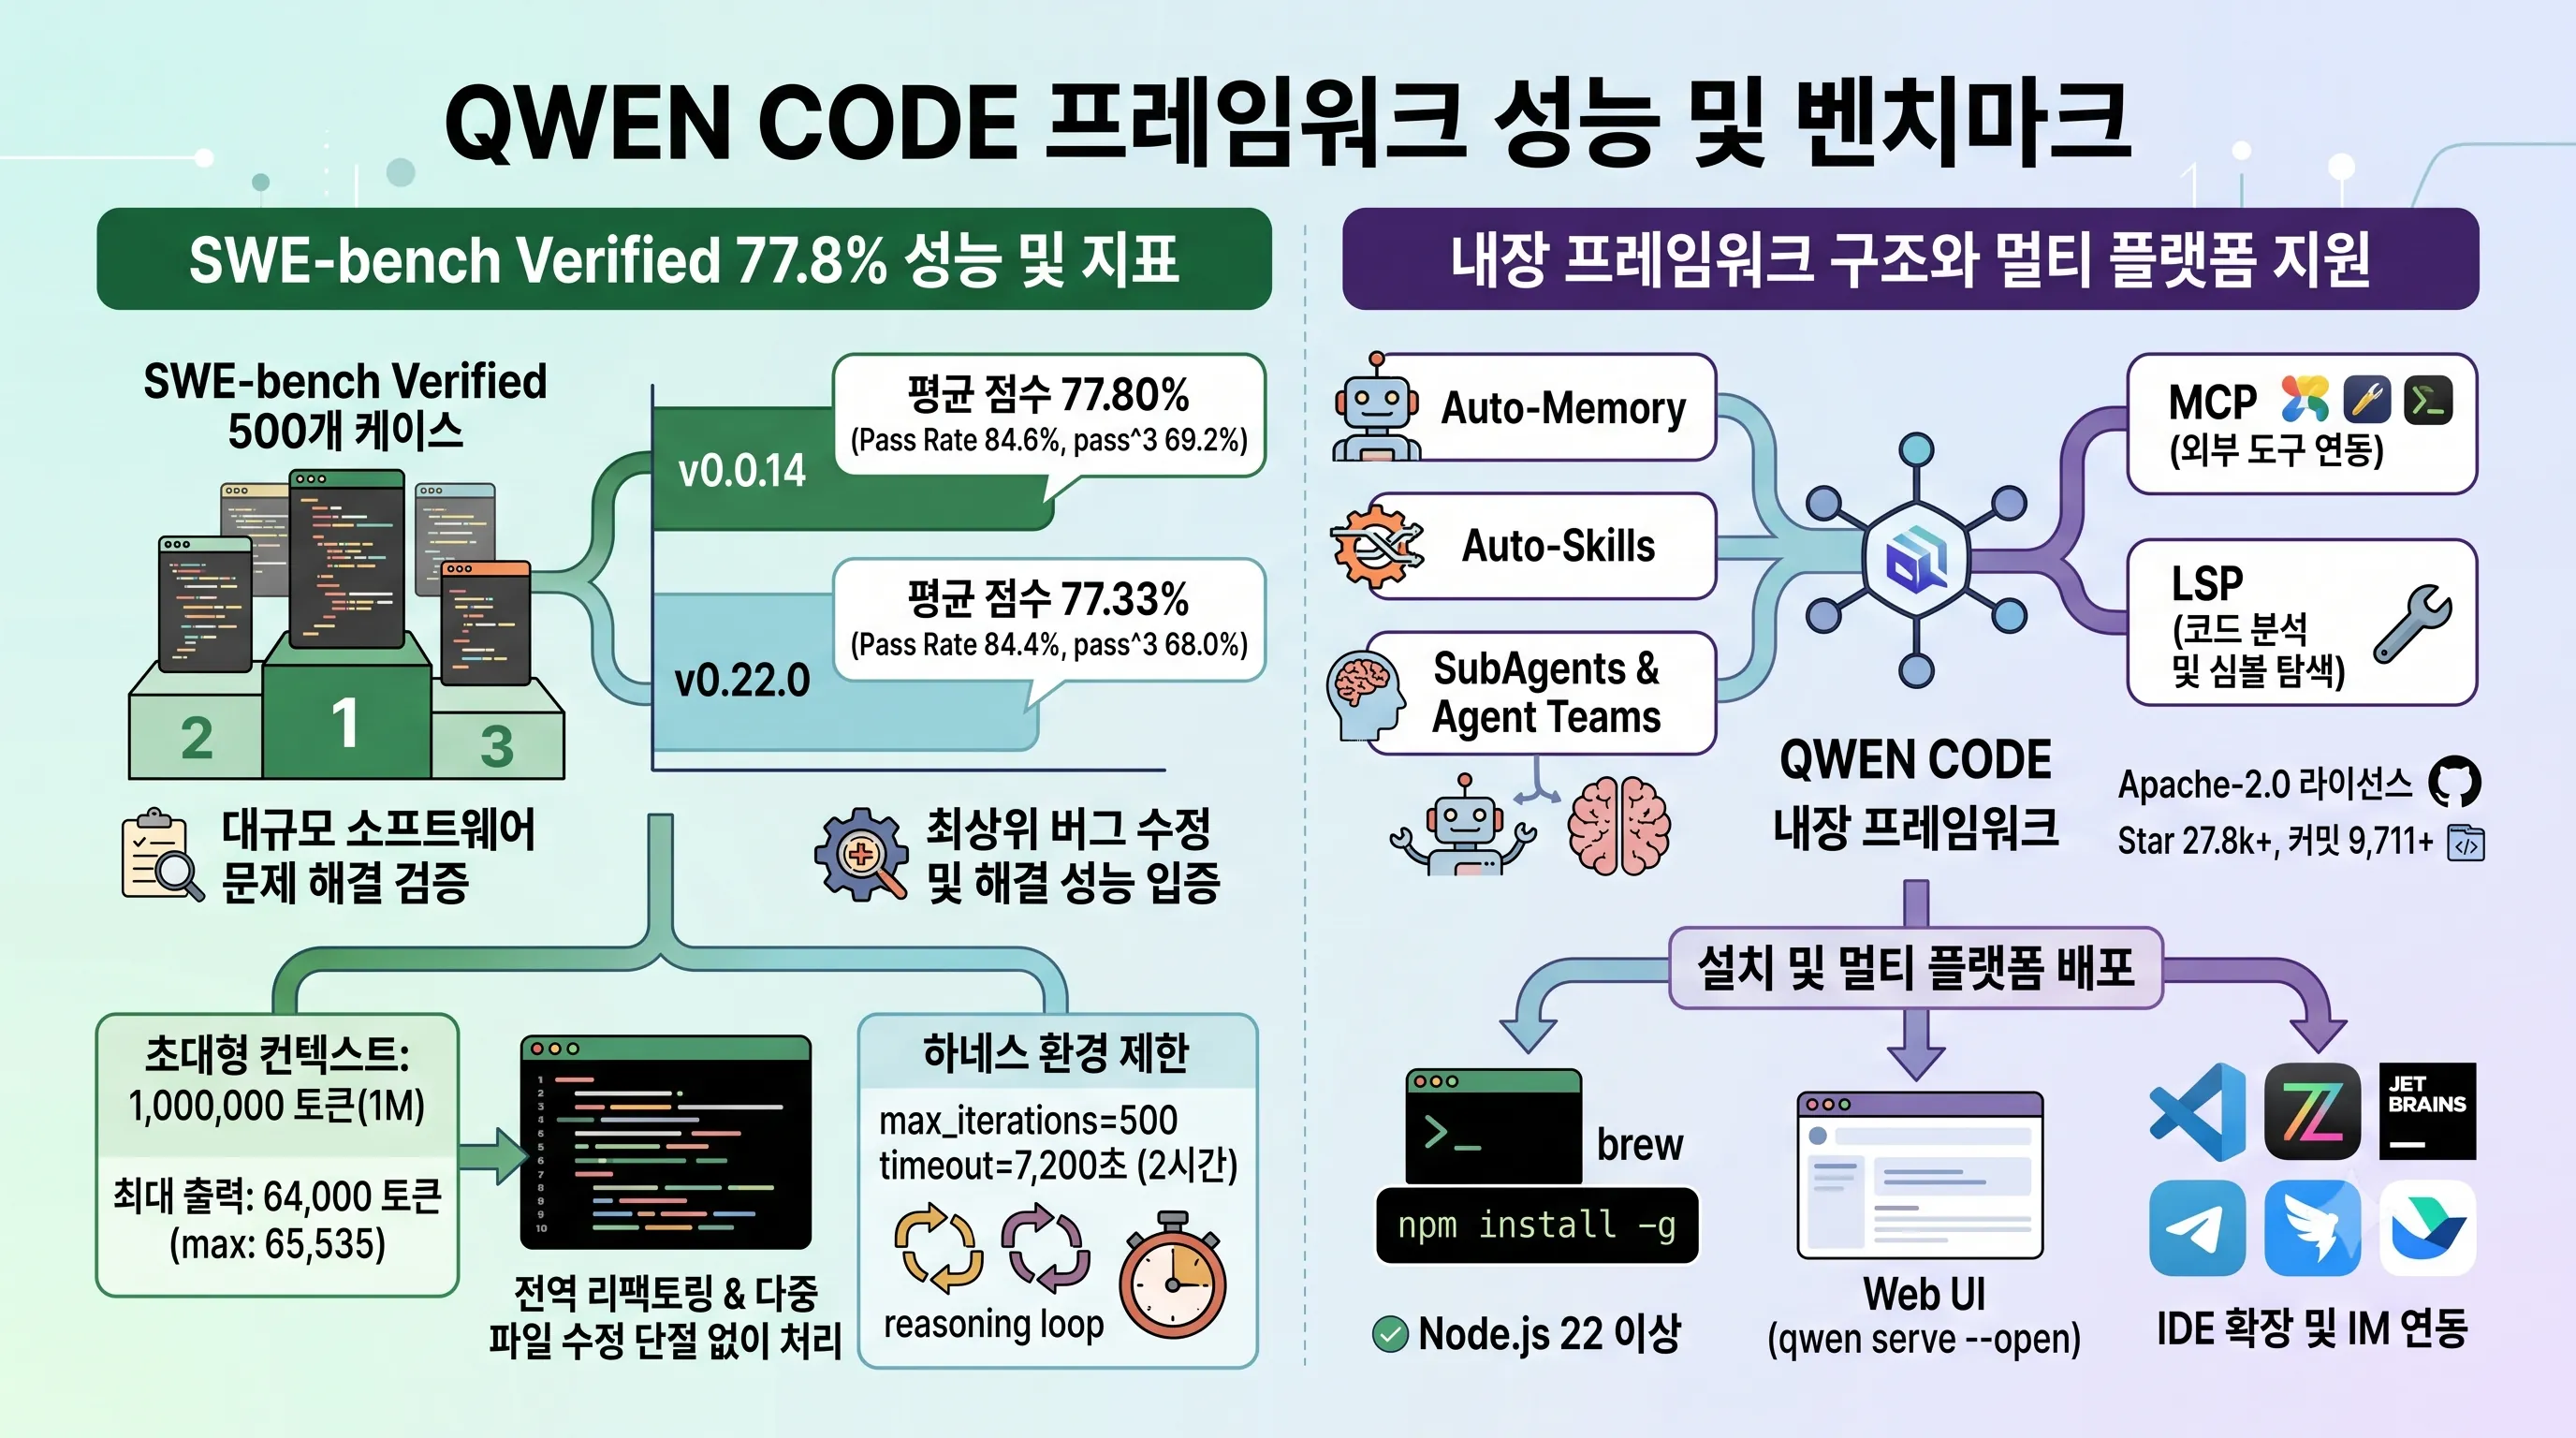
npx taste로 팀 컨벤션을 동기화합니다. - Qwen Code 프레임워크는 SWE-bench Verified 77.80%를 달성했으며, 1M 컨텍스트 및 최대 64,000 출력 토큰, 내장 LSP와 Auto-Memory 체계를 지원합니다.
- CLI 환경에서
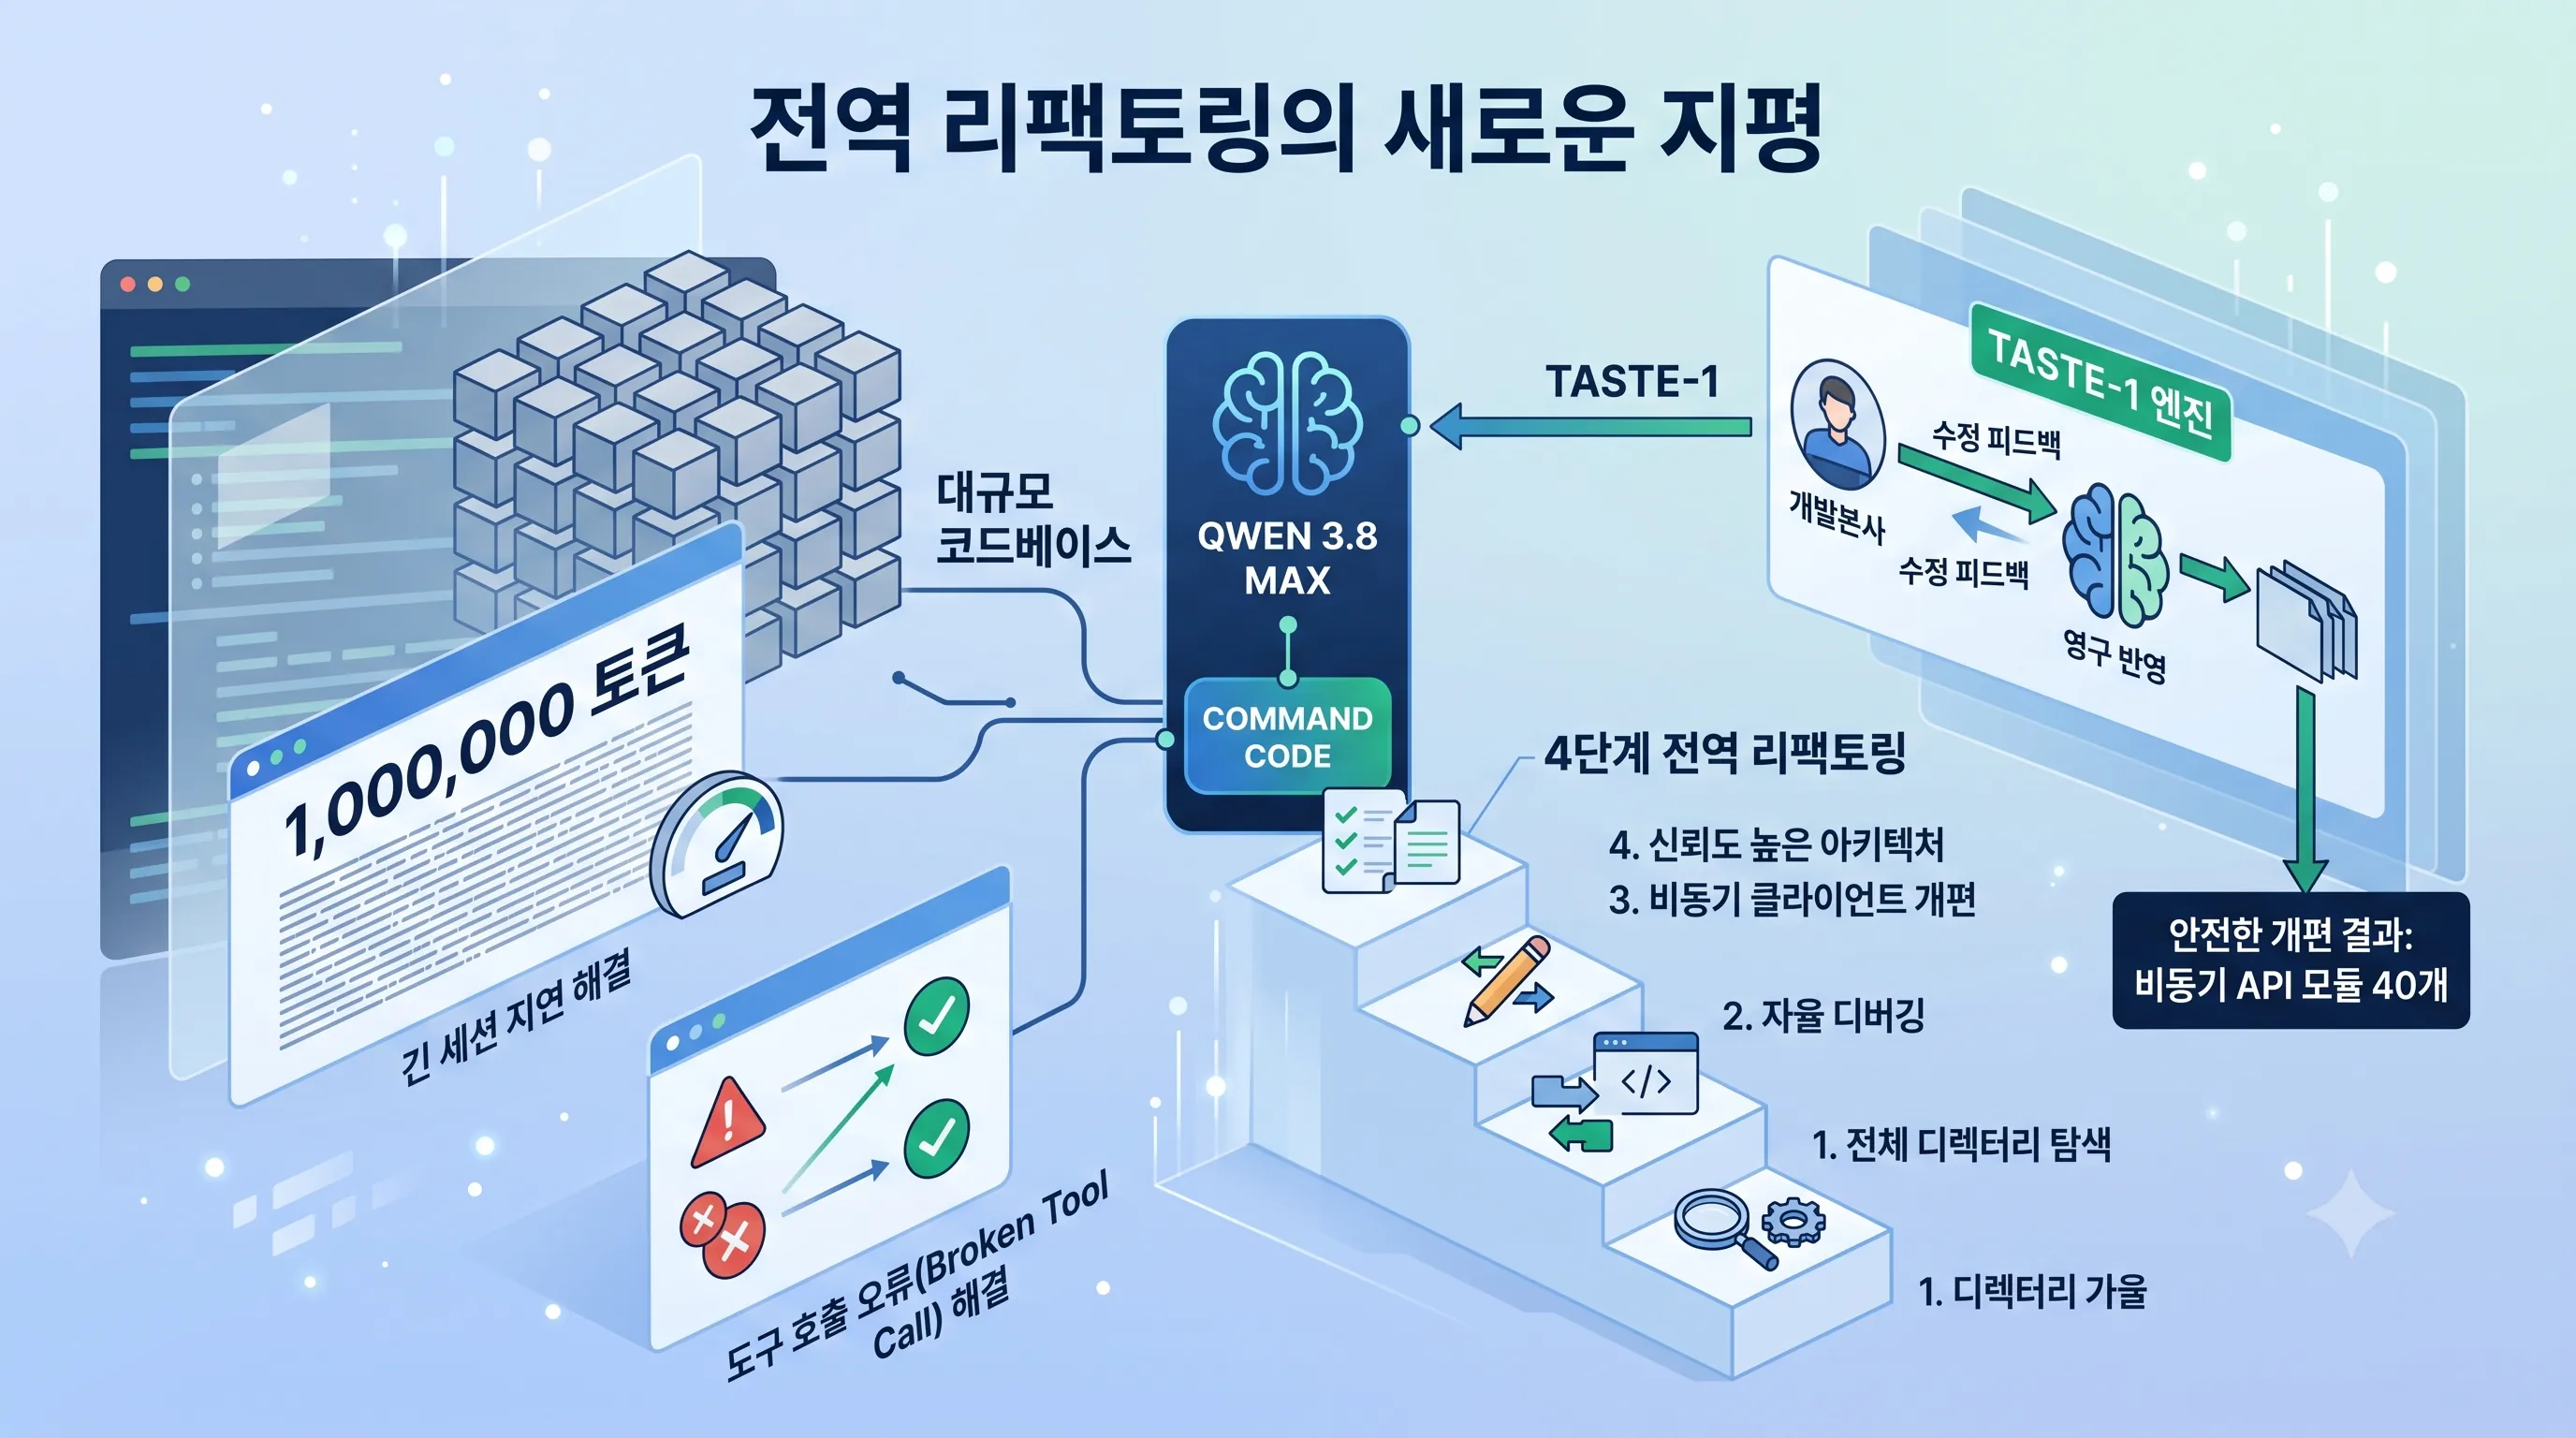
qwen3.8-max세션을 구동해 40여 개requests엔드포인트를 비동기httpx로 전환하고 100% 테스트 통과까지 자율 디버깅을 완수했습니다. - @/src 일괄 탑재, /plan 선검증, /compress-fast 경량화, 테스트 오라클 자율 루프로 이어지는 4단계 전역 리팩토링 패턴을 확립했습니다.
- 명확한 접두사 체계(/, @, !)와 함께 12개 병렬 에이전트 기반
/review, 컨텍스트를 분리하는/btw·/advisor, 5단계 승인 모드로 세션을 정밀 제어합니다. - Cloudflare Code Mode MCP를 통해 2,500개 API를 약 1,000 토큰으로 압축 연동하며, 130T+ 서빙 토큰 검증과 월 $1(Go)부터 시작하는 요금제를 제공합니다.
대규모 코드베이스를 전역적으로 리팩토링하는 작업은 수많은 모듈 간 의존성과 파편화된 컨텍스트로 인해 AI 에이전트 도입의 대표적인 난제로 꼽혀왔습니다.
특히 터미널 환경에서 오픈소스 대형 언어 모델(LLM)을 구동할 때 반복되는 도구 호출 오류(Broken Tool Call)와 긴 세션에 따른 지연 시간은 실전 적용을 가로막는 걸림돌이었습니다.
최근 1M(1,000,000) 토큰 단일 컨텍스트 윈도우를 지원하는 Qwen 3.8 Max와 오픈 모델 전용 런타임 하네스인 Command Code의 등장은 이러한 엔지니어링 워크플로우를 근본적으로 변화시켰습니다.
프로젝트 전체 디렉터리를 한 번에 탑재하고, 개발자의 수정 피드백을 영구 반영하는 taste-1 엔진을 통해 터미널 환경에서도 신뢰도 높은 자율 디버깅과 아키텍처 개선이 가능해졌습니다.
본 글에서는 Command Code CLI 환경을 구축하여 Qwen 3.8 Max로 실제 동기식 API 모듈 40여 개를 비동기 클라이언트로 안전하게 전면 개편한 4단계 전역 리팩토링 실전 패턴과 주요 운영 노하우를 상세히 살펴봅니다.
1. MoE 아키텍처와 1M 컨텍스트를 탑재한 Qwen 3.8 Max의 핵심 사양
Qwen 3.8 Max 아키텍처 및 핵심 사양과 특징
알리바바 클라우드(Alibaba Cloud)가 선보인 Qwen 3.8 Max는 대규모 코드베이스 분석 및 전역 리팩토링 환경에 최적화된 최신 대형 언어 모델입니다.
기존 모놀리식 구조의 한계를 극복하기 위해 다중 전문가를 효율적으로 활성화하는 MoE(Mixture of Experts) 아키텍처를 채택하여, 방대한 파라미터 규모를 유지하면서도 추론 시 필요한 연산 자원을 효율적으로 배분하도록 설계되었습니다.
이러한 아키텍처적 진환을 통해 터미널 에이전트와 같은 고부하 실시간 개발 도구 환경에서도 안정적인 지연 시간과 높은 처리 성능을 동시에 확보했습니다.
특히 개발 생태계의 접근성을 높이기 위해 오픈 가중치(Open weights) 방식으로 제공되어, 연구자와 엔지니어가 인프라 환경에 맞춰 유연하게 모델을 배포하고 활용할 수 있는 기반을 제공합니다.
초대규모 컨텍스트를 다루는 터미널 환경에서 프로젝트 전반의 소스 코드를 한 번에 로드하고 분석하는 작업에 최적화된 파이프라인을 구성할 수 있습니다.
| 구분 | 핵심 사양 및 지원 기능 | 기술적 특징 |
|---|---|---|
| 기반 아키텍처 | MoE(Mixture of Experts) | 토큰별 최적 전문가 서브넷 활성화를 통한 연산 효율성 극대화 |
| 배포 방식 | 오픈 가중치(Open weights) | 자체 인프라 배포 및 맞춤형 파인튜닝 지원 |
| 추론 및 제어 기능 | Thinking · Tool Use · Structured Output | 자체적 다단계 추론, 외부 CLI 도구 연동, 규격화된 JSON 출력 |
| 글로벌 벤치마크 | Text Arena 상위권 랭크 | 실시간 텍스트 생성 및 범용 추론 역량 검증 |
사고(Thinking) 및 도구 호출 역량과 Text Arena 랭킹
Qwen 3.8 Max는 단순한 텍스트 완성을 넘어 복잡한 공학적 문제를 해결할 수 있는 사고 기능(Thinking)을 기본 탑재하고 있습니다.
모델이 사용자 명령을 처리하기 전 내부적인 추론 과정을 거쳐 단계별 계획을 수립함으로써, 복잡한 전역 리팩토링 상황에서도 논리적 오류를 사전에 차단합니다.
터미널 환경에서 연속된 파일 수정 및 빌드 명령을 실행할 때 발생하는 예외 상황을 모델 스스로 예측하고 대응 방안을 마련하는 데 핵심적인 역할을 수행합니다.
또한 실무 개발 환경 연동을 위한 도구 사용(Tool use) 기능과 정확한 데이터 규격을 보장하는 구조화된 출력(Structured Output)을 완벽히 지원합니다.
터미널 에이전트가 요구하는 JSON 스키마나 특정 CLI 명령어 인터페이스에 맞춰 오차 없이 응답을 생성하므로, 외부 도구 호출 시 파싱 에러나 실행 실패를 원천적으로 방지합니다.
이러한 뛰어난 범용 언어 이해 및 코드 제어 능력은 글로벌 평가 지표인 Text Arena 랭킹 상위권 진입을 통해 공식적으로 입증되었습니다.
2. Broken Tool Call 복구와 taste-1 RL 엔진: Command Code 하네스 특성
1T 토큰당 100만 회 도구 복구 및 99% 프롬프트 캐시 적중률
오픈소스 거대언어모델(LLM)을 터미널 에이전트로 구동할 때 발생하는 치명적인 병목 현상은 문법적 오류나 비정형 출력으로 인한 Broken Tool Call입니다.
Command Code는 이러한 도구 호출 실패를 실시간으로 교정하여 토큰 비용 폭증과 세션 중단을 방어하는 전용 런타임 하네스를 제공합니다.
특히 하네스 차원에서 1조(1T) 토큰당 100만 회의 도구 호출 복구(Repair) 기능을 무료로 지원하여 오픈소스 모델의 프로덕션 배포 안정성을 대폭 끌어올렸습니다.
대규모 코드베이스 탐색 시 발생하는 I/O 비용 또한 아키텍처 레벨에서 최적화되었습니다.
하네스는 파일 읽기(read) 및 셸(shell) 명령어 실행 시 99% 이상의 프롬프트 캐시 적중률을 달성하도록 설계되었습니다.
이를 통해 10개 하네스를 비교 측정한 TEF(Token Efficiency Frontier) 벤치마크에서 선도적인 위치를 기록하며 압도적인 토큰 효율성을 입증했습니다.
실제로 개발자 David Thyresson은 "Command Code는 프로덕션 환경에서 오픈 모델을 신뢰할 수 있게 만든 최초의 에이전트이며, 단 2달러로 다수의 CLI와 완전한 Redwood 앱을 배포했다"고 평가했습니다.
| 구분 | 주요 기술 사양 및 성능 지표 |
|---|---|
| 도구 복구(Repair) 지원 | 1조(1T) 토큰당 100만 회 도구 호출 복구 무료 제공 |
| 프롬프트 캐시 적중률 | 파일 읽기(read) 및 셸(shell) 실행 시 99% 이상 달성 |
| 토큰 효율성 평가 | TEF(Token Efficiency Frontier) 벤치마크 선도 (10개 하네스 대비 검증) |
| 적응형 학습 엔진 | taste-1 신경-기호(Neuro-symbolic) 강화학습(RL) 엔진 |
| 컨벤션 동기화 | npx taste push / pull 기반 패키지 공유 |
| 라이선스 및 서비스 형태 | 상용 구독 기반 제품 (완전 오픈소스 아님) |
taste-1 신경-기호 RL 엔진과 팀 컨벤션 공유(npx taste)
Command Code의 핵심 경쟁력은 개발자의 상호작용 데이터를 흡수하는 taste-1 신경-기호(Neuro-symbolic) RL 엔진에 있습니다.
터미널 환경에서 발생하는 개발자의 Accept, Reject, Edit 신호를 실시간으로 학습하여 개별 엔지니어의 코딩 스타일과 선호도를 에이전트에 영구적으로 반영합니다.
Zeno Rocha는 "Command Code는 나의 취향(taste)을 학습하며, 일주일 사용 후에는 다른 에이전트에서 반복 수정하던 실수를 완전히 멈췄다"고 분석했습니다.
개인화된 에이전트 지식은 팀 전체로 손쉽게 확장됩니다.
개발팀은 npx taste push / pull 명령어를 활용하여 조직 내 코딩 컨벤션과 맞춤형 스킬 패키지를 간편하게 배포하고 동기화할 수 있습니다.
다만 Command Code는 상용 구독 기반 제품으로 제공되며, 전체 소스코드가 공개된 완전 오픈소스 소프트웨어가 아니라는 구조적 특성을 인지하고 도입 계획을 수립해야 합니다.
3. SWE-bench Verified 77.8%: Qwen Code 프레임워크 성능 및 벤치마크
SWE-bench Verified 벤치마크 지표 및 세부 실행 제한
Qwen Code 프레임워크는 대규모 소프트웨어 엔지니어링 문제를 해결하는 능력을 검증하기 위해 SWE-bench Verified 500개 케이스를 기준으로 성능 평가를 진행했습니다.
공식 벤치마크 결과에 따르면, Qwen Code v0.0.14 버전은 평균 점수 77.80%, Pass Rate 84.6%, pass^3 69.2%라는 높은 해결 능력을 기록했습니다.
이어 최적화가 적용된 Qwen Code v0.22.0 버전에서도 평균 점수 77.33%, Pass Rate 84.4%, pass^3 68.0%를 달성하며 일관되게 최상위 수준의 코드 수정 및 문제 해결 성능을 입증했습니다.
이러한 성능 지표는 모델이 광범위한 코드베이스를 한 번에 탐색하고 대규모 패치를 생성할 수 있는 구조적 스펙에 기반합니다.
Qwen Code는 1,000,000 토큰(1M)에 달하는 초대형 컨텍스트 길이를 지원하며, 출력 토큰은 최대 64,000 토큰(model_max_tokens: 65,535)까지 생성할 수 있어 전역 리팩토링 및 다중 파일 수정 작업을 단절 없이 처리합니다.
또한 벤치마크 평가를 위한 하네스 환경 제한 조건으로는 max_iterations=500과 실행 제한 시간 runtime_timeout_sec=7,200이 설정되어 복잡한 버그 해결을 위한 다단계 추론 루프를 안정적으로 지원합니다.
| 구분 | Qwen Code v0.0.14 | Qwen Code v0.22.0 | 하네스 및 컨텍스트 스펙 |
|---|---|---|---|
| 평균 점수 | 77.80% | 77.33% | 컨텍스트 길이: 1,000,000 토큰 (1M) |
| Pass Rate | 84.6% | 84.4% | 최대 출력 토큰: 64,000 (설정치: 65,535) |
| pass^3 지표 | 69.2% | 68.0% | max_iterations=500 / timeout=7,200초 |
Auto-Memory·LSP 내장 프레임워크 구조와 멀티 플랫폼 지원
오픈소스 생태계에서 Qwen Code는 Apache-2.0 라이선스를 기반으로 공개되어 있으며, GitHub 저장소 기준 27.8k 이상의 Star와 9,711개 커밋을 기록하며 활발한 개발이 이루어지고 있습니다.
단순한 터미널 스크립트 수준을 넘어선 에이전트 아키텍처를 제공하기 위해 Auto-Memory와 Auto-Skills 모듈이 기본 탑재되어 있으며, 하위 작업을 분담하는 SubAgents와 Agent Teams 협업 체계를 기본으로 지원합니다.
여기에 외부 도구 연동을 위한 MCP(Model Context Protocol)와 정확한 코드 분석 및 심볼 탐색을 돕는 LSP(Language Server Protocol)가 내장되어 전문적인 개발 환경을 구성합니다.
설치 및 실행 환경의 경우 최신 런타임인 Node.js 22 이상 환경을 요구하며, 패키지 매니저를 통해 npm install -g @qwen-code/qwen-code@latest 또는 brew 명령어로 간편하게 구축할 수 있습니다.
지원 인터페이스는 명령줄 기반의 터미널 에이전트에 국한되지 않고 데스크톱 앱과 브라우저에서 실행 가능한 Web UI(qwen serve --open) 환경을 포괄합니다.
나아가 VS Code, Zed, JetBrains 등 주요 IDE 확장 프로그램은 물론 Telegram, DingTalk, Feishu와 같은 인스턴트 메신저(IM) 연동까지 멀티 플랫폼 형태로 유연하게 배포 및 활용할 수 있습니다.
4. Command Code CLI 환경 구축 및 Qwen 3.8 Max 실습 워크플로우
글로벌 CLI 설치 및 qwen3.8-max 모델 세션 활성화
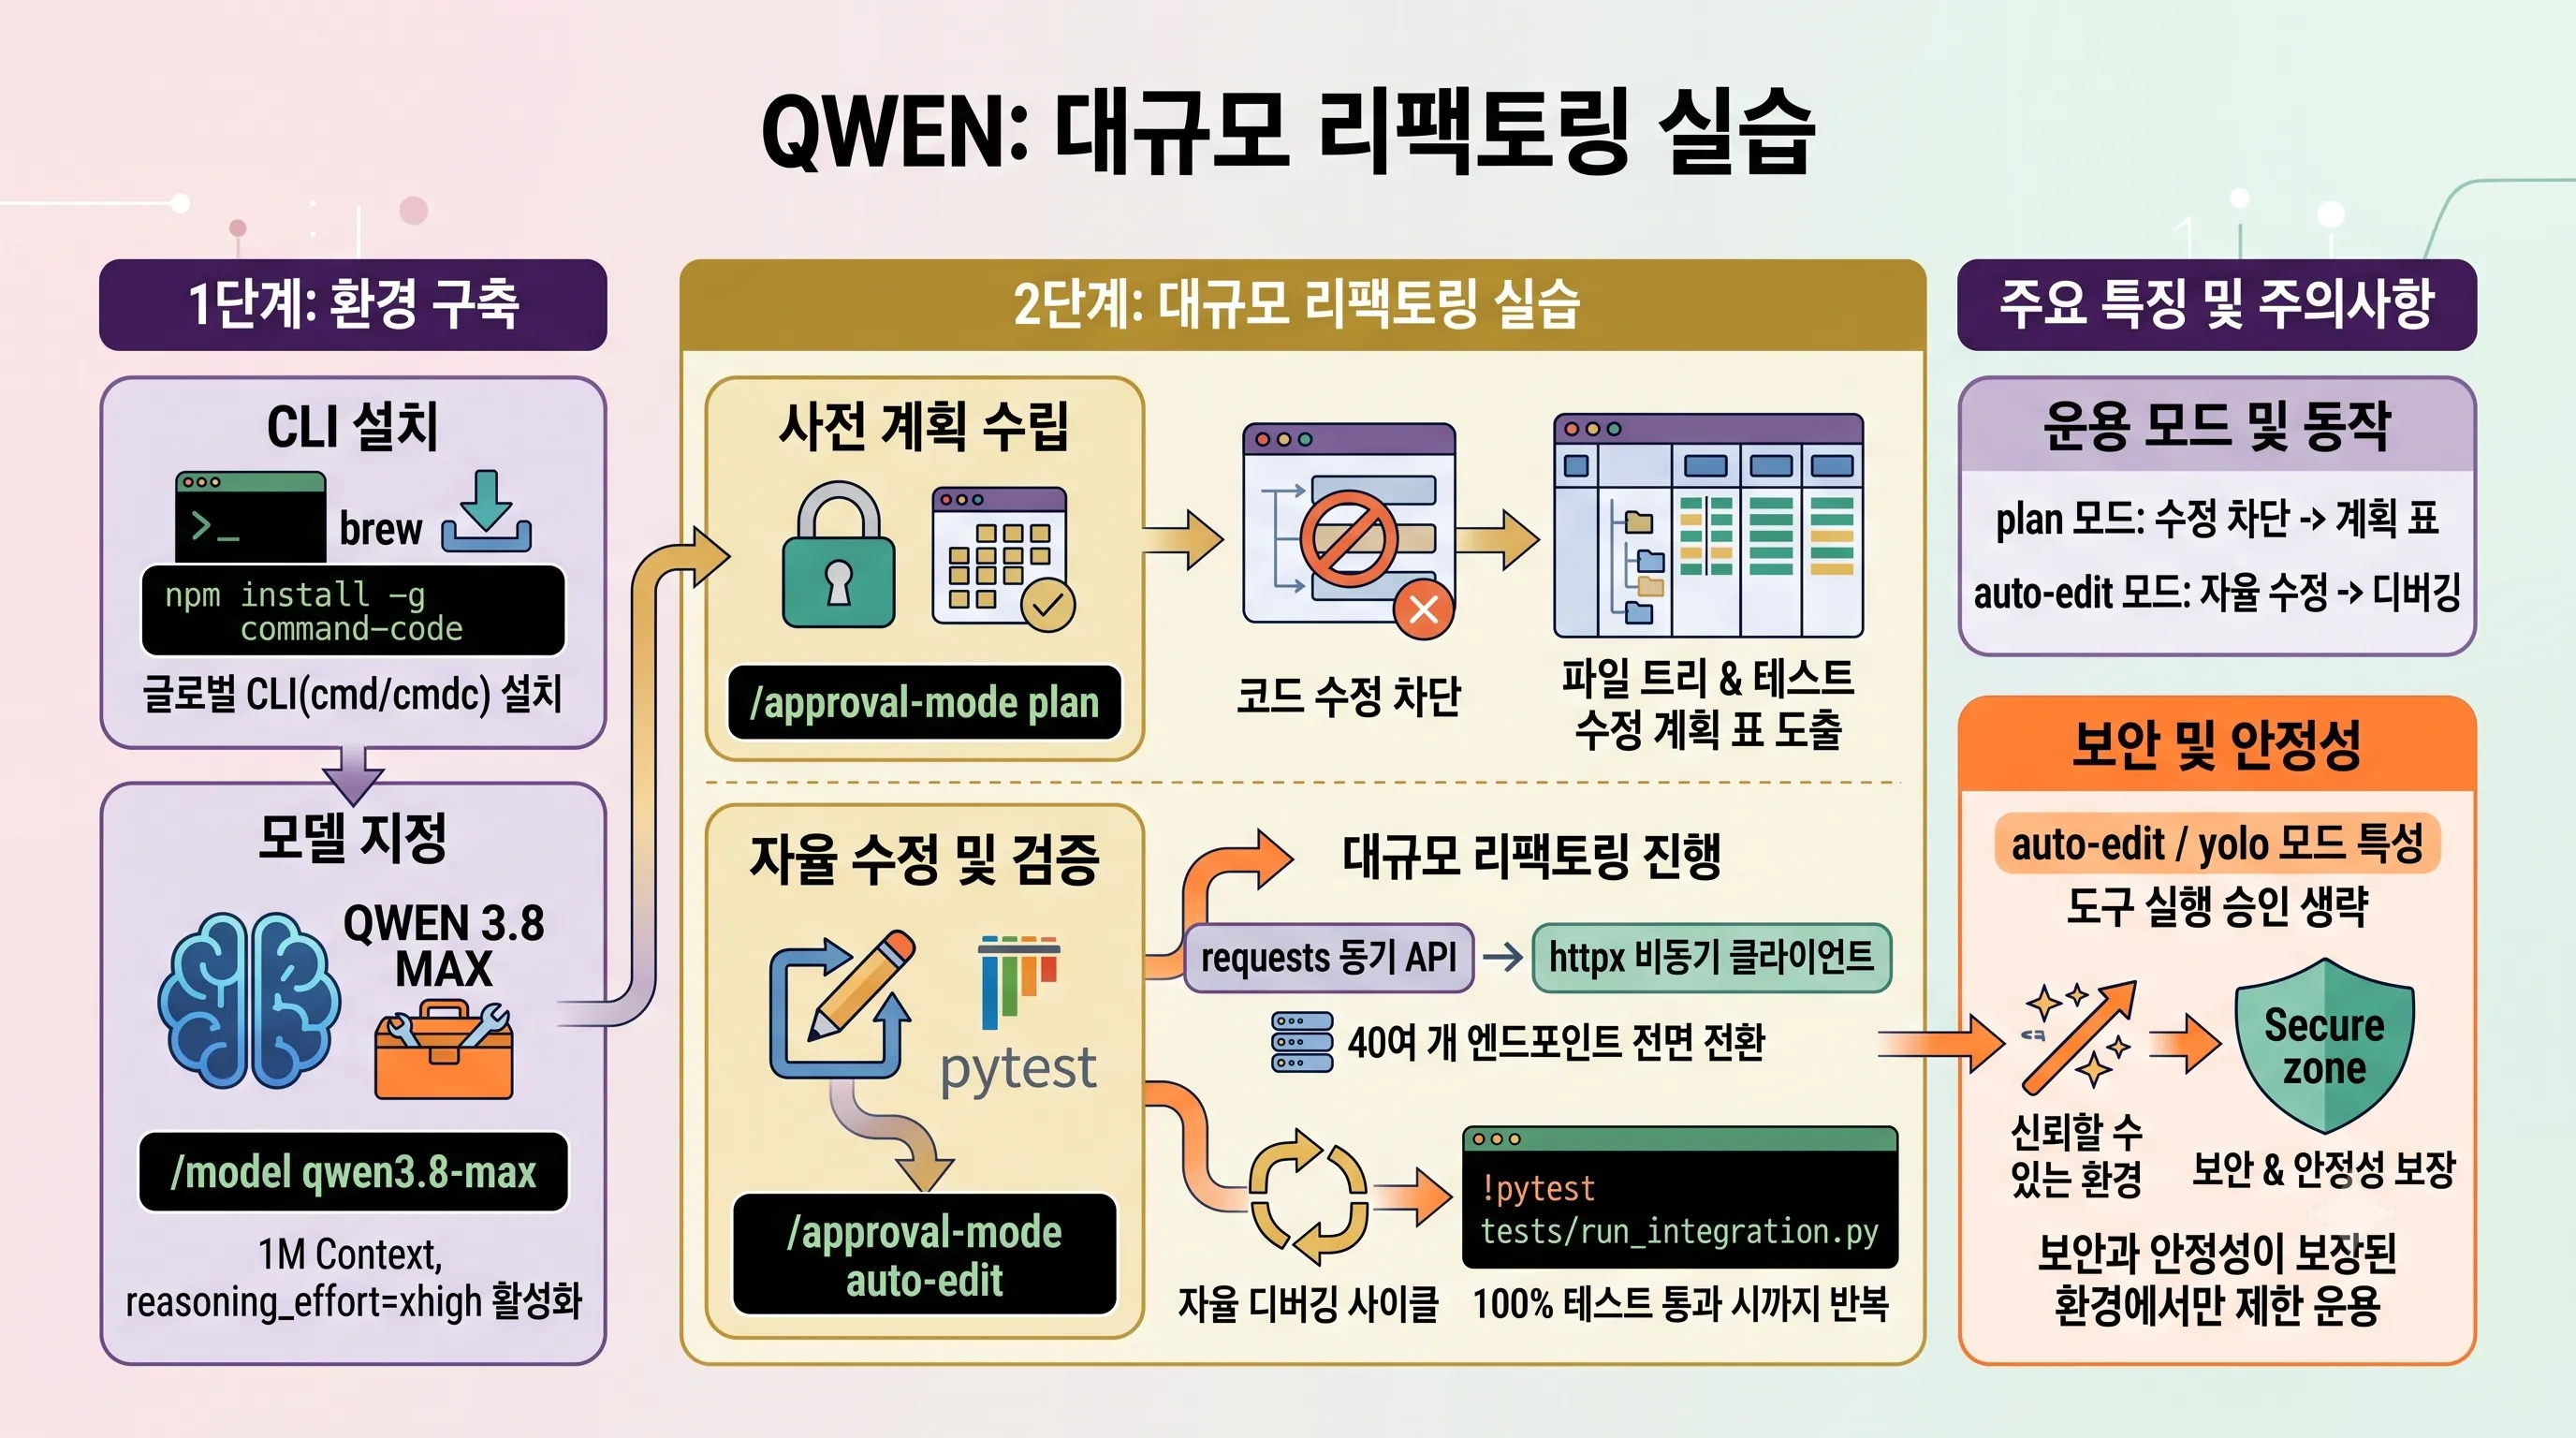
터미널 기반 코딩 에이전트 환경을 구축하기 위해 npm install -g command-code 명령어를 실행하여 글로벌 CLI 환경을 설정합니다.
이 과정을 통해 기본 환경에서는 cmd, 윈도우 환경에서는 cmdc 명령어로 터미널 에이전트 인터페이스에 즉각 접근할 수 있습니다.
실행된 세션 내부에서 /model qwen3.8-max 명령어를 입력하면 모델 전환이 이루어집니다.
해당 설정은 1M Context 전역 처리 역량과 함께 심층적 추론을 수행하는 reasoning_effort=xhigh 모드를 활성화하여 복잡한 대규모 코드베이스 분석에 최적화된 상태를 구성합니다.
| 구분 | 설정 명령어 및 모드 | 주요 기능 및 동작 특성 |
|---|---|---|
| CLI 설치 | npm install -g command-code | 글로벌 CLI(cmd / Windows: cmdc) 환경 설치 |
| 모델 지정 | /model qwen3.8-max | 1M Context 활성화 및 reasoning_effort=xhigh 추론 모드 진입 |
| 사전 계획 수립 | /approval-mode plan | 코드 직접 수정을 차단하고 파일 트리 및 테스트 수정 계획 도출 |
| 자율 수정 및 검증 | /approval-mode auto-edit | 통합 테스트 기반 100% 통과 시점까지 자율 디버깅 수행 |
requests에서 비동기 httpx로의 40여 개 엔드포인트 전면 전환 실전
대규모 리팩토링 단계에서는 예기치 않은 소스 코드 오염을 방지하기 위해 /approval-mode plan 설정을 적용합니다.
이 모드는 에이전트의 코드 직접 수정을 차단하며, 수정 작업으로 영향을 받는 파일 트리와 단위 테스트 수정 계획을 정리된 표 형태로 선제 출력하도록 유도합니다.
수정 계획이 확정된 이후에는 /approval-mode auto-edit 모드로 전환하여 본격적인 코드 변경 작업을 진행합니다.
에이전트는 기존의 requests 라이브러리 기반 동기식 외부 API 호출부 40여 개를 비동기 httpx 클라이언트 구조로 전면 전환하는 대규모 리팩토링을 수행합니다.
코드 수정과 동시에 !pytest tests/run_integration.py 명령어를 연계 실행하여 검증 프로세스를 가동합니다.
에이전트는 통합 테스트가 100% 테스트 통과를 달성할 때까지 오류 로그를 스스로 분석하며 자율 디버깅 사이클을 반복 완료합니다.
다만 auto-edit 및 yolo 모드는 도구 실행 승인 프롬프트를 생략하는 구조적 특성을 지닙니다.
따라서 자동화된 파일 수정 및 명령어 실행 권한이 직접 부여되므로, 보안과 안정성이 보장된 신뢰할 수 있는 환경에서만 제한적으로 운용해야 합니다.
5. 1M 컨텍스트 전역 리팩토링 4단계 실행 패턴
1단계: @/src 일괄 탑재와 2단계: /plan 청사진 선검증
대규모 코드베이스 리팩토링에서 가장 큰 병목은 모듈 간의 파편화된 의존성을 파악하는 과정입니다.
터미널 에이전트 환경에서는 수동으로 개별 소스 파일을 복사해 붙여넣는 비효율을 없애기 위해 1M(1,000,000) 토큰 단일 컨텍스트 윈도우를 활용합니다.
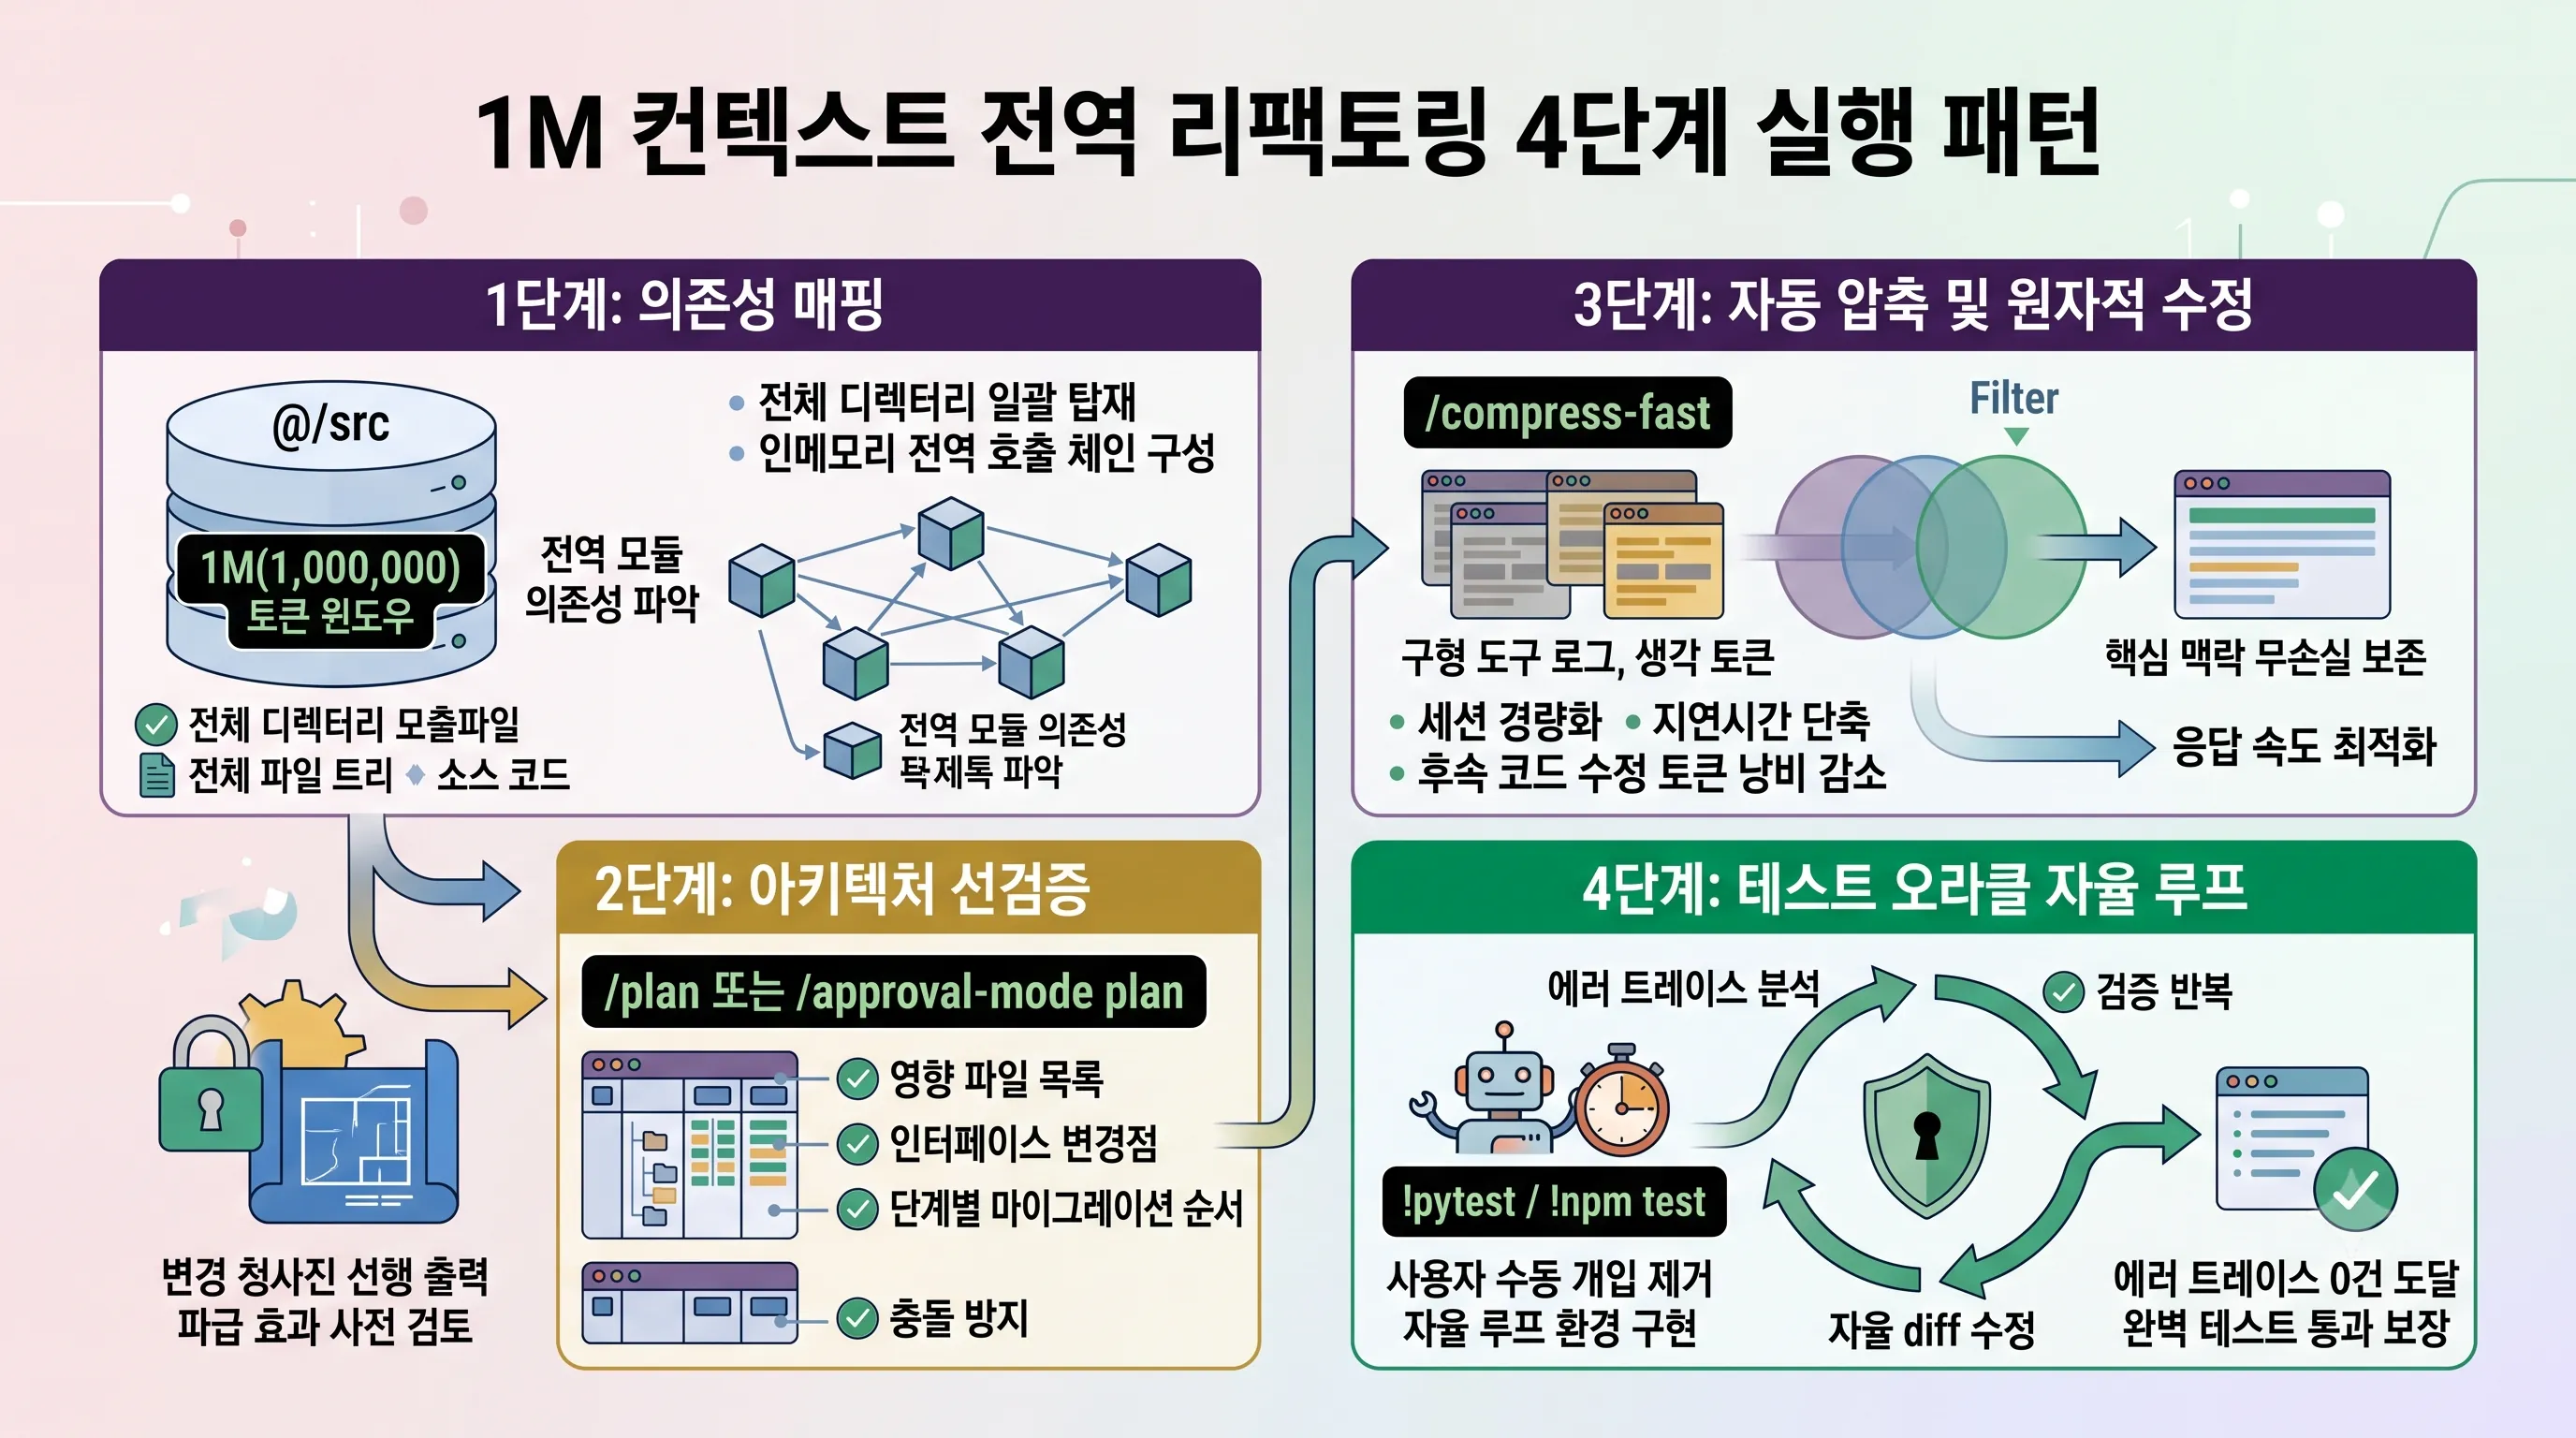
1단계인 의존성 매핑 단계에서는 @/src 지시어를 입력하여 전체 디렉터리의 파일 트리와 소스 코드를 단일 컨텍스트에 한 번에 탑재합니다.
이를 통해 분산된 모듈 간의 참조 관계와 전역 호출 체인을 즉시 인메모리 상에서 온전하게 구성할 수 있습니다.
전체 컨텍스트가 로드된 이후에는 곧바로 코드를 수정하지 않고 2단계인 아키텍처 선검증을 거칩니다.
사용자는 /plan 또는 /approval-mode plan 명령을 호출하여 변경될 아키텍처 청사진을 사전에 출력하도록 지시합니다.
이 과정에서 터미널 에이전트는 리팩토링 대상이 되는 영향 파일 목록, 인터페이스 변경점, 구체적인 마이그레이션 순서를 체계적으로 정리하여 사용자에게 선행 제시합니다.
개발자는 코드베이스 전반에 미치는 파급 효과를 사전에 검토함으로써 구조적 결함이나 예기치 못한 인터페이스 충돌을 방지합니다.
3단계: /compress-fast 세션 경량화와 4단계: 테스트 오라클 자율 루프
대규모 컨텍스트를 다루는 작업에서는 세션이 누적됨에 따라 지연시간이 증가하는 기술적 이슈가 동반됩니다.
컨텍스트 길이가 길어짐에 따라 발생하는 지연시간 단축을 위해 주기적인 세션 압축이 필수적이며, 이때 3단계인 /compress-fast 명령어를 적용합니다.
해당 명령은 작업 과정에서 누적된 구형 도구 호출 로그와 모델의 생각 토큰을 핵심 맥락의 손실 없이 제거하여 세션을 즉시 경량화합니다.
이를 통해 후속 원자적 코드 수정 과정에서 불필요한 토큰 낭비를 줄이고 응답 속도를 최적화합니다.
최종 4단계에서는 백그라운드 셸을 활용한 테스트 오라클 자율 루프가 작동합니다.
터미널 에이전트는 백그라운드 셸(!) 지시어를 통해 pytest나 npm test와 같은 검증 스위트를 직접 실행합니다.
테스트 실행 결과 반환되는 실패 로그를 스스로 분석하며 에러 트레이스가 0건에 도달할 때까지 자율적으로 diff 수정과 검증을 반복 수행합니다.
사용자의 반복적인 수동 개입 없이도 완벽한 테스트 통과를 보장하는 자율 루프 환경을 구현합니다.
| 단계 구분 | 실행 명령어 및 도구 | 주요 역할 및 동작 메커니즘 |
|---|---|---|
| 1단계: 의존성 매핑 | @/src | 1M(1,000,000) 토큰 윈도우에 전체 디렉터리를 일괄 탑재하여 전역 모듈 의존성 파악 |
| 2단계: 아키텍처 선검증 | /plan 또는 /approval-mode plan | 영향 파일 목록, 인터페이스 변경점, 단계별 마이그레이션 순서 청사진 선행 출력 |
| 3단계: 자동 압축 및 원자적 수정 | /compress-fast | 구형 도구 호출 로그 및 생각 토큰의 무손실 제거를 통한 지연시간 단축 및 세션 경량화 |
| 4단계: 테스트 오라클 자율 루프 | !pytest / !npm test | 백그라운드 셸 기반 테스트 실행 및 에러 트레이스 0건 도달 시까지 자율 diff 수정 반복 |
6. 접두사 체계(/, @, !)와 Qwen Code 세션 제어 명령어
슬래시(/), 앳(@), 느낌표(!) 접두사 규칙과 다중 에이전트(/review, /advisor)
터미널 기반 에이전트 환경에서 작업 효율성을 극대화하기 위해 Qwen Code는 명확한 접두사 체계를 제공합니다.
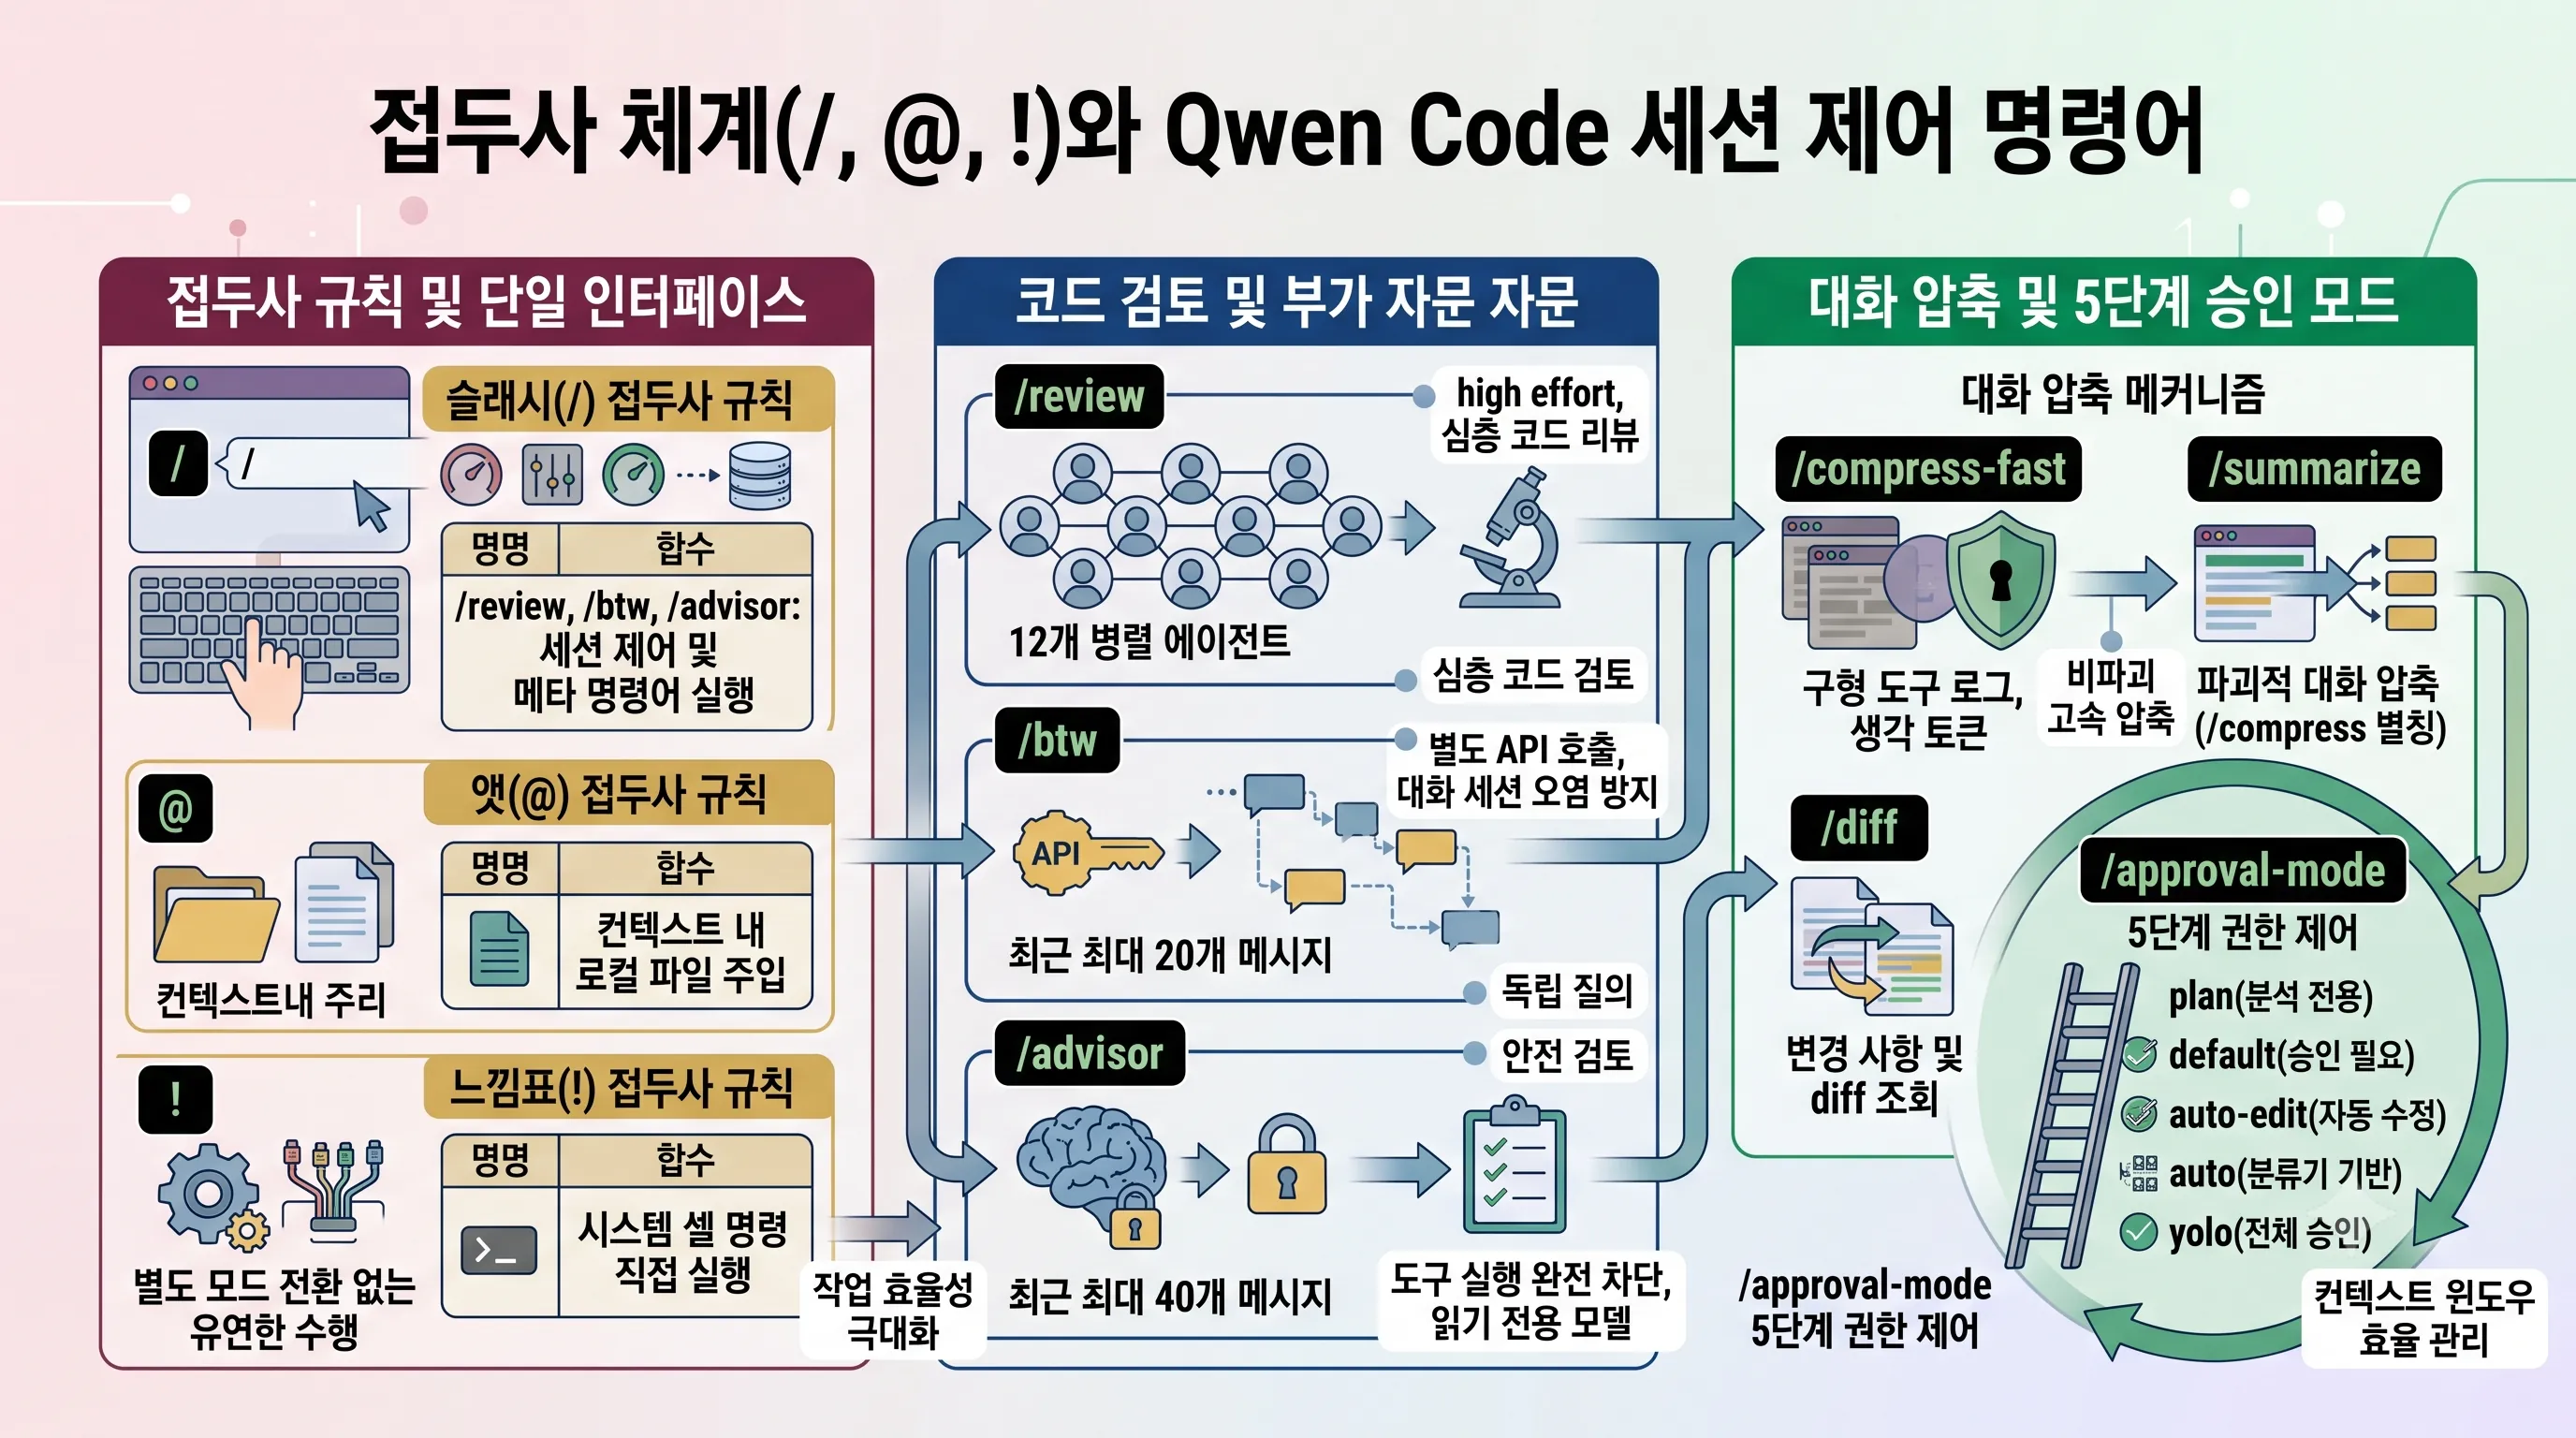
사용자는 명령 창의 첫 문자에 따라 입력의 성격을 제어할 수 있으며, 슬래시(/)는 세션 제어 및 메타 명령어 실행, 앳(@)은 컨텍스트 내 로컬 파일 주입, 느낌표(!)는 시스템 셸 명령의 직접 실행으로 구분됩니다.
이러한 접두사 분기를 통해 개발자는 별도의 모드 전환 없이 셸 호출과 파일 컨텍스트 참조, 메타 세션 조작을 단일 인터페이스에서 유연하게 수행할 수 있습니다.
코드베이스 검토 및 부가 자문 작업에서는 전용 슬래시 명령어를 통한 컨텍스트 분리 기법이 핵심적인 역할을 담당합니다.
/review 명령어는 12개 병렬 에이전트를 high effort 수준으로 실행하여 심층적인 다중 에이전트 코드 리뷰를 진행합니다.
독립된 작업 흐름이 필요한 경우 /btw 명령어를 활용하여 최근 최대 20개 메시지의 컨텍스트만 별도 API 호출로 분리 전송함으로써 메인 대화 세션을 오염시키지 않고 질의할 수 있습니다.
또한 /advisor 명령어는 최근 최대 40개 메시지를 도구 실행이 완전히 차단된 읽기 전용 모델로 전송하여 안전한 아키텍처 및 로직 검토를 지원합니다.
/compress-fast 대화 압축과 5단계 승인 모드(/approval-mode)
대규모 리팩토링 과정에서 컨텍스트 윈도우를 효율적으로 관리하기 위한 압축 메커니즘도 세분화되어 있습니다.
/compress-fast 명령어는 별도의 AI 추론 연산을 거치지 않고 이전 도구 실행 로그와 생각(thinking) 토큰을 즉시 제거하여 고속으로 세션을 경량화합니다.
반면 /summarize 명령어는 /compress의 별칭으로 동작하며 대화 기록 자체를 요약 및 압축하는 파괴적(destructive) 작업에 해당하므로 보존해야 할 상세 맥락에 따라 전략적인 선택이 요구됩니다.
작업 중 발생한 코드 변경 내역은 /diff 명령어를 통해 커밋되지 않은 변경 사항과 턴별 차이점을 대화형 뷰어로 신속하게 조회할 수 있습니다.
에이전트의 자율 수정 권한을 제어하는 /approval-mode는 환경과 위험도에 맞춰 총 5단계 옵션을 제공합니다.
분석 전용 모드인 plan부터 파일 수정 시 매번 확인을 거치는 default, 파일 수정을 자동으로 진행하는 auto-edit, 분류기 모델의 판단에 기반하는 auto, 그리고 모든 도구 실행과 파일 수정을 무조건 승인하는 yolo 모드로 구성됩니다.
| 명령어 / 모드 | 유형 / 단계 | 주요 기능 및 동작 스펙 |
|---|---|---|
| /review | 다중 에이전트 리뷰 | 12개 병렬 에이전트를 high effort로 실행하여 심층 코드 검토 수행 |
| /btw | 컨텍스트 분리 질의 | 최근 최대 20개 메시지를 별도 API 호출로 분리하여 전송 |
| /advisor | 읽기 전용 자문 | 최근 최대 40개 메시지를 도구 실행이 차단된 모델로 전송해 검토 |
| /compress-fast | 비파괴 고속 압축 | 추론 없이 도구 실행 로그 및 생각(thinking) 토큰을 즉시 제거 |
| /summarize | 파괴적 대화 압축 | /compress 별칭으로 동작하며 대화 이력을 요약 압축하는 파괴적(destructive) 작업 |
| /diff | 변경 내역 검사 | 커밋되지 않은 변경 사항 및 턴별 diff를 대화형 뷰어로 조회 |
| /approval-mode | 5단계 권한 제어 | plan(분석 전용), default(승인 필요), auto-edit(자동 수정), auto(분류기 기반), yolo(전체 승인) |
7. Cloudflare 생태계 연동과 Code Mode MCP를 통한 초경량 도구 통합
2,500개 API를 1,000 토큰으로 압축하는 Code Mode MCP 아키텍처
터미널 에이전트 환경에서 방대한 인프라 API를 호출할 때 발생하는 가장 큰 병목은 컨텍스트 윈도우의 낭비입니다.
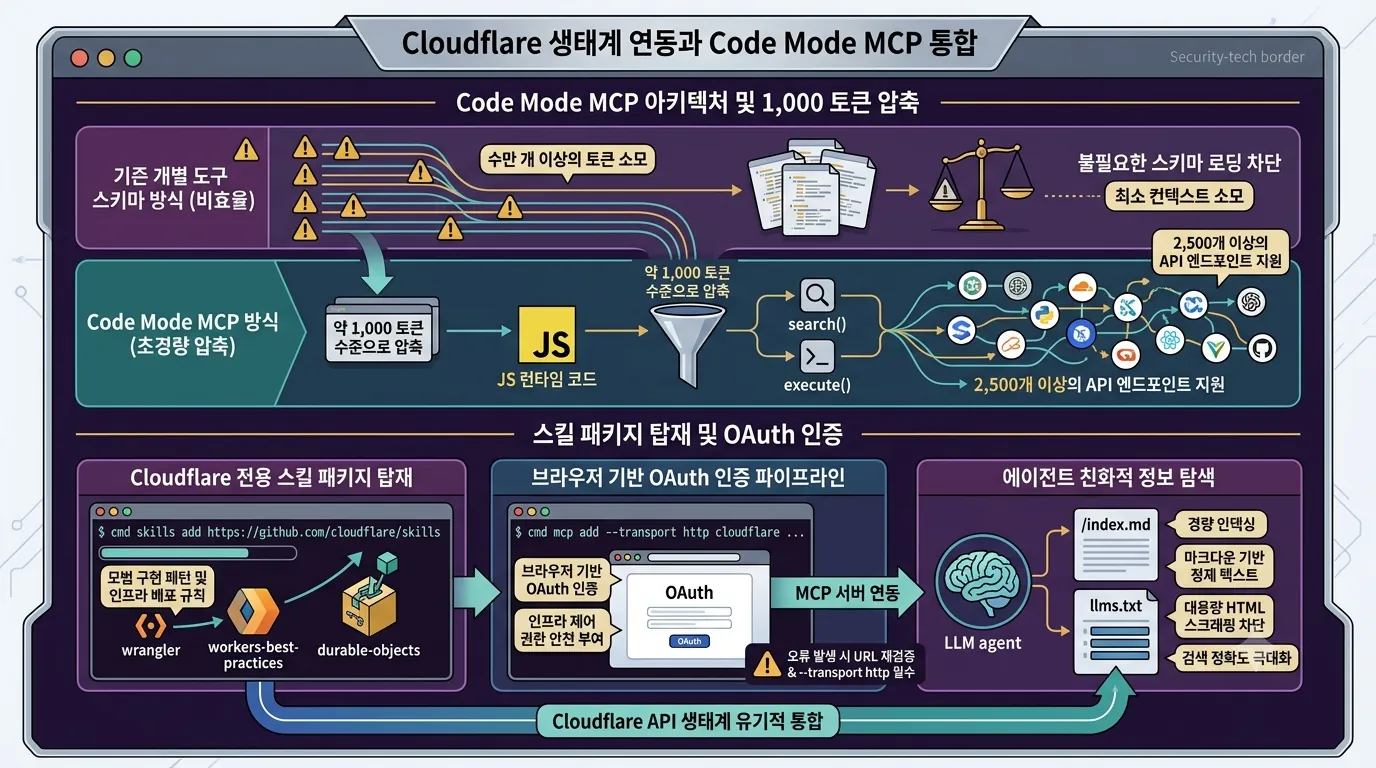
일반적으로 수천 개의 엔드포인트를 모델에 전달하려면 각 기능의 스키마 정의만으로 수만 개 이상의 토큰이 소모되는 한계가 존재합니다.
Cloudflare가 제공하는 Code Mode API MCP는 이러한 비효율을 혁신적으로 해결하는 초경량 도구 통합 구조를 채택하고 있습니다.
이 아키텍처는 개별 엔드포인트마다 정적 도구 스키마를 나열하는 대신, 오직 search() 및 execute() 두 가지 기본 함수만을 노출하여 JavaScript 코드로 직접 API를 실행하도록 설계되었습니다.
이 방식을 통해 에이전트는 2,500개 이상의 API 엔드포인트를 단 약 1,000 토큰 오버헤드 수준으로 압축하여 처리할 수 있습니다.
에이전트가 필요한 도구를 탐색할 때는 search() 함수로 API 명세를 동적으로 조회하고, 조합된 작업은 execute() 함수 내부에서 단일 JS 런타임 코드로 묶어 즉각 실행합니다.
따라서 모델은 불필요한 스키마 로딩 없이 최소한의 컨텍스트만 소모하면서도 Cloudflare 생태계의 방대한 제어 기능을 터미널 환경에서 유기적으로 호출할 수 있습니다.
| 구분 | 기존 개별 도구 스키마 등록 방식 | Cloudflare Code Mode MCP 방식 |
|---|---|---|
| 지원 엔드포인트 규모 | 개별 등록된 소수 도구로 제한 | 2,500개 이상의 API 엔드포인트 지원 |
| 컨텍스트 토큰 오버헤드 | 수만 개 이상의 토큰 소모 | 약 1,000 토큰 수준으로 압축 |
| 호출 인터페이스 | 정적 Tool Call 파라미터 매핑 | search() 및 execute() 기반 JS 코드 실행 |
| 문서 및 인덱싱 지원 | 별도 파싱 및 대용량 HTML 스크래핑 | /index.md 및 llms.txt 기반 경량 인덱싱 |
Cloudflare 전용 스킬 패키지 탑재 및 OAuth 연동
Command Code 환경에서는 전용 스킬 패키지를 로컬에 주입하여 에이전트의 개발 역량을 즉각적으로 확장할 수 있습니다.
사용자는 cmd skills add https://github.com/cloudflare/skills 명령어를 실행하여 wrangler, workers-best-practices, durable-objects와 같은 전문 스킬을 에이전트에 직접 탑재합니다.
이를 통해 에이전트는 Workers 및 Durable Objects 환경에 최적화된 모범 구현 패턴과 인프라 배포 규칙을 컨텍스트 내에서 정확히 파악하고 작업에 착수합니다.
클라우드 리소스와의 실시간 상호작용을 위해서는 MCP 서버 연동 및 인증 파이프라인 구성이 필수적입니다.
cmd mcp add --transport http cloudflare https://mcp.cloudflare.com/mcp 명령어를 입력하면 브라우저 기반 OAuth 인증이 진행되어 인프라 제어 권한이 터미널 에이전트에 안전하게 부여됩니다.
MCP 서버 연결 과정에서 오류가 발생할 경우 지정한 엔드포인트 URL 경로를 재검증해야 하며, 네트워크 프로토콜 규격을 일치시키기 위해 --transport http 옵션을 반드시 명시해야 합니다.
나아가 에이전트 친화적인 정보 탐색 환경을 구축하기 위해 각 제품 문서 URL 체계에는 /index.md 또는 llms.txt가 제공됩니다.
이는 복잡한 웹 마크업 구조 대신 마크다운 기반의 정제된 텍스트와 요약 인덱스를 에이전트에 직접 노출하여 불필요한 토큰 낭비를 차단하고 검색 정확도를 극대화하는 인덱싱 기법입니다.
결과적으로 개발자는 최소한의 토큰 비용만으로 Cloudflare API 생태계 전반을 터미널 에이전트 내에 빈틈없이 통합할 수 있습니다.
8. Command Code 운영 지표 및 요금제 구조 분석
130T+ 서빙 지표 및 500만 달러 시드 유치 기반의 엔터프라이즈 신뢰성
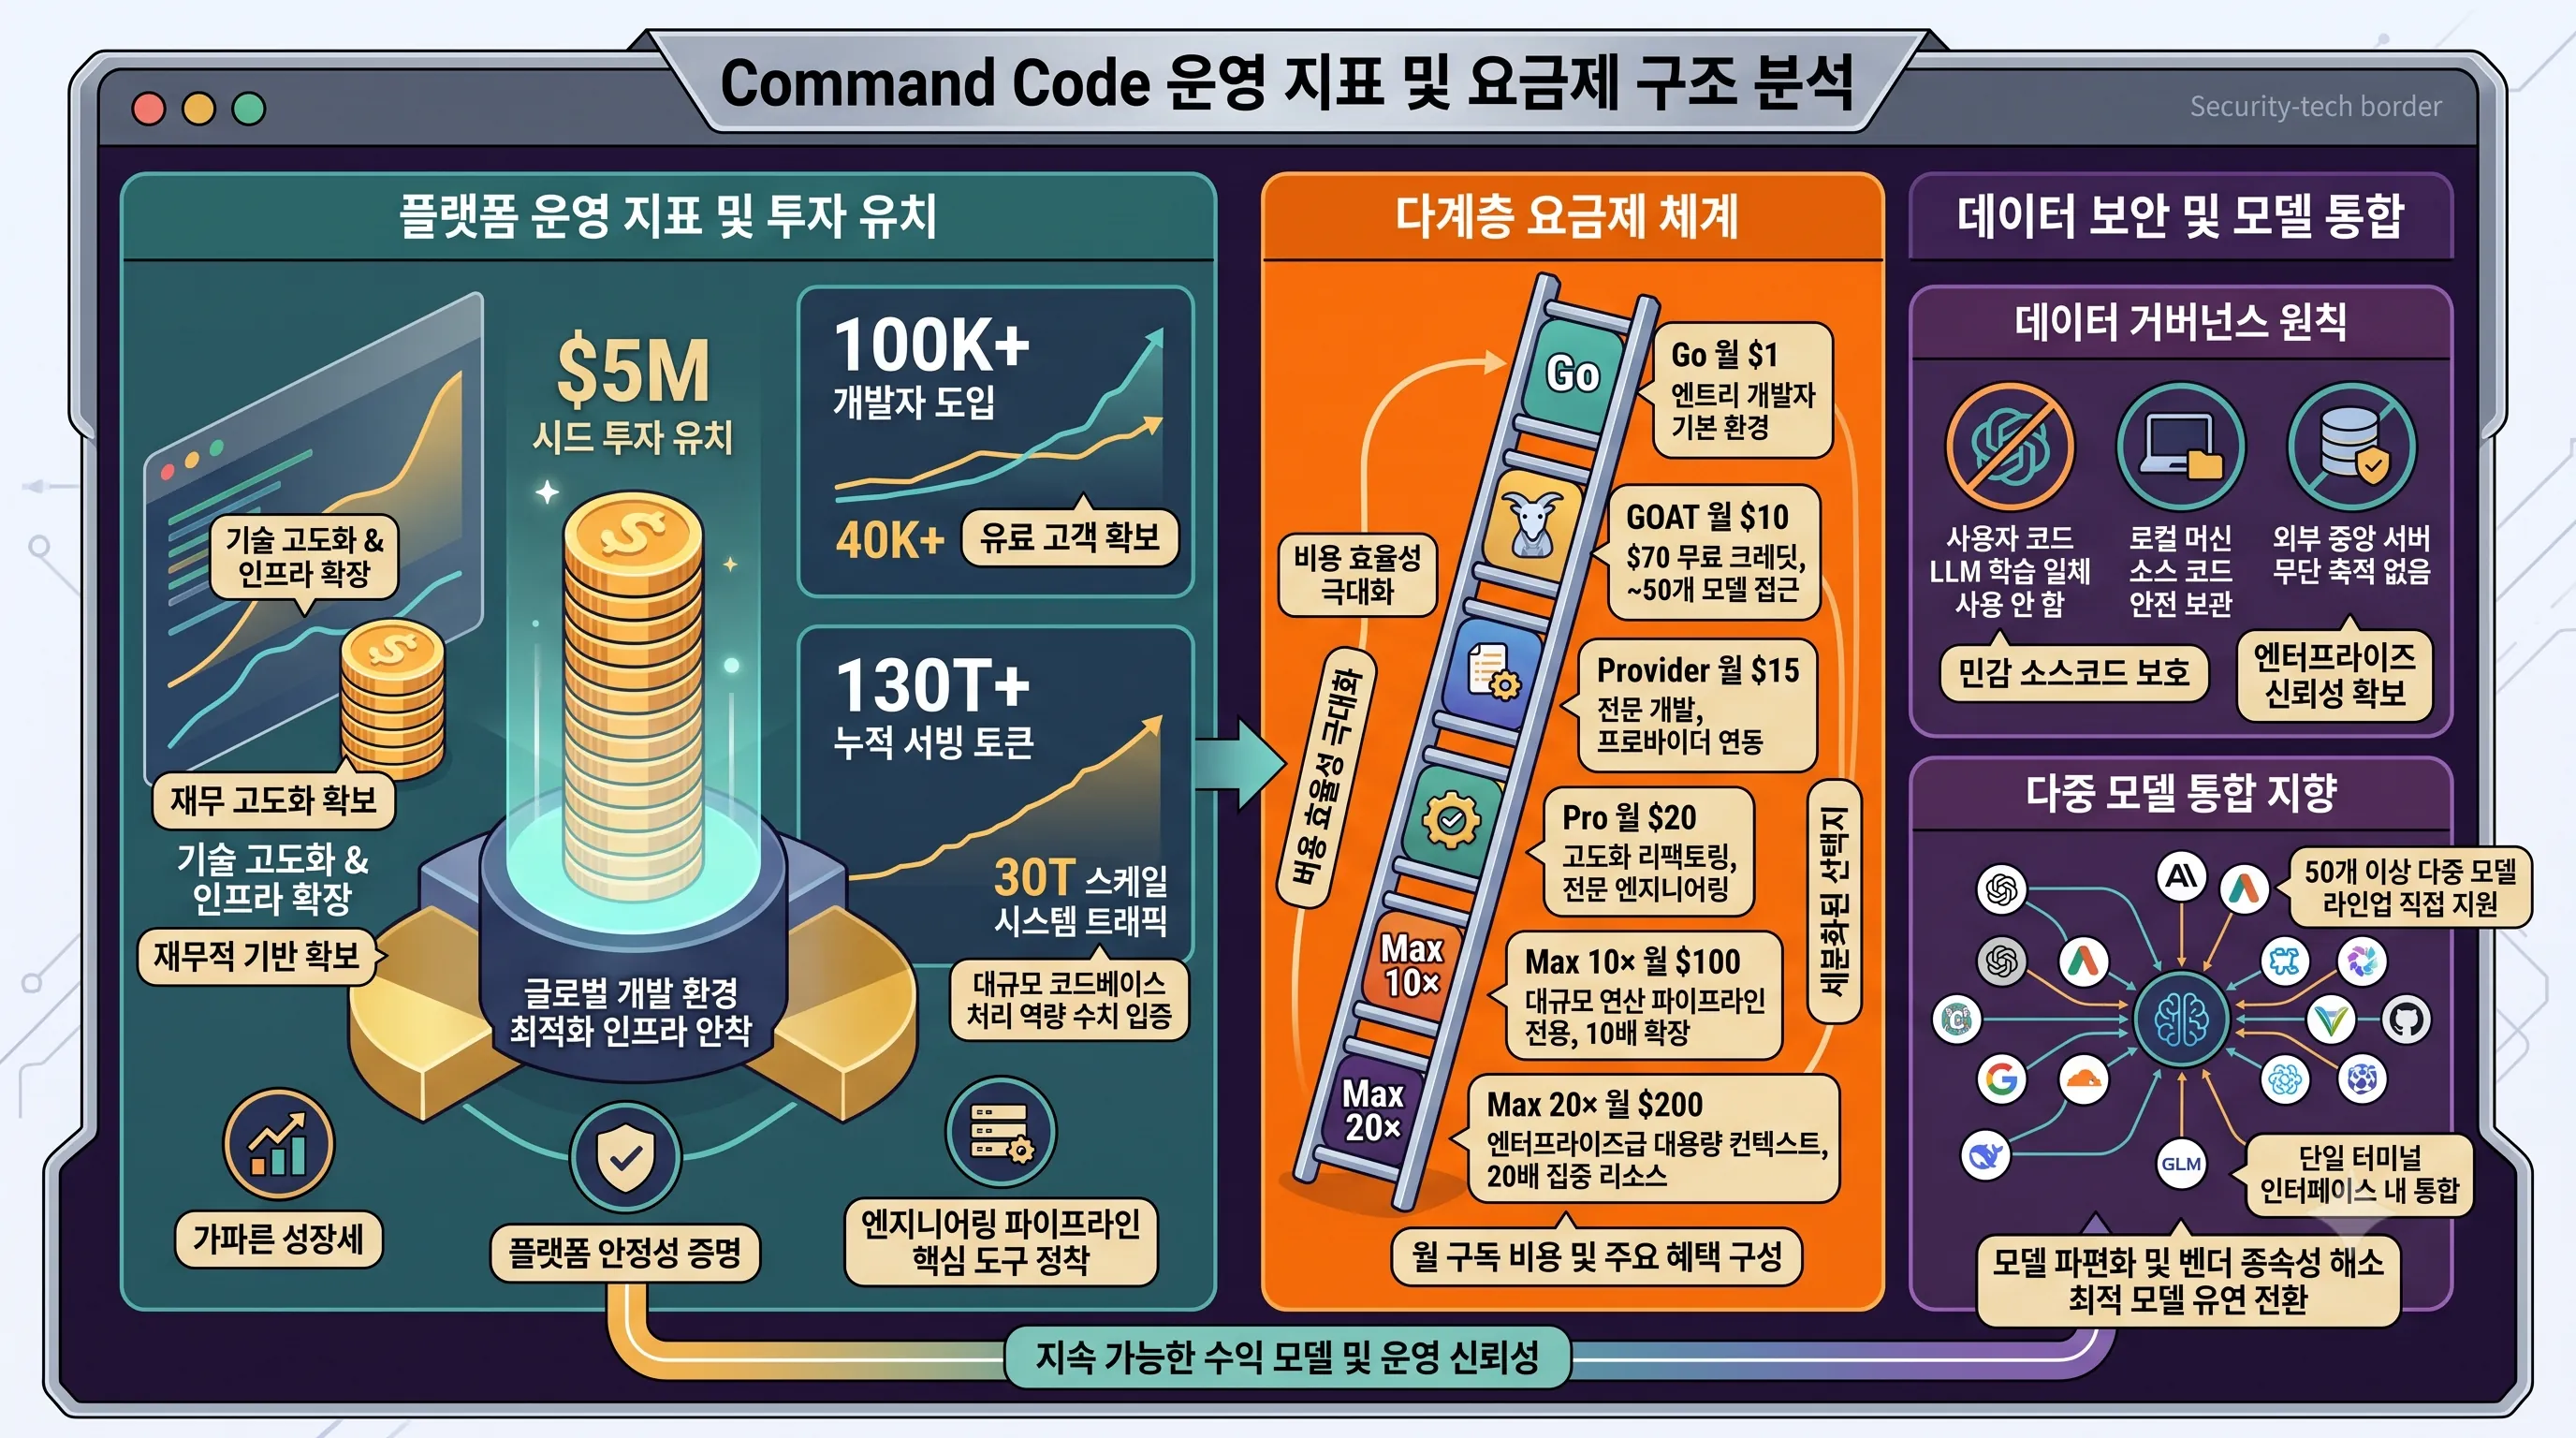
터미널 기반 코딩 에이전트 시장에서 독자적인 생태계를 구축하고 있는 Command Code는 대규모 실사용 트래픽과 가파른 성장세를 통해 플랫폼의 안정성을 입증하고 있습니다.
공식 지표에 따르면 Command Code는 500만 달러($5M) 규모의 시드 투자를 성공적으로 유치하며 기술 고도화 및 인프라 확장을 위한 견고한 재무적 기반을 확보했습니다.
이러한 자본력을 바탕으로 글로벌 개발 환경에 최적화된 터미널 에이전트 인프라를 빠르게 안착시켰습니다.
현재 플랫폼 전반에 걸쳐 100K+ 개발자가 Command Code를 도입하여 작업 흐름에 활용하고 있으며, 이 가운데 40K+ 유료 고객을 확보하여 높은 유료 전환율과 지속 가능한 수익 모델을 증명했습니다.
단순한 도구 도입을 넘어 엔지니어링 파이프라인의 핵심 도구로 정착하면서, 시스템 트래픽은 30T 스케일에 도달함과 동시에 130T+ 누적 서빙 토큰을 기록하며 대규모 코드베이스 처리 역량을 수치로 보여주고 있습니다.
Go($1)부터 Max 플랜까지의 요금제 체계와 데이터 보안 정책
Command Code는 개인 개발자부터 대규모 연산이 필요한 전문 엔지니어링 팀까지 폭넓게 수용할 수 있는 다계층 요금 체계를 제공합니다.
가장 진입 장벽이 낮은 Go 플랜(월 $1)을 시작으로, 비용 효율성을 극대화한 GOAT 플랜(월 $10)의 경우 $70 상당의 무료 크레딧을 기본 제공하여 약 50여 개 모델을 자유롭게 활용할 수 있도록 설계되었습니다.
이 외에도 확장된 리소스를 필요로 하는 엔지니어를 위해 Provider 플랜(월 $15), Pro 플랜(월 $20)이 마련되어 있으며, 대규모 고밀도 작업을 위한 Max 10× 플랜(월 $100) 및 Max 20× 플랜(월 $200)까지 세분화된 선택지를 지원합니다.
| 요금제 명칭 | 월 구독 비용 | 주요 혜택 및 리소스 구성 |
|---|---|---|
| Go | 월 $1 | 엔트리 개발자를 위한 기본 터미널 에이전트 환경 |
| GOAT | 월 $10 | $70 무료 크레딧 제공 및 약 50여 개 모델 접근 |
| Provider | 월 $15 | 연동 프로바이더 기반 전문 개발 작업 지원 |
| Pro | 월 $20 | 고도화된 리팩토링 및 전문 엔지니어링 리소스 |
| Max 10× | 월 $100 | 대규모 연산 파이프라인 전용 10배 확장 환경 |
| Max 20× | 월 $200 | 엔터프라이즈급 대용량 컨텍스트 20배 집중 리소스 |
모델 파편화 문제와 벤더 종속성을 해소하기 위해 Command Code는 글로벌 주요 AI 파운데이션 모델을 단일 터미널 인터페이스 내에 통합했습니다.
구체적으로 OpenAI, Anthropic, Google을 비롯하여 DeepSeek, Qwen, Kimi, GLM, MiniMax, Tencent 등 50개 이상의 다중 모델 라인업을 직접 지원합니다.
엔지니어는 단일 환경에서 프로젝트 특성에 맞춰 최적의 모델을 유연하게 전환하며 리팩토링 및 코드 생성을 수행할 수 있습니다.
기업 및 개인의 핵심 지적 자산을 보호하기 위한 엄격한 데이터 거버넌스 원칙 역시 플랫폼의 핵심 경쟁력입니다.
Command Code는 사용자 코드를 LLM 학습에 일체 사용하지 않으며, 모든 소스 코드는 외부 중앙 서버에 무단 축적되지 않고 사용자의 로컬 머신에 안전하게 보관됩니다.
이러한 무학습 정책과 로컬 중심 저장 아키텍처는 민감한 소스코드를 다루는 엔터프라이즈 환경에서도 신뢰성 높은 에이전트 도입을 가능하게 만드는 핵심 기반입니다.
관련 글