#GPU
6개의 글
칩 제조사에서 플랫폼 독점 기업으로: NVIDIA의 Hugging Face 인수와 MLOps의 미래
엔비디아의 허깅페이스 인수 배경과 오픈웨이트 AI 생태계, 그리고 글로벌 반독점 규제 동향을 분석합니다. AI 하드웨어와 소프트웨어 플랫폼의 변화에 관심 있는 개발자와 연구자를 위한 정보입니다.
Qwen3.8-27B: 27B 멀티모달 VLM, 로컬 배포와 성능 한계 분석
2026년 8월 출시된 Qwen3.8-27B, 27.78B 파라미터의 최신 멀티모달 VLM을 심층 분석합니다. 하이브리드 아키텍처, 100만 토큰 컨텍스트, 에이전트/코딩 성능을 로컬 배포 관점에서 파헤치고, 명확한 한계점과 Qwen 생태계 확장 전략까지 제시합니다.
클로드 AI, 스페이스X 파트너십으로 22만 GPU 확보! 코드 2배, 피크타임 해제
클로드(Claude) AI, 스페이스X 파트너십으로 대대적 성능 강화 및 서비스 개선 앤트로픽이 스페이스X '콜로서스 1' 데이터센터와 파트너십을 맺어 클로드 AI 모델의 성능과 안정성을 비약적으로 향상시켰습니다. 스페이스X로부터 300MW 이상의 컴퓨팅 파워와 22만 개 이상의...
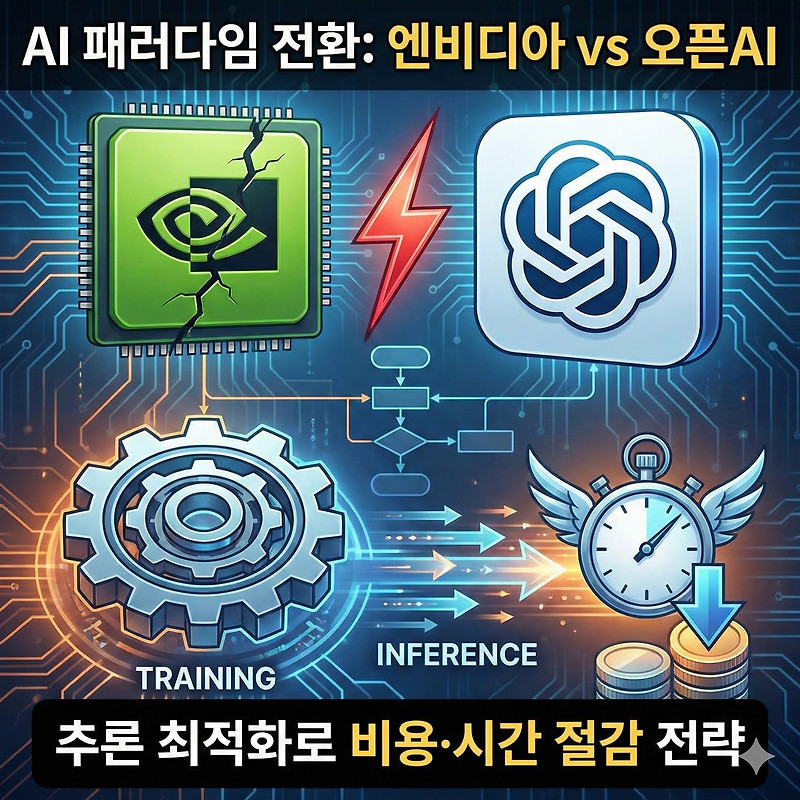
엔비디아와 오픈AI의 균열: AI 시대의 판도를 바꾸는 숨겨진 진실
(Executive Summary) AI 산업은 '모델 훈련' 중심에서 ' 실시간 추론 ' 중심으로 빠르게 전환되고 있으며, 이는 엔비디아와 오픈AI 같은 거대 기업 간의 이해관계 충돌을 야기하고 있습니다. 이러한 패러다임 변화는 AI 서비스 운영에 막대한 비용을 지불하는 기업들에게...
2026년 AI 노트북 분석: NPU 성능부터 코파일럿+ 활용법까지, 현명한 선택을 위한 전문가 가이드
? NPU의 등장: AI 연산에 최적화된 신경망 처리 장치(NPU)는 기존 CPU/GPU 대비 저전력으로 고효율 AI 추론을 가능하게 하여, AI 노트북의 핵심 동력으로 작용합니다. ? 온디바이스 AI의 부상: 인터넷 연결 없이 기기 내부에서 AI 연산을 수행하여, 개인 정보 보호와...
Llama 5, TCO, and Data Sovereignty: Why Enterprises Are Leaving Proprietary LLMs
오픈소스 LLM이 단순히 학술적 도구에 머물던 시대는 끝났습니다. 이 보고서는 2026년 초를 기준으로 Llama 5 및 이후의 오픈소스 모델들이 달성한 성능 지표를 분석합니다. 우리는 이제 단순한 성능 지표 논쟁에서 벗어나, 기업 도입의 핵심 동력인 총소유비용(TCO) 절감 과...