Qwen3.8-27B: 27B 멀티모달 VLM, 로컬 배포와 성능 한계 분석
- Qwen3.8-27B는 2026년 8월 14일 출시된 27.78B 파라미터의 포스트-트레인드 Dense Causal VLM 모델입니다.
- 텍스트, 이미지, 비디오 멀티모달 입력 및 텍스트 출력을 지원하며, 고사양 워크스테이션 로컬 배포에 최적화되었습니다.
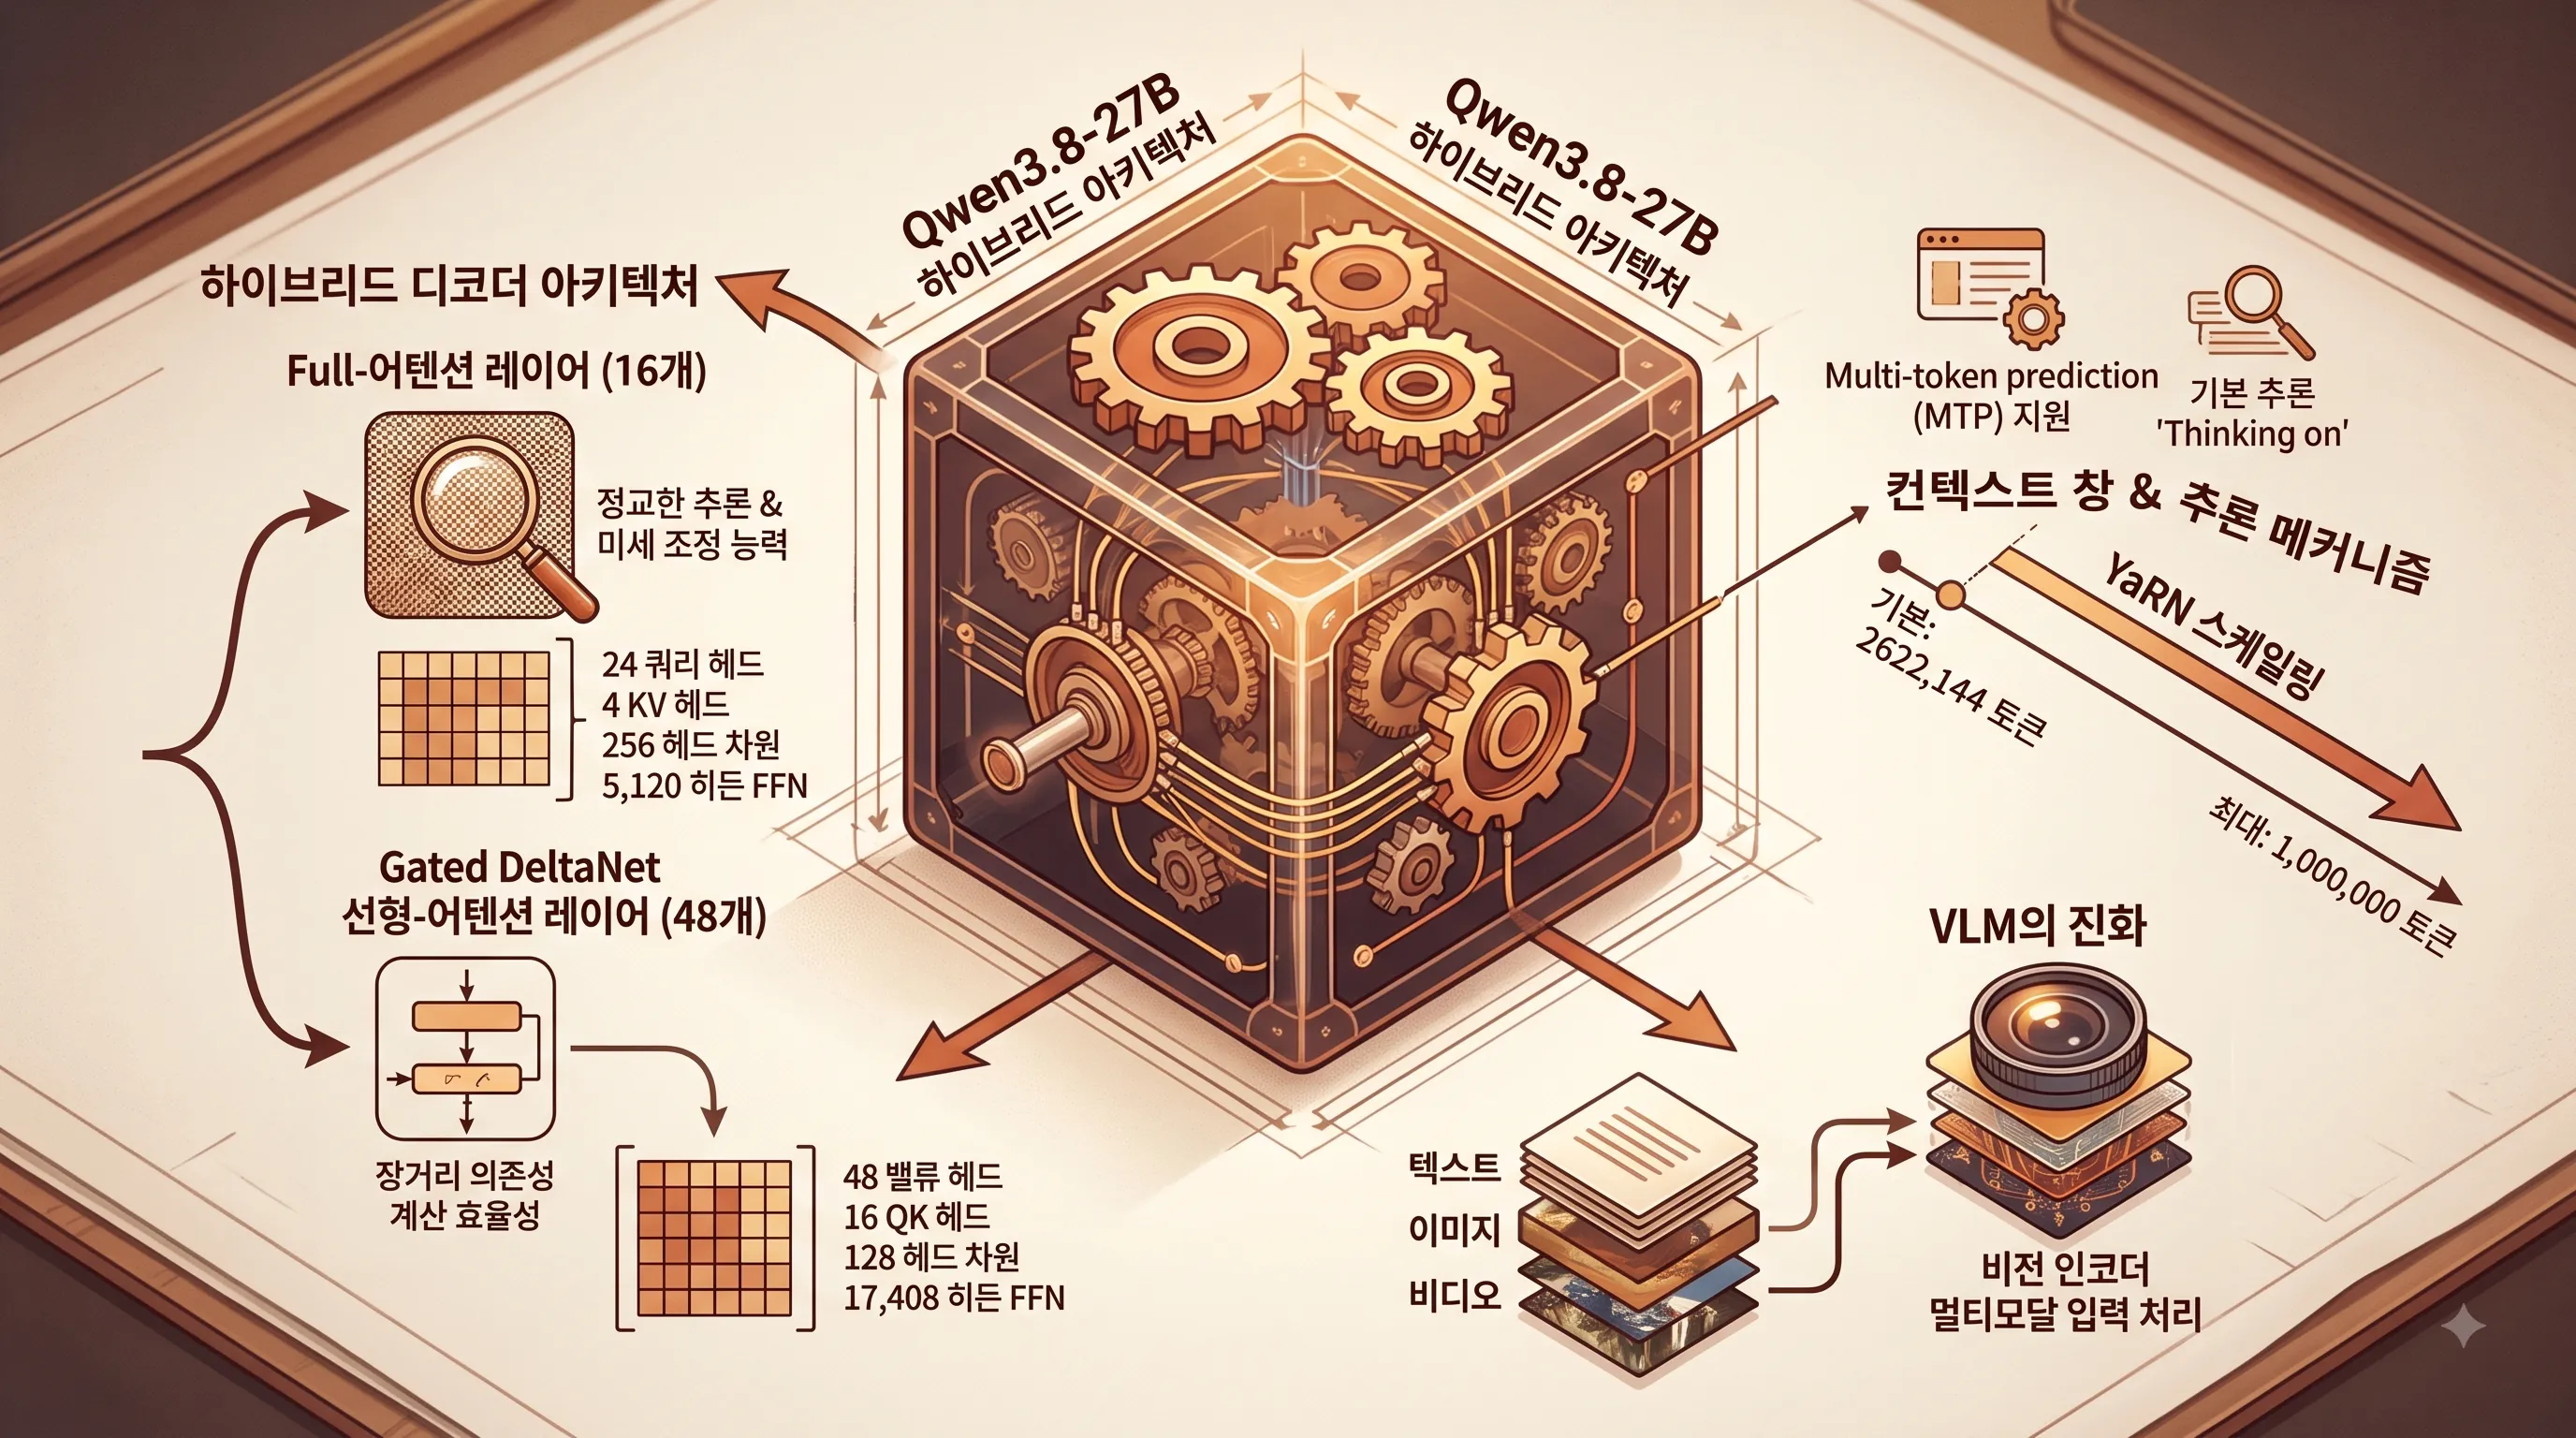
- 혁신적인 하이브리드 디코더 아키텍처를 채택, 48개 Gated DeltaNet 선형-어텐션 레이어와 16개 Full-어텐션 레이어를 결합하여 효율성과 성능을 극대화했습니다.
- 압도적인 컨텍스트 창: 기본 262,144 토큰을 지원하며, YaRN 스케일링을 통해 최대 1,000,000 토큰까지 확장이 가능합니다.
- 강력한 에이전트 및 코딩 능력: SWE-bench Pro 61.7점, LiveCodeBench_v6 90.3점을 기록하며 복잡한 코딩 작업에 강점을 보였습니다.
- 코드 인터프리터 시너지 효과: MathVision에서 코드 인터프리터 미사용 시 90.0점에서 사용 시 94.6점으로 성능이 크게 향상되었습니다.
- 하드웨어 요구사항: 최소 24GB GPU (4비트 양자화), BF16/FP8 또는 전체 컨텍스트 활용 시 48GB 이상 VRAM이 필요합니다.
- Qwen 생태계 확장: Qwen Studio, Qwen Code 등 공식 플랫폼을 지원하며, 2.4조 파라미터 MoE Qwen3.8 Max 모델 API 서비스를 제공하고 있습니다.
- 주요 한계: 모든 벤치마크는 Qwen 자체 보고이며 독립적인 재현 사례가 부재합니다. 최강 프론티어 API 모델을 일대일로 대체하기는 어렵다는 점을 인지해야 합니다.
1. Qwen3.8-27B 핵심 기술 명세: 하이브리드 아키텍처와 VLM의 진화
2026년 8월 14일 공식 출시된 Qwen3.8-27B는 인공지능 분야의 선두 주자인 알리바바가 선보인 최신 대규모 멀티모달 모델(VLM)입니다.
이 모델은 마케팅명 27B로 불리지만, 정확히는 27.78B개의 파라미터를 갖춘 포스트-트레인드 Dense Causal VLM으로 정의됩니다.
특히, 텍스트뿐만 아니라 이미지와 비디오를 포함하는 광범위한 멀티모달 입력을 처리하고 텍스트로 결과를 출력하는 능력을 통해 다양한 복합 태스크에 대응할 수 있도록 설계되었습니다.
이러한 강력한 멀티모달리티는 고사양 워크스테이션 환경에서 로컬 배포 가능한 모델 중 현존하는 가장 유력한 후보로 평가받게 합니다.
혁신적인 하이브리드 디코더 아키텍처
Qwen3.8-27B의 가장 두드러진 기술적 특징 중 하나는 바로 하이브리드 디코더 아키텍처입니다.
이 모델은 기존의 풀 어텐션(Full-attention) 메커니즘과 새로운 Gated DeltaNet 선형-어텐션 레이어를 지능적으로 결합하여 효율성과 성능을 극대화했습니다.
구체적으로, 전체 64개의 디코더 레이어 중 48개는 Gated DeltaNet 선형-어텐션 레이어로 구성되어 장거리 의존성 처리에 있어 계산 효율성을 크게 향상시킵니다.
반면, 핵심적인 추론 및 미세 조정 능력을 위해 16개의 레이어는 전통적인 Full-어텐션 메커니즘을 유지하여 모델의 표현력을 보강했습니다.
각 어텐션 유형별 구성도 정교하게 설계되었습니다.
Full-어텐션 레이어는 24개의 쿼리 헤드와 4개의 KV 헤드를 가지며, 각 헤드 차원은 256입니다.
이는 복잡하고 미묘한 관계를 포착하는 데 중점을 둡니다.
이에 반해, 선형-어텐션 레이어는 48개의 밸류 헤드와 16개의 QK 헤드, 그리고 128의 헤드 차원을 갖추고 있어 대규모 시퀀스에서 효율적인 정보 처리를 가능하게 합니다.
이러한 하이브리드 접근 방식은 모델이 다양한 유형의 정보에 대한 주의 메커니즘을 유연하게 조절하며, 계산 자원을 최적화하도록 돕는 핵심입니다.
또한, 히든 FFN(Feed-Forward Network) 크기는 각각 5,120과 17,408로 구성되어 모델의 깊이와 복잡성을 더합니다.
Qwen3.8-27B 하이브리드 디코더 아키텍처 구성
| 레이어 유형 | 레이어 수 | 쿼리 헤드 | KV 헤드 | 밸류 헤드 | QK 헤드 | 헤드 차원 | 히든 FFN 크기 |
|---|---|---|---|---|---|---|---|
| Full-어텐션 레이어 | 16 | 24 | 4 | - | - | 256 | 5,120 |
| Gated DeltaNet 선형-어텐션 레이어 | 48 | - | - | 48 | 16 | 128 | 17,408 |
멀티모달 입력 처리와 정교한 비전 인코더
Qwen3.8-27B는 이름에서 알 수 있듯이, 텍스트뿐만 아니라 이미지와 비디오를 네이티브하게 입력 모달리티로 받아들여 처리하는 진정한 멀티모달 모델(VLM)입니다.
이는 단순히 텍스트에 이미지를 보조적으로 활용하는 것을 넘어, 비정형적인 시각 데이터를 모델의 초기 입력 단계에서부터 통합하여 이해한다는 것을 의미합니다.
이러한 멀티모달 능력의 핵심에는 정교하게 설계된 비전 인코더가 있습니다.
Qwen3.8-27B의 비전 인코더는 27개의 레이어, 1,152의 너비, 그리고 16개의 헤드로 구성되어 있습니다.
특히 패치 크기 16, 시간 패치 2, 공간 병합 2와 같은 파라미터는 비디오 데이터와 같은 시공간 정보를 효율적으로 인코딩하도록 최적화되어 있습니다.
이러한 구성은 이미지의 미세한 디테일과 비디오의 연속적인 움직임을 정확하게 포착하여 모델의 전반적인 세계 이해도를 높이는 데 기여합니다.
Qwen3.8-27B 비전 인코더 상세 스펙
| 항목 | 값 |
|---|---|
| 레이어 수 | 27 |
| 너비 | 1,152 |
| 헤드 수 | 16 |
| 패치 크기 | 16 |
| 시간 패치 | 2 |
| 공간 병합 | 2 |
압도적인 컨텍스트 창과 효율적인 추론 메커니즘
장문의 문서 처리와 복잡한 상호작용에 있어 핵심적인 요소인 컨텍스트 창은 Qwen3.8-27B의 또 다른 강점입니다.
이 모델은 기본적으로 262,144 토큰이라는 매우 넓은 네이티브 컨텍스트 창을 지원합니다.
이는 대부분의 현재 대규모 언어 모델들이 제공하는 컨텍스트 창을 훨씬 뛰어넘는 수준으로, 방대한 양의 정보를 한 번에 이해하고 처리할 수 있음을 의미합니다.
더 나아가, YaRN 스케일링 기술을 적용하여 최대 1,000,000 토큰까지 컨텍스트를 확장할 수 있습니다.
이러한 압도적인 컨텍스트 길이는 장문의 코드, 법률 문서, 복잡한 연구 논문 등 고도의 정보 집약적인 작업에서 모델의 활용도를 극대화합니다.
추론 효율성을 위한 기능도 강화되었습니다.
Multi-token prediction (MTP)을 지원하며, 이를 위해 하나의 MTP 히든 레이어가 포함되어 있습니다.
MTP는 여러 토큰을 동시에 예측하여 추론 속도를 향상시키고 토큰 생성의 효율성을 높이는 기술입니다.
또한, 모델의 기본 추론 기능은 'Thinking on'으로 활성화되어 있으며, 'xhigh' 수준의 노력과 'preserve_thinking'의 연속성을 기본값으로 갖추고 있어 보다 일관되고 심층적인 추론 과정을 기대할 수 있습니다.
이러한 요소들은 사용자가 모델과 상호작용할 때 더욱 자연스럽고 심도 있는 응답을 얻을 수 있도록 설계된 것입니다.
모델의 어휘 크기는 248,320개(패딩 포함)로, 다양한 언어 및 특수 토큰을 효과적으로 처리할 수 있는 기반을 제공합니다.
기술적 세부 사항 및 생태계 호환성
Qwen3.8-27B는 개발자 및 사용자 편의성을 고려한 다양한 기술적 지원을 제공합니다.
공식 가중치 형식은 고성능 추론 및 훈련에 적합한 BF16과 효율적인 메모리 사용을 위한 Blockwise FP8을 모두 지원합니다.
이는 다양한 하드웨어 환경에서 모델을 효율적으로 구동할 수 있게 하는 중요한 요소입니다.
또한, 널리 사용되는 여러 서비스 프레임워크와의 공식적인 호환성을 갖추고 있습니다.
Transformers, vLLM, SGLang, TokenSpeed 등 다양한 프레임워크를 통해 모델을 손쉽게 배포하고 활용할 수 있습니다.
이러한 광범위한 호환성은 개발자들이 기존 워크플로우에 Qwen3.8-27B를 통합하는 데 큰 이점을 제공합니다.
모델의 라이선스는 널리 사용되고 개방적인 Apache License 2.0을 채택하여, 상업적 사용을 포함한 다양한 환경에서의 자유로운 활용을 보장합니다.
2. 벤치마크 성능 완전 분석: 경쟁 모델 및 이전 버전과의 격차
2026년 8월 17일 현재, Qwen3.8-27B은 27B 파라미터급 로컬 배포 가능 멀티모달 모델 중 단연 돋보이는 후보로 평가받고 있습니다.
이 모델의 성능은 다양한 벤치마크 점수를 통해 다각도로 분석할 수 있으나, 모든 데이터가 Qwen 자체 보고라는 점과 특정 벤치마크 조건이 명시되어 있다는 점을 전제로 심층적인 평가가 이루어져야 합니다.
특히, 벤치마크 재현을 위한 독립적인 검증 사례가 아직 부재하다는 점은 그 신뢰도를 판단하는 데 있어 중요한 고려 사항입니다.
에이전트 및 코딩 능력 벤치마크 상세 분석
Qwen3.8-27B은 코딩 및 에이전트 작업 처리 능력에서 높은 점수를 기록했습니다.
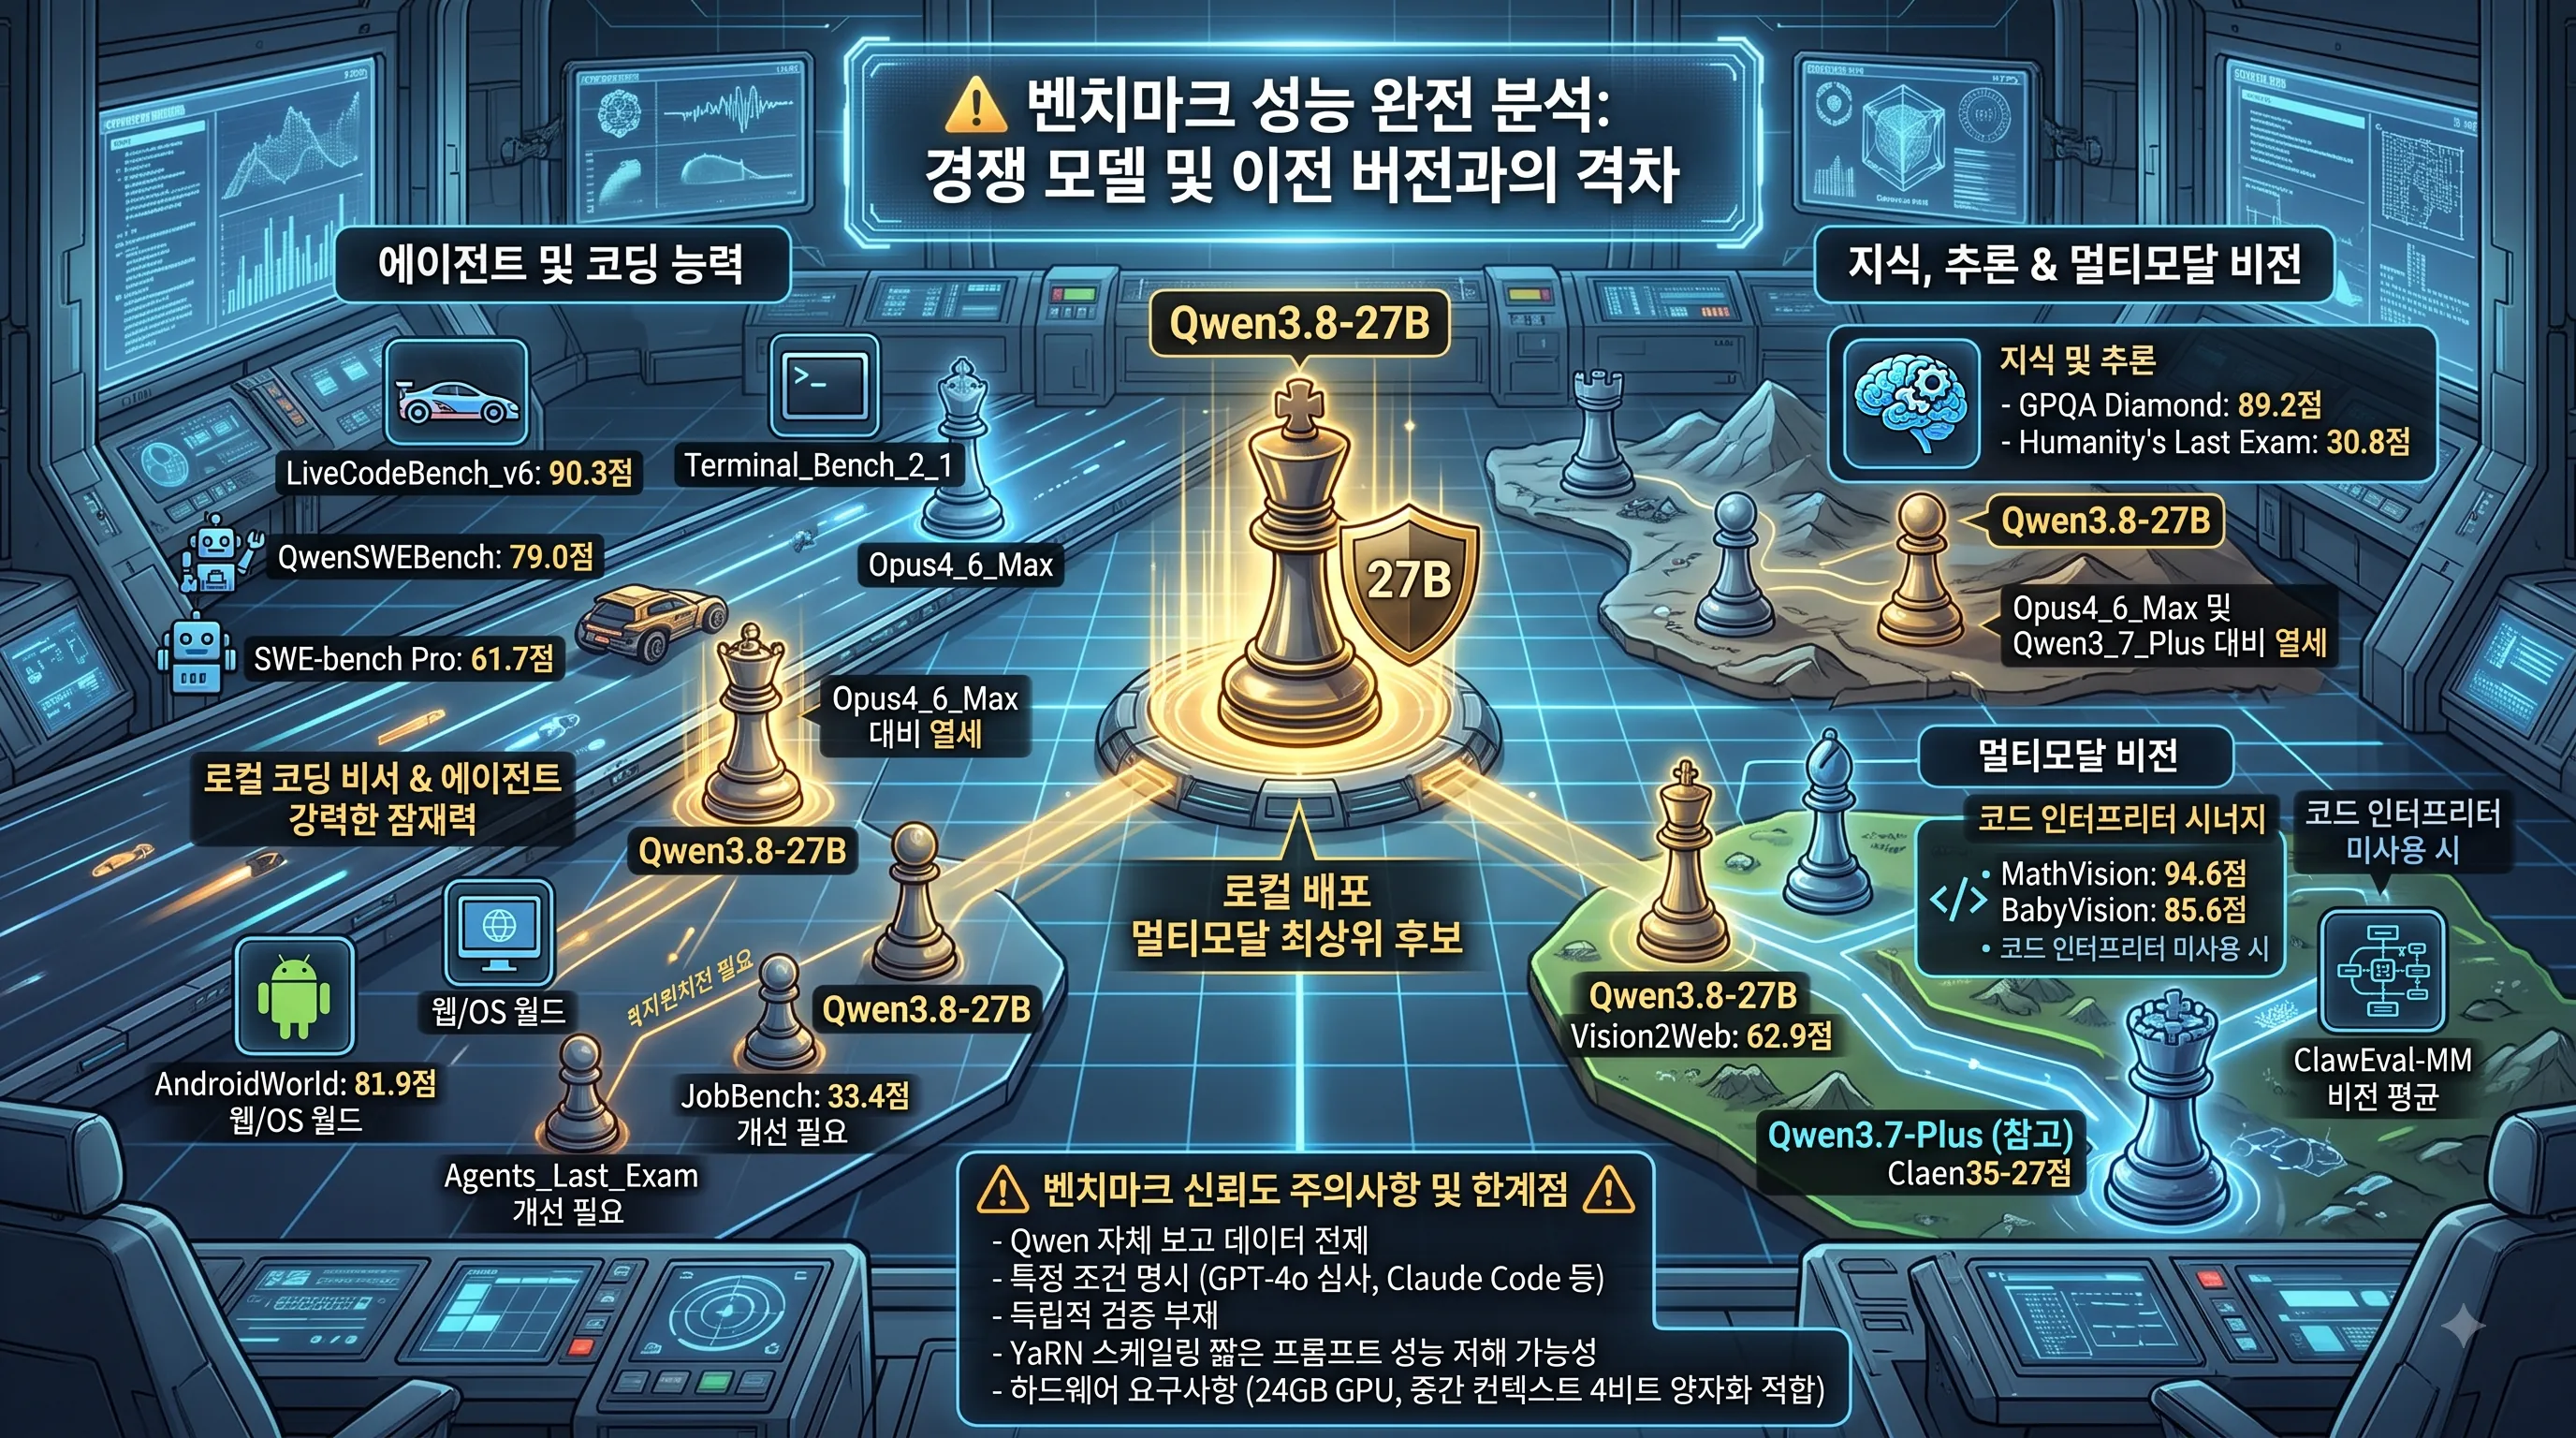
특히, SWE-bench Pro에서 61.7점, QwenSWEBench에서 79.0점, LiveCodeBench_v6에서 90.3점을 달성하며 복잡한 코딩 작업을 해결하는 데 있어 강력한 성능을 과시했습니다.
이는 로컬 코딩 비서나 바운드 에이전트로서의 활용 가능성을 크게 시사하는 대목입니다.
그러나 Terminal_Bench_2_1에서는 73.0점을 기록했음에도 불구하고, 최강 경쟁 모델인 Opus4_6_Max 대비 열세한 점수를 보였습니다.
또한, NL2Repo_Bench에서 42.3점, DeepSWE_1_1에서 42.2점, CoWorkBench에서 70.7점, OSWorld_Verified에서 84.3점, WebArena_Verified에서 64.8점을 기록하며 다양한 에이전트 시나리오에서 준수한 성능을 입증했습니다.
특히, AndroidWorld에서 81.9점을 얻은 것은 모바일 환경 에이전트로서의 잠재력을 보여줍니다.
하지만 JobBench의 33.4점이나 Agents_Last_Exam_Pass@1_score의 20.4점(Pass@1) / 42.9점(Pass@N)은 여전히 개선의 여지가 있음을 시사합니다.
Qwen3.8-27B 에이전트 및 코딩 능력 벤치마크 점수
| 벤치마크 | Qwen3.8-27B 점수 | 비고 |
|---|---|---|
| SWE-bench Pro | 61.7점 | |
| QwenSWEBench | 79.0점 | |
| LiveCodeBench_v6 | 90.3점 | |
| Terminal_Bench_2_1 | 73.0점 | Opus4_6_Max 대비 열세 |
| NL2Repo_Bench | 42.3점 | |
| DeepSWE_1_1 | 42.2점 | |
| CoWorkBench | 70.7점 | |
| OSWorld_Verified | 84.3점 | |
| WebArena_Verified | 64.8점 | |
| AndroidWorld | 81.9점 | 모바일 환경 에이전트 잠재력 |
| JobBench | 33.4점 | 개선 필요 |
| Agents_Last_Exam_Pass@1_score (Pass@1) | 20.4점 | 개선 필요 |
| Agents_Last_Exam_Pass@1_score (Pass@N) | 42.9점 | 개선 필요 |
지식 및 추론 능력 벤치마크 비교
일반 지식 및 복잡한 추론 능력 벤치마크에서 Qwen3.8-27B은 혼재된 양상을 보였습니다.
특히 GPQA Diamond에서 89.2점이라는 높은 점수를 얻었지만, 이는 Opus4_6_Max 및 이전 버전인 Qwen3_7_Plus 대비 열세한 수치입니다.
인류의 마지막 시험으로 불리는 Humanitys_Last_Exam에서도 30.8점을 기록하며, 역시 Opus4_6_Max와 Qwen3_7_Plus에 미치지 못하는 성능을 보여주었습니다.
이러한 결과는 Qwen3.8-27B이 특정 유형의 지식 추론에서 여전히 최상위 프론티어 모델에 비해 간극이 존재함을 의미합니다.
다만, IFBench에서 79.5점을 기록하며 전반적인 지시 이행 능력에서는 강점을 보였습니다.
Qwen3.8-27B 지식 및 추론 능력 벤치마크 점수 비교
| 벤치마크 | Qwen3.8-27B 점수 | 경쟁 모델 비교 |
|---|---|---|
| GPQA Diamond | 89.2점 | Opus4_6_Max 및 Qwen3_7_Plus 대비 열세 |
| Humanitys_Last_Exam | 30.8점 | Opus4_6_Max 및 Qwen3_7_Plus에 미치지 못함 |
| IFBench | 79.5점 |
멀티모달 비전 능력 및 코드 인터프리터 활용
Qwen3.8-27B의 핵심 강점 중 하나는 멀티모달 비전 능력입니다.
Vision2Web에서 62.9점을 기록하며 웹 기반 시각 정보 처리 능력에서 실용적인 수준의 성능을 입증했습니다.
또한 ClawEval_MM_Pass@3_average에서 57.4점(Pass@1) / 56.9점(Pass@3)을 기록했지만, 이 부문에서는 오히려 Qwen3.7-Plus가 더 높은 평균 점수를 보였습니다.
이는 특정 비전 처리 영역에서 이전 버전이 여전히 강점을 가질 수 있음을 보여줍니다.
흥미로운 점은 코드 인터프리터의 활용 여부에 따라 성능이 크게 향상된다는 것입니다.
MathVision에서 코드 인터프리터 미사용 시 90.0점에서 사용 시 94.6점으로, BabyVision에서는 65.7점에서 85.6점으로, CharXiv_RQ에서는 83.7점에서 90.2점으로 점수가 상승했습니다.
이는 Qwen3.8-27B이 단순한 비전 이해를 넘어 복잡한 시각-수학적 추론이나 데이터 분석에서 코드 인터프리터와의 시너지를 통해 고성능을 발휘할 수 있음을 입증합니다.
또한, OmniDocBench_1_5에서 91.1점을, RealWorldQA에서 85.9점, ERQA에서 65.5점을 기록하며 문서 및 실제 세계 QA(질의응답)에서도 뛰어난 능력을 보였습니다.
이러한 결과는 문서 및 이미지 분석, 그리고 사설 연구 워크플로우 등 다양한 멀티모달 자동화 시나리오에서 Qwen3.8-27B의 활용 가치를 높입니다.
Qwen3.8-27B 멀티모달 비전 능력 벤치마크 점수 및 코드 인터프리터 영향
| 벤치마크 | 코드 인터프리터 미사용 시 점수 | 코드 인터프리터 사용 시 점수 | Qwen3.7-Plus 점수 (참고) | 비고 |
|---|---|---|---|---|
| Vision2Web | 62.9점 | N/A | N/A | 웹 기반 시각 정보 처리 |
| ClawEval_MM_Pass@3_average (Pass@1) | 57.4점 | N/A | 높은 평균 점수 기록 | |
| ClawEval_MM_Pass@3_average (Pass@3) | 56.9점 | N/A | ||
| MathVision | 90.0점 | 94.6점 | N/A | 시각-수학적 추론 |
| BabyVision | 65.7점 | 85.6점 | N/A | |
| CharXiv_RQ | 83.7점 | 90.2점 | N/A | |
| OmniDocBench_1_5 | 91.1점 | N/A | N/A | 문서 분석 |
| RealWorldQA | 85.9점 | N/A | N/A | 실제 세계 질의응답 |
| ERQA | 65.5점 | N/A | N/A |
경쟁 모델 및 이전 버전과의 직접 비교 분석
Qwen3.8-27B은 이전 버전인 Qwen3.6-27B 대비 일관된 성능 향상을 보였다는 자체 평가가 있지만, 구체적인 벤치마크 수치 비교는 더욱 심층적인 분석이 필요합니다.
특히 Qwen3_7_Plus와의 비교에서는 GPQA Diamond와 Humanity's Last Exam에서 점수 열세를 보였고, 일반 비전 및 ClawEval-MM 평균 점수에서는 Qwen3.7-Plus가 오히려 더 높은 수치를 기록했습니다.
이는 Qwen3.8-27B이 모든 면에서 이전 버전을 압도하는 것은 아니며, 특정 영역에서는 이전 모델의 강점이 여전히 유효할 수 있음을 시사합니다.
반면, 최상위 프론티어 모델인 Opus4_6_Max와의 비교에서는 Terminal-Bench 2.1, NL2Repo-Bench, GPQA Diamond, Humanity's Last Exam 등 주요 지표에서 Qwen3.8-27B이 전반적으로 열세를 보였습니다.
이는 Qwen3.8-27B이 '최고의 멀티모달 모델'이라는 광범위한 표현보다는, 고사양 워크스테이션에서 양자화 가능한 강력한 멀티모달 인텔리전스를 요구하는 상황에서 새로운 경쟁 우위 모델로 포지셔닝하는 것이 더욱 적합함을 의미합니다.
벤치마크 신뢰도 관련 주의사항 및 한계점
Qwen3.8-27B의 벤치마크 성능을 해석할 때는 여러 가지 신뢰도 관련 주의사항을 반드시 고려해야 합니다.
첫째, 모든 벤치마크 데이터는 Qwen 자체 보고이며, 일부 벤치마크는 Qwen 팀이 자체 개발하거나 수정한 것입니다.
특히, Opus SWE-bench Pro 점수는 Qwen 환경에서 재실행되지 않고 가져온 것이므로 직접적인 환경 비교에는 한계가 있습니다.
둘째, 벤치마크에 사용된 특정 조건이 명시되어 있습니다.
예를 들어, GPT-4o 심사, Claude Code 사용, 비대칭 프롬프팅 등의 조건은 실제 사용자 환경이나 다른 모델과의 공정한 비교를 어렵게 만들 수 있습니다.
셋째, 독립적인 벤치마크 재현 사례가 출시일 기준으로 부재하다는 점은 결과의 객관성에 대한 검증이 필요함을 의미합니다.
마지막으로, 확장 컨텍스트와 관련하여 YaRN 스케일링이 100만 토큰을 지원하지만, 정적 YaRN이 짧은 프롬프트 성능을 저해할 가능성이 경고되었습니다.
또한, 24GB GPU는 중간 컨텍스트 4비트 양자화에 적합하며, BF16/FP8 또는 전체 262K 컨텍스트에는 부적합하다는 하드웨어 요구사항 또한 실제 환경에서의 성능 발휘에 영향을 미칠 수 있는 요소입니다.
3. 로컬 AI 구축 실전 가이드: 하드웨어 요구사항, 활용 분야 및 명확한 한계
최근 2026년 8월 14일 출시된 Qwen3.8-27B는 30B 파라미터급 멀티모달 모델 중 로컬 환경 배포를 고려하는 국내 개발자들에게 가장 유력한 선택지 중 하나로 떠오르고 있습니다.
이 모델은 텍스트, 이미지, 비디오 입력 및 텍스트 출력을 지원하는 포스트-트레인드 Dense Causal VLM으로, 고사양 워크스테이션에서 강력한 멀티모달 인텔리전스를 구축하고자 할 때 새로운 경쟁 우위를 제공합니다.
특히 이전 버전인 Qwen3.6-27B 대비 일관된 성능 향상을 보이며, 국내 개발자들이 직접 제어 가능한 환경에서 혁신적인 AI 애플리케이션을 개발할 수 있는 가능성을 열어주고 있습니다.
하드웨어 요구사항: 현실적인 로컬 배포를 위한 가이드
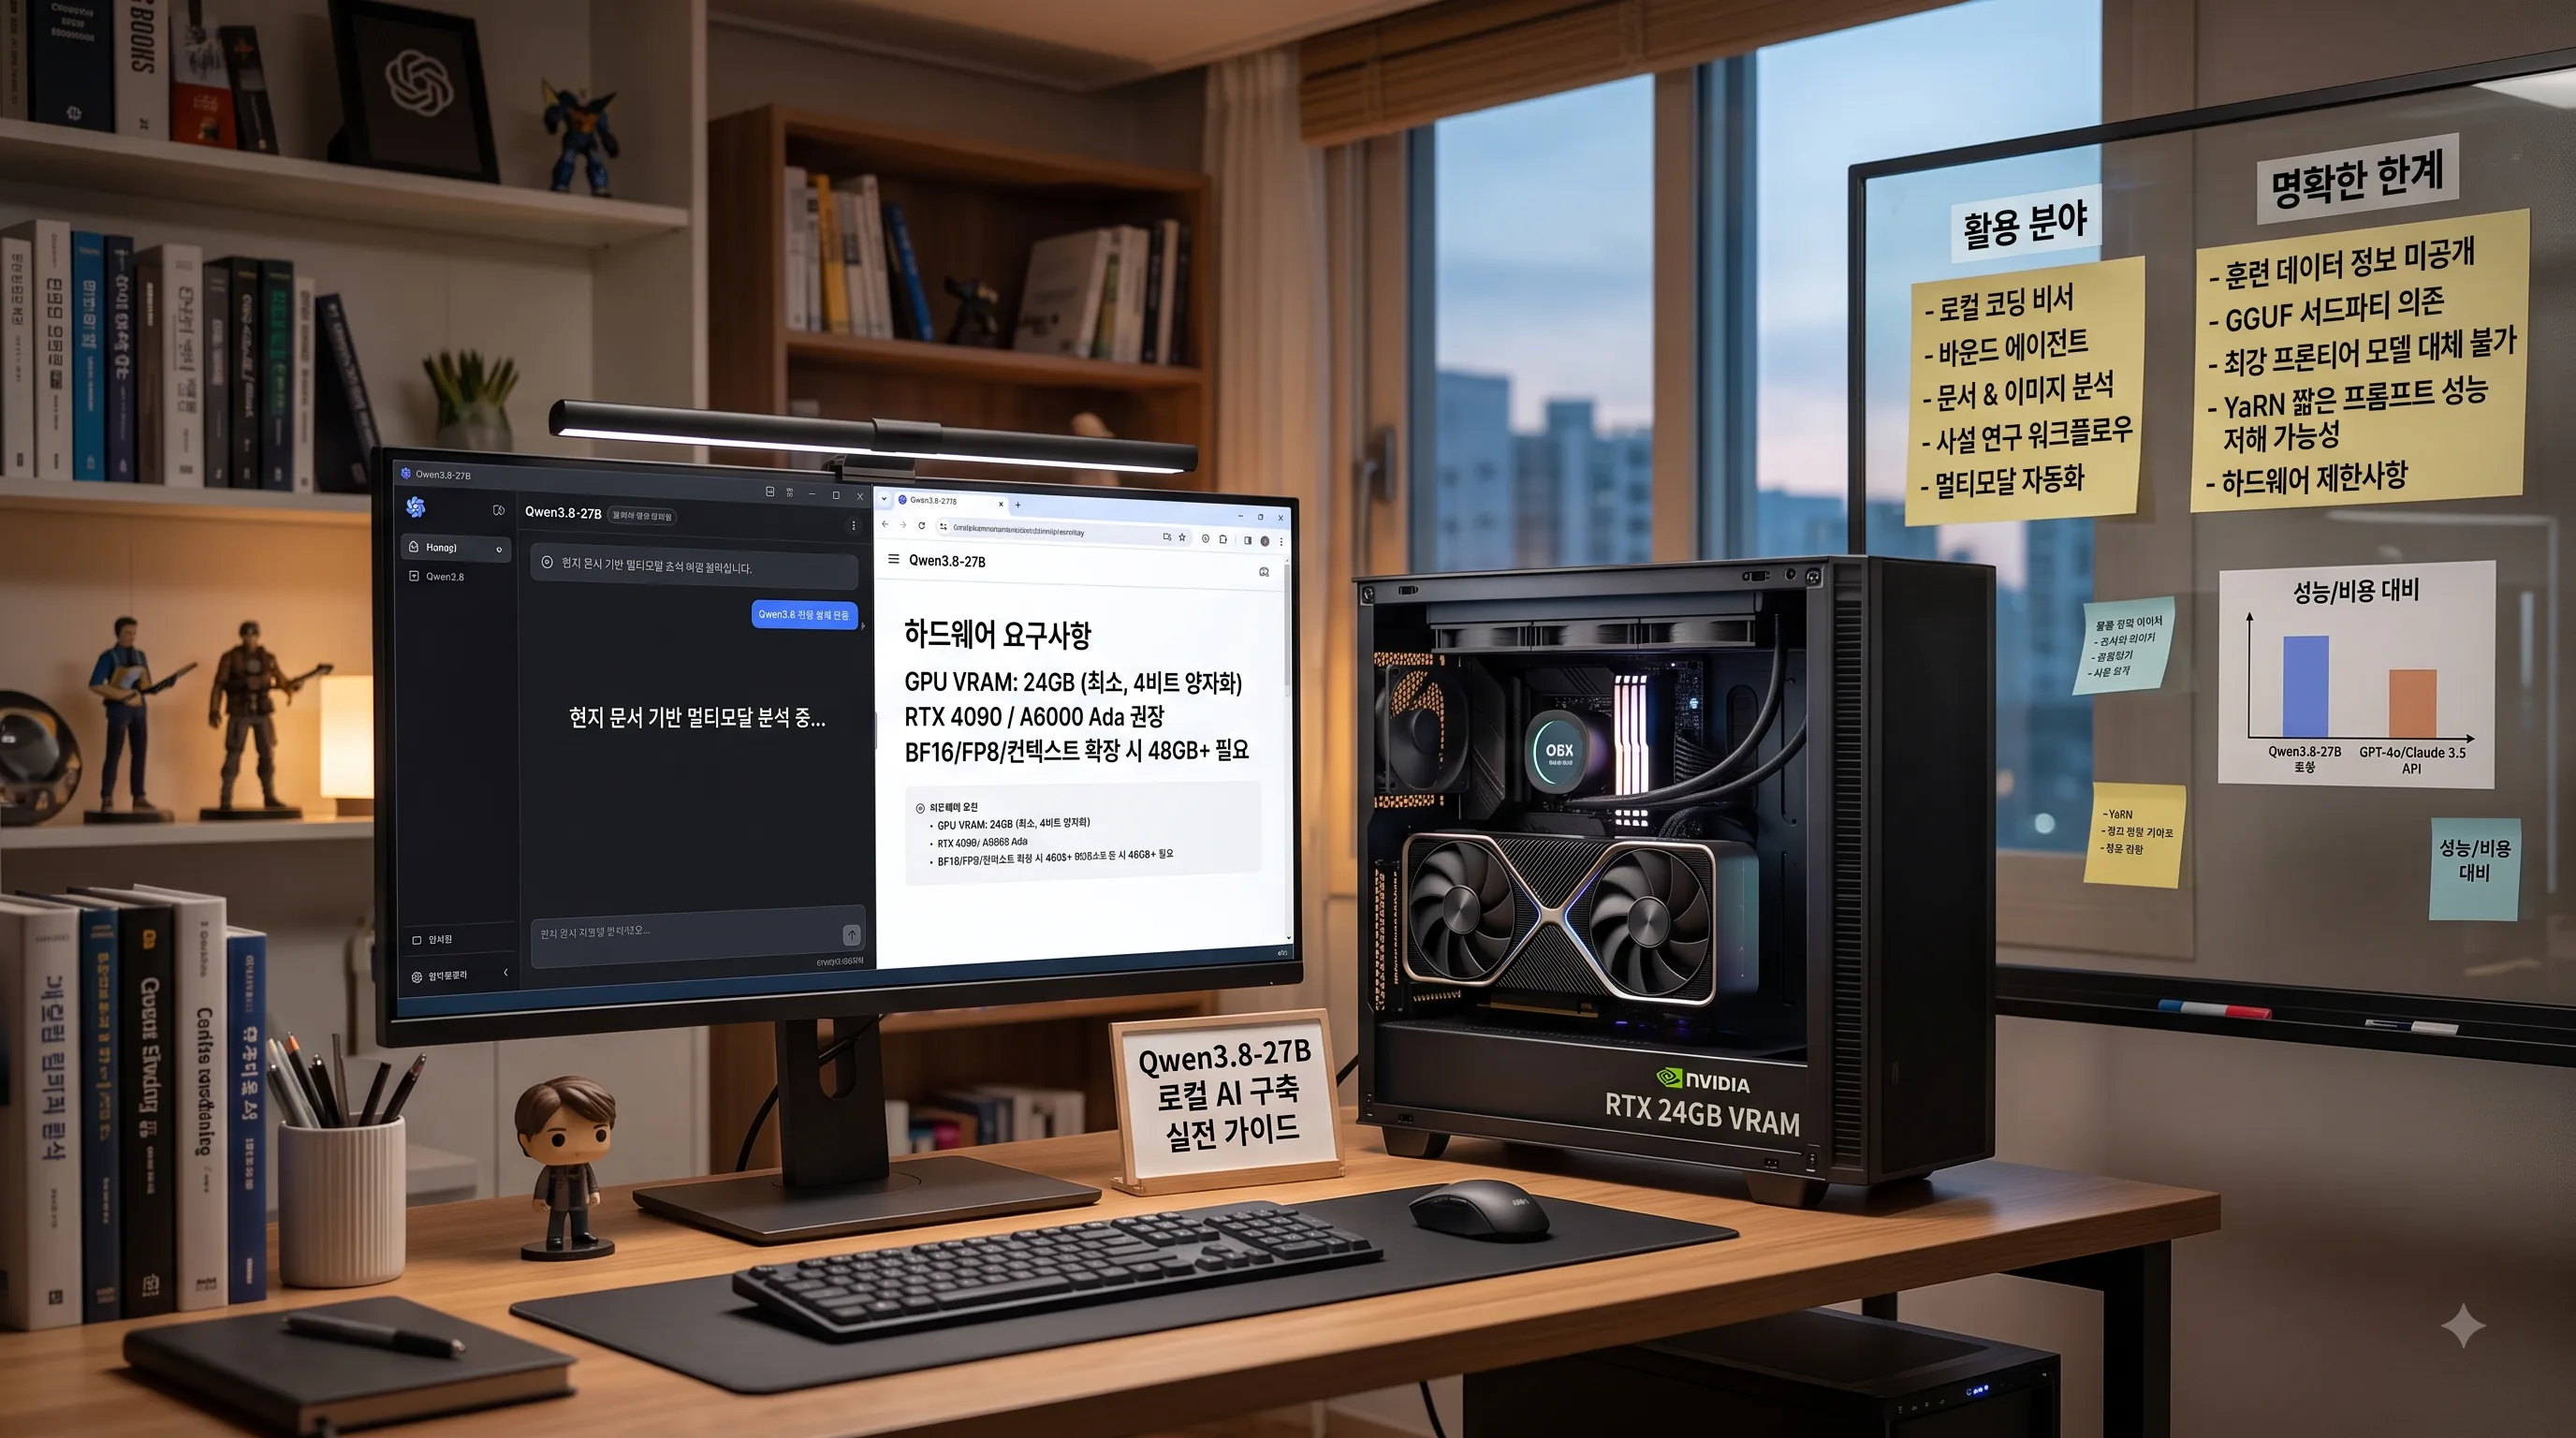
Qwen3.8-27B를 로컬 환경에 성공적으로 배포하기 위해서는 24GB GPU가 최소한의 기반 사양으로 요구됩니다.
이는 주로 중간 컨텍스트 길이의 4비트 양자화(quantization) 모델을 운영하는 데 적합한 수준입니다.
예를 들어, NVIDIA GeForce RTX 4090이나 RTX 6000 Ada, 또는 A6000과 같은 전문가용 GPU가 이러한 요구사항을 충족할 수 있습니다.
하지만 모델의 BF16 또는 Blockwise FP8 정식 가중치 형식을 그대로 사용하거나, 262,144 토큰에 달하는 전체 네이티브 컨텍스트 창을 활용하려면 24GB VRAM으로는 부족하며, 더 많은 GPU 메모리(예: 48GB 이상)가 필요하다는 점을 인지해야 합니다.
현재 공식적으로 제공되는 가중치 형식은 BF16과 Blockwise FP8뿐이며, 국내 사용자들이 흔히 사용하는 GGUF 파일은 서드파티 변환본에 의존해야 하므로 성능 및 안정성 측면에서 면밀한 검토가 필요합니다.
Qwen3.8-27B의 주요 활용 분야 및 잠재력
Qwen3.8-27B는 강력한 멀티모달 처리 능력과 Apache 2.0 라이선스로 인해 다양한 로컬 애플리케이션에 활용될 잠재력을 가지고 있습니다.
가장 주목할 만한 활용 분야로는 로컬 코딩 비서(Local Coding Assistant)가 있습니다.
이는 개발자가 자신의 코드베이스를 외부에 노출하지 않고도 코드 생성, 디버깅, 문서화, 리팩토링 등의 작업을 AI의 도움을 받아 수행할 수 있게 해줍니다.
또한, 바운드 에이전트(Bound Agent)로서 특정 도메인이나 업무에 특화된 자동화 에이전트를 구축하는 데 매우 효과적입니다.
예를 들어, 기업 내부 문서 관리 시스템과 연동하여 특정 유형의 문서를 자동으로 분류하거나, 고객 문의에 대한 1차 답변을 생성하는 에이전트를 만들 수 있습니다.
이외에도 문서 및 이미지 분석(Document & Image Analysis)을 통해 방대한 양의 사내 보고서나 시각 자료에서 필요한 정보를 추출하고 요약하는 데 활용될 수 있습니다.
특히 사설 연구 워크플로우(Private Research Workflows)에서는 민감한 데이터를 외부 클라우드에 전송할 필요 없이 로컬에서 안전하게 처리하며 연구 생산성을 높일 수 있습니다.
궁극적으로는 텍스트와 이미지 등 복합적인 정보를 이해하고 처리하는 멀티모달 자동화(Multimodal Automation) 솔루션을 구축하는 데 핵심적인 역할을 할 수 있을 것입니다.
명확한 한계점과 기대치 관리
아무리 강력한 모델이라 할지라도 Qwen3.8-27B에는 국내 개발자들이 반드시 인지하고 기대치를 관리해야 할 명확한 한계점들이 존재합니다.
가장 먼저, 훈련 데이터(Training Data)에 대한 정보가 전혀 공개되지 않았습니다.
훈련 코퍼스, 토큰 수, 지식 절단 시점, 후처리 레시피, 안전성 평가, 지원 언어 수 등 핵심적인 훈련 관련 정보가 미공개되어 있어, 모델의 동작 방식이나 잠재적 편향성에 대한 투명성이 부족합니다.
이러한 점은 민감한 데이터를 처리하거나 높은 신뢰성이 요구되는 애플리케이션에 모델을 적용할 때 신중을 기해야 함을 의미합니다.
또한, 앞서 언급했듯이 공식 가중치 형식은 BF16과 FP8로 제한되어 있으며, 국내에서 흔히 사용되는 GGUF 파일은 서드파티에 의해 변환된 형태로만 존재합니다.
이는 로컬 환경에서 다양한 하드웨어 구성에 유연하게 대응하기 어려운 요인이 될 수 있습니다.
가장 중요한 한계점 중 하나는 최강 프론티어 API 모델(예: GPT-4o, Claude 3.5 Opus) 또는 데이터센터 규모의 오픈 모델들을 일대일로 대체할 수 없다는 점입니다.
Qwen3.8-27B는 자체 벤치마크에서 좋은 점수를 보였지만, 출시일(2026-08-14) 기준 독립적인 벤치마크 재현 사례가 부재하며, 벤치마크 데이터 또한 Qwen 자체 보고(일부 벤치마크 자체 개발/수정)임을 감안할 때 그 결과는 주의 깊게 해석해야 합니다.
실제로 Opus4.6 Max나 Qwen3.7 Plus와 같은 경쟁 모델 대비 특정 벤치마크(예: Terminal-Bench 2.1, GPQA Diamond)에서 열세를 보이는 부분이 확인되었습니다.
마지막으로, 확장 컨텍스트(최대 100만 토큰) 기능은 YaRN 스케일링을 통해 가능하지만, 정적 YaRN 스케일링이 짧은 프롬프트의 성능을 저해할 가능성이 경고되고 있어 사용 시 주의가 필요합니다.
이러한 한계점들을 명확히 이해하고 모델의 강점과 약점을 종합적으로 고려하여 활용한다면, 국내 개발자들은 Qwen3.8-27B를 통해 로컬 AI 환경에서 혁신적인 가치를 창출할 수 있을 것입니다.
4. Qwen 생태계 확장 전략: Qwen Studio부터 2.4조 Max 모델까지
Qwen 생태계의 핵심 축: 공식 플랫폼들
알리바바는 Qwen 모델 라인업을 기반으로 광범위한 AI 생태계를 구축하고 있으며, 그 중심에는 사용자 접근성과 활용성을 극대화하는 공식 플랫폼들이 자리 잡고 있습니다.
이러한 플랫폼들은 개별 모델의 성능을 넘어 사용자에게 통합적인 경험을 제공하는 데 주력하고 있습니다.
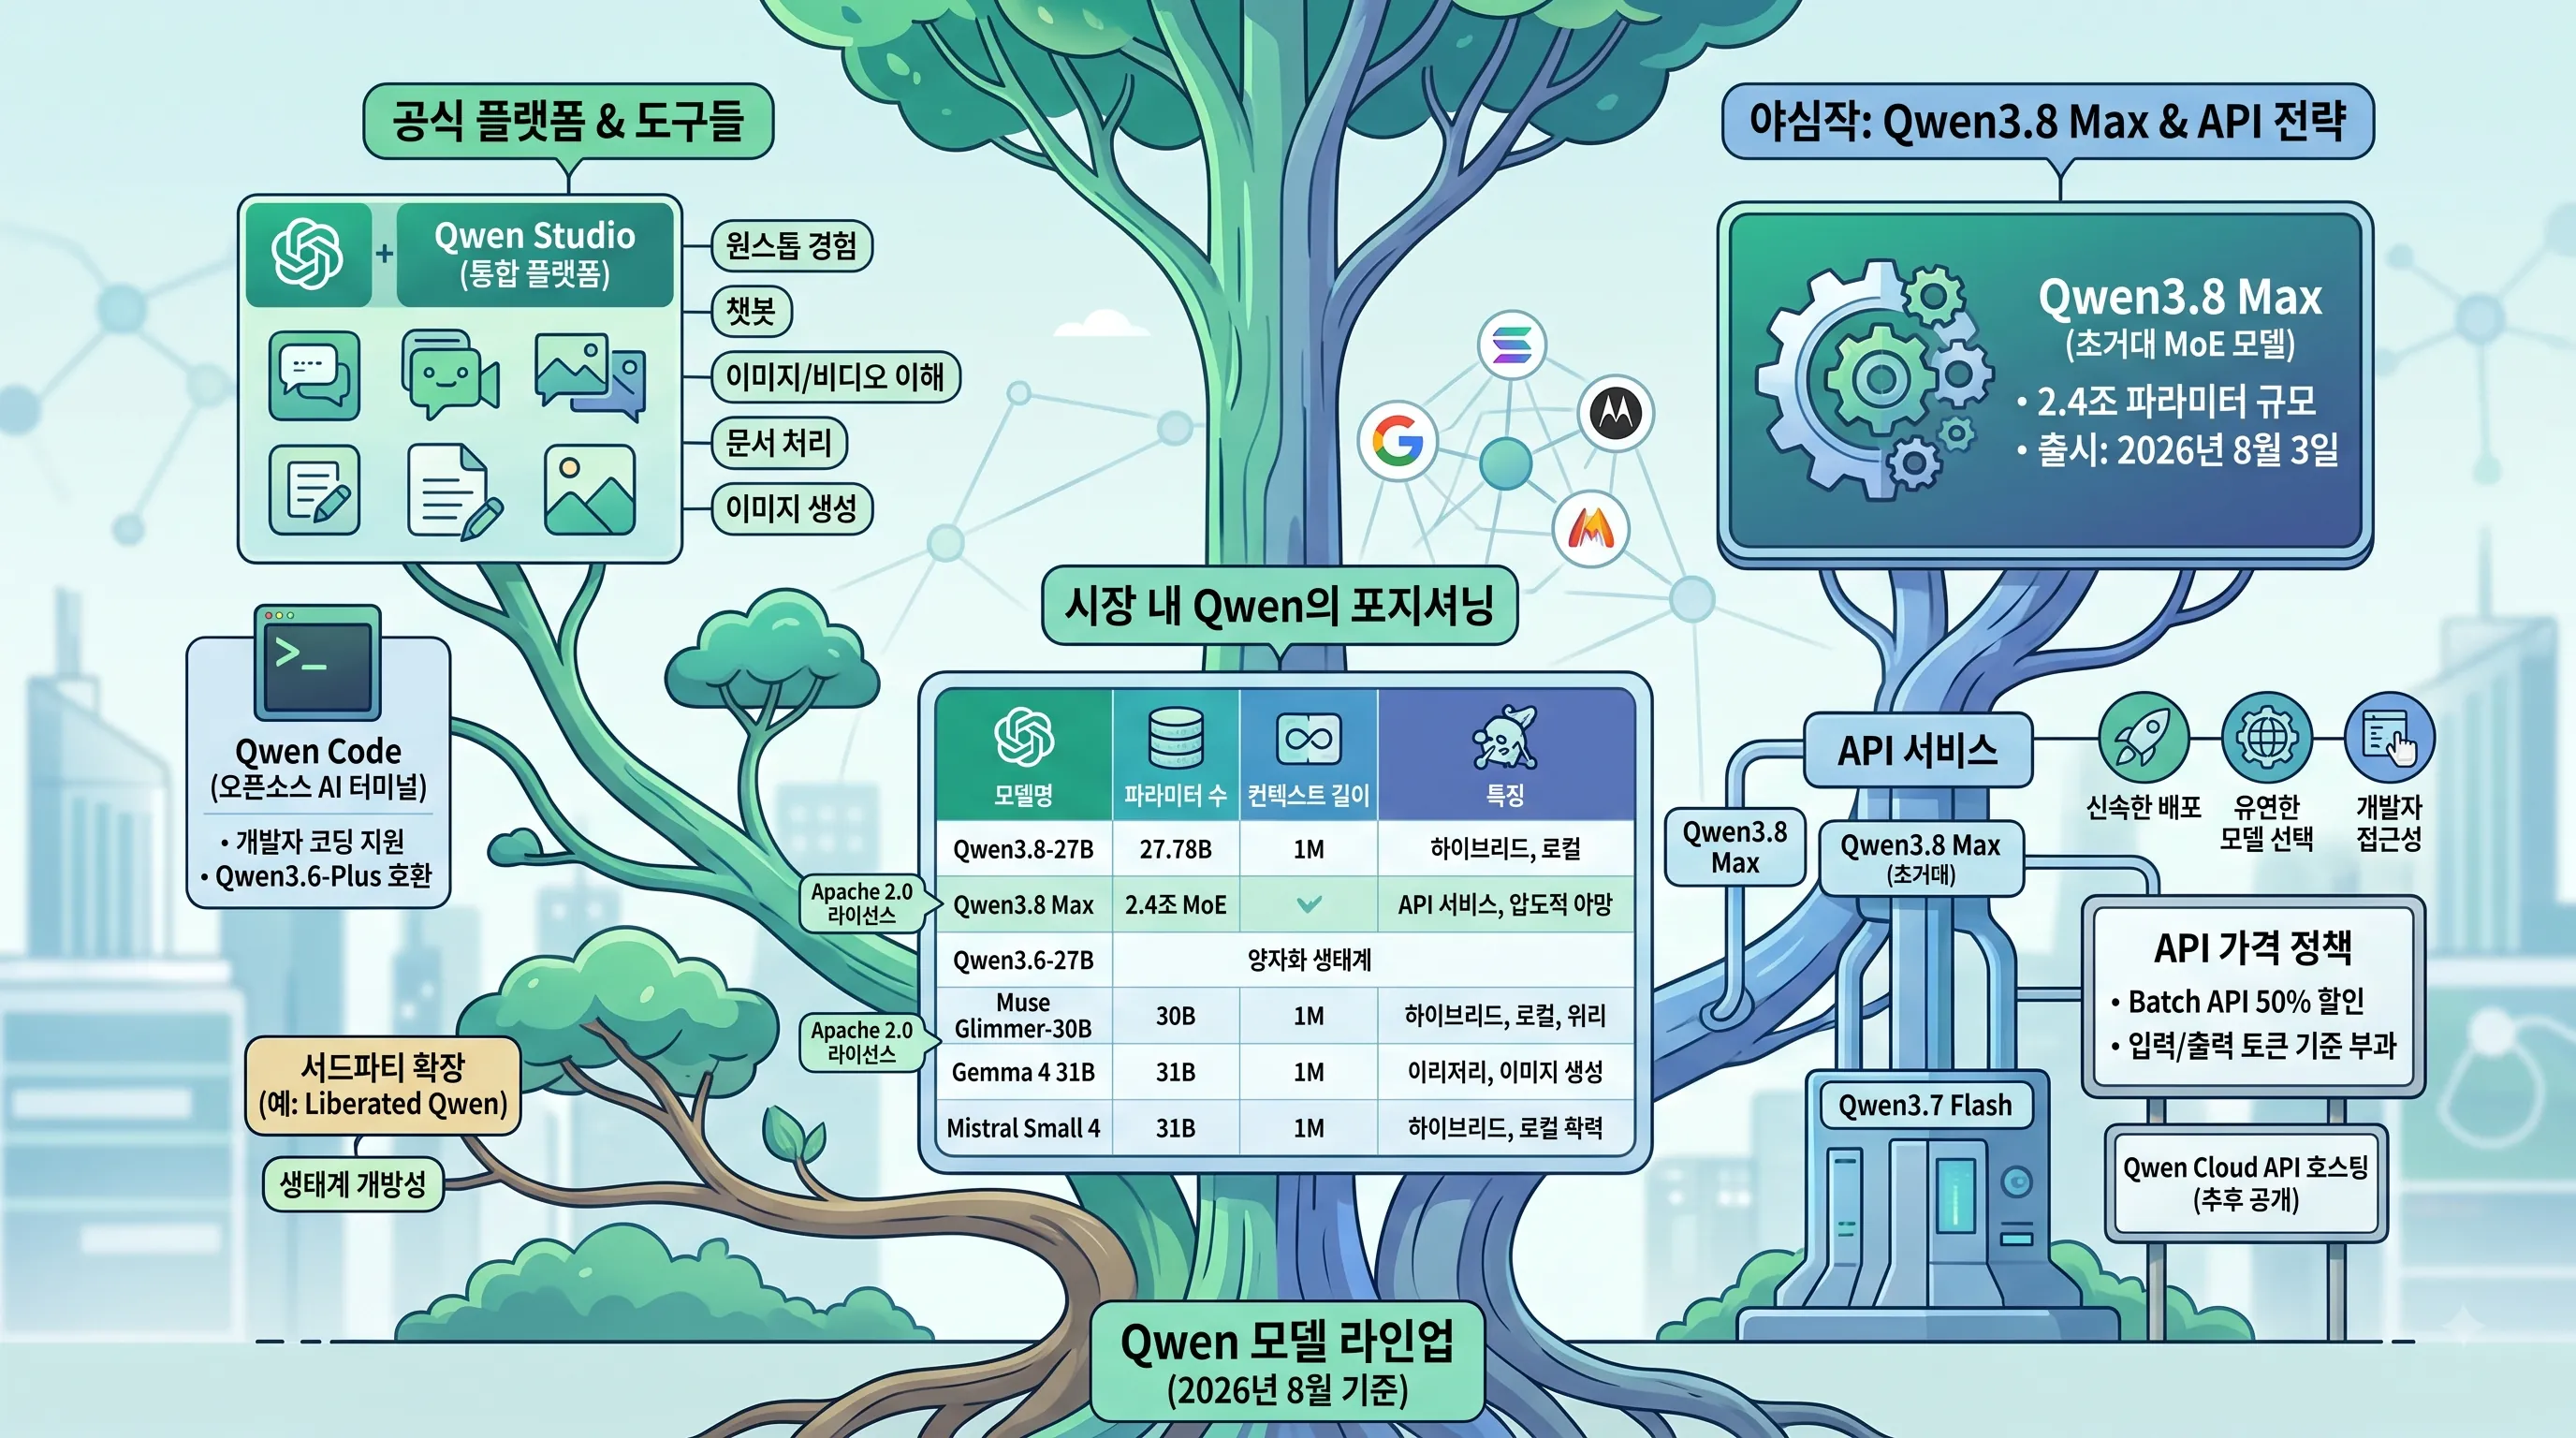
대표적으로 Qwen Studio는 Qwen의 공식 통합 플랫폼으로 기능하며, 사용자들은 이곳에서 다양한 Qwen 모델의 역량을 활용할 수 있습니다.
챗봇 기능부터 시작하여 이미지 및 비디오 이해, 이미지 생성, 그리고 문서 처리에 이르기까지 광범위한 AI 기능을 Qwen Studio 내에서 원스톱으로 경험할 수 있도록 설계되었습니다.
이는 개발자와 비즈니스 사용자가 Qwen의 강력한 멀티모달 능력을 손쉽게 통합하고 활용할 수 있도록 지원하는 핵심 인프라입니다.
또한, 코딩 및 개발자 지원을 위해 최적화된 Qwen Code가 존재합니다.
이것은 Qwen에 최적화된 오픈소스 AI 터미널 에이전트로서, 특히 Qwen3.6-Plus와 같은 모델들과의 호환성을 통해 개발자들이 코딩 작업을 더욱 효율적으로 수행할 수 있도록 돕습니다.
이러한 공식 플랫폼 외에도, 샌프란시스코의 'Liberated Qwen'과 같은 서드파티 파인튜닝 버전 개발 사례들이 시장에 등장하며 Qwen 생태계의 개방성과 확장성을 증명하고 있습니다.
알리바바의 야심작: Qwen3.8 Max와 API 전략
알리바바의 Qwen 생태계 확장 전략의 정점은 압도적인 규모의 Qwen3.8 Max 모델과 이를 중심으로 한 API 서비스 전략에서 엿볼 수 있습니다.
Qwen3.8 Max는 2.4조 파라미터 규모의 MoE(Mixture-of-Experts) 모델로, 이미 2026년 8월 3일에 출시되어 현재 활발히 서비스되고 있습니다.
이러한 초거대 모델의 출시는 알리바바가 범용 인공지능 분야에서 최고 수준의 경쟁력을 확보하려는 강력한 의지를 반영합니다.
알리바바는 과거 챗GPT와 유사한 형태로 Qwen 조직을 재편성하는 과정을 진행해 왔으며, 이는 긍정적인 전략적 방향이자 Qwen 프로젝트에 대한 기업의 높은 야망을 시사하는 것으로 평가됩니다.
이러한 조직 재편은 Qwen 모델들이 더욱 신속하고 효율적으로 개발, 배포될 수 있는 기반을 마련했습니다.
API 서비스를 통해 접근 가능한 Qwen 모델로는 Qwen3.8 Max 외에도 Qwen3.7 Flash가 제공되고 있으며, 이는 다양한 사용 사례와 성능 요구사항에 맞춰 선택할 수 있는 유연성을 제공합니다.
이러러한 API 중심의 서비스 전략은 개발자들이 강력한 Qwen 모델을 자체 인프라 구축 없이도 손쉽게 활용할 수 있도록 함으로써 생태계 확장의 중요한 동력이 되고 있습니다.
경쟁 구도 분석: 시장 내 Qwen의 포지셔닝
현재(2026년 8월 17일 기준) 거대 AI 모델 시장은 매우 역동적이며, Qwen은 여러 강력한 경쟁자들 사이에서 독자적인 위치를 구축하고 있습니다.
Qwen의 포지셔닝을 객관적으로 분석하기 위해서는 시장의 주요 경쟁 모델들을 함께 고려해야 합니다.
Qwen의 직전 버전인 Qwen3.6-27B는 약 27.8B 파라미터 모델로, 이미 성숙한 양자화 생태계를 보유하고 있어 Qwen3.8-27B와 함께 로컬 환경에서의 강력한 대안으로 주목받고 있습니다.
경쟁 모델 중 하나인 Muse Glimmer-30B는 약 29.6B 파라미터(비전 인코더 포함)의 텍스트 및 이미지 멀티모달 모델이며, 131K+의 컨텍스트 길이를 지원하고 Apache 2.0 라이선스를 따릅니다.
구글의 모델인 Gemma 4 31B는 약 31B 파라미터의 텍스트 및 이미지 멀티모달 모델로, 최대 256K의 컨텍스트를 제공하며 역시 Apache 2.0 라이선스로 공개되었습니다.
Mistral AI의 Mistral Small 4는 총 119B 파라미터 중 6.5B의 활성 파라미터를 가진 MoE 모델이며, 텍스트 및 이미지 모달리티를 지원하고 256K의 긴 컨텍스트와 Apache 2.0 라이선스를 특징으로 합니다.
이러한 경쟁 모델들과 비교했을 때, Qwen은 특히 Qwen3.8 Max의 2.4조 파라미터 MoE 구조를 통해 규모 면에서 압도적인 야망을 드러내며, Qwen Studio와 Qwen Code와 같은 통합 플랫폼을 통해 사용자 친화적인 생태계 구축에 강점을 보이고 있습니다.
특히 멀티모달 기능과 긴 컨텍스트 처리 능력은 여러 경쟁자들과 유사하지만, 알리바바의 전폭적인 지원과 공격적인 모델 개발 전략은 Qwen이 시장에서 중요한 역할을 할 수 있는 기반이 됩니다.
Qwen 및 주요 경쟁 모델 비교
| 모델명 | 파라미터 수 | 모달리티 | 컨텍스트 길이 | 라이선스 | 특징 |
|---|---|---|---|---|---|
| Qwen3.8-27B | 27.78B | 텍스트, 이미지, 비디오 입력 / 텍스트 출력 | 262,144 (네이티브) / 1,000,000 (YaRN 스케일링) | Apache 2.0 | 하이브리드 디코더, MTP, 로컬 배포 최적화 |
| Qwen3.6-27B | 약 27.8B | N/A | N/A | N/A | 성숙한 양자화 생태계 |
| Qwen3.8 Max | 2.4조 (MoE) | N/A | N/A | N/A | 초거대 MoE 모델 (API 서비스) |
| Muse Glimmer-30B | 약 29.6B (비전 인코더 포함) | 텍스트, 이미지 | 131K+ | Apache 2.0 | |
| Gemma 4 31B | 약 31B | 텍스트, 이미지 | 최대 256K | Apache 2.0 | |
| Mistral Small 4 | 119B (활성 6.5B MoE) | 텍스트, 이미지 | 256K | Apache 2.0 | MoE 아키텍처 |
Qwen API 서비스 및 가격 정책
Qwen은 강력한 모델들을 API 형태로 제공하며, 2026년 8월 현재 최신 가격 정보가 사용 가능합니다.
사용자는 Qwen API를 통해 필요에 따라 모델을 선택하고, 사용량에 따라 비용을 지불하는 방식을 이용할 수 있습니다.
Batch API는 실시간 가격의 50% 요율로 제공되며, 입력 및 출력 토큰을 기준으로 비용이 부과됩니다.
이러한 가격 가이드는 각 모델별 토큰당 비용과 컨텍스트 길이에 따른 세부 정보를 포함하고 있어, 기업 및 개발자가 프로젝트 예산을 효율적으로 계획할 수 있도록 돕습니다.
API 방식의 접근은 대규모 언어 모델을 활용하고자 하는 기업이나 개발팀에게 직접적인 모델 구축 및 유지보수의 부담 없이 최신 Qwen 모델의 강력한 성능을 이용할 수 있게 하는 핵심적인 요소입니다.
다만, Qwen Cloud API 호스팅 서비스는 아직 'coming soon' 상태로, 정확한 모델 가격에 대한 상세 정보는 추후 공개될 예정입니다.
이는 Qwen이 점진적으로 서비스 제공 범위를 확장하며 시장의 수요에 맞춰 나갈 것임을 시사합니다.
관련 글