제미나이 3.7 플래시 공식 출시: AI 성능, 가격, 활용 전략 완벽 분석
- 구글의 최신 AI 모델 제미나이 3.7 플래시가 2026년 8월 13일 공식 출시되었습니다.
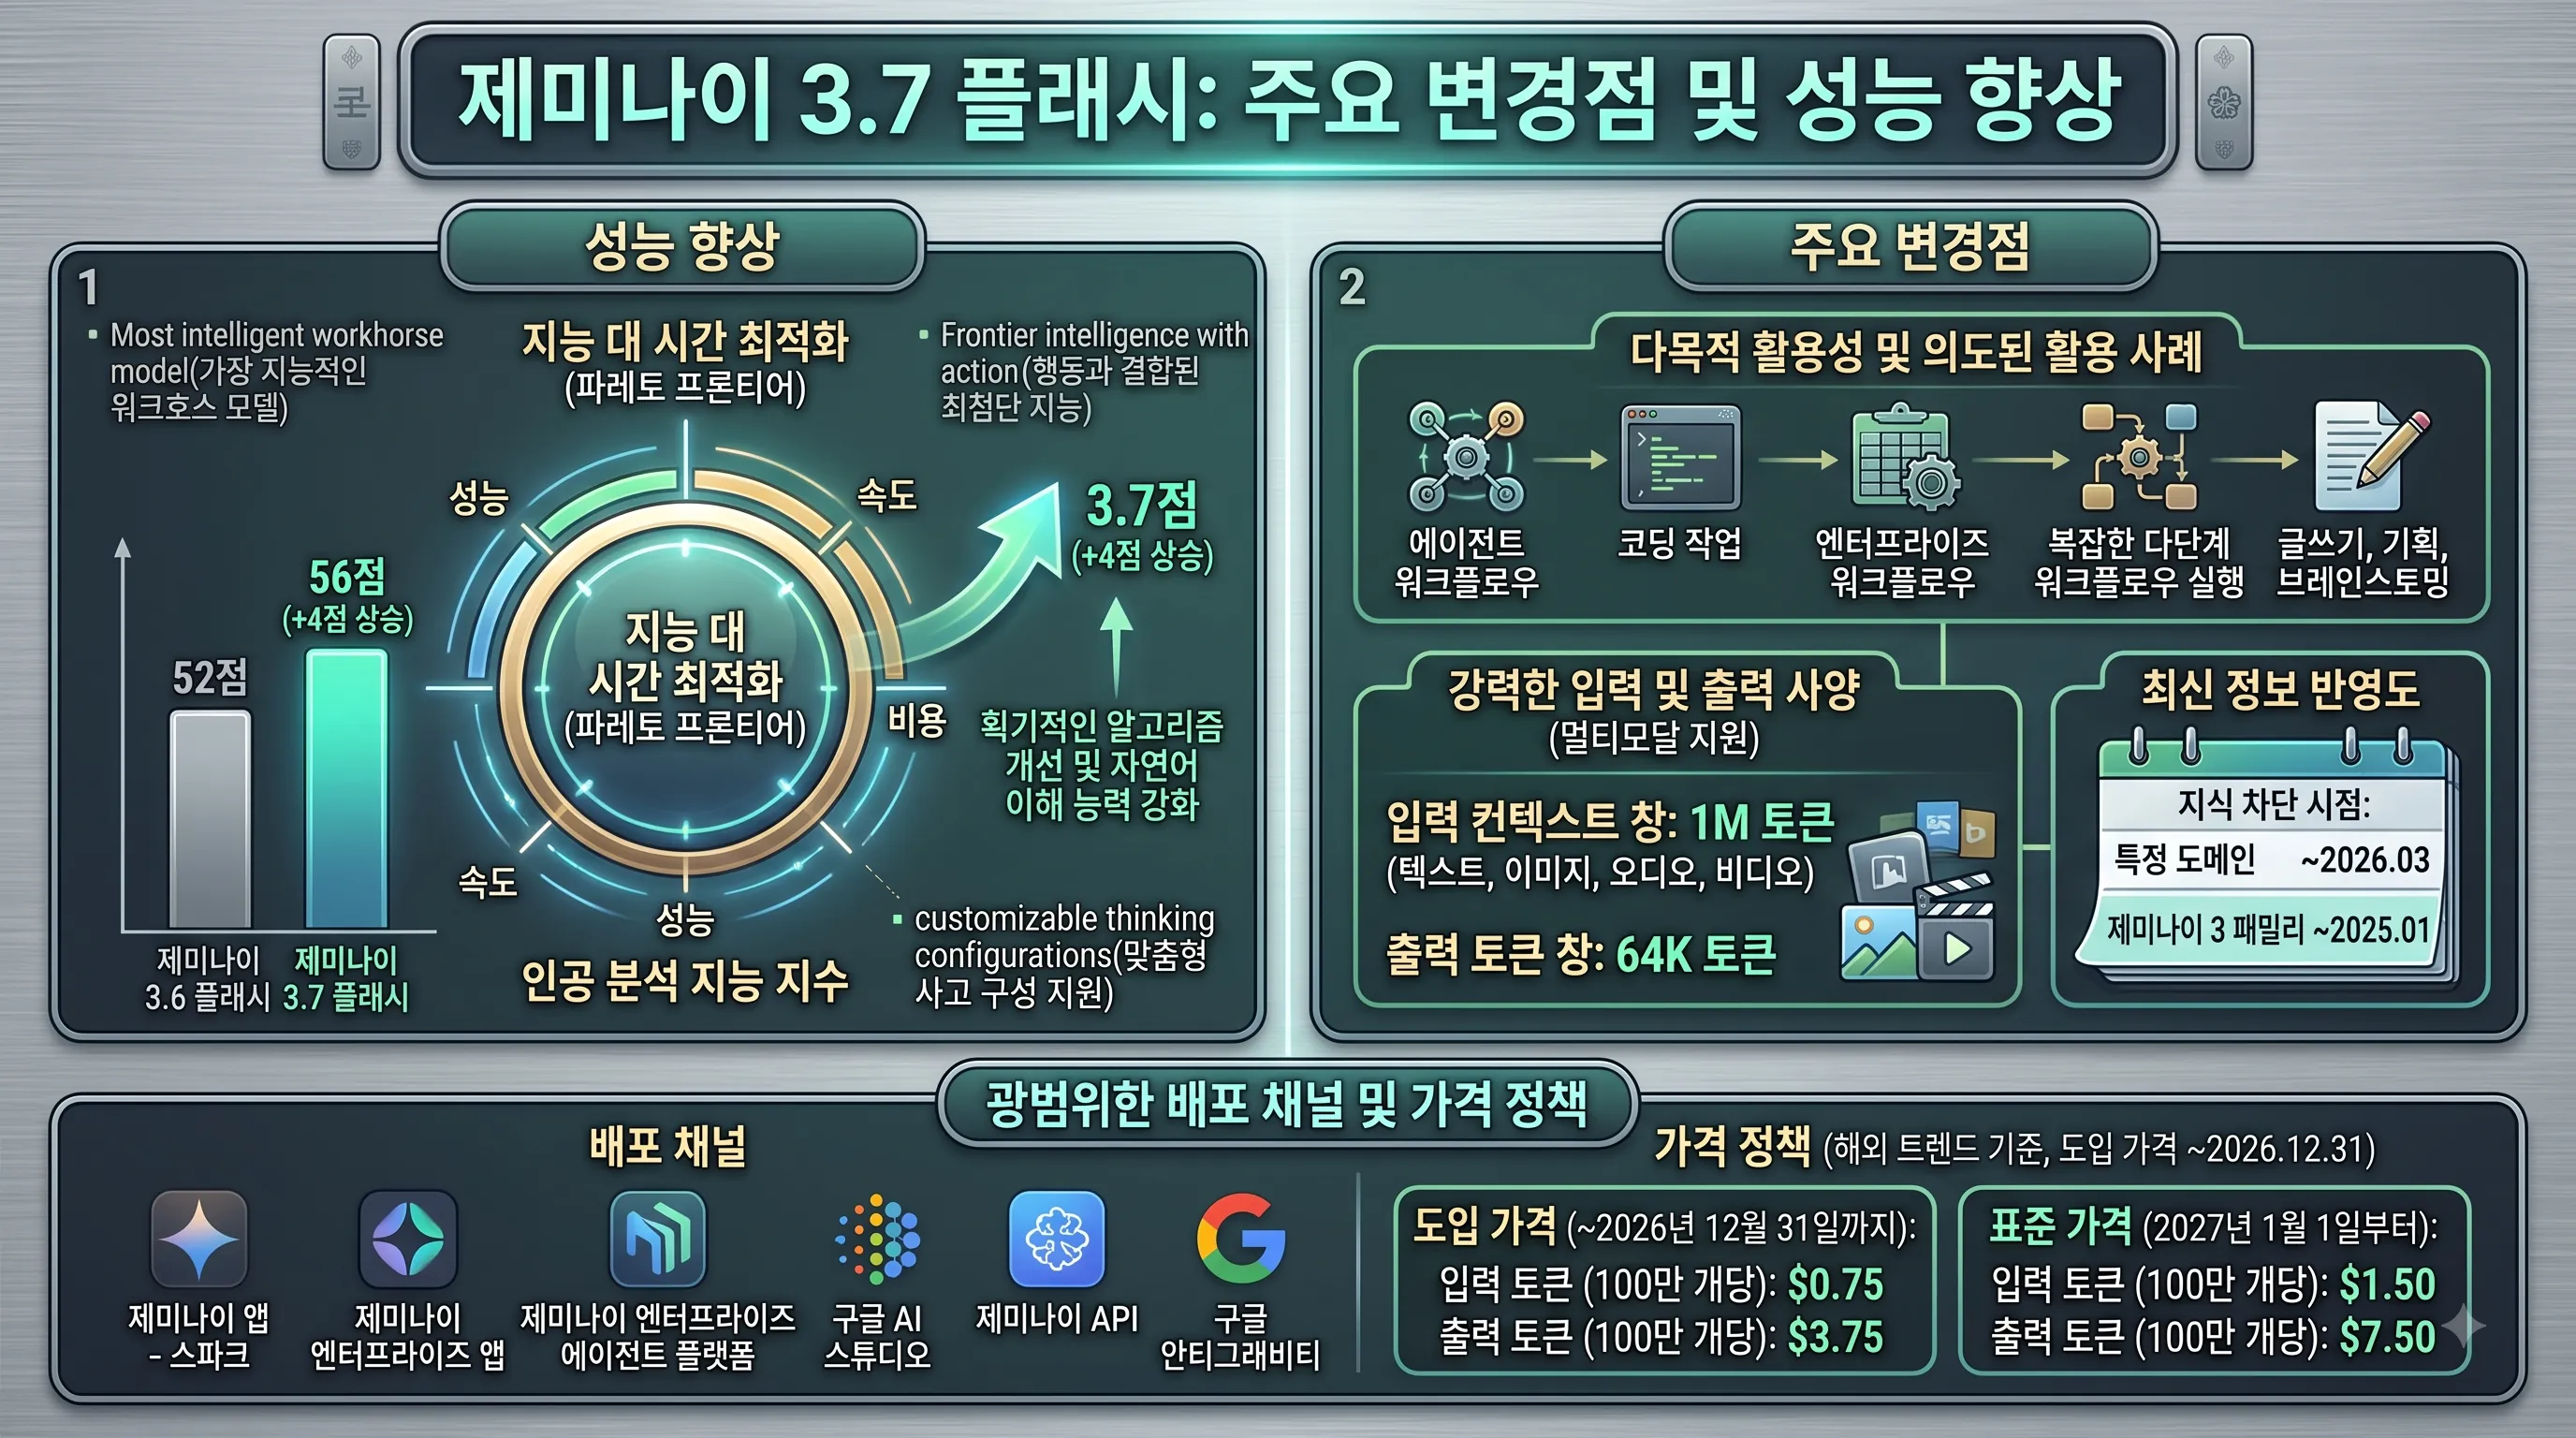
- 제미나이 3.6 플래시 대비 인공 분석 지능 지수(AAII)가 4점 향상된 56점을 기록하며 핵심 추론 능력이 개선되었습니다.
- '행동과 결합된 최첨단 지능'을 지향하며, 에이전트 워크플로우, 코딩 작업, 엔터프라이즈 워크플로우 등 광범위한 실무에 활용 가능합니다.
- 1M 토큰의 방대한 입력 컨텍스트와 64K 토큰의 출력 토큰을 지원하는 멀티모달 모델입니다.
- 주요 벤치마크에서 코딩 (FrontierCode 43.6%, DeepSWE 65.3%), 멀티모달 이해 (CharXiv 88.7%), 장문 컨텍스트 (97.0%) 등 뛰어난 성능을 보였습니다.
- 가격은 2026년 12월 31일까지 도입가(입력 $0.75/1M, 출력 $3.75/1M)가 적용되며, 이후 표준가(입력 $1.50/1M, 출력 $7.50/1M)로 인상됩니다.
- 할루시네이션과 같은 일반적인 AI 모델의 한계가 존재하며, 사이버 보안 및 CBRN 영역에서 경고 임계값에 도달하는 안전성 평가 결과가 나왔습니다.
1. 제미나이 3.7 플래시: 3.6 버전 대비 주요 변경점 및 성능 향상
구글의 최신 AI 모델인 제미나이 3.7 플래시(Gemini 3.7 Flash)가 2026년 8월 13일에 공식 출시되었습니다.
이 모델은 제미나이 3 모델 패밀리의 일원으로서, 이전 버전인 제미나이 3.6 플래시를 기반으로 획기적인 알고리즘 개선을 이루어냈습니다.
특히, 3주 간격으로 빠르게 이뤄지는 '플래시' 시리즈의 출시 주기를 고려할 때, 이번 업데이트는 사용자들에게 더욱 빠르고 효율적인 AI 경험을 제공하려는 구글의 노력을 잘 보여줍니다.
제미나이 3.7 플래시의 핵심 정체성은 '행동과 결합된 최첨단 지능(frontier intelligence with action)'이라는 속성에 집약되어 있습니다.
이는 단순히 높은 지능을 넘어, 실제 작업 환경에서 구체적인 행동과 실행을 통해 가치를 창출하는 데 중점을 둔 모델임을 의미합니다.
널리 사용되는 플래시 시리즈의 명성을 계승하면서, 가장 지능적인 워크호스 모델(Most intelligent workhorse model)로서의 역할을 공고히 하고 있습니다.
향상된 지능과 다목적 활용성
이번 제미나이 3.7 플래시의 가장 두드러지는 변화는 인공 분석 지능 지수(Artificial Analysis Intelligence Index) 점수의 상승입니다.
이 모델은 이전 제미나이 3.6 플래시의 52점에서 56점으로 4점 향상된 성능을 기록했습니다.
이러한 점수 향상은 모델의 핵심 추론 기반에 대한 알고리즘 개선의 결과이며, 향상된 자연어 이해 능력(enhanced natural language understanding)을 통해 사용자가 원하는 작업을 더욱 성공적으로 처리할 수 있음을 시사합니다.
제미나이 3.7 플래시는 '작업당 지능 대 시간'의 파레토 프론티어(Intelligence vs. Time per Task Pareto frontier)에 도달하며 최적의 효율성을 추구합니다.
이는 성능과 속도, 비용 사이의 균형을 극대화하여 다양한 기업 및 개인 사용자에게 최적화된 솔루션을 제공한다는 의미입니다.
또한, 품질, 비용, 지연 시간의 조합을 제어하기 위한 맞춤형 사고 구성(customizable thinking configurations)을 지원하여, 사용 환경에 따라 유연하게 모델을 조정할 수 있는 강력한 이점을 제공합니다.
이 모델의 의도된 활용 사례(Intended Use Cases)를 살펴보면, '행동과 결합된 최첨단 지능'이라는 핵심 속성이 더욱 명확해집니다.
에이전트 워크플로우(Agentic workflows), 코딩 작업(Coding tasks), 엔터프라이즈 워크플로우(Enterprise workflows)와 같은 복잡한 업무부터, 글쓰기(Writing), 기획(Planning), 브레인스토밍(Brainstorming)에 이르기까지 광범위한 영역에서 활용될 수 있습니다.
특히, 복잡한 다단계 워크플로우를 실행(Executing complex multi-step workflows)하고, 목표를 관리 가능한 단계로 분해하며, 다양한 애플리케이션을 연결하는 데 탁월한 능력을 발휘합니다.
제미나이 3.7 플래시는 텍스트 문자열뿐만 아니라 이미지, 오디오, 비디오 파일을 포함한 다양한 형태의 입력을 지원하는 멀티모달(multimodal) 모델입니다.
이는 100만(1M) 토큰에 달하는 방대한 입력 컨텍스트 창(Input_Context_Window)과 6만 4천(64K) 토큰의 출력 토큰 창(Output_Token_Window)을 통해 장문 이해 및 응답 생성 능력을 더욱 강화했음을 의미합니다.
최신 정보 반영도를 나타내는 지식 차단 시점(Knowledge_Cutoff)은 특정 도메인에서는 2026년 3월까지의 데이터를, 제미나이 3 패밀리 전반과 관련된 다른 도메인에서는 2025년 1월까지의 데이터를 학습했습니다.
| 구분 | 내용 |
|---|---|
| 입력 컨텍스트 창 | 1M 토큰 |
| 출력 토큰 창 | 64K 토큰 |
| 지식 차단 시점 (특정 도메인) | 2026년 3월 |
| 지식 차단 시점 (Gemini 3 패밀리 전반) | 2025년 1월 |
광범위한 배포 채널 및 가격 정책
제미나이 3.7 플래시는 다양한 채널을 통해 광범위하게 배포되어 사용자 접근성을 높였습니다.
주요 배포 채널로는 제미나이 앱 - 스파크(Gemini App - Spark), 제미나이 엔터프라이즈 앱(Gemini Enterprise App), 제미나이 엔터프라이즈 에이전트 플랫폼(Gemini Enterprise Agent Platform), 구글 AI 스튜디오(Google AI Studio), 제미나이 API(Gemini API), 그리고 구글 안티그래비티(Google Antigravity)가 있습니다.
이는 개발자부터 일반 사용자, 그리고 기업 환경에 이르기까지 거의 모든 사용자가 이 강력한 모델에 접근하고 활용할 수 있음을 의미합니다.
가격 정책에 있어서는 해외 트렌드 기준(Overseas_Trends_USD)으로, 2026년 12월 31일까지 유효한(Expires 2026-12-31) 도입 가격(Introductory Price)이 적용되고 있습니다.
입력 토큰 100만 개당 0.75달러, 출력 토큰 100만 개당 3.75달러입니다.
이는 국내 사용자들에게도 해외 시장의 최신 AI 기술을 비교적 합리적인 가격으로 경험할 수 있는 기회를 제공하며, 초기 도입 장벽을 낮추는 역할을 합니다.
그러나 2027년 1월 1일부터는 표준 가격(Standard Price)이 적용될 예정으로, 입력 토큰 100만 개당 1.50달러, 출력 토큰 100만 개당 7.50달러로 인상될 예정입니다.
따라서 국내 기업이나 개발자들은 현재의 도입 가격 기간을 활용하여 모델을 충분히 검토하고 도입 전략을 세울 필요가 있습니다.
| 구분 | 입력 토큰 (100만 개당) | 출력 토큰 (100만 개당) | 적용 기간 |
|---|---|---|---|
| 도입 가격 | $0.75 | $3.75 | ~ 2026년 12월 31일 |
| 표준 가격 | $1.50 | $7.50 | 2027년 1월 1일 ~ |
2. 코딩부터 멀티모달 이해까지: 18개 최신 벤치마크 점수 심층 분석
Gemini 3.7 Flash의 종합 지능 및 코딩 능력
2026년 8월 13일 출시된 Gemini 3.7 Flash는 이전 버전인 Gemini 3.6 Flash 대비 4점 향상된 성능을 보여주며, 특히 '인공 분석 지능 지수(Artificial Analysis Intelligence Index)'에서 56점을 기록했습니다.
이는 플래시(Flash) 시리즈의 핵심적인 발전으로, 모델의 전반적인 추론 및 문제 해결 능력이 더욱 정교해졌음을 의미합니다.
새롭게 선보인 Gemini 3.7 Flash는 광범위한 벤치마크 평가에서 그 진가를 입증하며, 개발자와 기업 사용자 모두에게 혁신적인 가치를 제공하고 있습니다.
코딩 및 소프트웨어 엔지니어링 벤치마크 심층 분석
Gemini 3.7 Flash는 코딩 및 소프트웨어 개발 분야에서 인상적인 성과를 나타냈습니다.
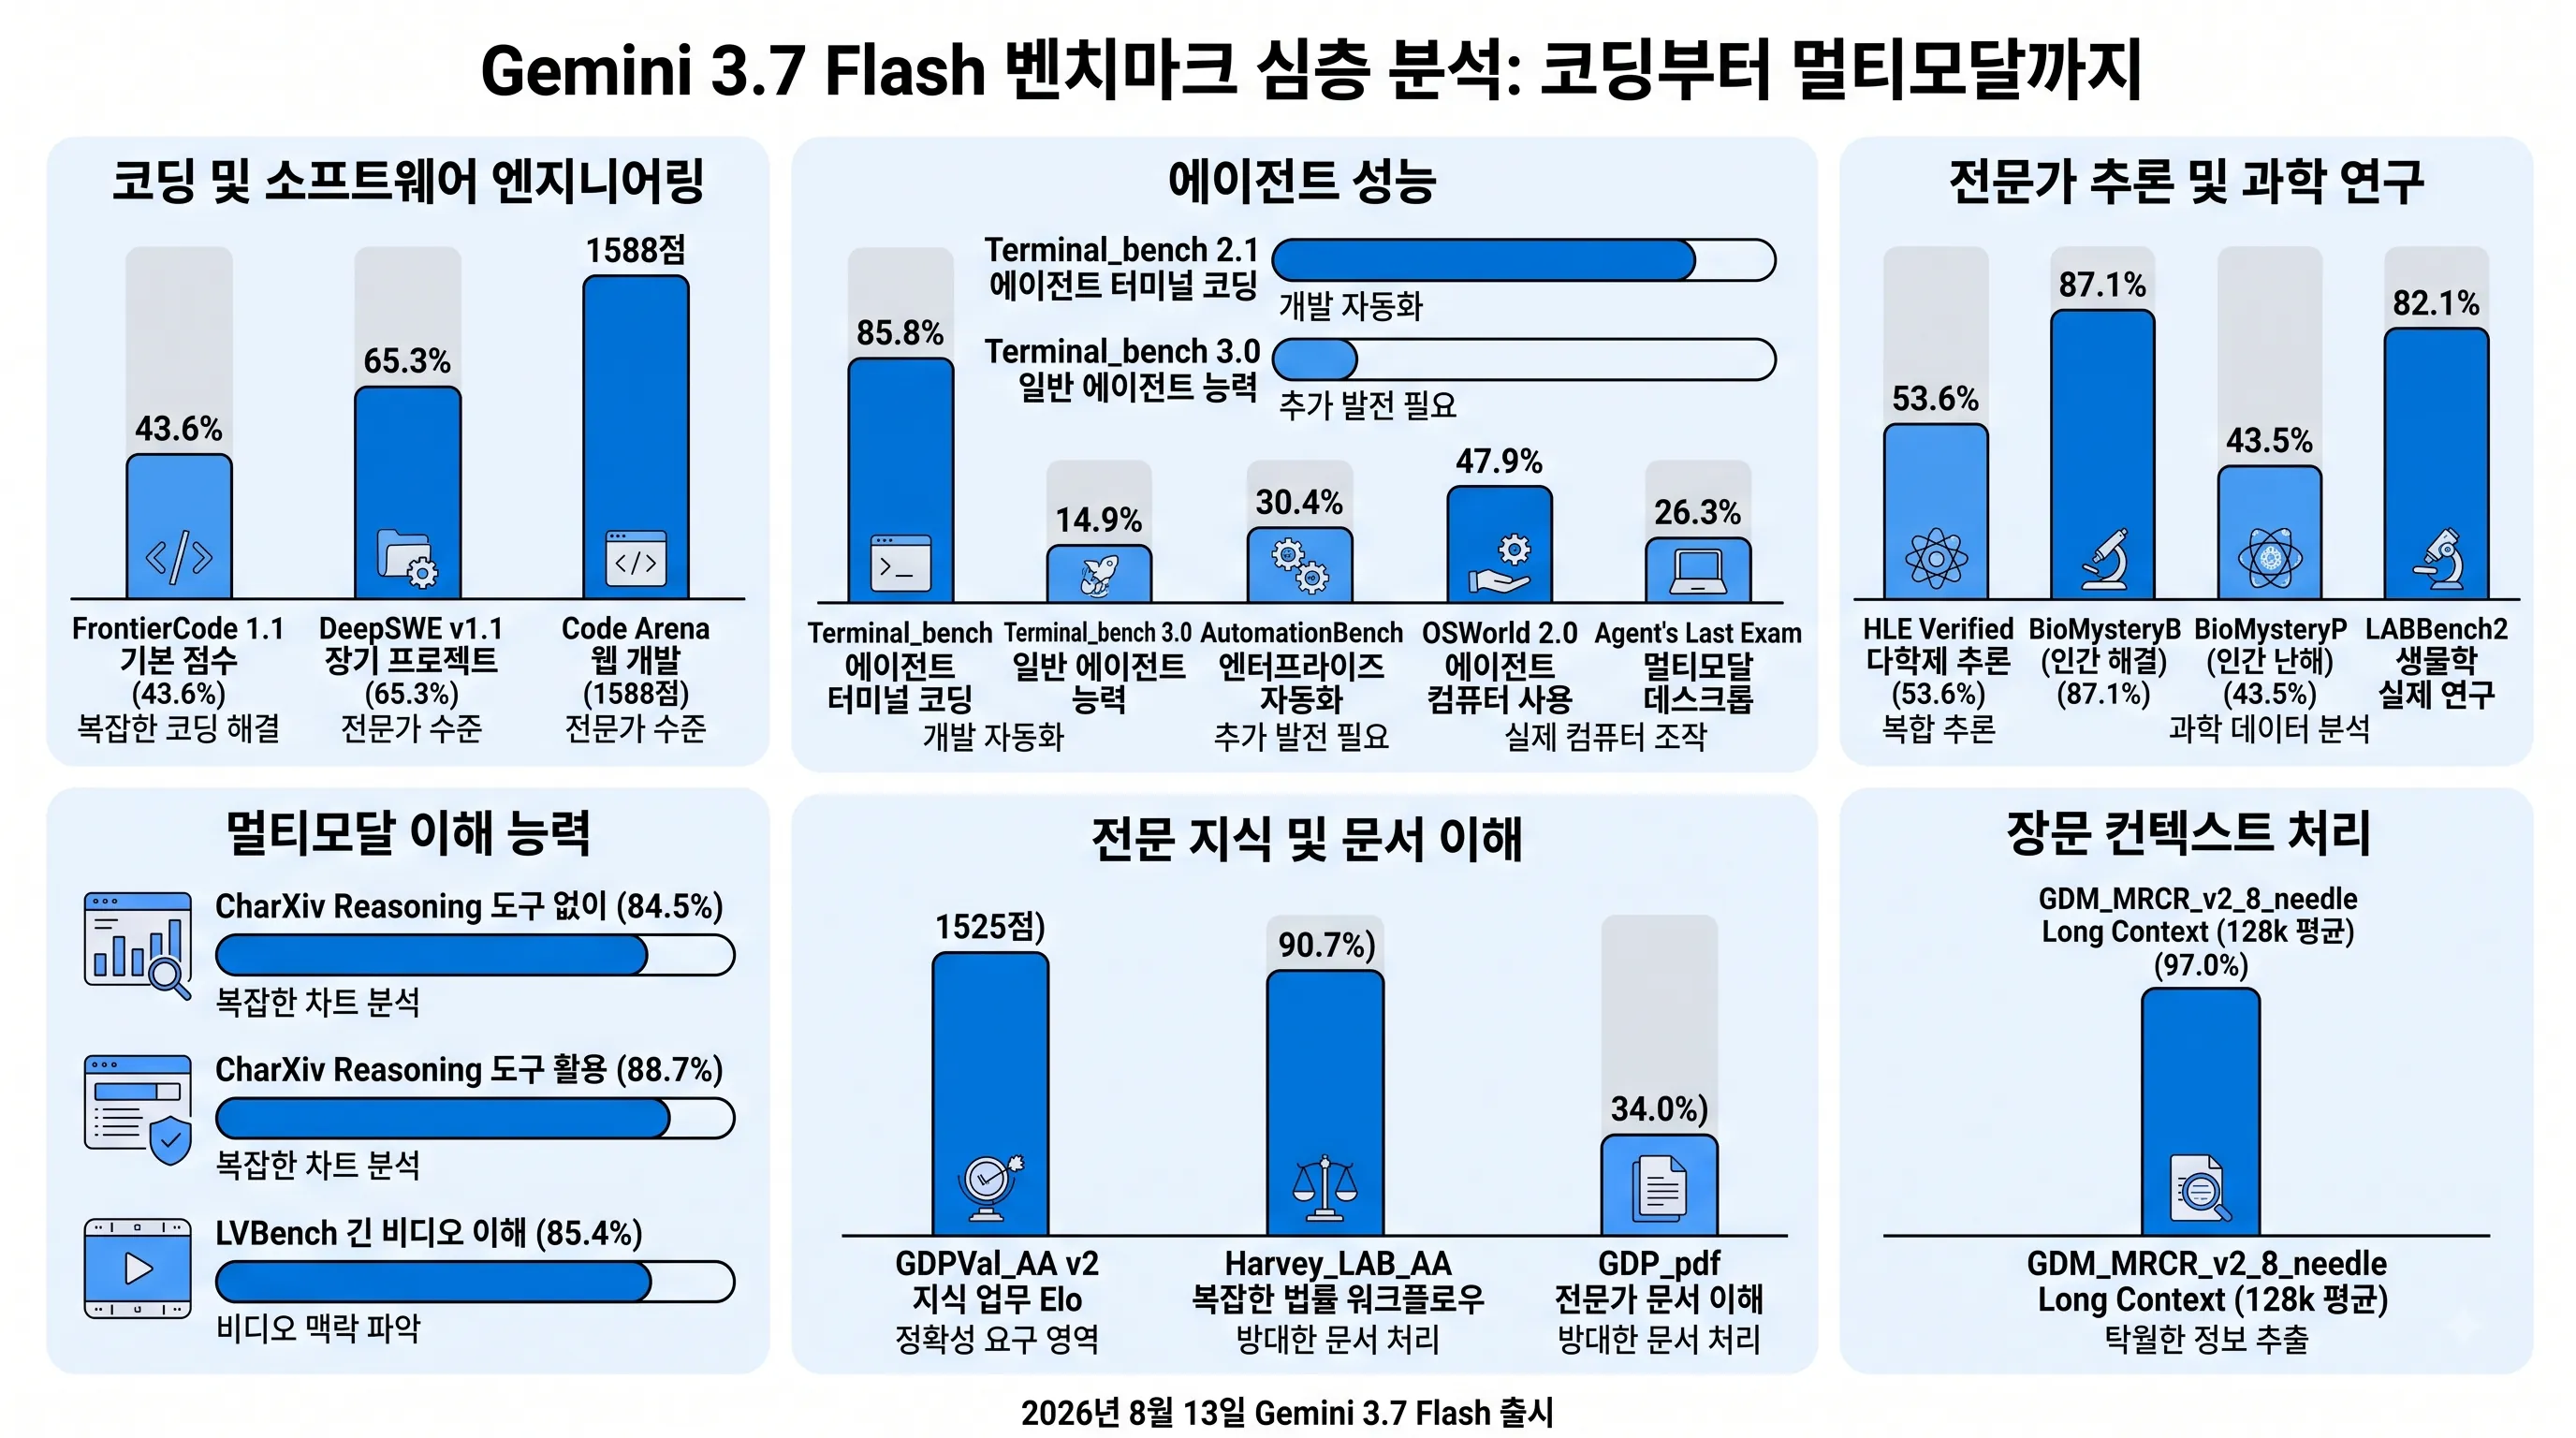
특히, 최신 코딩 능력을 측정하는 FrontierCode 1.1 Main Score에서 43.6%를 달성했으며, 이는 복잡한 코딩 과제를 해결하는 데 필요한 모델의 기본 역량을 잘 보여줍니다.
또한, 장기적인 관점에서 소프트웨어 엔지니어링 프로젝트를 평가하는 DeepSWE v1.1 Long-horizon Software Engineering 벤치마크에서는 65.3%라는 높은 점수를 기록했습니다.
이는 단순히 코드를 생성하는 것을 넘어, 실제 소프트웨어 개발 라이프사이클에서 요구되는 복합적인 문제 해결 능력을 갖추고 있음을 시사합니다.
웹 개발 분야에서도 Gemini 3.7 Flash의 역량은 빛을 발합니다.
Code Arena Web Development Elo 벤치마크에서는 1588점을 획득하여, 실제 웹 개발 환경에서의 코드 작성 및 디버깅 능력이 전문가 수준에 근접함을 객관적으로 증명했습니다.
이러한 수치들은 Gemini 3.7 Flash가 개발자들의 생산성을 획기적으로 향상시킬 수 있는 강력한 코딩 파트너가 될 수 있음을 의미합니다.
| 벤치마크명 | 점수 | 영역 |
|---|---|---|
| FrontierCode 1.1 Main Score | 43.6% | 코딩 및 소프트웨어 개발 |
| DeepSWE v1.1 Long-horizon Software Engineering | 65.3% | 코딩 및 소프트웨어 개발 |
| Code Arena Web Development Elo | 1588점 | 웹 개발 |
멀티모달 이해 능력: 이미지, 비디오, 차트 분석
Gemini 3.7 Flash는 텍스트를 넘어 이미지, 오디오, 비디오 파일 등 다양한 형태의 입력을 지원하는 멀티모달 능력을 자랑합니다.
특히 시각 정보 이해 부문에서 뛰어난 성능을 보였습니다.
복잡한 차트에서 정보를 추출하고 합성하는 능력을 평가하는 CharXiv Reasoning Information Synthesis from Complex Charts 벤치마크에서 도구 없이 84.5%, 도구를 활용했을 때는 88.7%의 점수를 기록했습니다.
이는 데이터 시각화 자료를 통해 인사이트를 도출하는 데 있어 Gemini 3.7 Flash의 강력한 역량을 보여주는 대목입니다.
장시간 비디오 콘텐츠를 이해하는 능력 또한 돋보입니다.
LVBench Long Video Understanding 벤치마크에서 85.4%를 달성하며, 긴 분량의 영상 내에서 핵심 정보를 파악하고 맥락을 이해하는 데 탁월한 성능을 입증했습니다.
이러한 멀티모달 이해 능력은 단순히 정보를 인식하는 것을 넘어, 복잡한 시각적 데이터를 분석하고 추론하는 고차원적인 작업에 Gemini 3.7 Flash를 활용할 수 있음을 의미합니다.
| 벤치마크명 | 점수 | 설명 |
|---|---|---|
| CharXiv Reasoning Information Synthesis from Complex Charts (도구 없이) | 84.5% | 복잡한 차트 정보 추출 및 합성 |
| CharXiv Reasoning Information Synthesis from Complex Charts (도구 활용) | 88.7% | 복잡한 차트 정보 추출 및 합성 |
| LVBench Long Video Understanding | 85.4% | 장시간 비디오 콘텐츠 이해 |
에이전트 성능 지표: 복합 작업 자동화 및 컴퓨터 사용
이번 Gemini 3.7 Flash의 벤치마크 분석에서 특히 주목할 점은 바로 에이전트(Agentic) 성능 지표들입니다.
모델이 단순한 질의응답을 넘어, 목표를 설정하고 자율적으로 복합적인 작업을 수행하는 능력을 평가하는 지표들이 대거 포함되었습니다.
터미널 환경에서 코딩 작업을 수행하는 능력을 측정하는 Terminal_bench 2.1 Agentic Terminal Coding에서는 85.8%라는 매우 높은 점수를 기록하여, 개발 및 자동화 워크플로우에서 강력한 에이전트 역할을 할 수 있음을 보여주었습니다.
그러나 일반적인 에이전트 역량을 측정하는 Terminal_bench 3.0 General Agent Capabilities에서는 14.9%, 엔터프라이즈 워크플로우 자동화를 평가하는 AutomationBench Enterprise Workflow Automation에서는 30.4%를 기록하며 아직 개선의 여지가 있음을 시사합니다.
이러한 점수들은 Gemini 3.7 Flash가 특정 영역에서는 높은 에이전트 능력을 보이지만, 보다 넓은 범위의 일반적인 에이전트 작업이나 기업 환경에서의 복잡한 자동화에는 추가적인 발전이 필요함을 나타냅니다.
컴퓨터 사용 및 멀티모달 데스크톱 작업과 관련된 에이전트 성능도 측정되었습니다.
OSWorld 2.0 Agentic Computer Use 벤치마크에서는 47.9%를 기록했으며, 이는 운영체제 환경에서 컴퓨터를 조작하고 특정 목표를 달성하는 능력을 평가합니다.
더 나아가, 멀티모달 데스크톱 및 운영체제 에이전트 작업을 종합적으로 평가하는 Agent's Last Exam Multimodal Desktop and OS Agent Tasks Pass Rate에서는 26.3%의 합격률을 보였습니다.
이 수치들은 Gemini 3.7 Flash가 실제 컴퓨터 환경에서 다양한 모달리티를 활용하여 복잡한 에이전트 작업을 수행할 잠재력을 가지고 있지만, 아직 완벽한 자율 에이전트로 기능하기 위해서는 지속적인 학습과 고도화가 필요함을 보여줍니다.
| 벤치마크명 | 점수 | 영역 |
|---|---|---|
| Terminal_bench 2.1 Agentic Terminal Coding | 85.8% | 에이전트 코딩 작업 |
| Terminal_bench 3.0 General Agent Capabilities | 14.9% | 일반 에이전트 역량 |
| AutomationBench Enterprise Workflow Automation | 30.4% | 엔터프라이즈 워크플로우 자동화 |
| OSWorld 2.0 Agentic Computer Use | 47.9% | 에이전트 컴퓨터 사용 |
| Agent's Last Exam Multimodal Desktop and OS Agent Tasks Pass Rate | 26.3% | 멀티모달 데스크톱 및 OS 에이전트 작업 |
전문 지식 작업 및 문서 이해도
Gemini 3.7 Flash는 지식 노동 및 문서 이해 분야에서도 유의미한 성능을 보였습니다.
지식 업무 능력을 평가하는 GDPVal_AA v2 Knowledge Work Elo 벤치마크에서 1525점을 획득하며, 다양한 지식 기반 작업에서 모델의 활용 가능성을 증명했습니다.
특히, 복잡한 법률 워크플로우를 처리하는 능력을 측정하는 Harvey_LAB_AA Complex Legal Workflows에서는 무려 90.7%라는 압도적인 점수를 기록했습니다.
이는 Gemini 3.7 Flash가 법률 분야와 같이 높은 정확성과 전문성이 요구되는 영역에서 상당한 기여를 할 수 있음을 강력히 시사합니다.
전문적인 문서 이해도 평가에서도 Gemini 3.7 Flash의 성능은 흥미롭습니다.
GDP_pdf Expert Document Comprehension 벤치마크에서는 34.0%를 기록했습니다.
이 수치는 대규모의 PDF 문서를 심층적으로 이해하고 핵심 정보를 추출하는 능력을 나타내며, 특히 기업 환경에서 방대한 문서를 처리해야 하는 작업에 있어 Gemini 3.7 Flash의 잠재력을 엿볼 수 있게 합니다.
| 벤치마크명 | 점수 | 영역 |
|---|---|---|
| GDPVal_AA v2 Knowledge Work Elo | 1525점 | 지식 업무 능력 |
| Harvey_LAB_AA Complex Legal Workflows | 90.7% | 복잡한 법률 워크플로우 |
| GDP_pdf Expert Document Comprehension | 34.0% | 전문가 문서 이해도 |
전문가 추론 및 과학 연구 분야 성과
Gemini 3.7 Flash는 다양한 분야의 전문 지식과 추론 능력을 요하는 벤치마크에서도 뛰어난 성과를 보여주었습니다.
다학제적인 전문가 추론 능력을 검증하는 HLE Verified Multidisciplinary Expert Reasoning 벤치마크에서 53.6%를 달성했습니다.
이는 모델이 특정 분야를 넘어 광범위한 지식 영역에서 복합적인 추론을 수행할 수 있음을 의미합니다.
생명정보학 및 생물학 연구 분야에서도 Gemini 3.7 Flash의 잠재력이 확인되었습니다.
BioMysteryBench Bioinformatics Research Reasoning 벤치마크에서는 인간이 풀 수 있는 문제(Human Solvable)에서 87.1%, 인간도 어려워하는 문제(Human Difficult)에서는 43.5%를 달성했습니다.
또한, 실제 생물학 연구 과제를 평가하는 LABBench2 Biology Real-World Research Tasks에서는 82.1%라는 높은 점수를 기록했습니다.
이러한 결과는 Gemini 3.7 Flash가 복잡한 과학 연구 데이터를 분석하고 새로운 가설을 도출하는 데 유용한 도구로 활용될 수 있음을 시사합니다.
| 벤치마크명 | 점수 | 영역 |
|---|---|---|
| HLE Verified Multidisciplinary Expert Reasoning | 53.6% | 다학제 전문가 추론 |
| BioMysteryBench Bioinformatics Research Reasoning (Human Solvable) | 87.1% | 생명정보학 연구 추론 (인간 해결 가능) |
| BioMysteryBench Bioinformatics Research Reasoning (Human Difficult) | 43.5% | 생명정보학 연구 추론 (인간 난해) |
| LABBench2 Biology Real-World Research Tasks | 82.1% | 생물학 실제 연구 과제 |
장문 컨텍스트 처리 성능
긴 문맥을 이해하고 처리하는 능력은 대규모 언어 모델의 핵심 역량 중 하나입니다.
Gemini 3.7 Flash는 GDM_MRCR_v2_8_needle Long Context Performance 128k Avg 벤치마크에서 97.0%라는 경이로운 점수를 기록했습니다.
이는 모델이 128,000 토큰에 달하는 매우 긴 컨텍스트 내에서도 특정 정보를 정확하게 찾아내고 이해하는 능력이 탁월함을 의미합니다.
방대한 문서나 긴 대화 기록에서 필요한 정보를 추출하거나 요약하는 작업에서 Gemini 3.7 Flash는 사용자에게 높은 만족도를 제공할 것으로 기대됩니다.
| 벤치마크명 | 점수 | 영역 |
|---|---|---|
| GDM_MRCR_v2_8_needle Long Context Performance 128k Avg | 97.0% | 장문 컨텍스트 처리 |
3. 실무 활용 가이드: 에이전트 및 기업 워크플로우 자동화
생산성 혁신의 핵심: Gemini 3.7 Flash의 등장
어제인 2026년 8월 13일, 구글의 새로운 모델인 Gemini 3.7 Flash가 공식 출시되었습니다.
이 모델은 기존 Gemini 3.6 Flash의 후속작으로, Gemini 3 모델 제품군의 차세대 반복을 대표합니다.
특히, 핵심 추론 기반의 알고리즘 개선을 통해 Gemini 3.6 Flash 대비 인공 분석 지능 지수(Artificial Analysis Intelligence Index)에서 4점 향상된 56점을 기록하며, '가장 지능적인 워크호스 모델'이라는 평가를 받고 있습니다.
이는 단순히 지능을 넘어 '행동과 지능의 결합'을 목표로 하며, 복잡한 실무 환경에서 목표를 관리 가능한 단계로 세분화하고 다양한 애플리케이션을 연결하는 데 탁월한 성능을 발휘하도록 설계되었습니다.
오늘(2026년 8월 14일)부터 Gemini App - Spark, Gemini Enterprise App, Google AI Studio 등 다양한 채널을 통해 이 강력한 AI를 접할 수 있게 되었습니다.
에이전트 워크플로우 자동화의 새로운 지평
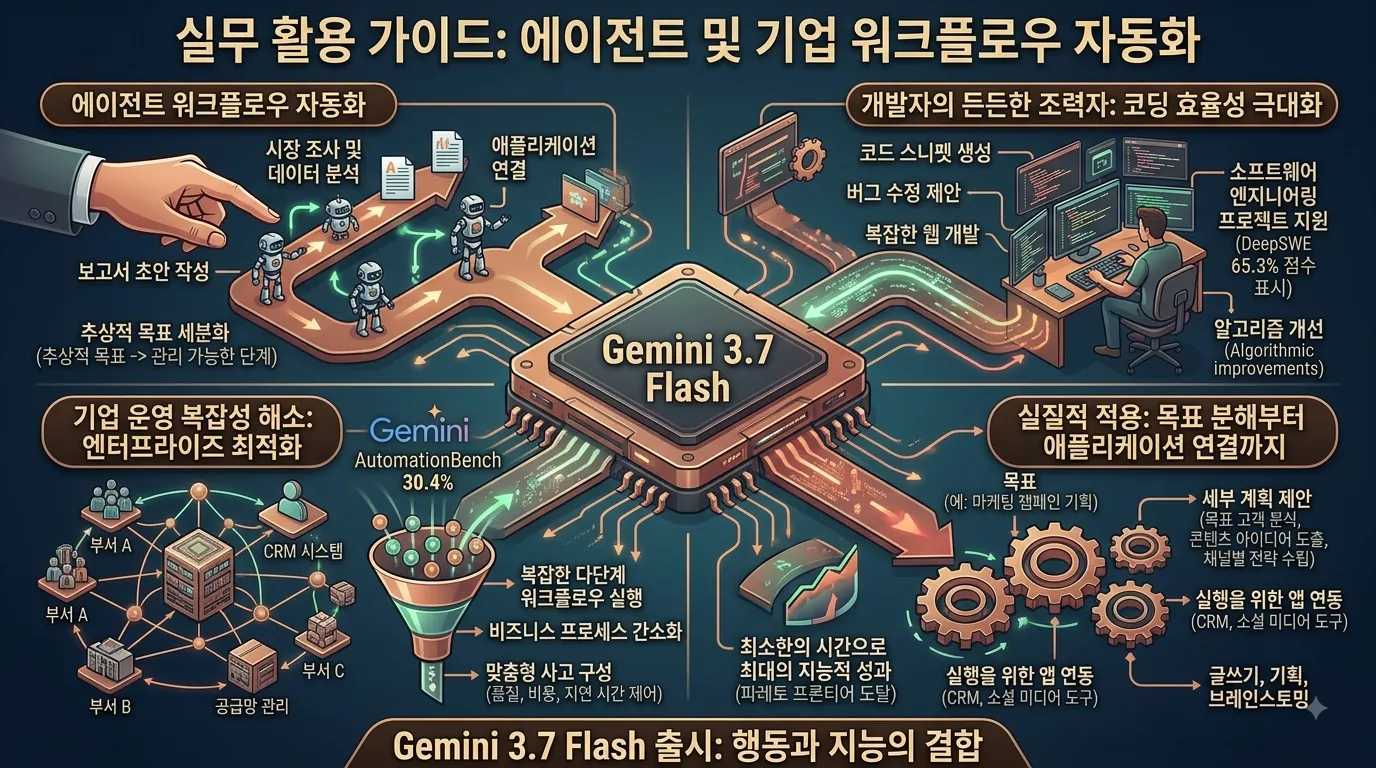
Gemini 3.7 Flash는 특히 '에이전트 워크플로우' 분야에서 혁신적인 실무 활용 가이드를 제시합니다.
에이전트 워크플로우는 복잡한 작업을 자율적으로 수행하고, 목표를 달성하기 위해 여러 단계를 계획하고 실행하는 과정을 의미합니다.
이 모델은 '지능과 행동의 결합'이라는 핵심 속성을 바탕으로, 사용자가 제시하는 추상적인 목표를 관리 가능한 단계로 세분화하는 데 탁월한 능력을 보여줍니다.
예를 들어, 특정 프로젝트 계획 수립이라는 목표가 주어졌을 때, Gemini 3.7 Flash는 시장 조사, 데이터 분석, 보고서 초안 작성, 피드백 반영 등 구체적인 작업 흐름을 자동으로 구성하고 실행할 수 있도록 지원합니다.
이는 향상된 자연어 이해 능력(Enhanced natural language understanding)과 더불어, '원하는 작업을 더욱 성공적으로 처리하는(More successfully handles desired tasks)' 능력을 통해 가능합니다.
구체적으로, Terminal_bench_2_1_Agentic_Terminal_Coding 벤치마크에서 85.8%라는 높은 점수를 기록하며 터미널 환경에서의 에이전트 코딩 작업 지원 능력을 입증했습니다.
또한, 다양한 애플리케이션과의 연결성(Connecting applications)을 통해 정보 수집부터 최종 보고서 생성까지, 여러 시스템을 넘나드는 에이전트의 업무 수행을 매끄럽게 지원합니다.
개발자의 든든한 조력자: 코딩 작업의 효율성 극대화
개발자들에게 Gemini 3.7 Flash는 코딩 작업의 효율성을 극대화하는 강력한 도구가 될 것입니다.
이 모델은 '코딩 작업(Coding tasks)'을 주요 활용 사례 중 하나로 명시하고 있으며, 이미 여러 벤치마크에서 그 역량을 입증했습니다.
예를 들어, DeepSWE_v1_1_Long_horizon_Software_Engineering 벤치마크에서 65.3%, FrontierCode_1_1_Main_Score에서 43.6%를 기록했으며, 웹 개발 분야의 Code_Arena_Web_Development_Elo 점수도 1588점에 달합니다.
이는 단순한 코드 생성 보조를 넘어, 장기적인 소프트웨어 엔지니어링 프로젝트와 복잡한 웹 개발 환경에서 개발자를 효과적으로 지원할 수 있음을 의미합니다.
개발자는 Gemini 3.7 Flash를 활용하여 코드 스니펫 생성, 버그 수정 제안, 문서화, 심지어 특정 기능 구현을 위한 전체 코드 구조 설계 등 다양한 작업을 자동화하거나 가속화할 수 있습니다.
특히 '알고리즘 개선(Algorithmic improvements)'이 이루어진 덕분에, 더 복잡하고 미묘한 코딩 문제에 대한 이해도와 해결 능력이 향상되었습니다.
기업 운영의 복잡성 해소: 엔터프라이즈 워크플로우 최적화
기업 환경에서 Gemini 3.7 Flash는 복잡한 '엔터프라이즈 워크플로우(Enterprise workflows)'를 자동화하고 최적화하는 데 핵심적인 역할을 수행할 것입니다.
수많은 부서와 시스템이 얽혀 있는 기업의 운영 환경에서, Gemini 3.7 Flash는 '복잡한 다단계 워크플로우 실행(Executing complex multi-step workflows)' 능력을 통해 비즈니스 프로세스를 간소화합니다.
예를 들어, 고객 서비스 처리, 공급망 관리, 재무 보고서 작성 등 여러 단계와 다양한 애플리케이션 연동이 필요한 작업을 이 모델이 효과적으로 조율하고 실행할 수 있습니다.
AutomationBench_Enterprise_Workflow_Automation 벤치마크에서 30.4%를 기록하며, 아직 개선의 여지는 있지만 실제 기업 환경에서의 자동화 잠재력을 분명히 보여주었습니다.
특히, '품질, 비용, 지연 시간의 균형을 제어하는 맞춤형 사고 구성(Customizable thinking configurations to control quality, cost, latency mix)'을 지원한다는 점은 기업의 특정 요구사항에 맞춰 AI의 동작 방식을 유연하게 조정할 수 있음을 의미합니다.
이는 각 기업의 고유한 워크플로우와 예산, 속도 요구사항에 맞춰 최적의 AI 활용 전략을 구축할 수 있게 하여, 진정한 의미의 '지능적인 워크호스 모델(Most intelligent workhorse model)'로 기능합니다.
실질적인 적용: 목표 분해부터 애플리케이션 연결까지
Gemini 3.7 Flash의 실무 활용 가치는 '목표를 관리 가능한 단계로 세분화(Breaking down goals into manageable steps)'하고 '애플리케이션을 연결(Connecting applications)'하는 능력에서 극대화됩니다.
이는 단순히 특정 작업을 수행하는 것을 넘어, '글쓰기(Writing)', '기획(Planning)', '브레인스토밍(Brainstorming)'과 같은 지식 노동자의 핵심 업무 전반에 걸쳐 혁신을 가져옵니다.
예를 들어, 마케팅 캠페인 기획이라는 큰 목표가 있다면, Gemini 3.7 Flash는 목표 고객 분석, 콘텐츠 아이디어 도출, 채널별 배포 전략 수립 등 세부적인 계획을 제안하고, 이를 실행하기 위해 CRM 시스템, 소셜 미디어 관리 도구 등 다양한 애플리케이션과 연동될 수 있습니다.
이러한 능력은 '지능 대 작업 시간 파레토 프론티어에 도달(Reaching the Intelligence vs. Time per Task Pareto frontier)'했다는 평가와 맞물려, 사용자가 최소한의 시간과 노력으로 최대의 지능적 성과를 얻을 수 있음을 시사합니다.
결론적으로, Gemini 3.7 Flash는 향상된 지능과 행동력을 바탕으로 개인 및 기업의 복잡한 실무 워크플로우를 자동화하고, 궁극적으로 생산성을 비약적으로 향상시킬 수 있는 핵심적인 도구로 자리매김할 것입니다.
4. 가격 정책 및 API 접근성: 2026년 말까지 한시적 특별가 제공
가격 정책 및 API 접근성: 2026년 말까지 한시적 특별가 제공
2026년 8월 13일 출시된 혁신적인 AI 모델, Gemini 3.7 Flash는 현재 개발자와 기업 고객을 위해 매우 매력적인 가격 정책과 광범위한 접근 채널을 제공하고 있습니다.
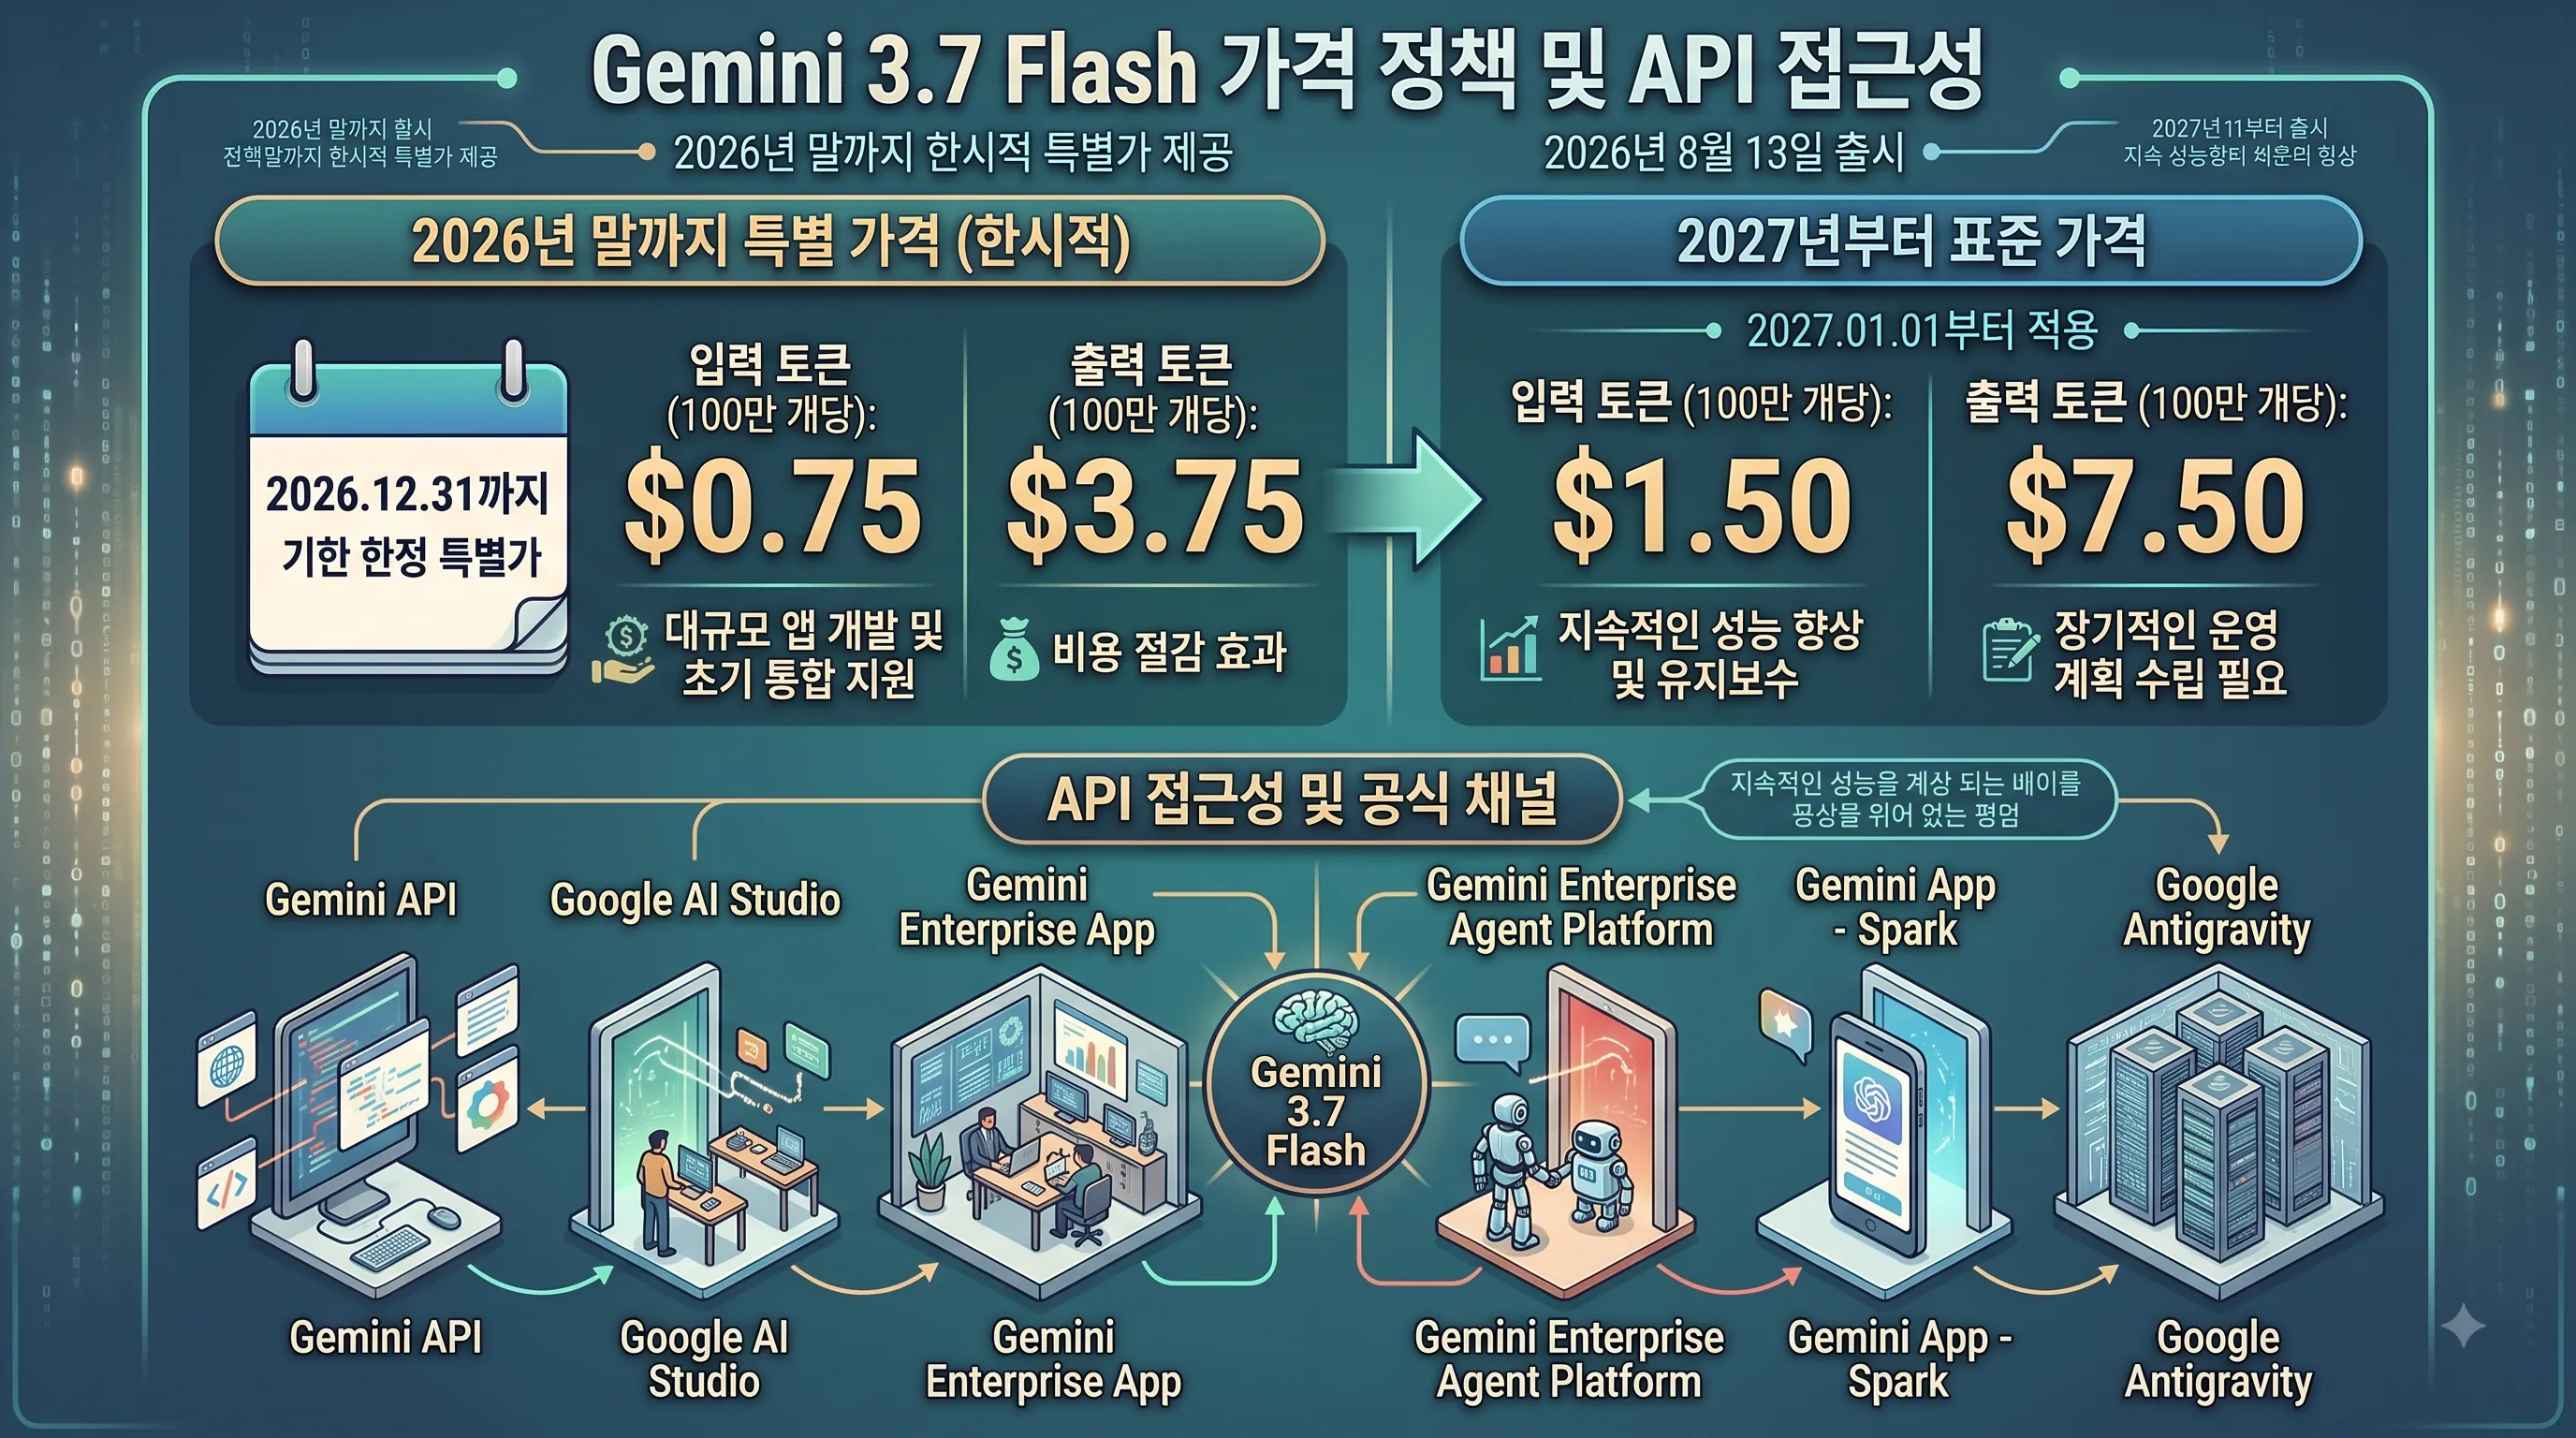
특히, 출시를 기념하여 2026년 12월 31일까지 적용되는 한시적인 특별 가격은 이 강력한 모델을 합리적인 비용으로 경험할 수 있는 절호의 기회를 제공합니다.
이후 2027년부터는 표준 가격 정책으로 전환될 예정이므로, 현재의 특별 가격은 모델 도입을 고려하는 국내 기업들에게 중요한 의사결정 요소가 될 것입니다.
2026년 말까지의 출시 기념 특별가 (한시적 제공)
Gemini 3.7 Flash는 2026년 12월 31일까지 파격적인 출시 기념 특별가로 제공됩니다.
이는 글로벌 시장의 해외 추세에 맞춰 책정된 가격으로, 입력 토큰 100만 개당 0.75달러, 출력 토큰 100만 개당 3.75달러입니다.
국내 개발자와 기업들도 이 가격으로 서비스를 이용할 수 있으며, 이는 특히 대규모 언어 모델(LLM) 기반의 애플리케이션을 개발하거나 기존 워크플로우에 AI를 통합하려는 초기 단계의 프로젝트에 큰 비용 절감 효과를 가져다줄 것입니다.
이 특별 가격은 Gemini 3.7 Flash의 뛰어난 성능과 효율성을 고려할 때, 시장에서 찾아보기 힘든 경쟁력 있는 조건으로 평가됩니다.
다시 강조하지만, 이 가격은 2026년 12월 31일까지만 유효하므로, 현재 서비스를 도입하거나 확장하려는 기업들은 이 기회를 적극적으로 활용하는 것이 현명합니다.
2027년부터 적용될 표준 가격 정책
현재의 특별 가격 기간이 종료되는 2027년 1월 1일부터는 Gemini 3.7 Flash의 표준 가격 정책이 적용됩니다.
표준 가격은 입력 토큰 100만 개당 1.50달러, 출력 토큰 100만 개당 7.50달러로 책정됩니다.
이는 특별 가격 대비 약 두 배 가량 높은 수준이지만, 모델의 지속적인 성능 향상과 유지보수, 그리고 장기적인 서비스 지원을 고려할 때 여전히 경쟁력 있는 가격대입니다.
국내 기업들은 내년부터 적용될 이 표준 가격을 염두에 두고 장기적인 AI 도입 및 운영 계획을 수립해야 할 것입니다.
초기 진입 장벽을 낮추기 위한 특별 가격과 안정적인 서비스 제공을 위한 표준 가격 간의 명확한 구분을 통해, 사용자들은 도입 시기와 비용 효율성을 전략적으로 판단할 수 있습니다.
| 구분 | 입력 토큰 (100만 개당) | 출력 토큰 (100만 개당) | 적용 기간 |
|---|---|---|---|
| 도입 가격 | $0.75 | $3.75 | ~ 2026년 12월 31일 |
| 표준 가격 | $1.50 | $7.50 | 2027년 1월 1일 ~ |
개발자와 기업을 위한 API 접근성 및 공식 채널
Gemini 3.7 Flash는 다양한 공식 채널을 통해 개발자와 기업에게 폭넓게 제공되어 접근성을 극대화하고 있습니다.
주요 접근 채널로는 Gemini API가 있어, 개발자들이 자신들의 애플리케이션에 Gemini 3.7 Flash의 강력한 기능을 직접 통합할 수 있도록 지원합니다.
이를 통해 맞춤형 AI 솔루션 및 서비스를 구축하는 것이 매우 용이합니다.
또한, Google AI Studio는 코드 없이도 AI 모델을 실험하고 프로토타이핑할 수 있는 직관적인 환경을 제공하여, 비개발 직군이나 빠르게 아이디어를 구현하고자 하는 사용자들에게 특히 유용합니다.
기업 고객들을 위한 전용 플랫폼도 마련되어 있습니다.
Gemini Enterprise App과 Gemini Enterprise Agent Platform은 기업 환경에서 AI를 보다 안전하고 효율적으로 활용할 수 있도록 설계되었으며, 복잡한 비즈니스 워크플로우 자동화 및 에이전트 구축에 최적화된 기능을 제공합니다.
이 외에도 일반 사용자용 애플리케이션인 Gemini App - Spark와 구글의 차세대 기술 인프라인 Google Antigravity를 통해서도 모델의 역량을 간접적 또는 직접적으로 경험하고 활용할 수 있습니다.
이러한 다각적인 채널 지원은 국내 모든 규모의 기업과 개발팀이 Gemini 3.7 Flash를 각자의 필요에 맞춰 유연하게 도입하고 활용할 수 있도록 보장합니다.
5. 명시된 한계와 안전성 평가: 할루시네이션 및 사이버 보안 점검 결과
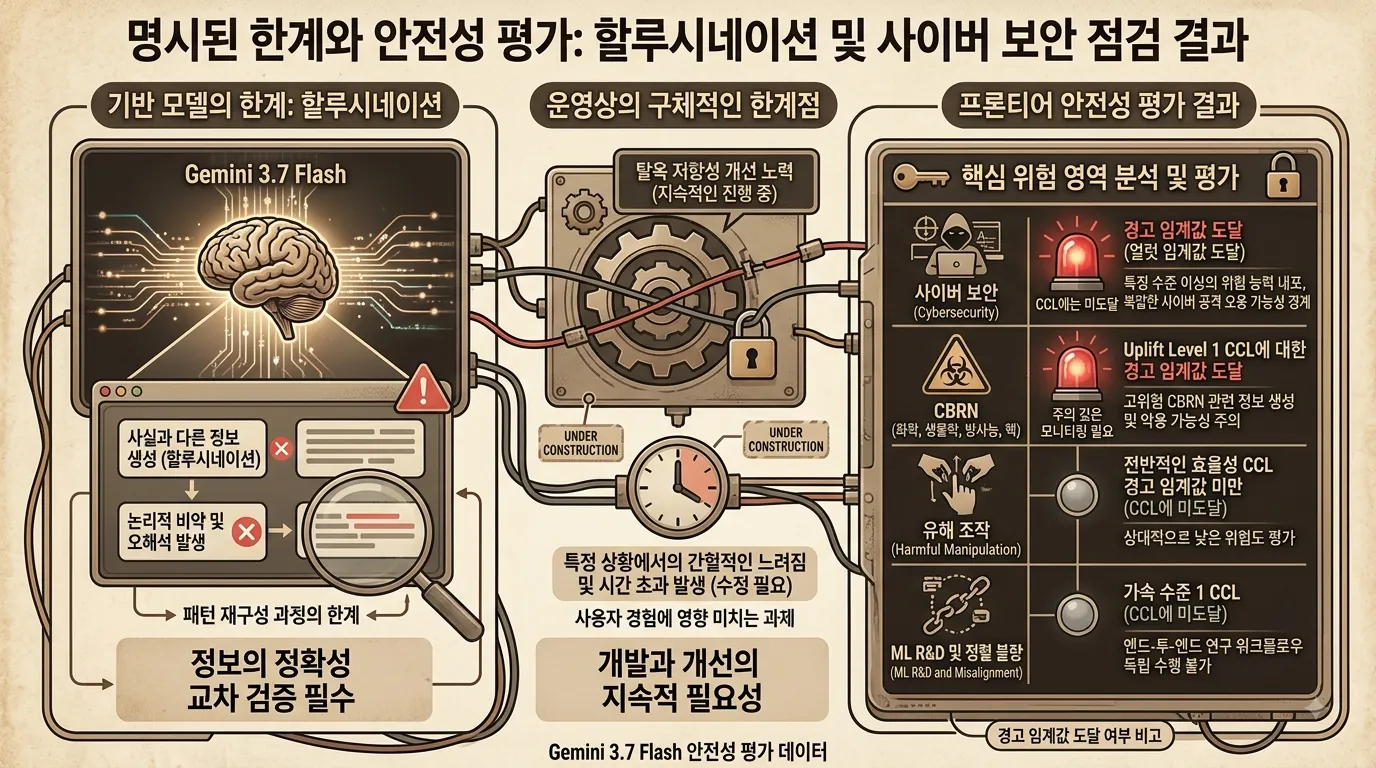
일반적인 기반 모델의 한계: 할루시네이션
Gemini 3.7 Flash는 전반적으로 향상된 성능을 제공하지만, 여전히 모든 기반 모델이 공통적으로 안고 있는 근본적인 한계에서 완전히 자유롭지 않습니다.
특히, 모델이 사실과 다른 정보를 생성하는 현상인 '할루시네이션(Hallucinations)'은 Gemini 3.7 Flash에서도 여전히 관찰될 수 있는 문제입니다.
이는 AI가 학습된 데이터 내에서 패턴을 재구성하는 과정에서 논리적 비약이나 오해석을 일으킬 수 있기 때문입니다.
따라서 사용자는 모델이 제공하는 정보의 정확성을 항상 교차 검증할 필요가 있습니다.
운영상의 구체적인 한계점: 탈옥 저항성 및 성능
Gemini 3.7 Flash는 출시일인 2026년 8월 13일 이후에도 운영상 개선이 필요한 몇 가지 한계를 명시하고 있습니다.
그중 하나는 '탈옥 저항성(jailbreak resistance) 개선 노력'이 지속적으로 진행 중이라는 점입니다.
이는 사용자가 모델의 안전장치를 우회하여 의도치 않거나 유해한 출력을 유도하려는 시도에 대해 모델이 더욱 견고하게 방어할 수 있도록 끊임없이 연구하고 있음을 의미합니다.
또한, 특정 상황에서는 간헐적인 느려짐(slowness)이나 시간 초과(timeout) 문제가 발생할 수 있다고 밝히고 있으며, 이는 사용자 경험에 영향을 미칠 수 있는 운영상의 과제로 남아 있습니다.
이러한 한계점들은 모델의 안정성과 신뢰성을 더욱 높이기 위한 지속적인 개발과 개선의 필요성을 강조합니다.
프론티어 안전성 평가 결과: 핵심 위험 영역 분석
모델의 안전성 평가 결과는 Gemini 3.7 Flash의 잠재적 위험 수준을 투명하게 보여줍니다.
특히 사이버 보안(Cybersecurity) 영역에서는 '경고 임계값 도달(alert threshold reached)' 상태가 확인되었습니다.
이는 Gemini 3 모델군이 Catastrophic Capability Level(CCL)에는 도달하지 않았지만, 특정 수준 이상의 위험 능력에 대한 경고 임계값을 넘어서는 잠재적 위험을 내포하고 있음을 의미합니다.
즉, 모델이 복잡한 사이버 공격 시나리오에서 오용될 가능성이나 취약점을 생성할 가능성에 대해 높은 경계가 필요하다는 신호로 해석됩니다.
이와 유사하게 CBRN(화학, 생물학, 방사능, 핵) 영역에서도 Uplift Level 1 CCL에 대한 경고 임계값이 도달한 것으로 나타났습니다.
이는 모델이 고위험 CBRN 관련 정보 생성이나 악용 가능성에 대해 주의 깊은 모니터링이 필요함을 시사합니다.
반면, 유해 조작(Harmful Manipulation) 영역에서는 전반적인 효율성이 CCL 경고 임계값 미만으로 평가되어 상대적으로 낮은 위험도를 보였습니다.
ML R&D 및 정렬 불량(ML R&D and Misalignment) 영역의 '가속 수준 1 CCL(Acceleration Level 1 CCL)' 역시 모델이 엔드-투-엔드 연구 워크플로우를 독립적으로 수행할 수준에 미치지 못하여 CCL에 도달하지 않은 것으로 평가되었습니다.
이러한 상세한 안전성 평가는 Gemini 3.7 Flash의 강력한 성능과 함께 잠재적인 위험 요소를 명확히 인지하고 관리하기 위한 중요한 지표가 됩니다.
| 위험 영역 | 평가 결과 | CCL 경고 임계값 도달 여부 | 비고 |
|---|---|---|---|
| 사이버 보안 (Cybersecurity) | 경고 임계값 도달 | 도달 | 특정 수준 이상의 위험 능력 내포 |
| CBRN | Uplift Level 1 CCL에 대한 경고 임계값 도달 | 도달 | 고위험 CBRN 관련 정보 생성/악용 가능성 주의 |
| 유해 조작 (Harmful Manipulation) | 전반적인 효율성 CCL 경고 임계값 미만 | 미도달 | 상대적으로 낮은 위험도 |
| ML R&D 및 정렬 불량 (ML R&D and Misalignment) | 가속 수준 1 CCL (CCL에 미도달) | 미도달 | 엔드-투-엔드 연구 워크플로우 독립 수행 불가 |
관련 글