AI의 자신만만한 거짓말 잡는 법: 3사 모델 교차 검증(LLM Consensus) 파이프라인
- 단일 모델의 환각 한계를 극복하는 다중 에이전트 토론 및 교차 검증(LLM Consensus)을 통해 생성 결과의 사실성과 추론 정확도를 대폭 향상할 수 있습니다.
- OpenAI, Anthropic, Google 3사 모델을 병렬 연동하여 다수결 및 만장일치 기반으로 신뢰도를 자동 산출하는 파이프라인을 구축합니다.
- LangGraph 및 LangChain 런타임 프레임워크를 활용해 상태 관리와 결정론적 제어가 결합된 고신뢰성 팩트체크 아키텍처를 완성합니다.
생성형 AI가 매우 유창하고 당당하게 오답을 내놓는 할루시네이션(환각 현상)은 프로덕션 환경에서 서비스 신뢰도를 저해하는 치명적인 문제입니다.
단일 모델 프롬프팅이나 단순 자체 반성(Reflection) 방식만으로는 모델 내부에 고착된 편향과 지식 오류를 완벽하게 교정하기 어렵습니다.
이러한 한계를 극복하기 위해 서로 다른 아키텍처를 지닌 이종 모델 간 교차 검증(Multi-Model Consensus) 메커니즘이 필수적인 대안으로 부상하고 있습니다.
다중 모델의 집단 지성과 토론 과정을 거치면 불확실한 정보가 필터링되어 단일 에이전트 대비 환각률을 획기적으로 낮출 수 있습니다.
본 글에서는 주요 3사 LLM을 병렬로 연계해 다수결 합의를 도출하고 팩트를 엄격하게 검증하는 오케스트레이션 파이프라인 설계 및 구현 전략을 상세히 살펴봅니다.
1. 단일 모델의 한계와 다중 토론·합의(Consensus) 기반 환각 검증 성능
벤치마크 및 프로덕션 환경의 환각률 개선 수치
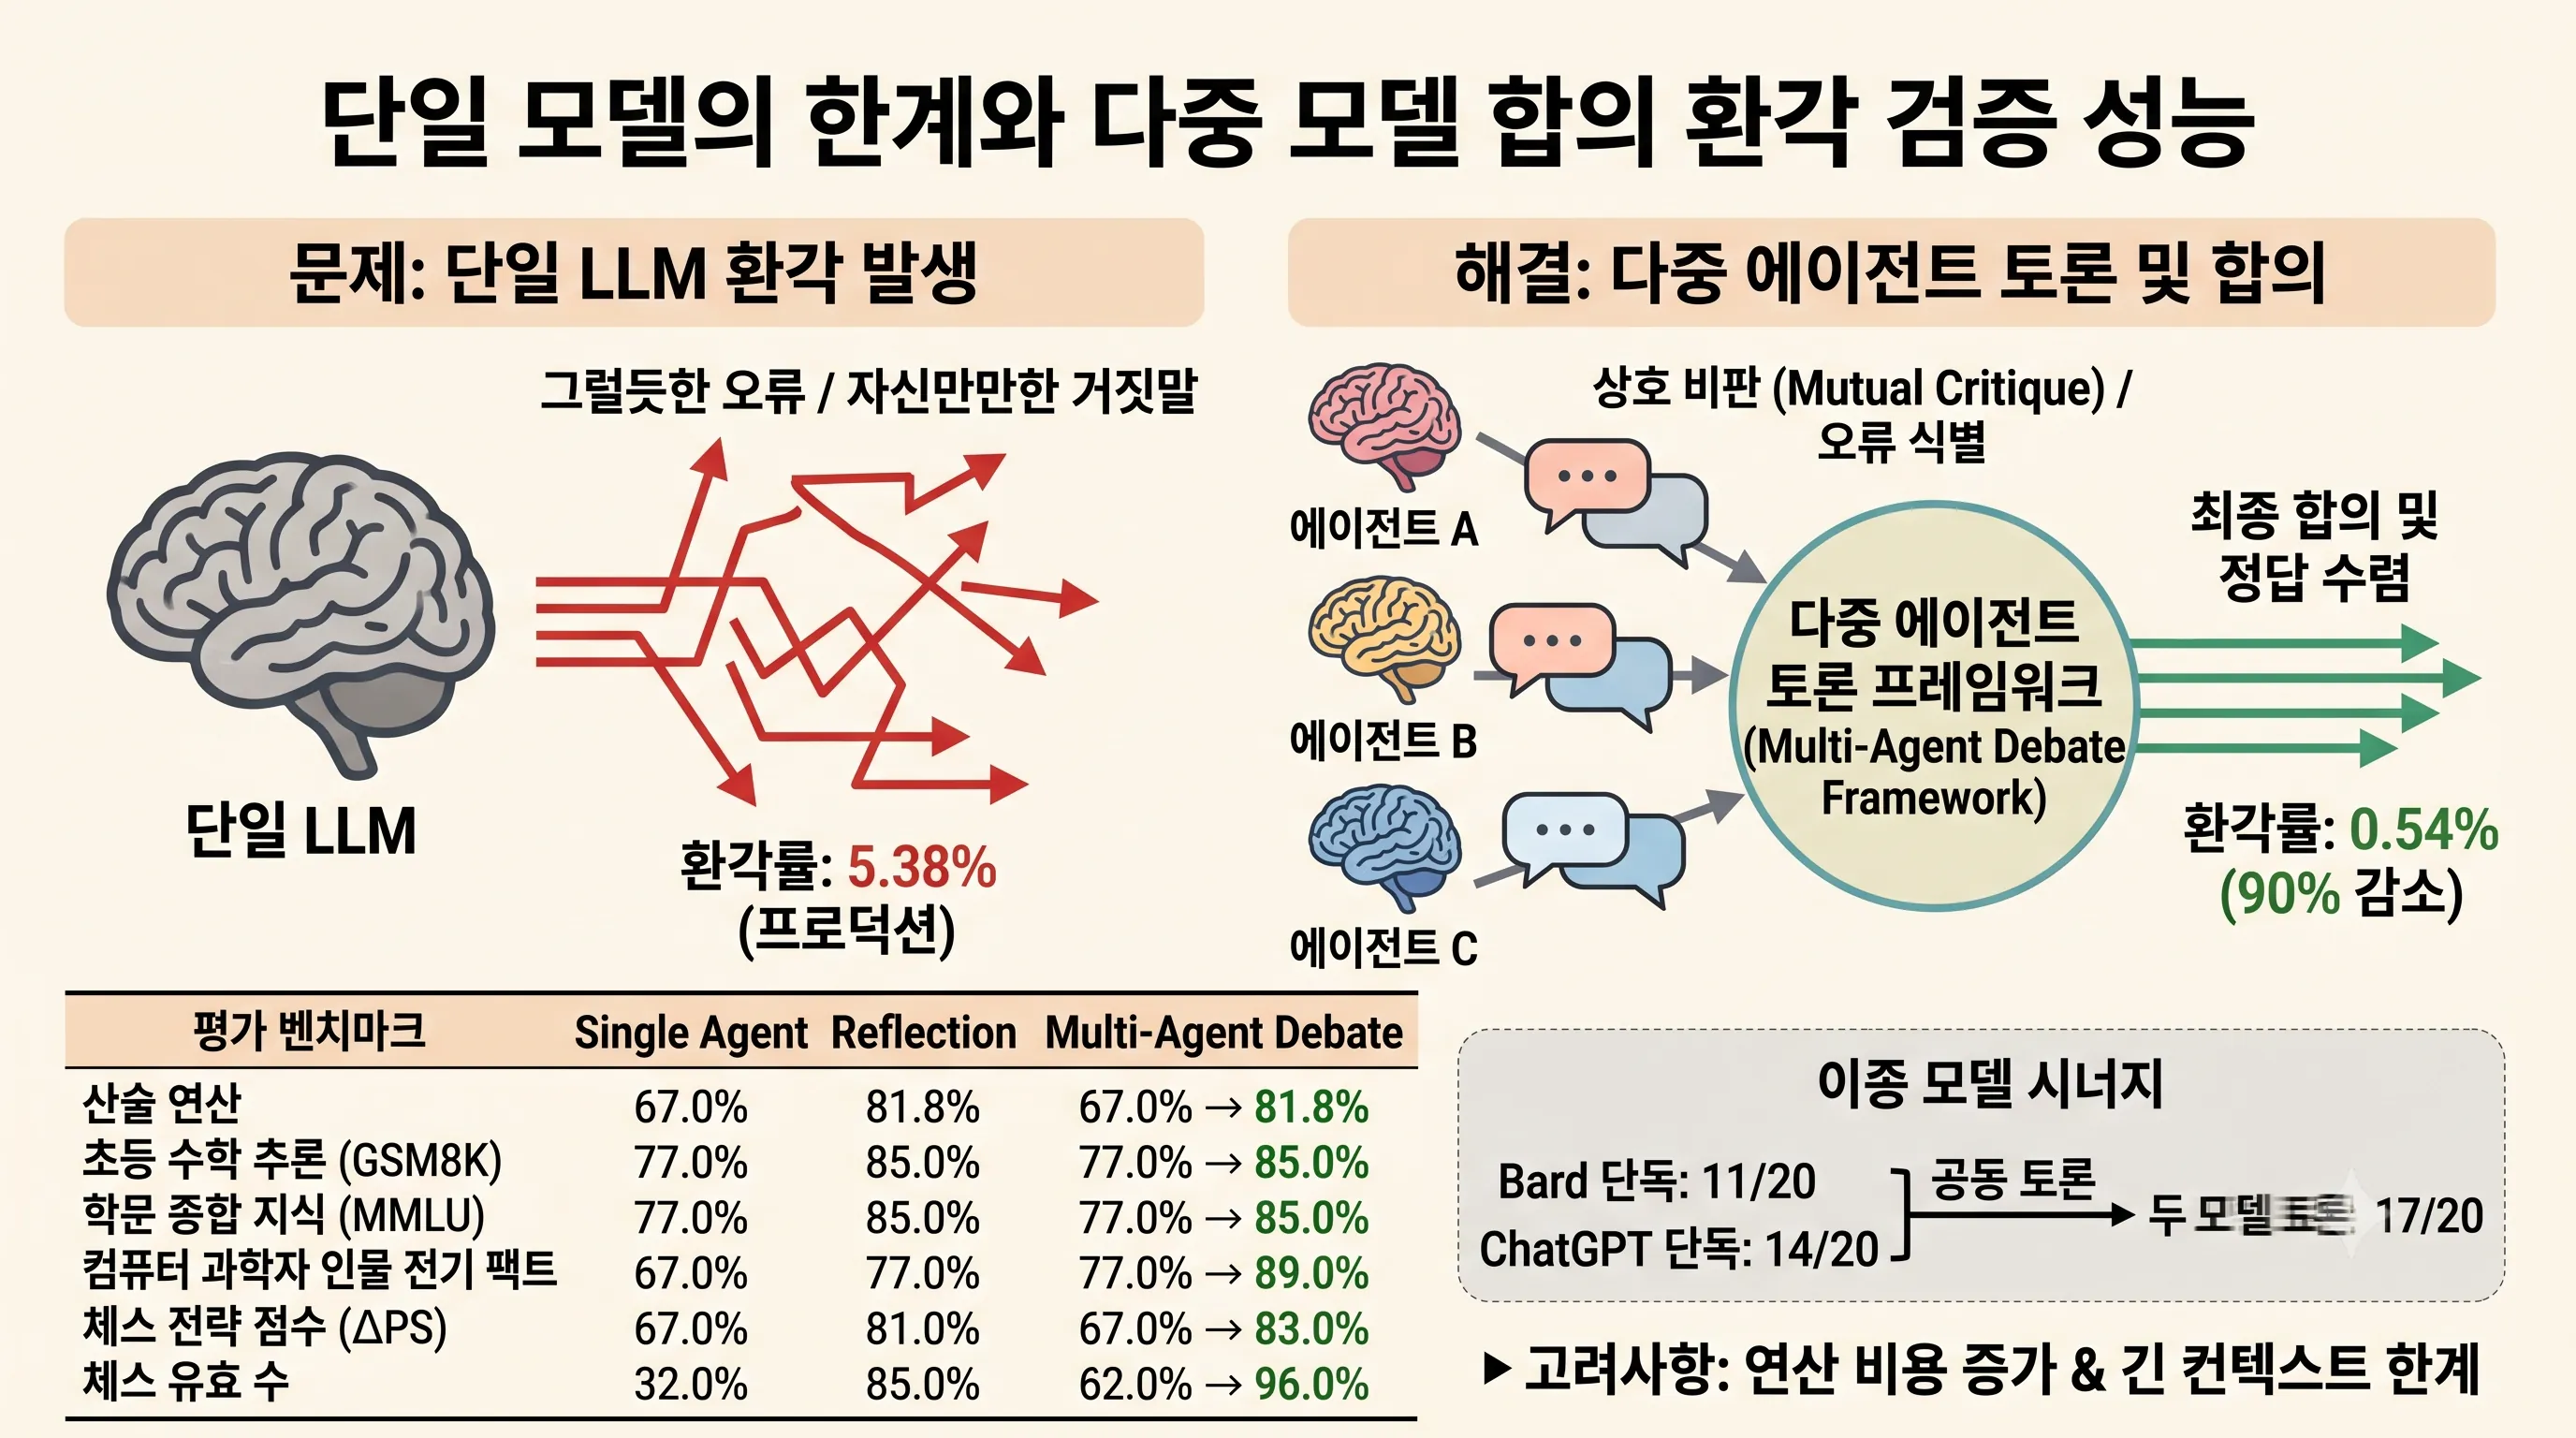
단일 거대언어모델(LLM)이 생성하는 그럴듯한 오류와 자신만만한 거짓말을 해결하기 위한 방법론으로 다중 에이전트 토론(Multi-Agent Debate) 프레임워크가 주목받아 왔습니다.
논문 arXiv:2305.14325v1(Improving Factuality and Reasoning in Language Models through Multiagent Debate)에 수록된 벤치마크 평가 결과에 따르면, 다중 모델의 상호 검증 구조는 기존 단일 에이전트(Single Agent)나 자기 성찰(Reflection), 단순 다수결(Majority Voting) 방식을 모든 영역에서 뛰어넘는 정확도를 입증했습니다.
산술 연산(Arithmetic) 작업에서 단일 에이전트 정확도는 67.0%, 자기 성찰은 72.1%, 다수결은 69.0%에 머물렀으나, 다중 에이전트 토론 방식을 도입했을 때는 정확도 81.8%로 대폭 상승했습니다.
초등 수학 추론 벤치마크인 GSM8K에서도 단일 에이전트 77.0%, 자기 성찰 75.0%, 다수결 81.0%였던 성능이 다중 에이전트 토론을 거치며 85.0%까지 향상되었습니다.
추론 복잡도가 높은 고난도 도메인과 팩트 체크 영역에서도 동일한 개선 경향이 명확히 관측되었습니다.
방대한 학문 지식을 평가하는 MMLU 벤치마크의 경우 단일 에이전트는 63.9%, 자기 성찰은 57.7%의 낮은 정답률을 보였으나, 다중 에이전트 토론 적용 시 71.1%로 상승했고 페르소나 프롬프트를 결합했을 때는 74.2%까지 정답률이 치솟았습니다.
컴퓨터 과학자 인물 전기 팩트 정확도 검증에서도 단일 에이전트(66.0%) 및 자기 성찰(68.3%) 대비 다중 에이전트 토론은 73.8%의 사실 정확도를 기록했습니다.
체스 규칙 및 전략 평가에서도 체스 유효 수(Chess Move Validity) 정확도가 단일 에이전트 29.3%에서 토론 기반 45.2%로 올랐으며, 전략 점수(ΔPS) 역시 단일 모델의 91.4점에서 다중 에이전트 토론 적용 시 122.9점으로 크게 향상되었습니다.
| 평가 벤치마크 및 작업 항목 | Single Agent | Reflection (자기 성찰) | Majority Voting (다수결) | Multi-Agent Debate |
|---|---|---|---|---|
| 산술 연산 (Arithmetic) | 67.0% | 72.1% | 69.0% | 81.8% |
| 초등 수학 추론 (GSM8K) | 77.0% | 75.0% | 81.0% | 85.0% |
| 학문 종합 지식 (MMLU) | 63.9% | 57.7% | - | 71.1% (페르소나 적용 74.2%) |
| 컴퓨터 과학자 인물 전기 팩트 | 66.0% | 68.3% | - | 73.8% |
| 체스 전략 점수 (ΔPS) | 91.4 | 102.1 | 102.2 | 122.9 |
| 체스 유효 수 (Move Validity) | 29.3% | 38.8% | - | 45.2% |
이러한 토론 및 합의 메커니즘은 단일 벤더 내부 모델뿐만 아니라 이종 모델 간의 상호 작용에서도 강력한 시너지를 발휘했습니다.
GSM8K 20개 문제를 대상으로 진행된 이종 모델 토론 실험에서 Bard 단독 처리 시 11개, ChatGPT 단독 처리 시 14개를 맞히는 데 그쳤으나, 두 모델이 공동 토론을 수행하자 17개 문제를 해결하며 개별 모델의 지식 한계를 상호 보완했습니다.
실제 372회에 걸쳐 수행된 프로덕션 환경 테스트에서도 다중 모델 합의(Consensus) 파이프라인을 도입한 결과 기존 5.38%에 달하던 환각률이 0.54%로 90% 급감하는 성과가 확인되었습니다.
다양한 합의 기반 접근법(Consensus-based approaches)을 현업 시스템에 적용한 결과 전반적인 할루시네이션 발생률이 35.9% 감소하는 등 운영 안정성이 입증되었습니다.
상호 비판을 통한 정답 수렴 메커니즘과 연산 비용 한계
다중 에이전트 토론의 가장 핵심적인 장점은 모델 내부의 가중치나 그래디언트에 접근할 필요 없이 블랙박스 언어 모델에 동일한 절차와 프롬프트 템플릿을 곧바로 적용할 수 있다는 점입니다.
이 프레임워크는 기존의 Zero-shot Chain of Thought를 비롯한 단일 프롬프팅 기법과 독립적으로 결합되어 추가적인 성능 향상을 이끌어냅니다.
특히 참여하는 모든 모델이 초기 라운드에서 제각기 오답을 제시하더라도, 라운드가 거듭되며 진행되는 상호 비판(Mutual Critique) 과정을 통해 논리적 오류를 식별하고 최종 라운드에서 올바른 정답으로 자율 수렴하는 회복력을 보여줍니다.
근거가 불확실한 정보나 환각성 주장은 에이전트 간의 불일치를 유발하며, 토론이 심화됨에 따라 자연스럽게 답변에서 제거되거나 정제됩니다.
그러나 합의 기반 검증 파이프라인이 모든 환경에서 완벽한 해결책이 되는 것은 아니며 명확한 기술적 트레이드오프가 존재합니다.
단일 에이전트 추론 대비 여러 모델이 다회차 라운드를 반복 생성해야 하므로 연산 비용(Compute Cost)의 급격한 증가가 불가피합니다.
또한 토론 라운드가 길어질수록 누적되는 토큰으로 인해 긴 컨텍스트 처리 한계가 발생할 수 있으며, 이는 초기 라운드의 핵심 논점을 요약하여 전달하는 압축 기법을 통해 완화해야 합니다.
무엇보다 모델들이 잘못된 논리나 왜곡된 정보에 대해 과도한 확신을 공유할 경우 집단적으로 오답에 합의(수렴)해 버리는 예외적인 실패 케이스가 발생할 수 있어 정교한 중재 설계가 요구됩니다.
2. OpenAI·Anthropic·Google 3사 모델 병렬 교차 검증 파이프라인 구축
3사 플래그십 모델 연동 및 RunnableParallel 병렬 질의
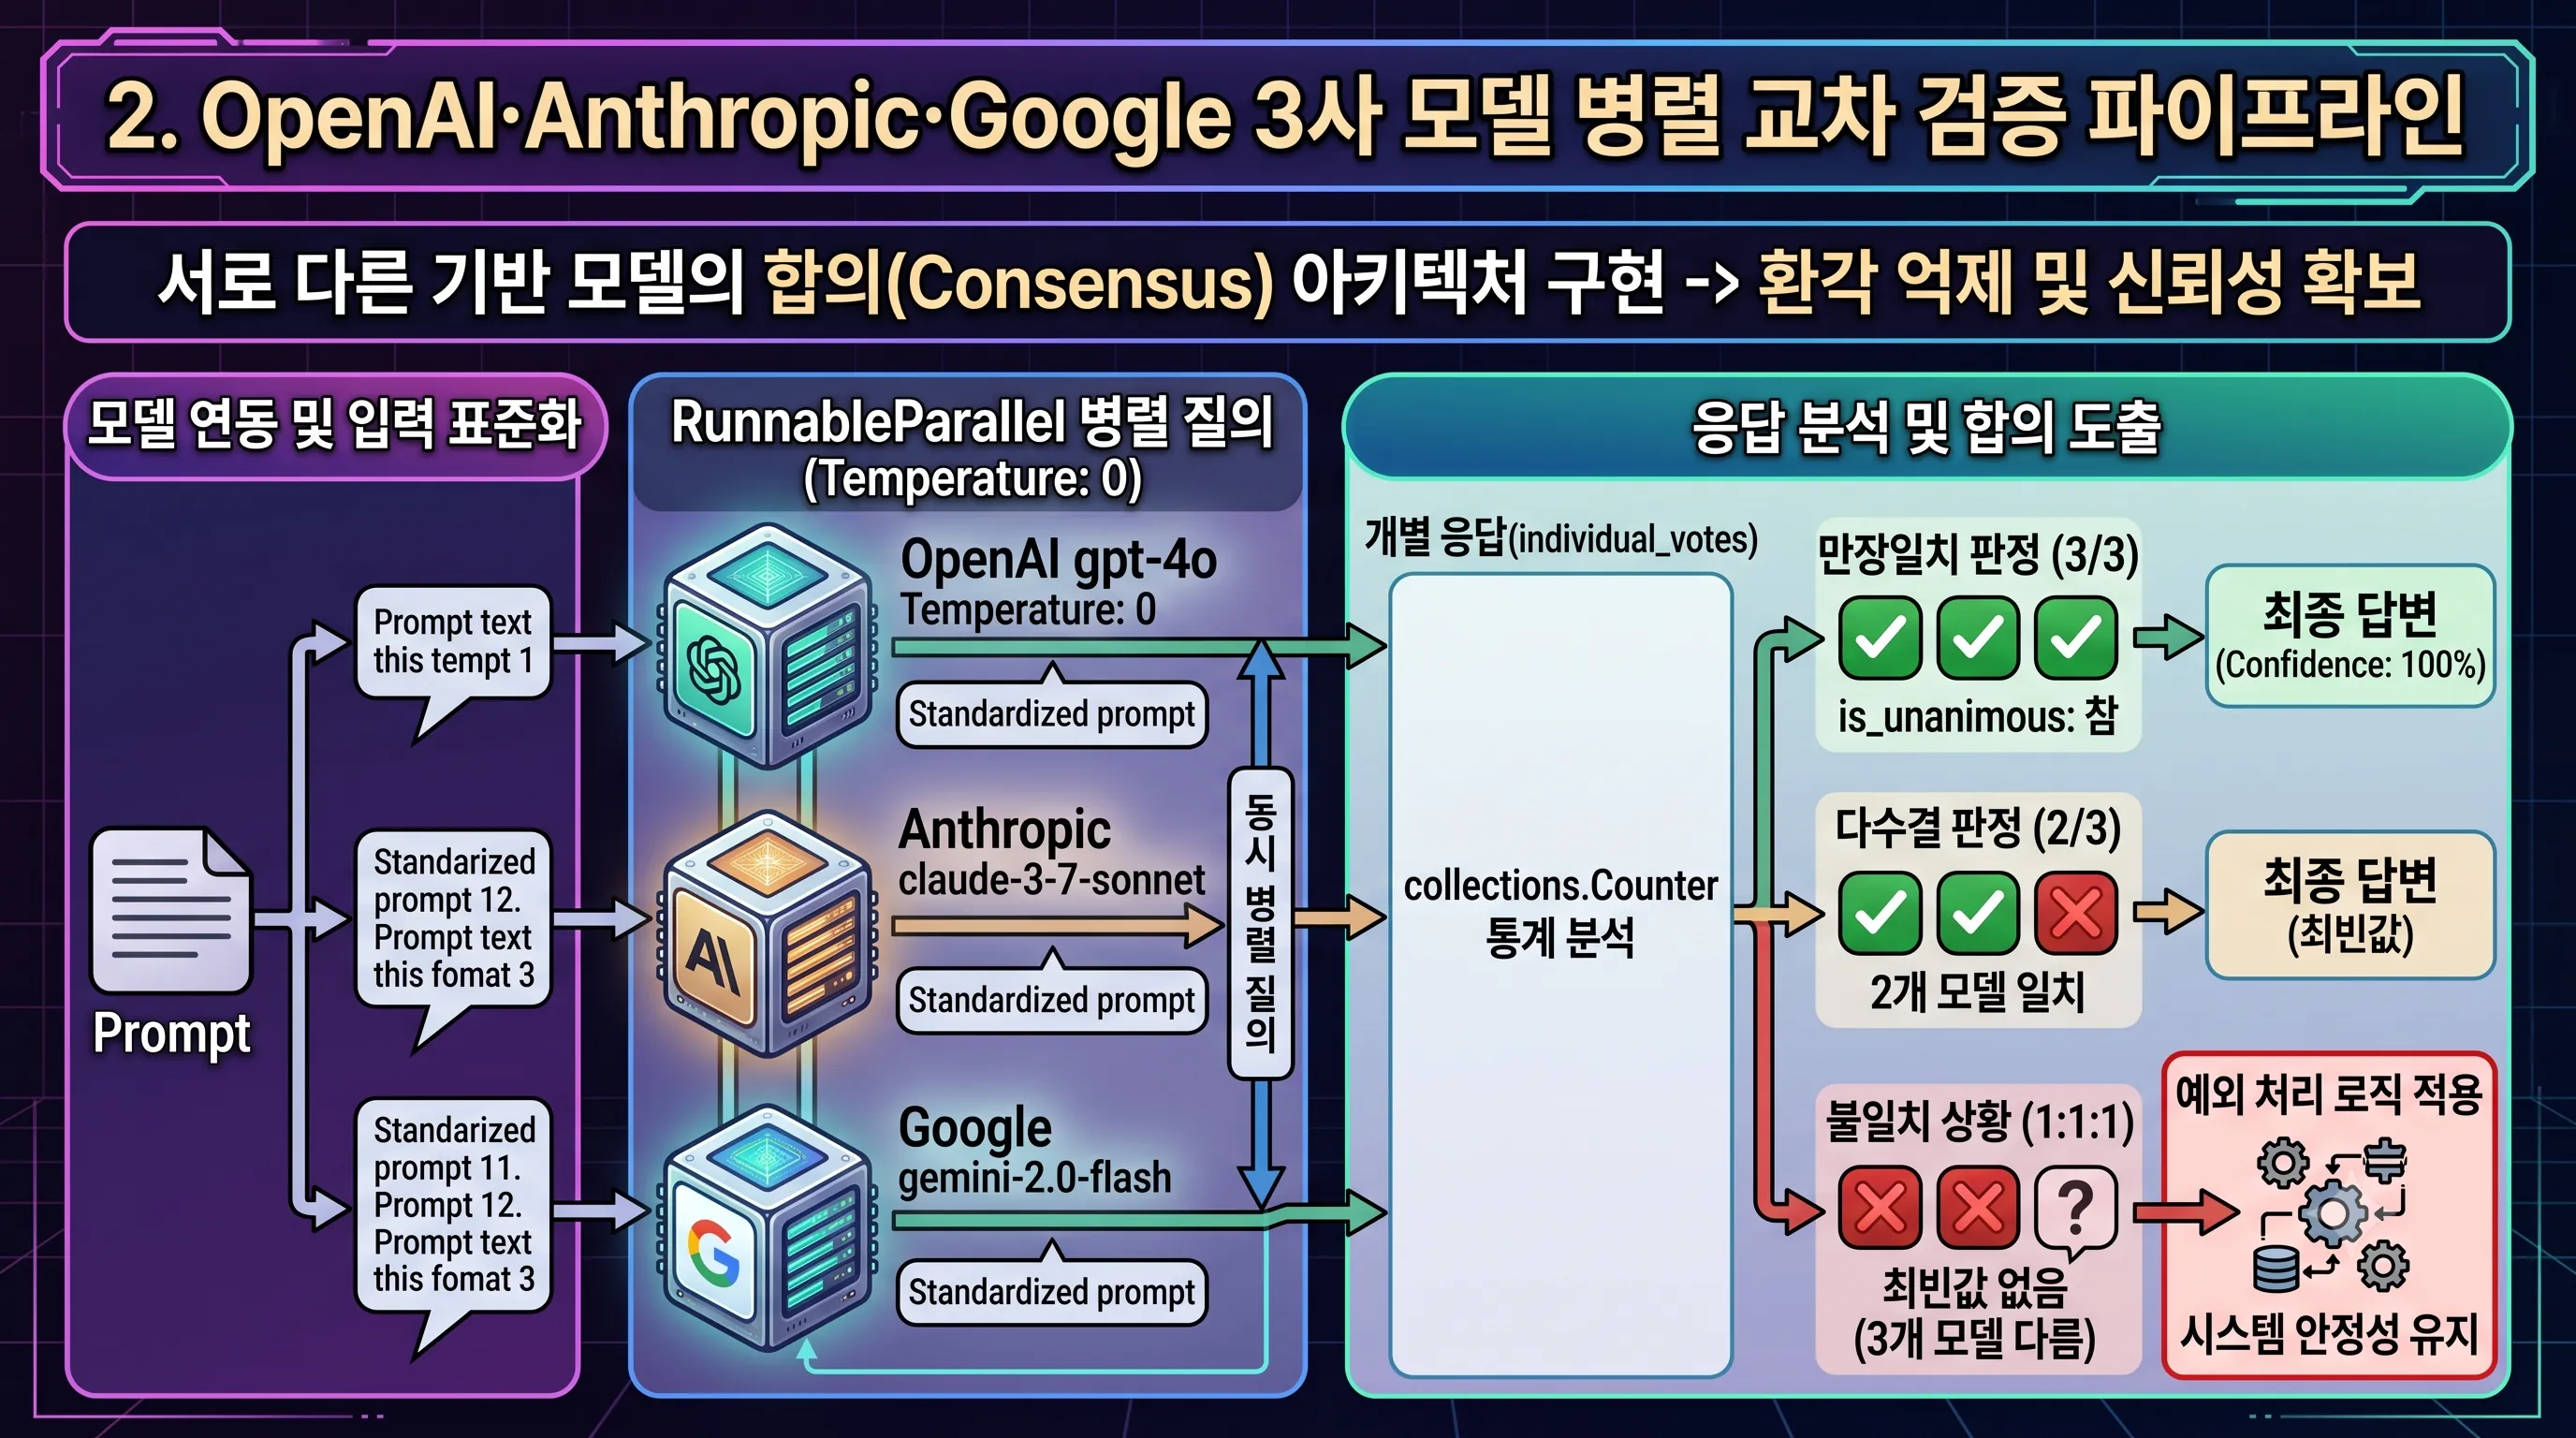
인공지능의 환각 현상을 억제하고 신뢰성 높은 결과물을 도출하기 위해 서로 다른 기반의 주요 AI 모델을 교차 검증하는 합의(Consensus) 아키텍처가 구현되었습니다.
이번 교차 검증 파이프라인에는 OpenAI의 gpt-4o, Anthropic의 claude-3-7-sonnet-20250219, 그리고 Google의 gemini-2.0-flash 등 각 사의 대표 모델 3종이 연동되었습니다.
응답의 일관성을 확보하고 무작위성을 배제하기 위해 3개 모델 모두 Temperature 0으로 설정되었습니다.
모델 간 공정한 비교와 정량적 합의 도출을 위해 PromptTemplate을 활용한 입력 표준화가 이루어집니다.
동일한 질문을 정형화된 프롬프트로 가공하여 각 모델에 전달하며, 선택지 중 하나를 고르는 단답형(A, B, C 등) 선택 응답을 명확히 요구합니다.
이렇게 표준화된 프롬프트는 LangChain의 RunnableParallel 구조를 통해 3개 모델에 동시 전달되어 지연 시간을 최소화하며 병렬 처리됩니다.
| 제공사 | 적용 모델 | 온도 설정(Temperature) | 질의 방식 |
|---|---|---|---|
| OpenAI | gpt-4o | 0 | PromptTemplate 기반 동시 병렬 질의 |
| Anthropic | claude-3-7-sonnet-20250219 | 0 | PromptTemplate 기반 동시 병렬 질의 |
| gemini-2.0-flash | 0 | PromptTemplate 기반 동시 병렬 질의 |
만장일치·다수결 판별과 불일치(1:1:1) 예외 처리 로직
병렬로 수집된 개별 응답(individual_votes)은 파이썬 내장 모듈인 collections.Counter를 거쳐 통계적으로 분석 및 취합됩니다.
카운터를 통해 최빈값을 추출함으로써 최종 다수결 승자(winner)를 확정하고, 전체 응답의 일치율을 기반으로 만장일치 여부(is_unanimous)와 신뢰도(confidence)를 산출합니다.
이를 통해 3개 모델이 완벽히 일치하는 3/3 만장일치 판정 또는 2개 모델의 의견이 일치하는 2/3 다수결 구조를 명확히 판별할 수 있습니다.
반면, 3개 모델이 각각 완전히 다른 선택지를 제시하는 1:1:1 불일치 상황이 발생할 수 있습니다.
이러한 경우에는 최빈값이 존재하지 않아 단순 다수결 판별이 불가능해지므로, 시스템의 안정성을 유지하기 위한 추가 해결 로직을 적용해 예외 상황을 처리하도록 구성됩니다.
3. LangGraph 기반 결정론적 제어와 엔터프라이즈 오케스트레이션 확장
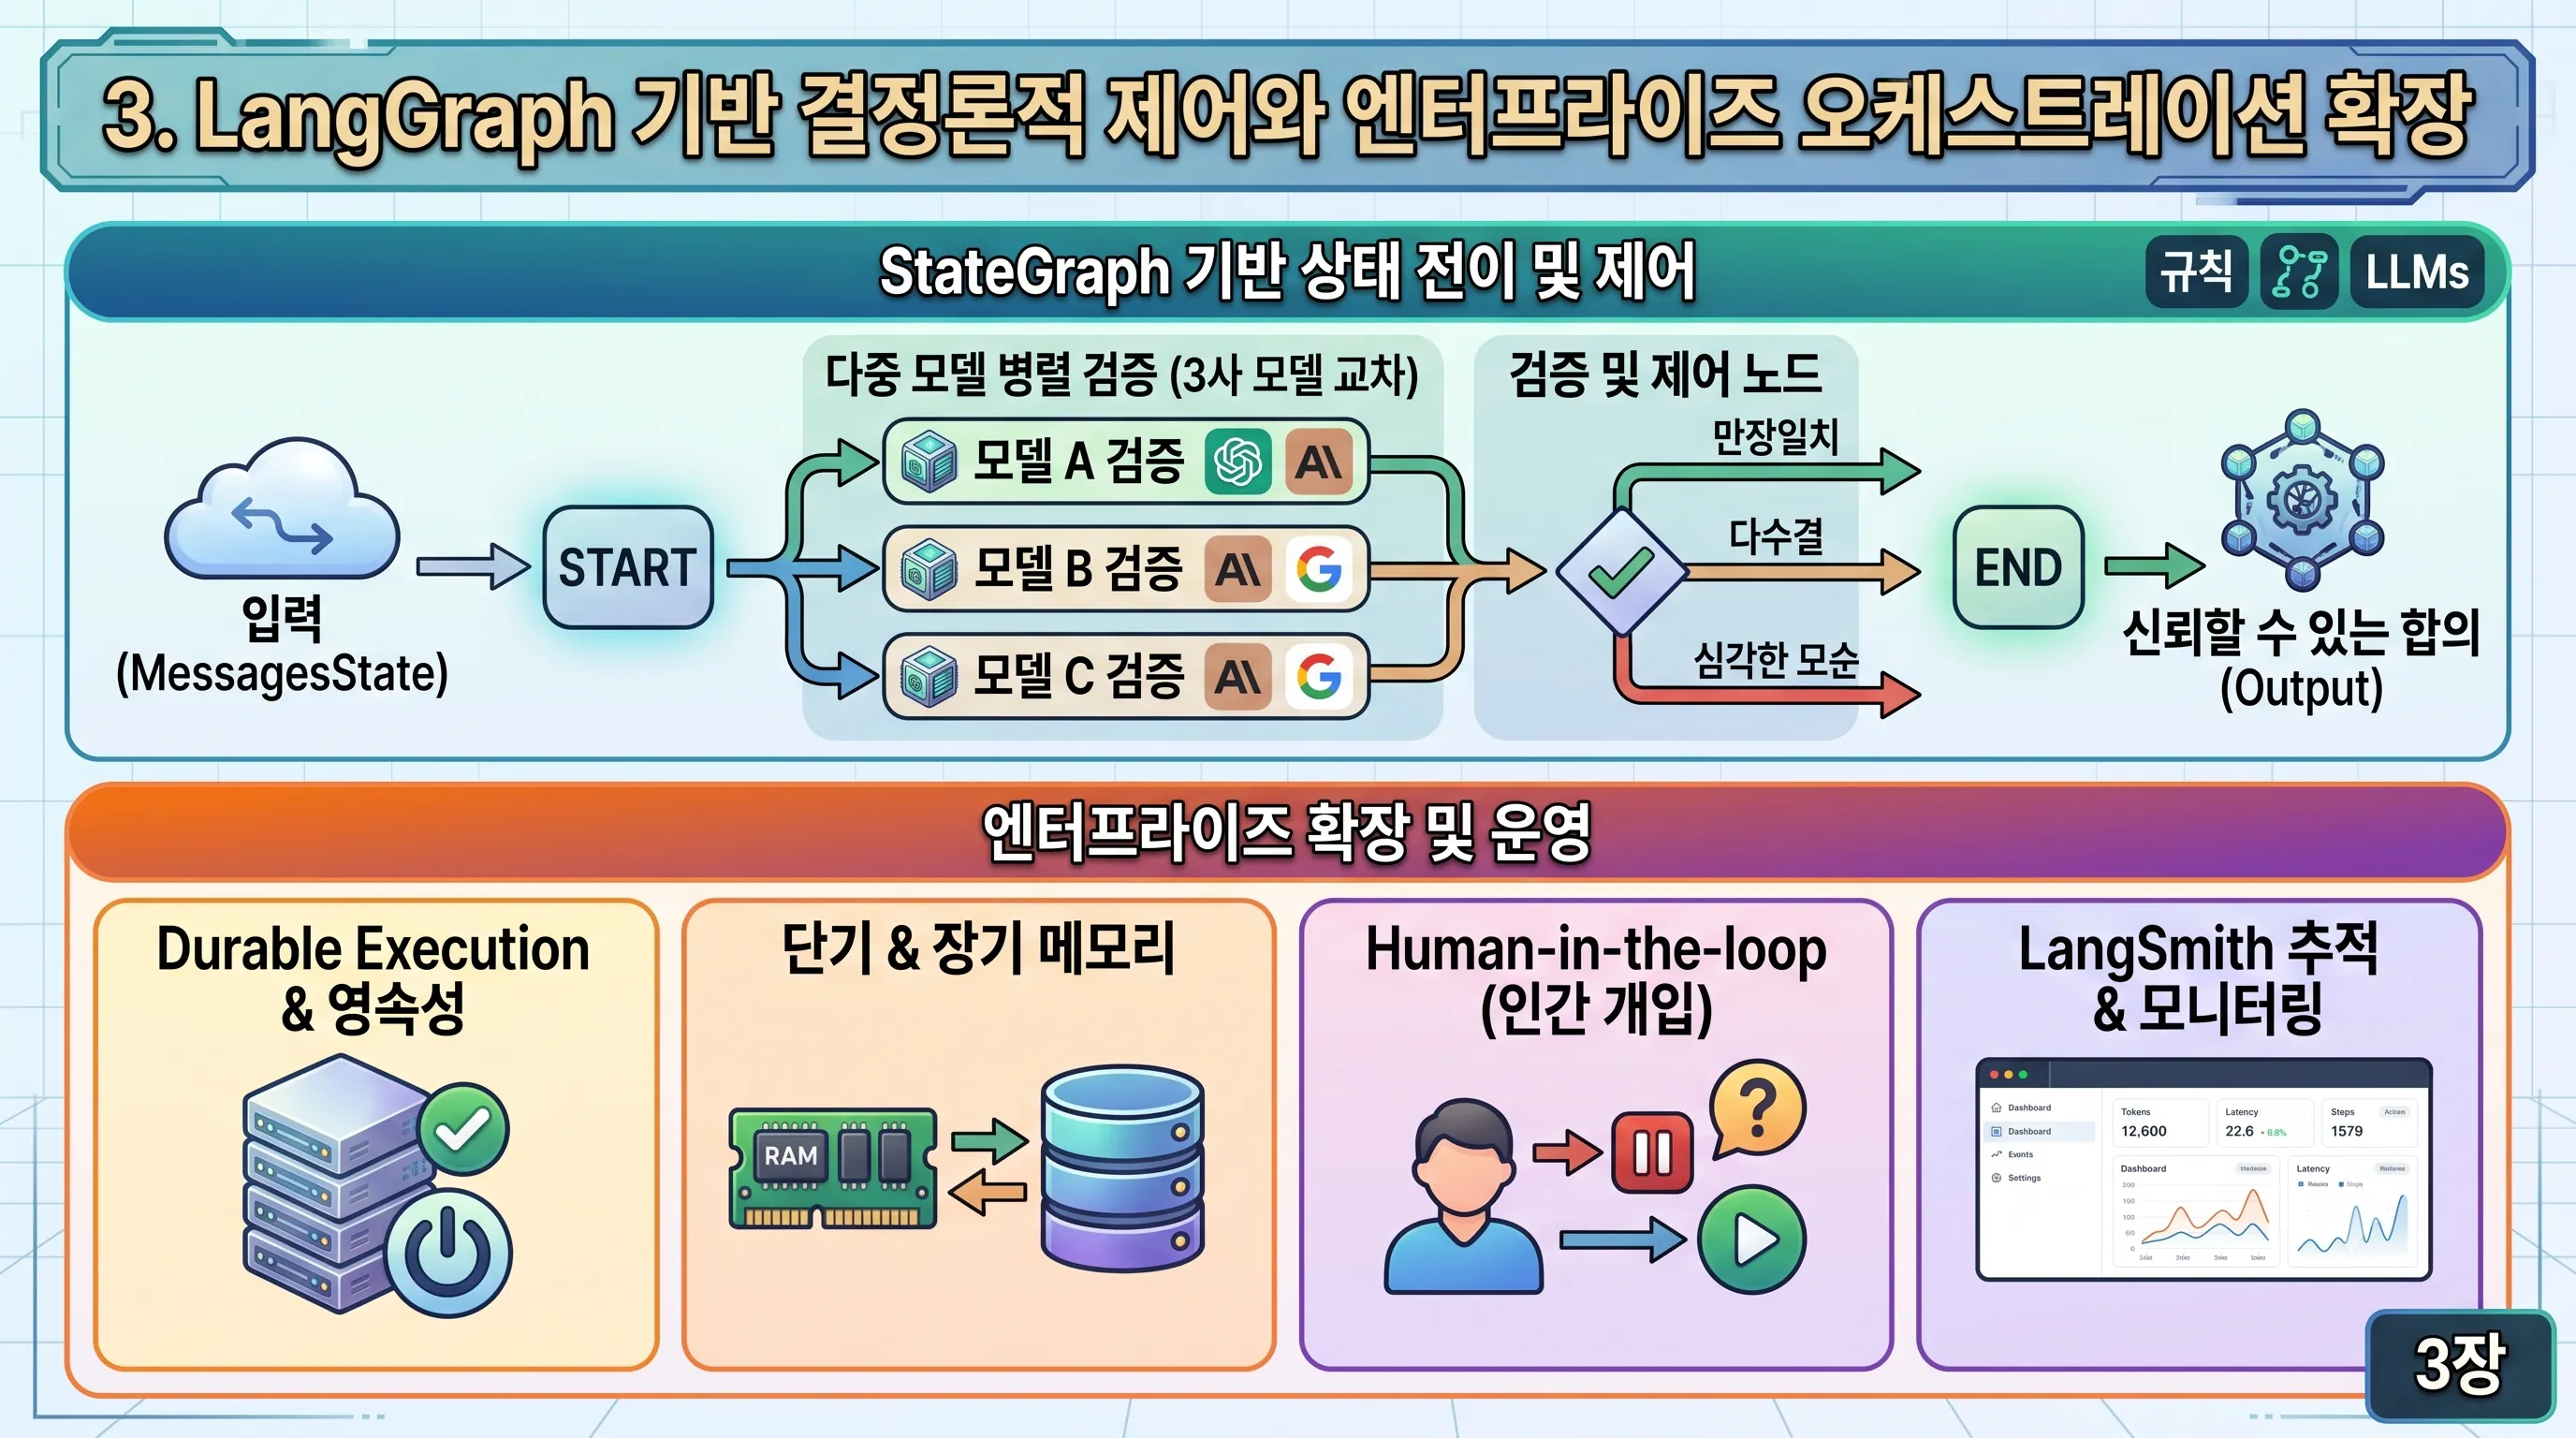
StateGraph 기반 상태 전이 및 결정론적 검증 노드 결합
3사 모델 교차 검증 파이프라인에서 신뢰도 높은 합의를 도출하기 위해서는 모델 간의 비결정적 추론과 규칙 기반의 엄격한 통제가 공존해야 합니다.
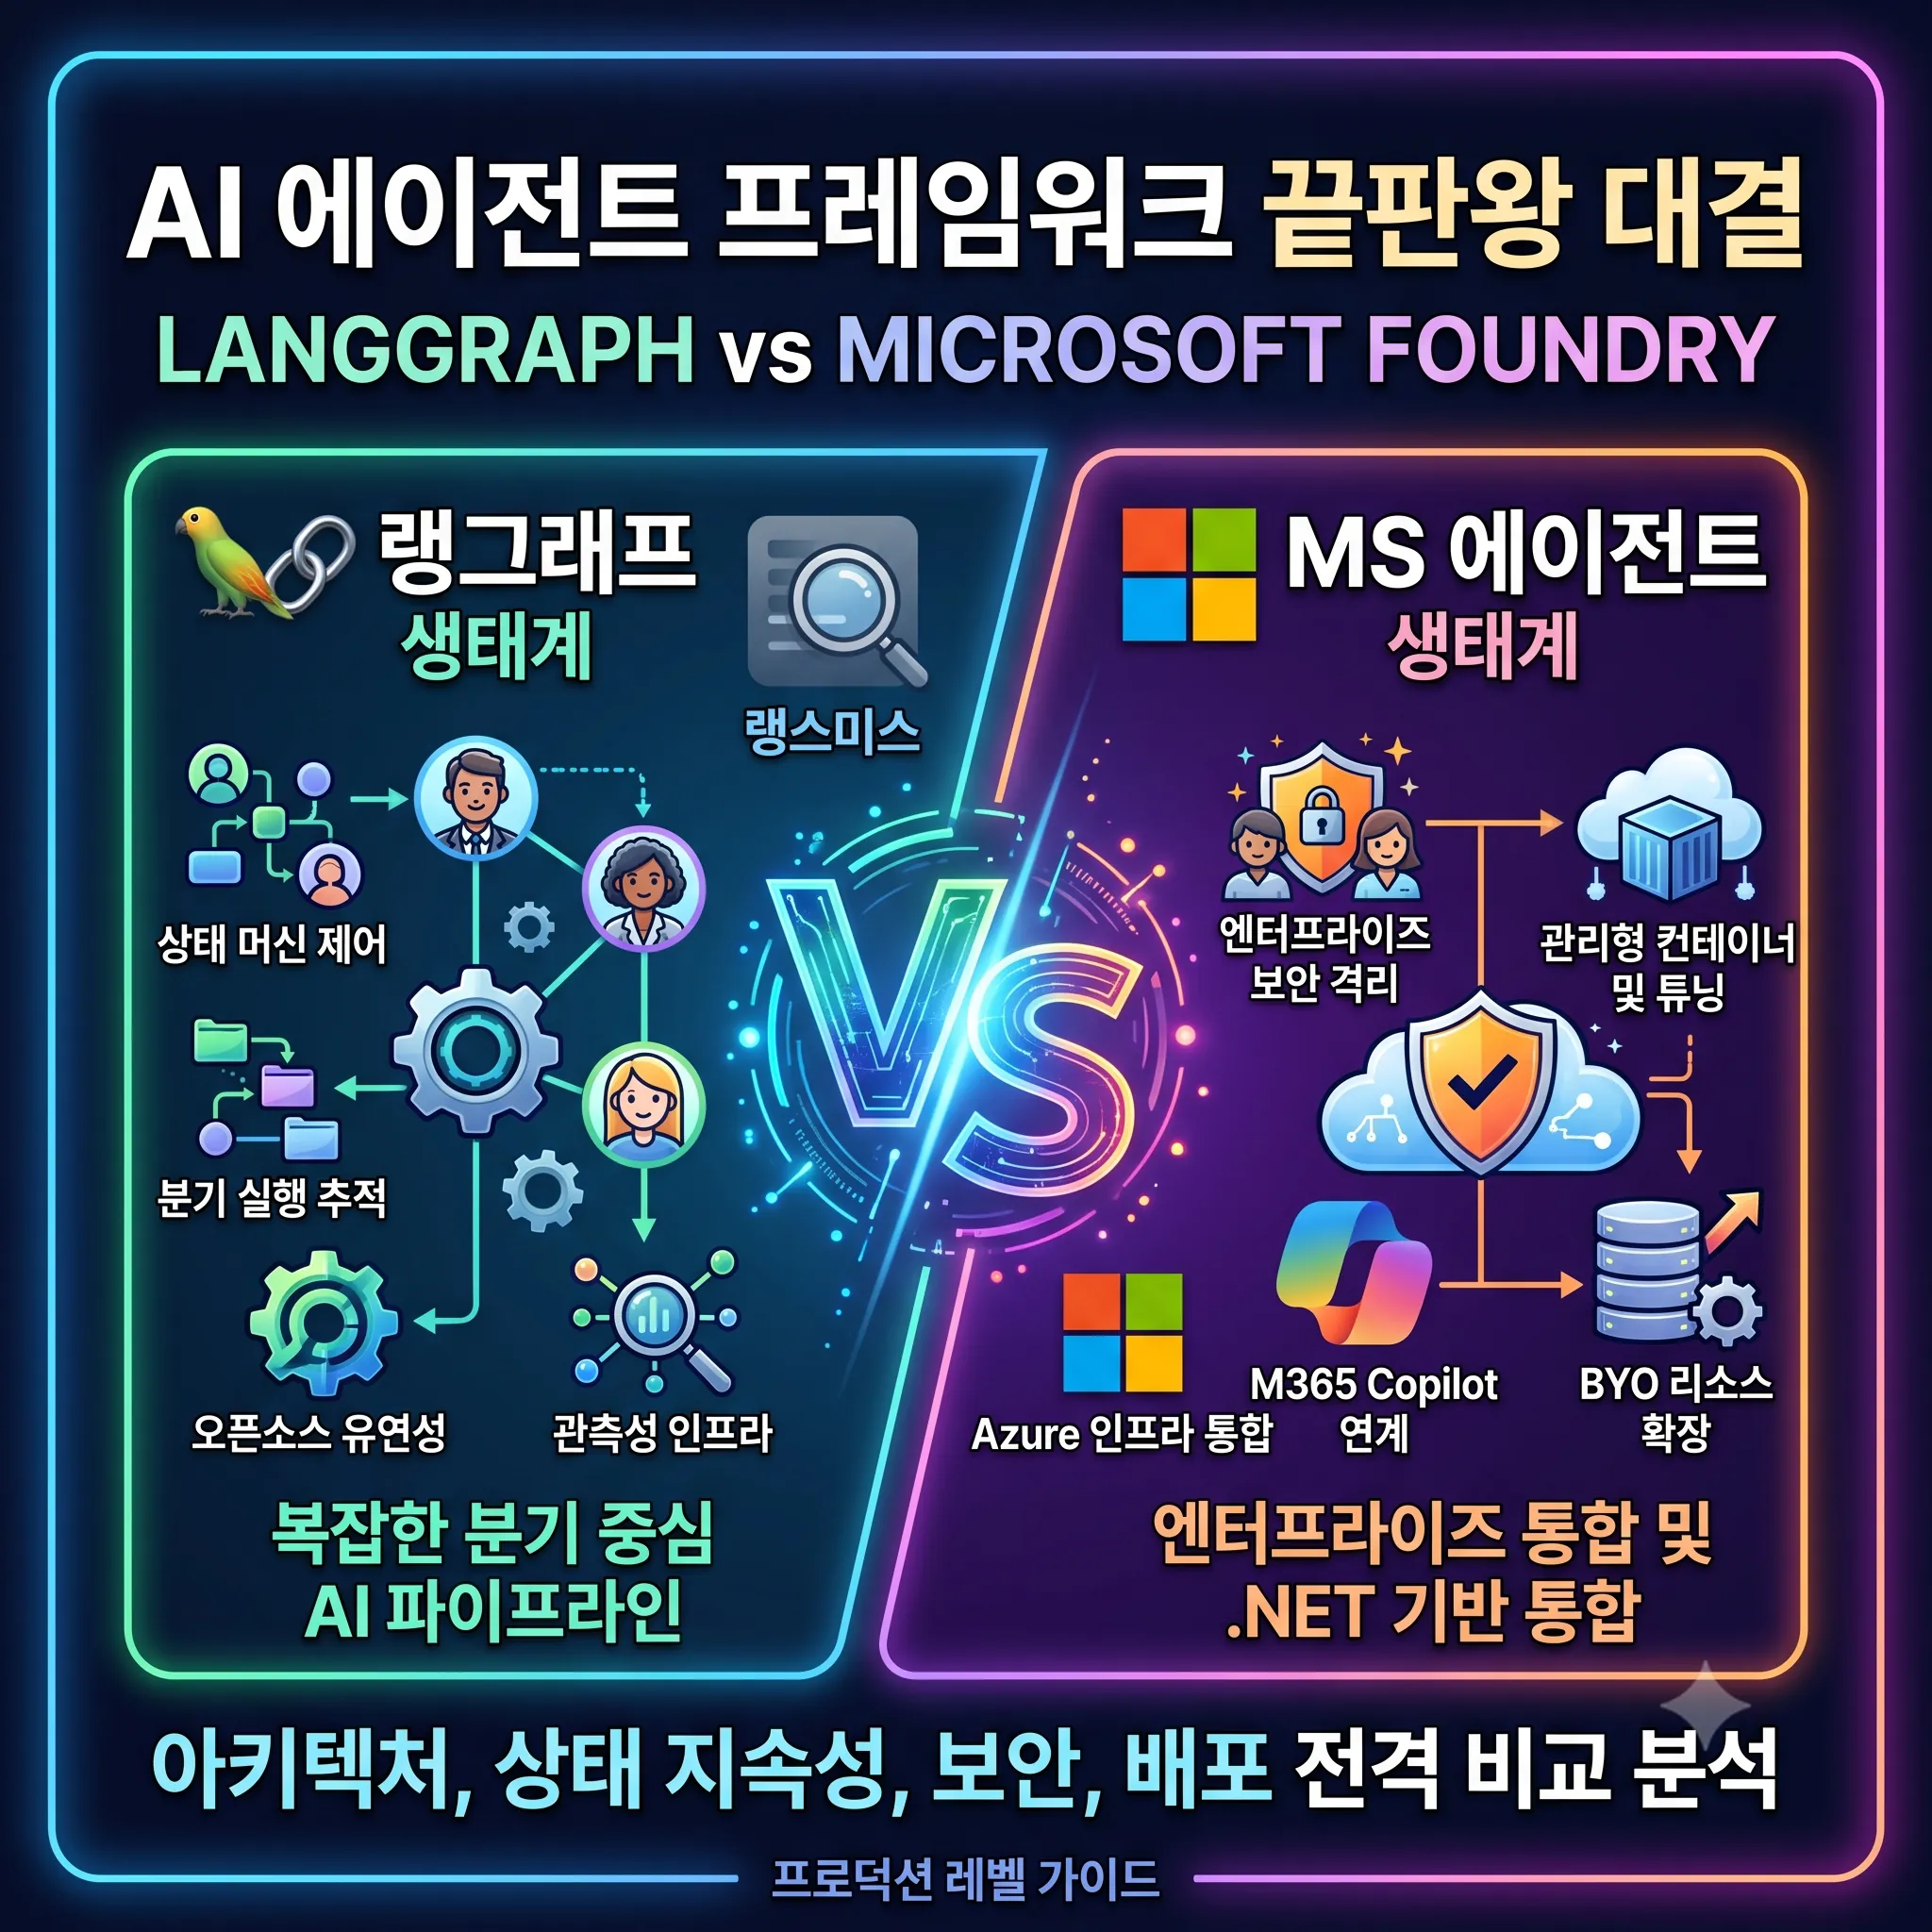
이러한 복합 워크플로우를 구현하는 핵심 런타임 프레임워크로 LangGraph가 널리 활용되고 있습니다.
LangGraph 공식 문서(LangGraph Overview)에 따르면, 해당 프레임워크는 StateGraph와 MessagesState, 그리고 START 및 END 노드를 기반으로 명시적인 그래프 구조를 정의하고 이를 실행 가능한 워크플로우로 컴파일합니다.
프롬프트나 고수준 아키텍처를 과도하게 추상화하지 않는 로우레벨 오케스트레이션 프레임워크 특성을 지니고 있어, 개발자가 실행 흐름과 상태 전이 로직 전체를 세밀하게 통제할 수 있습니다.
이 아키텍처의 가장 큰 기술적 강점은 결정론적(Deterministic) 핸드코딩 단계와 LLM 기반 에이전트 단계를 단일 그래프 내부에서 유연하게 혼합 제어할 수 있다는 점입니다.
예를 들어 복수의 파운데이션 모델이 내놓은 응답 간의 텍스트 유사도를 계산하거나 특정 정규식 규칙을 적용하는 작업은 결정론적 코드로 처리하고, 정성적 맥락 판정 및 종합 평가는 LLM 노드에 위임하는 방식입니다.
또한 LangChain 프레임워크의 create_agent 기능을 활용하면 프롬프트, 도구(Tools), 미들웨어를 결합하여 모듈화된 Harness 환경을 구성할 수 있어 개별 검증 에이전트의 독립성과 확장성을 동시에 확보할 수 있습니다.
| 구분 | 결정론적(Deterministic) 핸드코딩 단계 | LLM 기반 에이전트 단계 |
|---|---|---|
| 실행 방식 | 사전 정의된 규칙 및 파이썬 로직 직접 연산 | create_agent 기반 프롬프트·도구 연계 추론 |
| 주요 역할 | 엄격한 데이터 전처리, 포맷 검증, 점수 필터링 | 심층 맥락 분석, 상호 모순 식별, 정성적 교차 평가 |
| 오케스트레이션 | StateGraph 노드 내 정적 함수 실행 | MessagesState 기반 동적 상태 갱신 및 추론 |
Durable Execution·인간 개입(Human-in-the-loop) 및 LangSmith 추적
엔터프라이즈 환경의 합의 파이프라인에서는 장시간 실행되는 검증 작업의 안정성과 상태 보존이 필수적입니다.
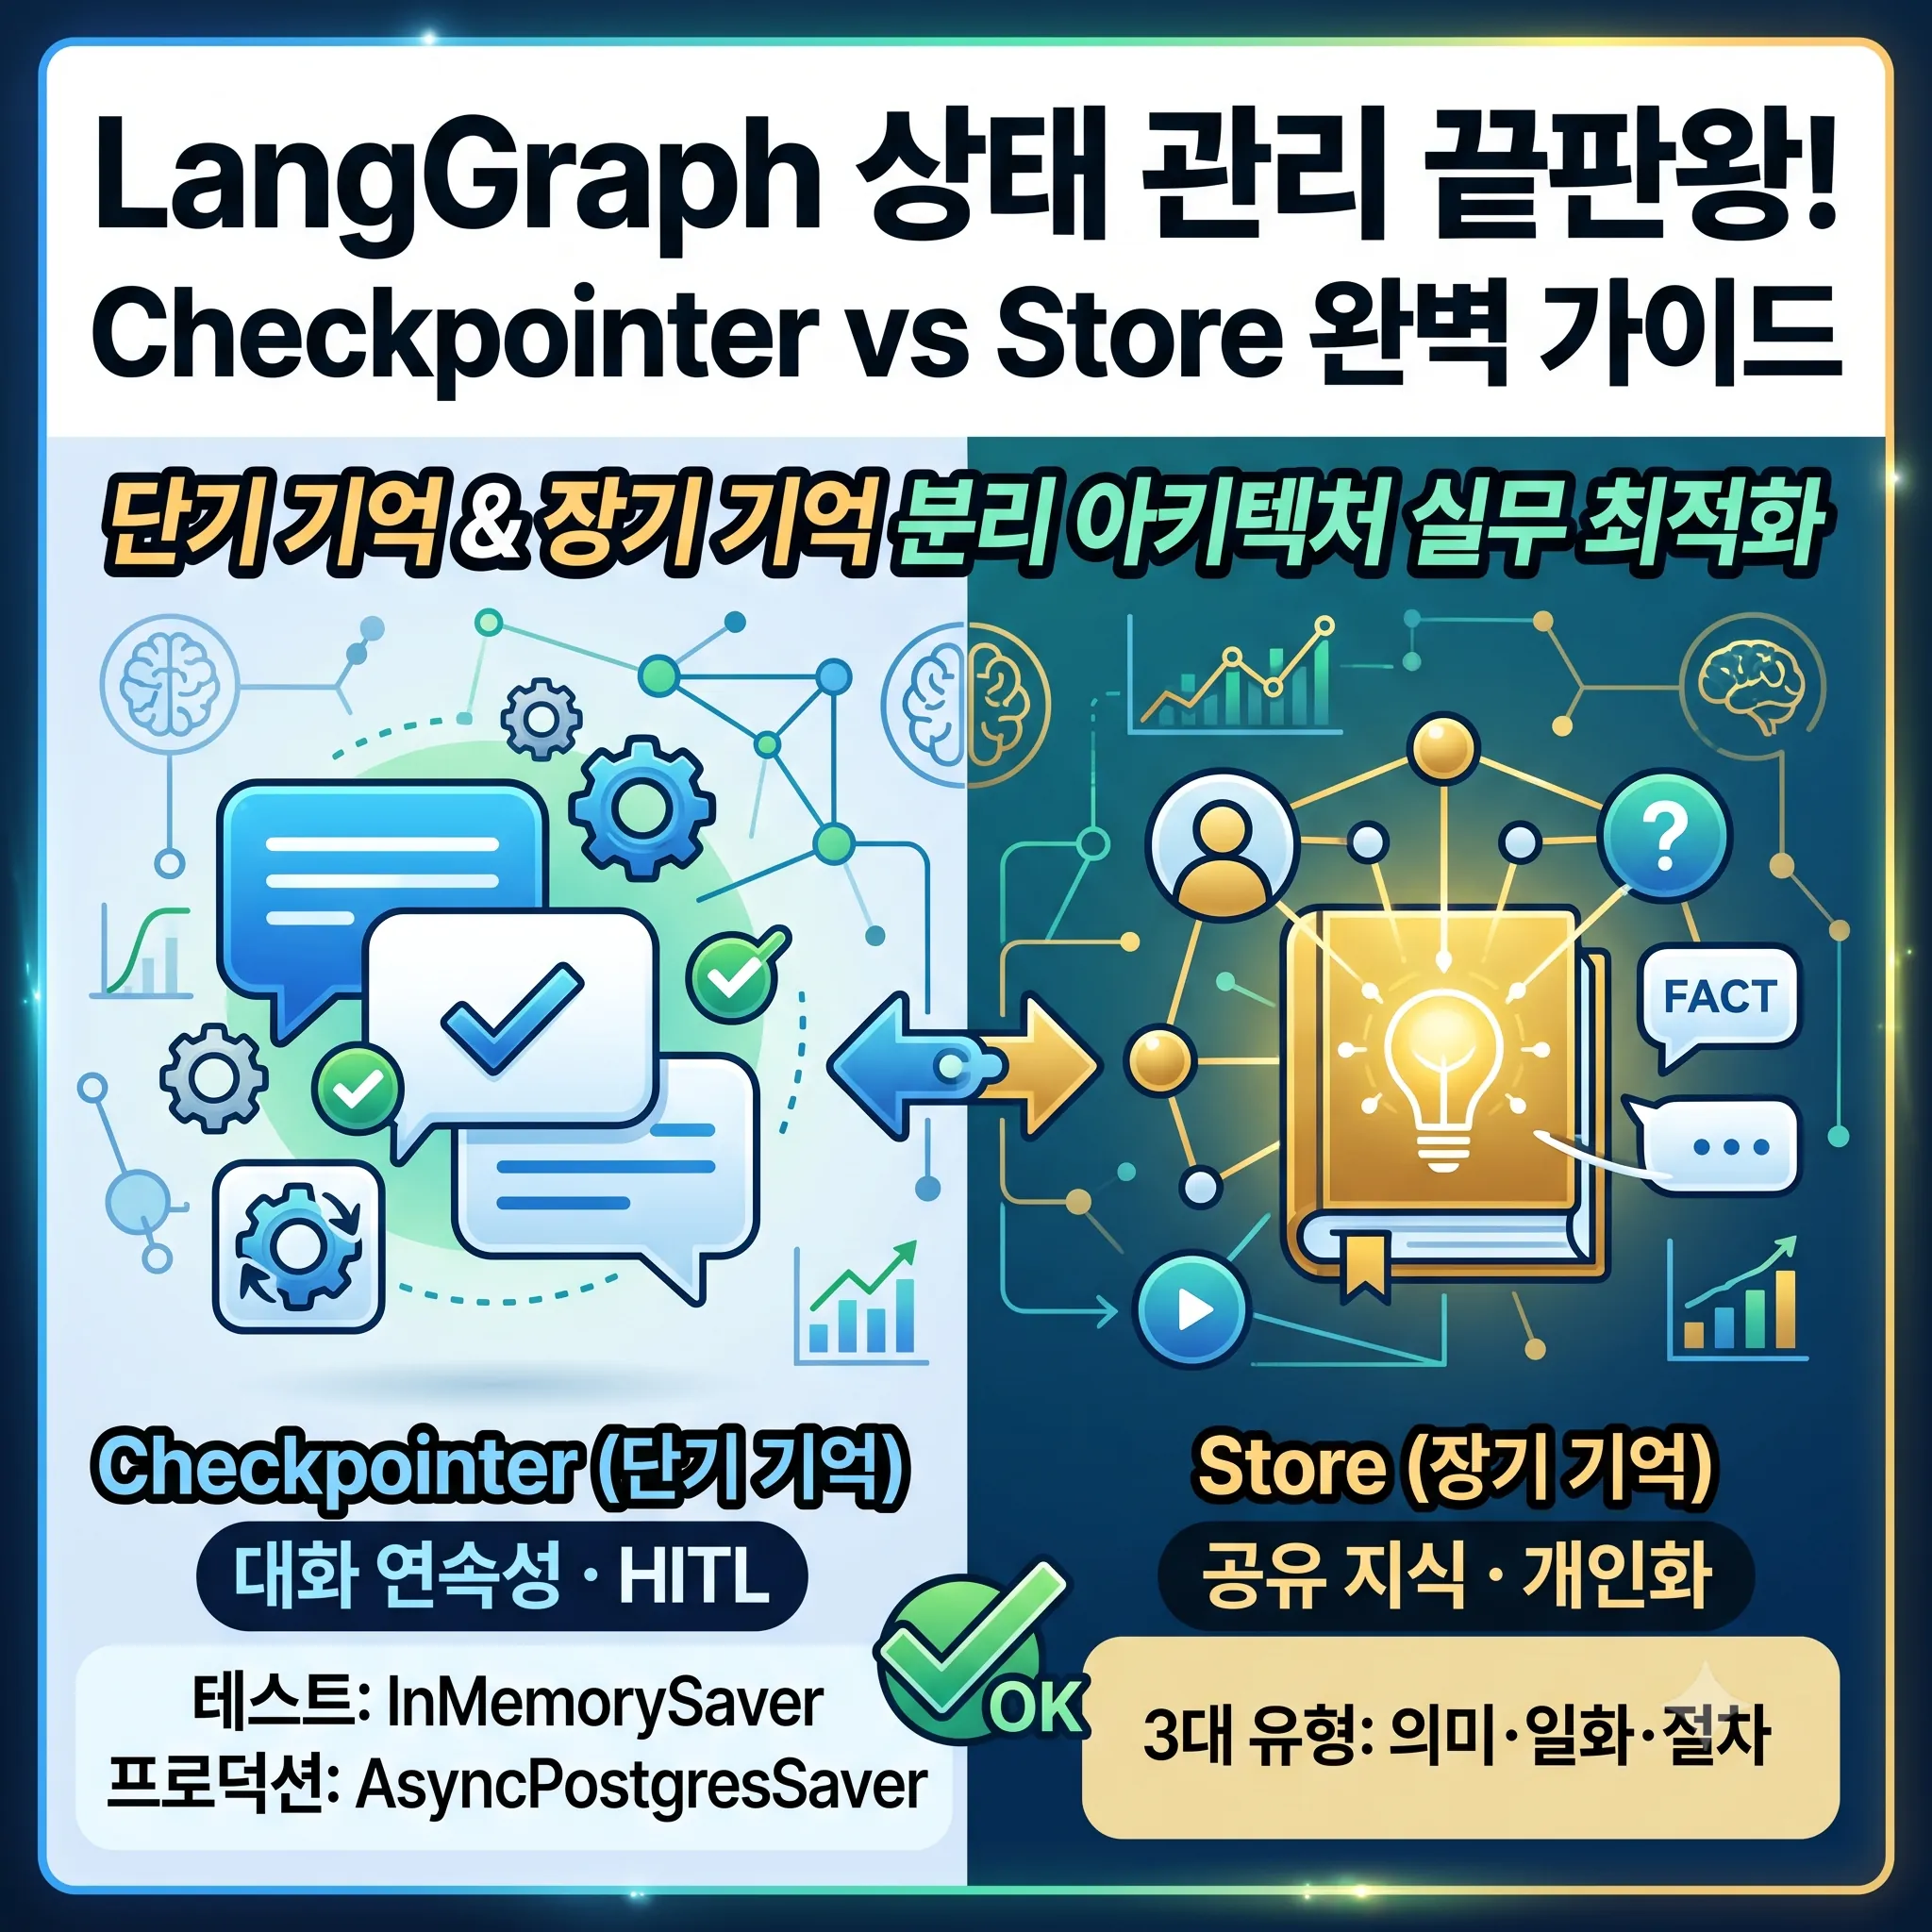
LangGraph는 Durable execution(지속 실행)과 견고한 상태 영속성(Persistence)을 제공하여 시스템 장애가 발생하더라도 작업 상태를 유실 없이 복구할 수 있도록 지원합니다.
동시에 단일 실행 흐름 내에서 유지되는 단기 작업 메모리(Working Memory)와 세션 간 데이터를 유지하는 장기 메모리(Long-term Memory) 체계를 지원하여, 과거 교차 검증 이력을 누적 참조하며 판단 정밀도를 높입니다.
특히 3사 모델의 교차 검증 결과가 팽팽하게 대립하거나 신뢰도 점수가 임계치에 미치지 못할 때, 시스템이 스스로 중단점을 생성하는 Human-in-the-loop(인간 개입) 기능을 가동할 수 있습니다.
관리자는 그래프의 실행 도중 개입하여 중간 상태를 직접 검사하거나 검증 파라미터를 수정한 후 실행을 재개할 수 있습니다.
여기에 LangSmith 플랫폼을 연동하면 전체 그래프의 실행 경로 추적, 노드별 상태 전이 디버깅, 레이턴시 및 토큰 소비 지표 모니터링을 실시간으로 수행할 수 있어 엔터프라이즈 파이프라인의 투명성과 운영 안정성을 극대화합니다.
관련 글