DeepSeek-V3: GPT-4o 넘본 오픈소스 AI 혁신, 수학·코딩 압도
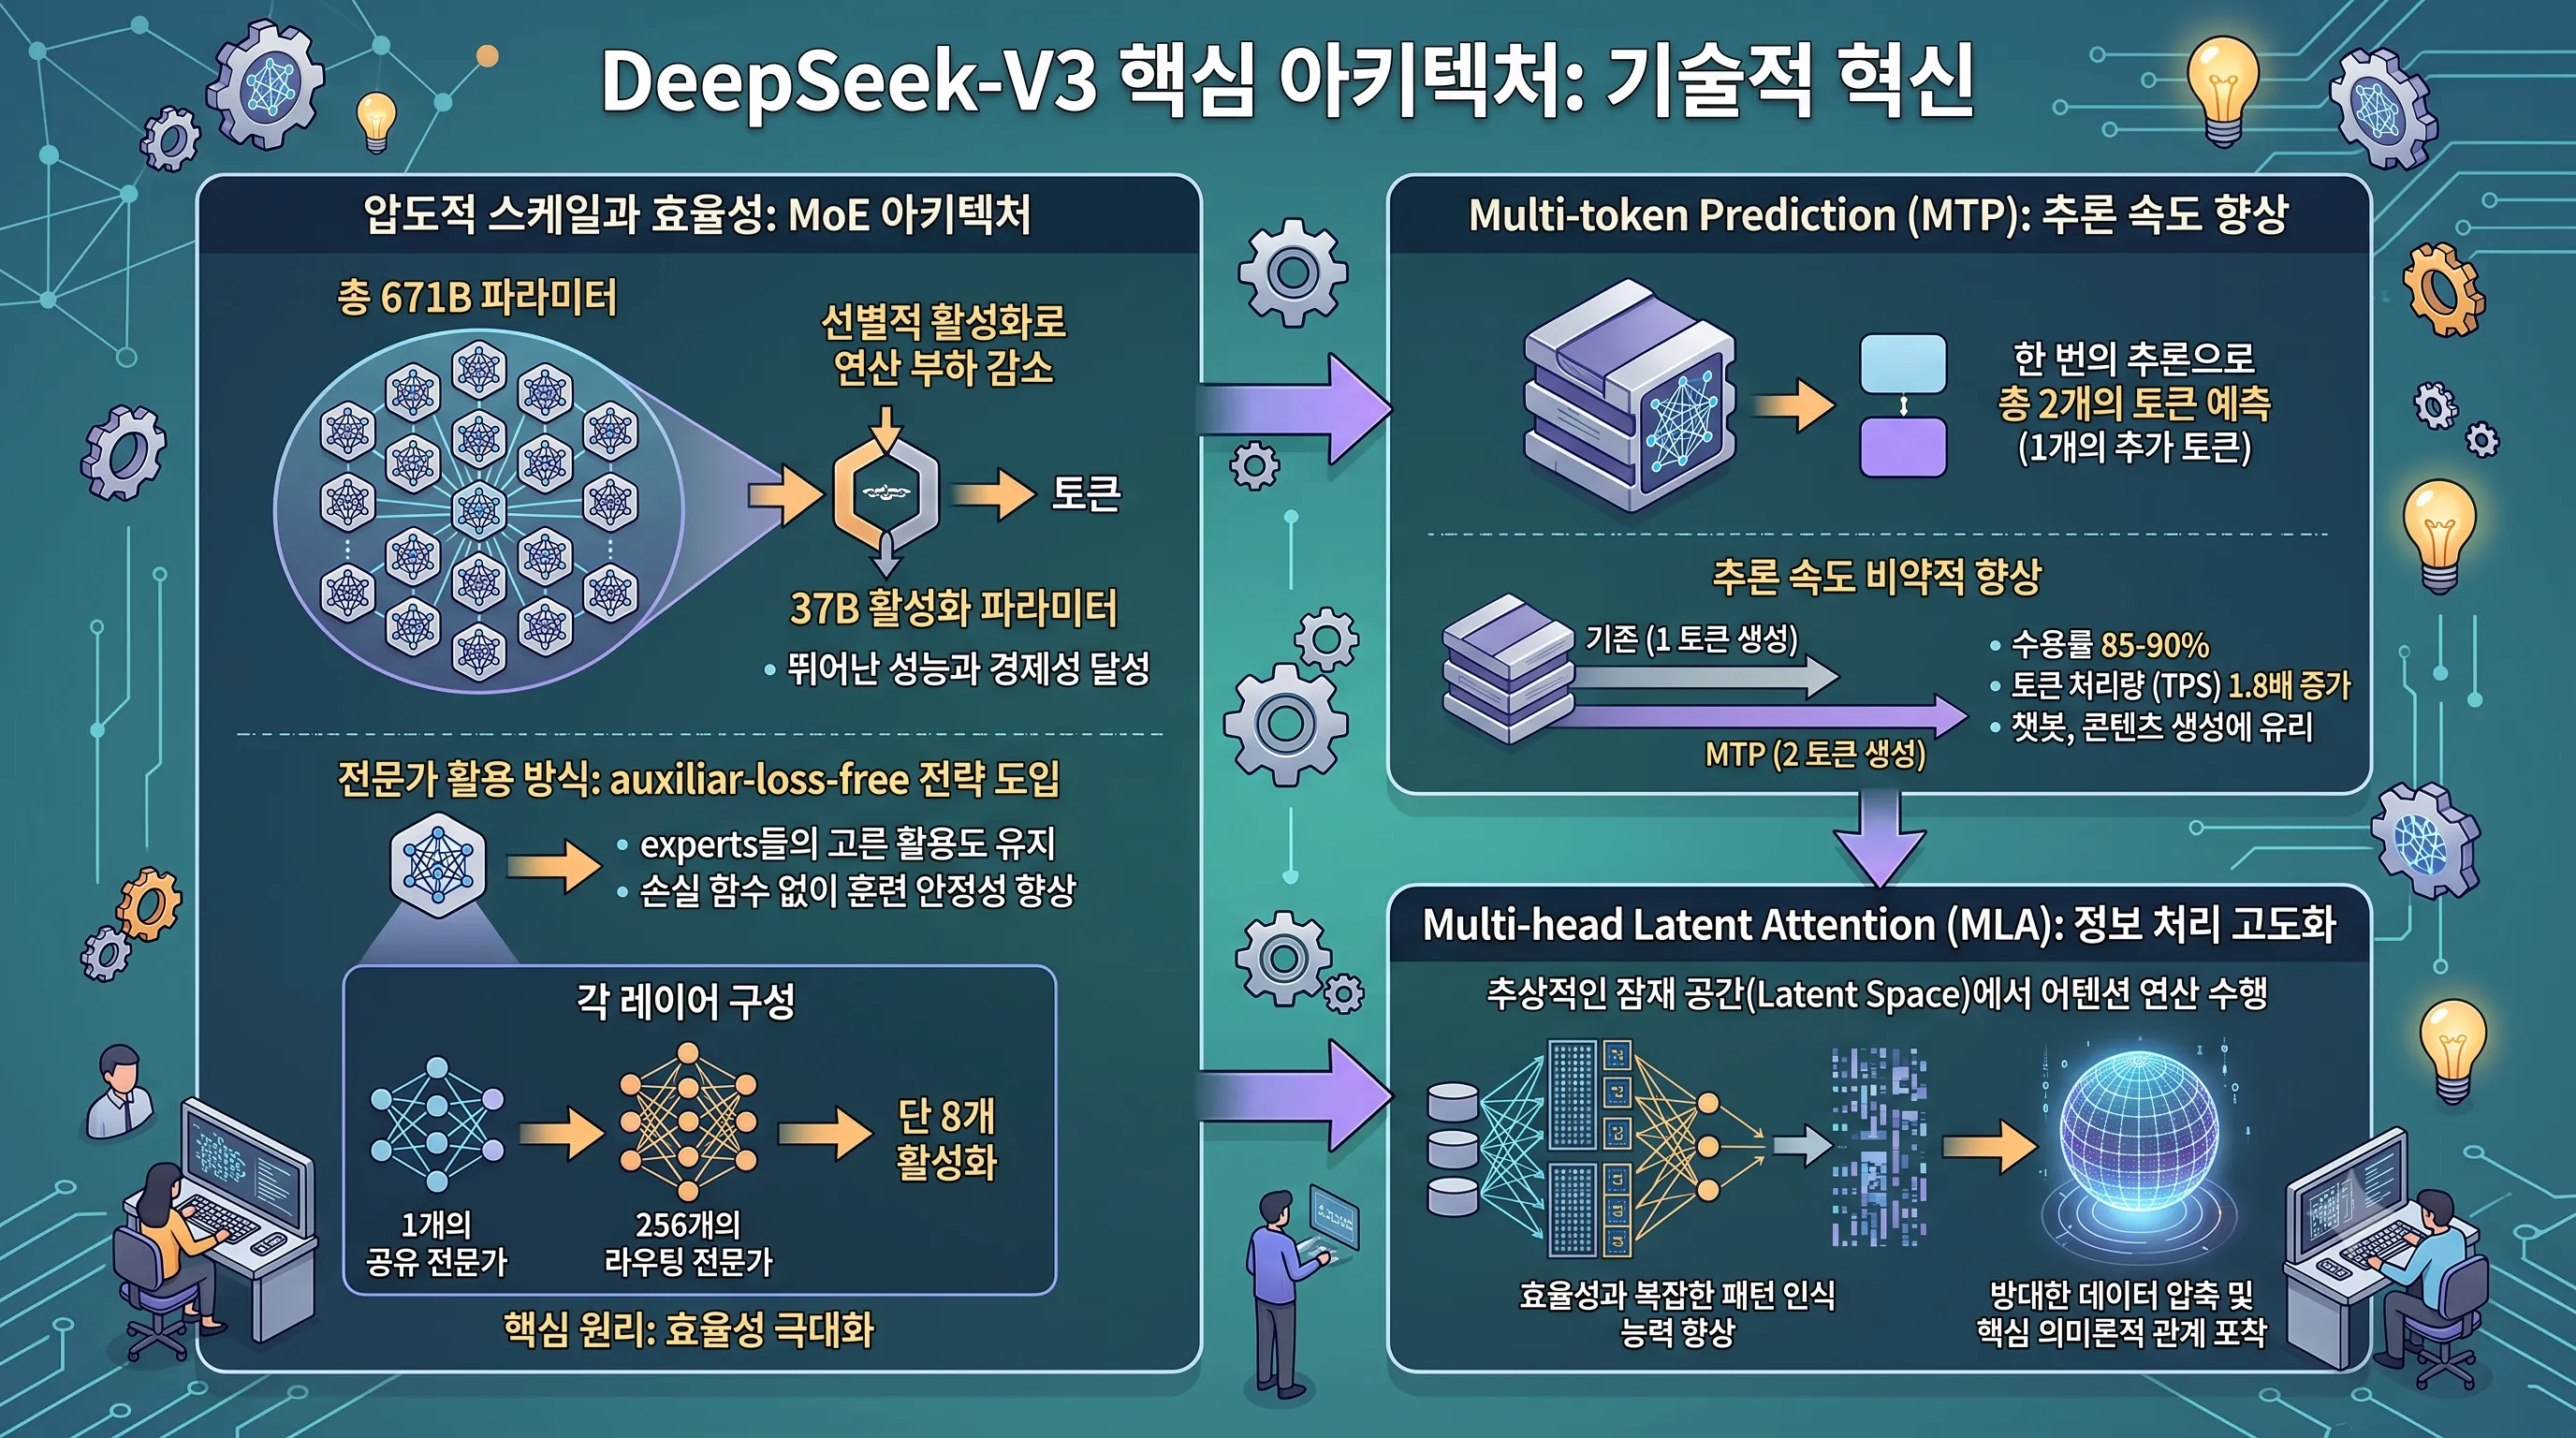
- DeepSeek-V3는 Mixture-of-Experts (MoE) 모델로, 671B 파라미터 중 토큰당 37B만 활성화하는 혁신적인 아키텍처를 가집니다.
- Multi-token prediction (MTP) 훈련 방법론을 통해 추론 속도를 1.8배 향상시키며, 두 번째 토큰 수용률은 85-90%에 달합니다.
- 자체 개발한 DeepSeekMoE는 Auxiliary-loss-free 로드 밸런싱을, Multi-head Latent Attention (MLA)은 잠재 공간 처리의 고도화를 가능하게 합니다.
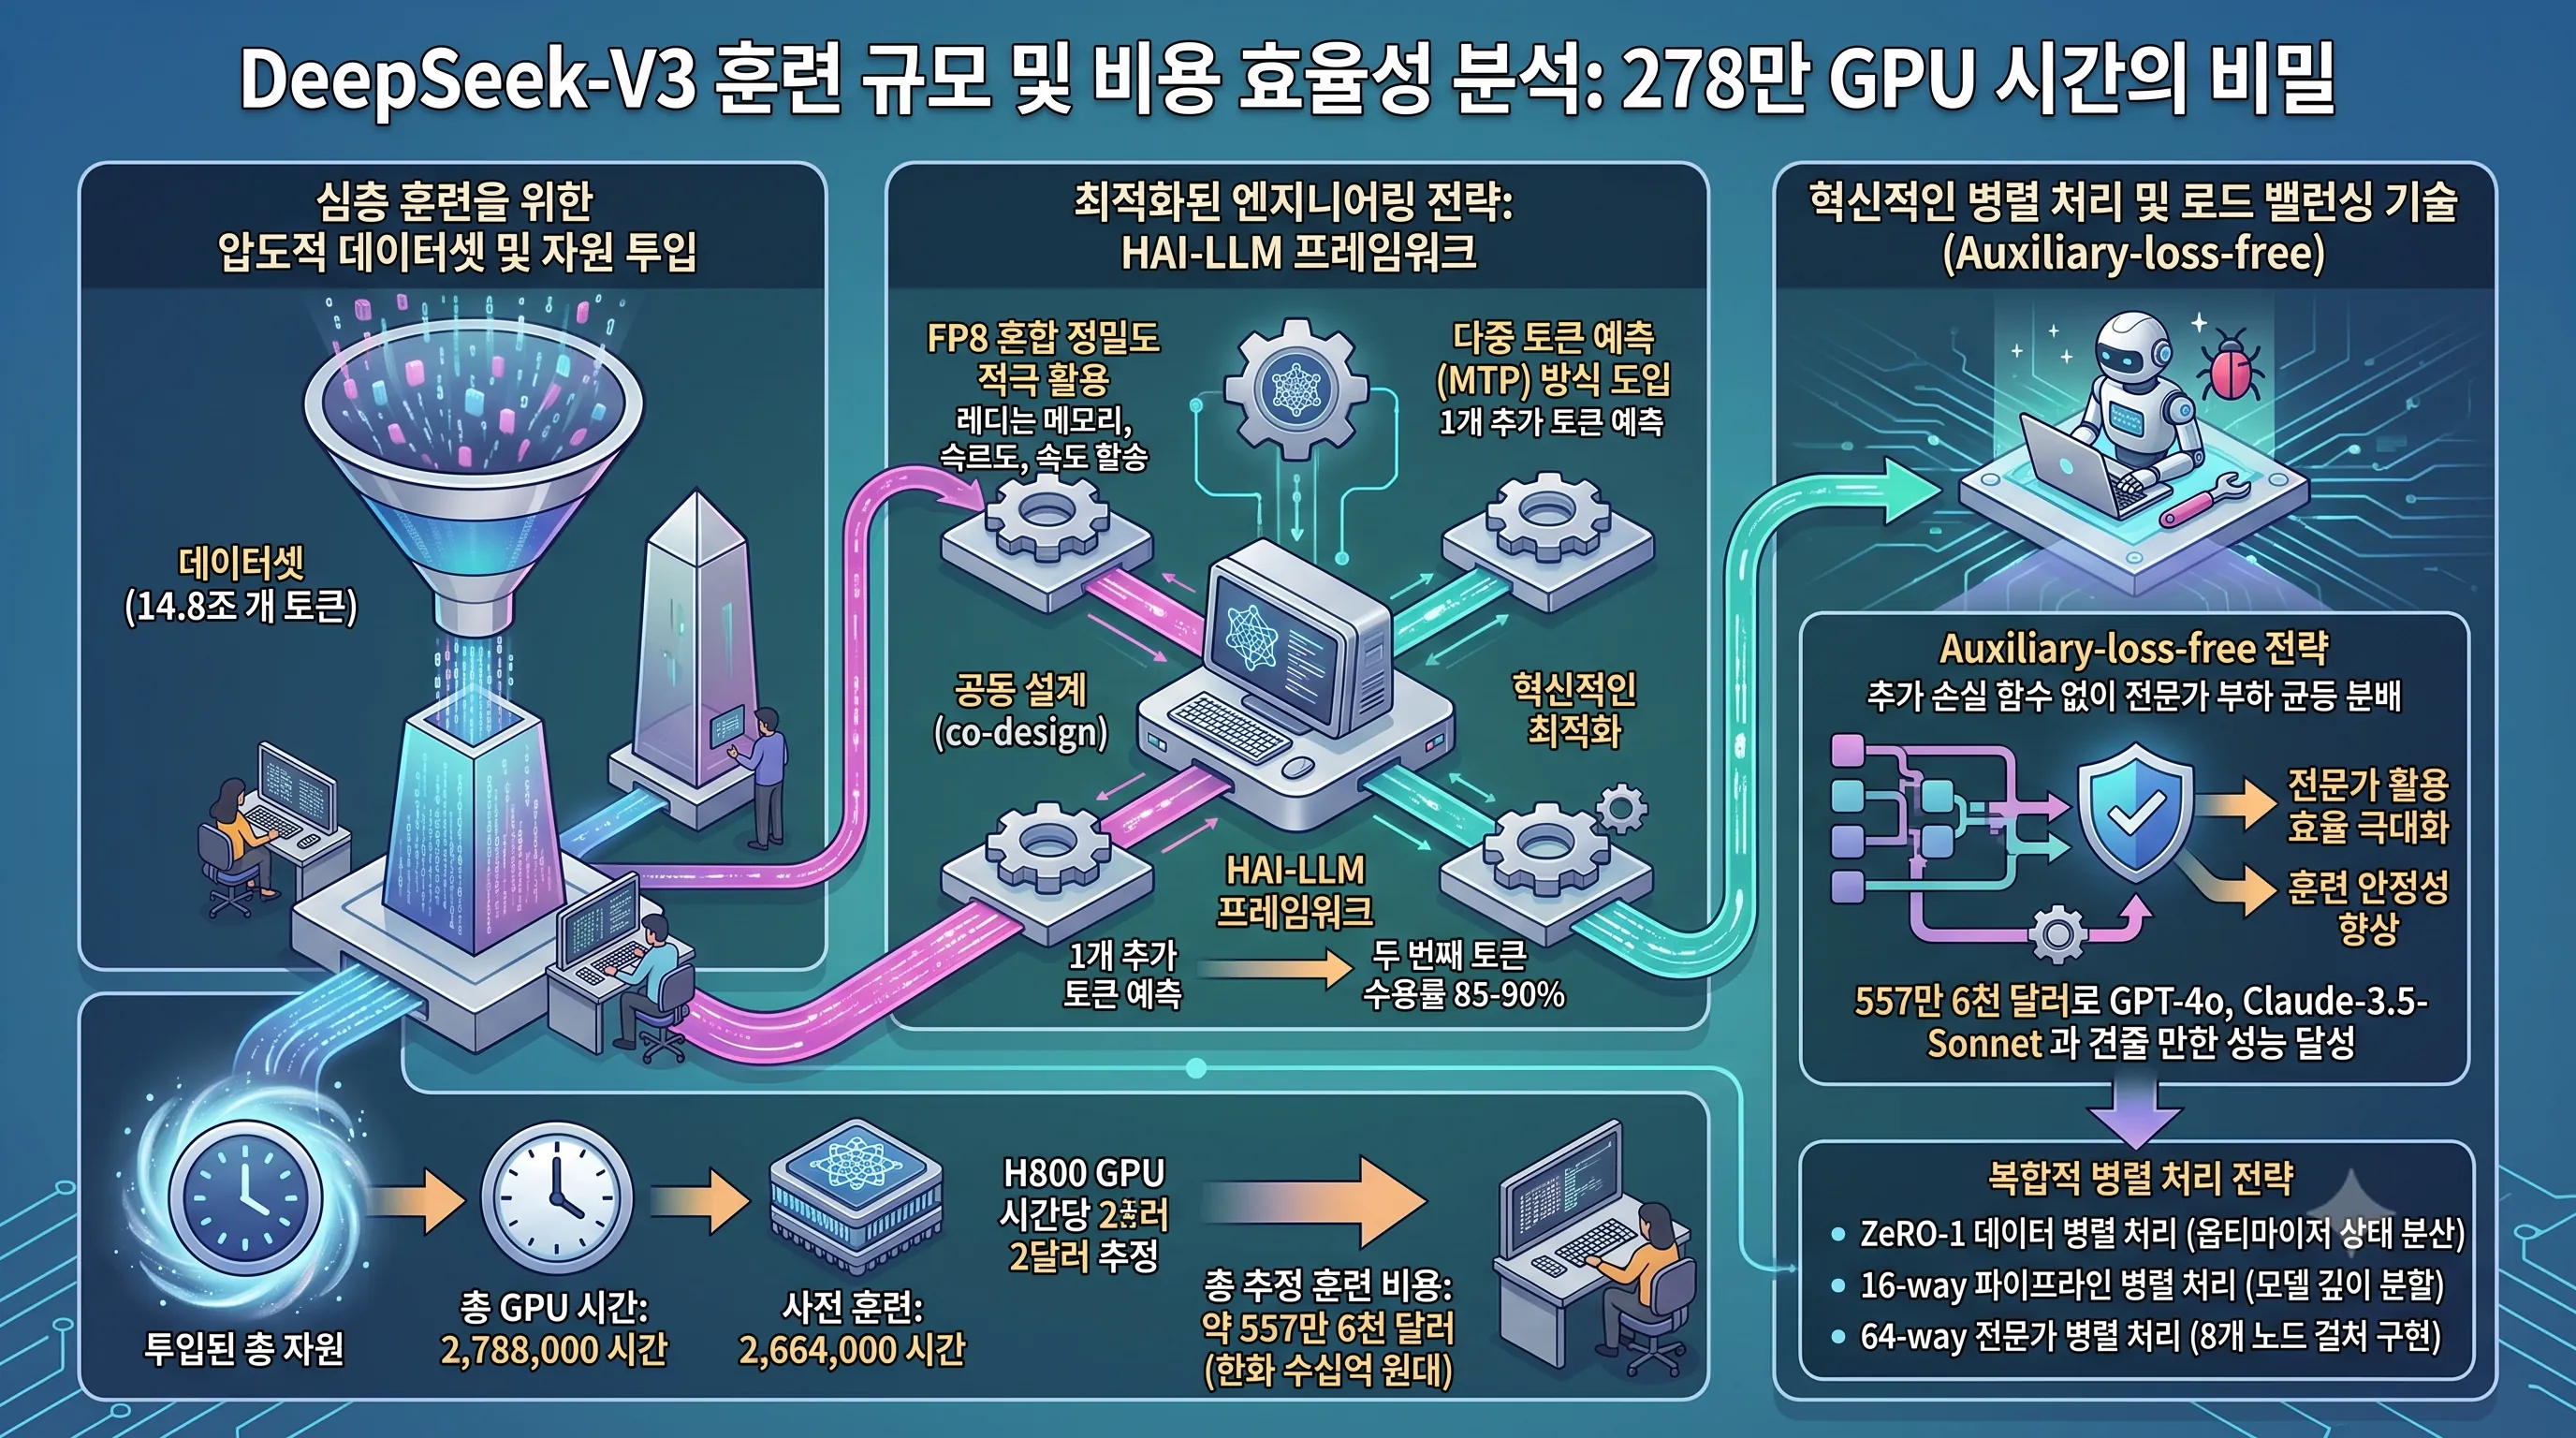
- 총 14.8조 개 토큰으로 훈련되었으며, 2.788M H800 GPU 시간이 투입되어 약 557만 6천 달러의 비용 효율성을 달성했습니다.
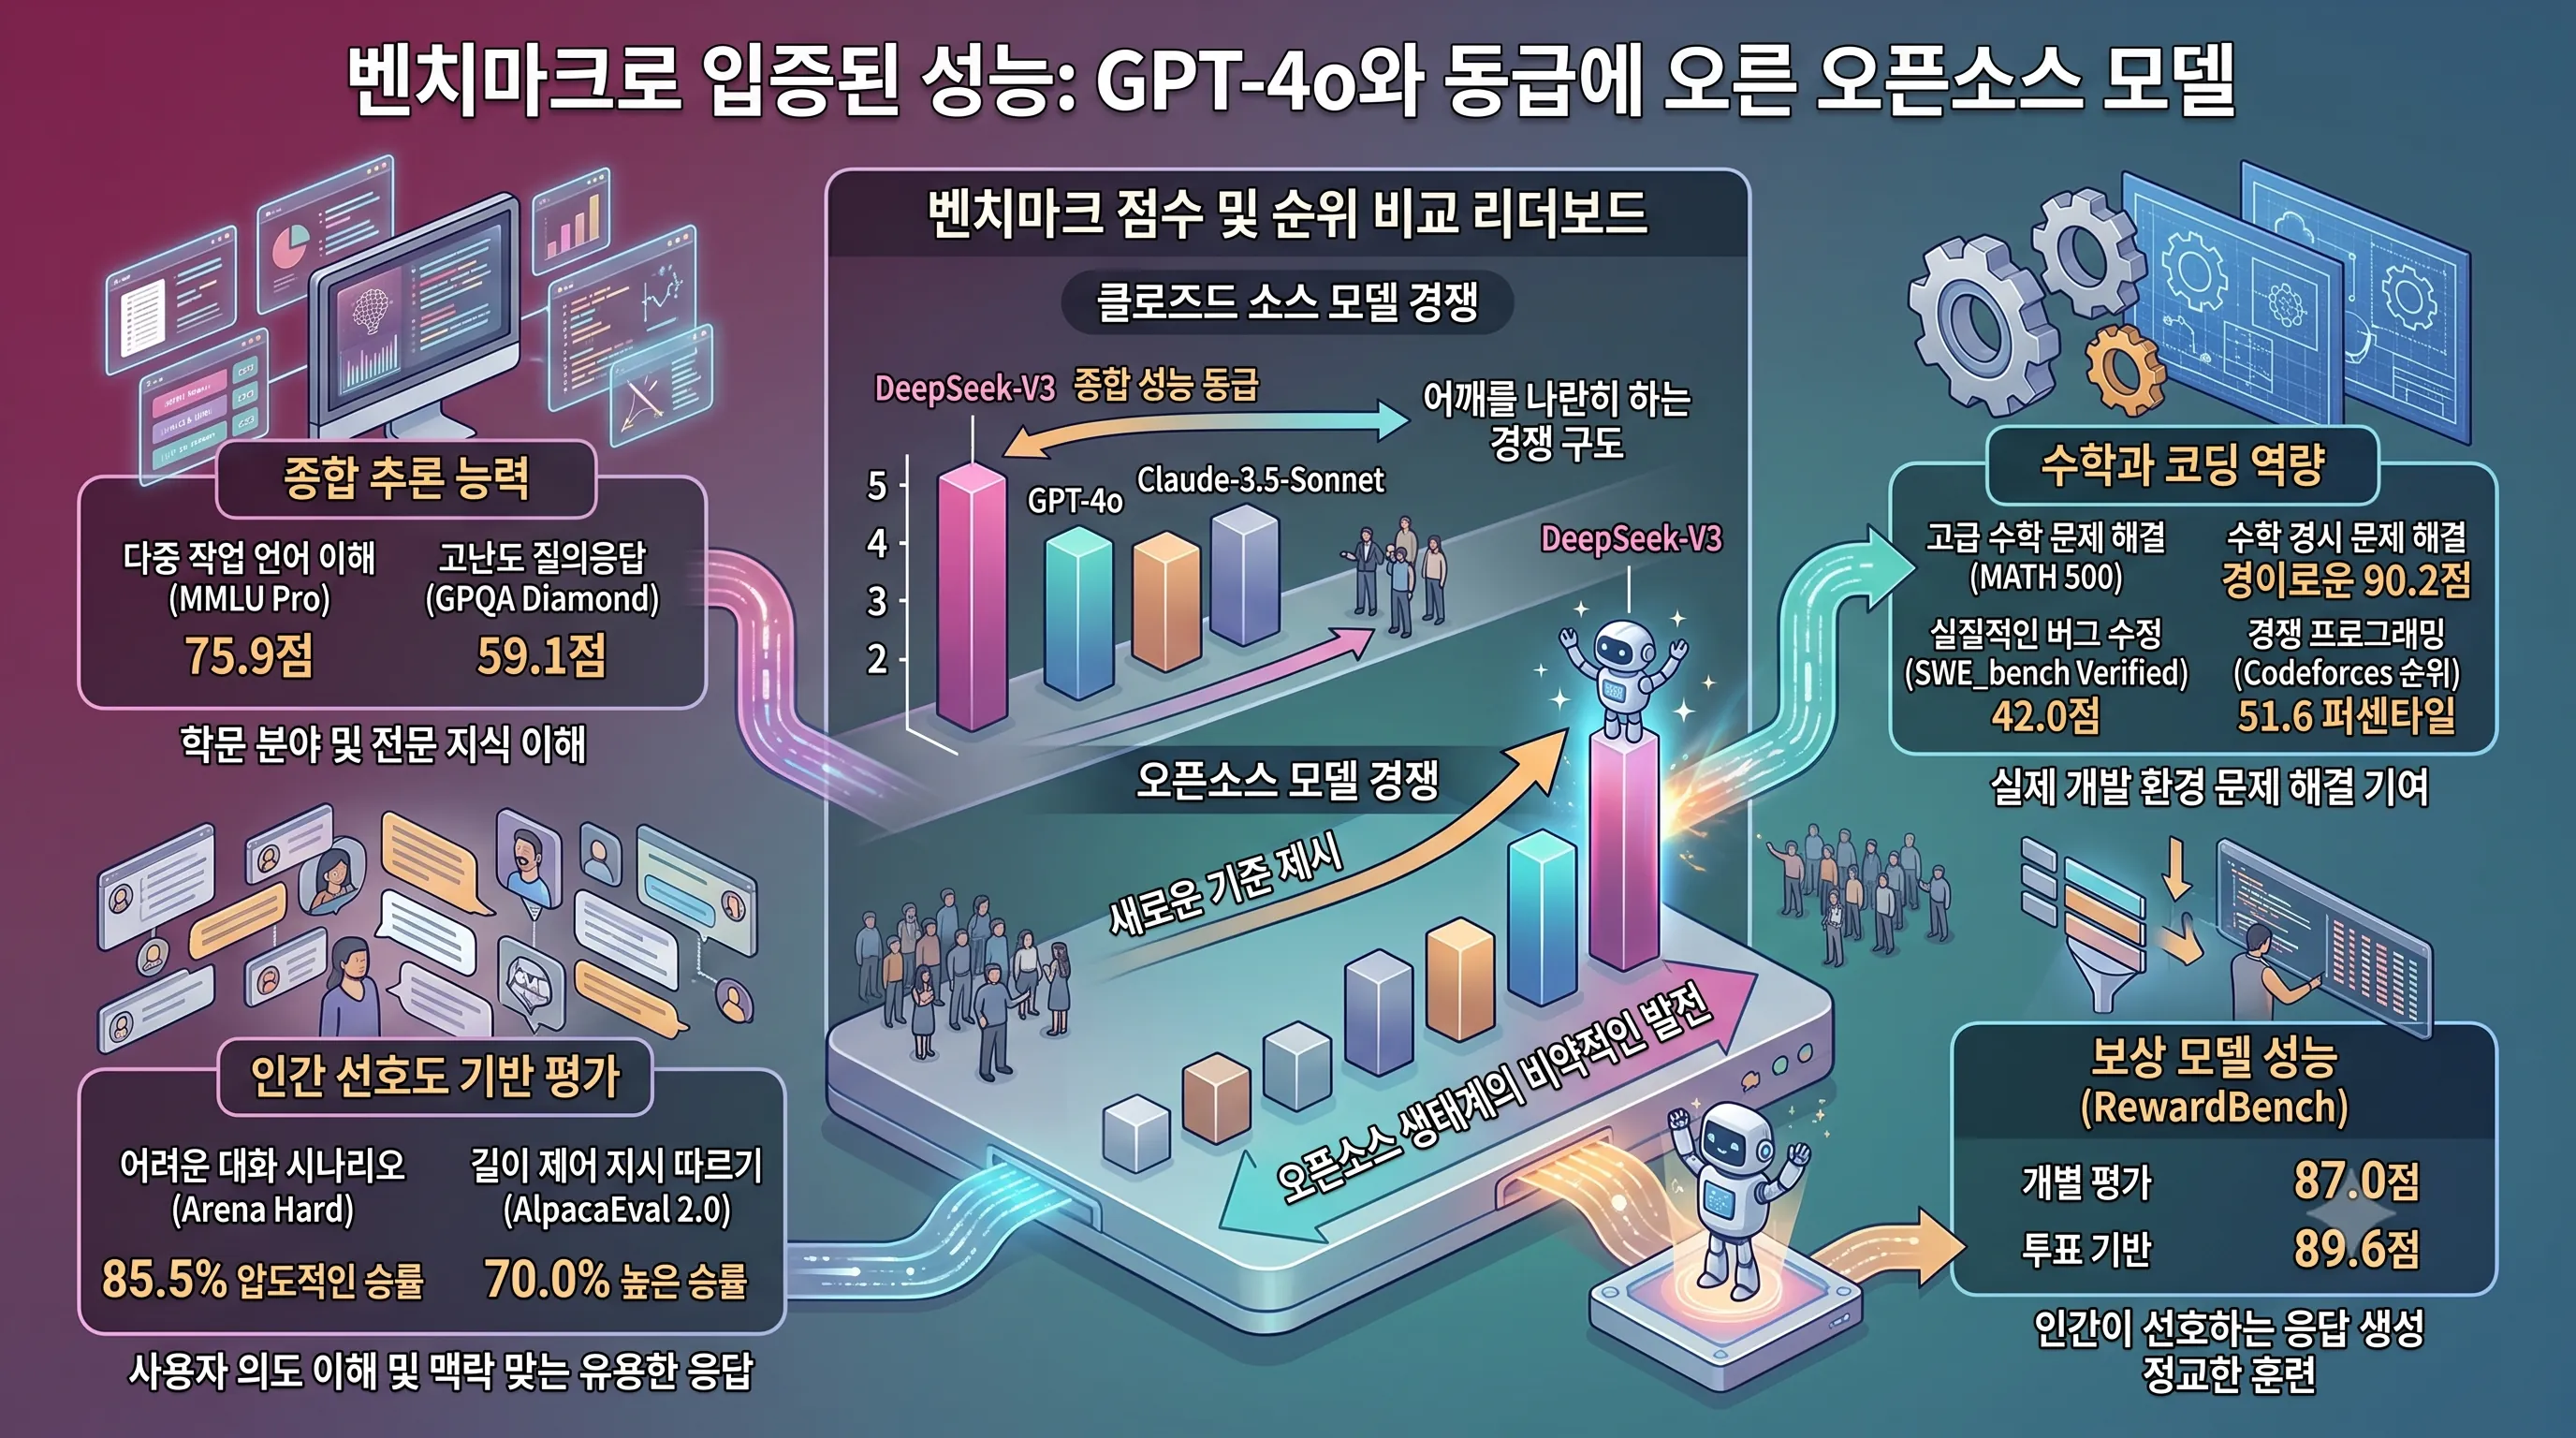
- 벤치마크에서 GPT-4o 및 Claude-3.5-Sonnet과 동급 성능을 입증, 특히 수학 (MATH 500: 90.2점) 및 코딩 (SWE_bench: 42.0%, Codeforces: 51.6 퍼센타일) 분야에서 압도적인 역량을 보여줍니다.
- 인간 선호도 기반 Arena Hard 벤치마크에서 GPT-4-0314 대비 85.5%의 높은 승률을 기록했습니다.
- 배포 시 최적의 성능을 위해 상당한 하드웨어 리소스가 필요하며, 향후 생성 속도 개선 가능성이 있습니다.
1. DeepSeek-V3 핵심 아키텍처: MoE와 MTP의 기술적 혁신
DeepSeek-V3 핵심 아키텍처: MoE와 MTP의 기술적 혁신
2026년 8월 9일 현재, 딥시크-AI(DeepSeek-AI)가 개발한 DeepSeek-V3는 인공지능 언어 모델 분야에서 독보적인 위치를 차지하고 있는 Mixture-of-Experts (MoE) 모델입니다.
이 모델의 정체성을 규정하는 핵심 기술은 바로 거대한 671B(6,710억) 파라미터 규모의 MoE 아키텍처와 혁신적인 Multi-token prediction (MTP) 훈련 방법론에 있습니다.
특히, 딥시크-V3는 방대한 전체 파라미터 중 특정 토큰을 처리할 때 37B(370억) 파라미터만 선별적으로 활성화하여 작동하는 것이 특징입니다.
이는 MoE 모델의 핵심 원리로, 전체 모델의 잠재력을 유지하면서도 실제 연산 부하를 크게 줄여 효율성을 극대화하는 방식입니다.
이러한 설계 덕분에 딥시크-V3는 다른 경쟁 모델들과 비교했을 때 뛰어난 성능과 경제성을 동시에 달성했습니다.
MoE 기반의 압도적 스케일과 효율성: DeepSeekMoE 아키텍처
DeepSeek-V3의 MoE 아키텍처는 자체적으로 개발된 DeepSeekMoE를 기반으로 합니다.
이 아키텍처는 기존 MoE 모델의 단점으로 지적되던 로드 밸런싱 문제를 해결하기 위해 Auxiliary-loss-free 전략을 선구적으로 도입했으며, 이는 전문가(Expert)들의 활용도를 고르게 유지하면서도 추가적인 손실 함수 없이 훈련 안정성을 높이는 데 기여했습니다.
딥시크-V3의 MoE 레이어 구성은 매우 구체적입니다.
각 MoE 레이어에는 1개의 공유 전문가(Shared Expert)와 256개의 라우팅 전문가(Routed Experts)가 포함되어 있습니다.
그리고 각 토큰을 처리할 때는 이 256개의 라우팅 전문가 중에서 단 8개의 전문가만이 활성화됩니다.
이 8개의 전문가가 담당하는 파라미터의 합이 바로 37B에 해당하며, 이는 전체 671B 파라미터 중 극히 일부만을 사용하여 각 토큰에 대한 추론을 수행한다는 것을 의미합니다.
이처럼 선별적으로 전문가를 활용하는 방식은 거대한 모델의 잠재력을 유지하면서도 실제 컴퓨팅 자원 소모를 최소화하여, 한국의 중소기업이나 연구팀에게도 고성능 AI 모델 접근의 가능성을 넓혀줄 수 있는 중요한 기술적 진보로 평가됩니다.
Multi-head Latent Attention (MLA): 잠재 공간 처리의 고도화
DeepSeek-V3의 핵심 아키텍처 중 하나인 Multi-head Latent Attention (MLA)은 모델의 정보 처리 능력을 한 단계 끌어올리는 중요한 역할을 합니다.
기존 어텐션 메커니즘이 입력 시퀀스의 모든 토큰 간 관계를 직접적으로 처리하는 방식이라면, MLA는 보다 추상적인 '잠재 공간(Latent Space)'에서 어텐션 연산을 수행하여 효율성과 복잡한 패턴 인식 능력을 향상시킵니다.
이러한 잠재 공간에서의 처리는 모델이 방대한 데이터를 압축하고, 핵심적인 의미론적 관계를 더욱 효과적으로 포착할 수 있도록 돕습니다.
비록 JSON 데이터에 MLA의 구체적인 작동 방식에 대한 상세한 설명은 없지만, 딥시크-V3가 Multi-head Latent Attention을 핵심 구성 요소로 채택했다는 사실만으로도 이 모델이 단순히 파라미터 수를 늘리는 것을 넘어, 정보 처리 아키텍처 자체의 혁신을 통해 성능을 극대화하려는 노력을 기울였음을 알 수 있습니다.
Multi-token prediction (MTP): 혁신적인 추론 속도 향상
DeepSeek-V3의 또 다른 독보적인 기술 혁신은 바로 훈련 목표로 채택된 Multi-token prediction (MTP)입니다.
기존 언어 모델들은 일반적으로 한 번에 하나의 다음 토큰만을 예측하는 방식으로 훈련되고 추론됩니다.
하지만 딥시크-V3는 MTP를 통해 한 번의 예측으로 1개의 추가 토큰, 즉 총 2개의 토큰을 동시에 예측하도록 훈련되었습니다.
이 기술의 진정한 가치는 추론 과정에서 드러납니다.
모델이 예측한 두 번째 토큰의 정확성이 높다면, 실제 토큰 생성 시 두 번째 토큰까지 한 번에 수용할 수 있게 되어 실질적인 추론 속도를 비약적으로 향상시킵니다.
딥시크-V3의 경우, 예측된 두 번째 토큰의 수용률(Acceptance Rate)이 무려 85-90%에 달합니다.
이는 대부분의 경우 한 번의 추론으로 두 토큰을 얻을 수 있다는 의미이며, 결과적으로 토큰 처리량(TPS, Tokens Per Second)을 1.8배 증가시키는 효과를 가져왔습니다.
이러한 추론 속도 향상은 사용자 경험을 직접적으로 개선하여, 챗봇이나 콘텐츠 생성과 같은 실시간 상호작용이 중요한 애플리케이션에서 딥시크-V3가 더욱 강력한 경쟁력을 가질 수 있게 합니다.
기업들이 대규모 언어 모델을 도입할 때 가장 중요하게 고려하는 요소 중 하나인 추론 비용과 속도 측면에서 MTP는 딥시크-V3에 명확한 우위를 제공하고 있습니다.
2. 역대급 훈련 규모와 비용 효율성 분석: 278만 GPU 시간의 비밀
딥시크(DeepSeek-AI)가 개발한 DeepSeek-V3는 출시 이후 현재까지 오픈소스 거대 언어 모델(LLM)의 훈련 규모와 비용 효율성 측면에서 새로운 기준을 제시했습니다.
총 671B개의 파라미터를 가진 이 MoE(Mixture-of-Experts) 모델은 활성화되는 파라미터가 토큰당 37B에 달하는 방대한 규모임에도 불구하고, 혁신적인 엔지니어링 전략을 통해 훈련 비용을 극적으로 절감한 것으로 평가받고 있습니다.
현재(2026년 8월 9일)까지 DeepSeek-V3의 성공적인 상용화와 벤치마크 성과는 이러한 훈련 과정의 우수성을 명확히 증명하고 있습니다.
심층 훈련을 위한 압도적인 데이터셋과 자원 투입
DeepSeek-V3의 훈련은 그야말로 역대급 규모였습니다.
모델은 14.8조 개에 달하는 방대한 토큰 데이터셋으로 사전 훈련되었는데, 이는 현존하는 어떤 오픈소스 모델과 비교해도 압도적인 수준입니다.
이러한 대규모 데이터셋을 학습시키기 위해 총 2,788,000 H800 GPU 시간이 투입되었으며, 이 중 사전 훈련(Pre-training)에만 2,664,000 H800 GPU 시간이 소요되었습니다.
현재 기준(H800 GPU 시간당 2달러 추정)으로 계산했을 때, 총 훈련 비용은 약 557만 6천 달러(한화 수십억 원대)에 달하는 것으로 추정됩니다.
이는 국내 기업들이 LLM 개발에 투자하는 비용과 비교했을 때도 상당히 큰 규모의 초기 투자가 이루어졌음을 의미하며, 이처럼 막대한 자원이 투입되었음에도 불구하고 DeepSeek-AI는 고도의 엔지니어링 최적화를 통해 비용 효율성을 극대화하는 데 성공했습니다.
최적화된 엔지니어링 전략: 비용 효율성의 핵심
DeepSeek-V3의 개발팀은 엄청난 훈련 규모에도 불구하고 훈련 비용과 안정성을 최적화하기 위해 다각적인 엔지니어링 전략을 구사했습니다.
이들의 핵심 프레임워크는 'HAI-LLM'으로, 이는 대규모 언어 모델의 훈련에 최적화된 내부 개발 프레임워크입니다.
또한, 훈련 과정 전반에 걸쳐 FP8 혼합 정밀도(FP8 mixed precision)를 적극적으로 활용하여 메모리 사용량을 줄이고 연산 속도를 크게 향상시켰습니다.
이는 GPU 자원을 더욱 효율적으로 사용할 수 있게 하여, 결과적으로 전체 훈련 시간을 단축하고 비용을 절감하는 데 결정적인 역할을 했습니다.
훈련 목표(Training Objective)로는 다중 토큰 예측(Multi-token prediction, MTP) 방식이 도입되어, 한 번의 예측으로 추가 토큰을 학습함으로써 훈련 효율을 높였습니다.
실제로 DeepSeek-V3는 한 번에 1개 추가 토큰을 예측하며, 두 번째 토큰 수용률이 85-90%에 달해 훈련 속도 향상에 기여했습니다.
혁신적인 병렬 처리 및 로드 밸런싱 기술
DeepSeek-V3의 훈련은 총 2048개의 NVIDIA H800 GPU를 활용했으며, 최적의 효율을 위해 정교한 병렬 처리 구성이 적용되었습니다.
특히, 16-way 파이프라인 병렬 처리(Pipeline Parallelism, PP)는 모델의 깊이를 효율적으로 분할하여 여러 GPU에 걸쳐 순차적으로 연산을 처리함으로써 메모리 부담을 줄였습니다.
MoE(Mixture-of-Experts) 구조의 특성을 살려 8개 노드에 걸쳐 64-way 전문가 병렬 처리(Expert Parallelism, EP)를 구현하여, 각 MoE 레이어 내의 256개 라우팅된 전문가(routed experts) 중 8개만 토큰당 활성화되도록 하면서도 효율적인 분산 처리를 가능하게 했습니다.
또한, ZeRO-1 데이터 병렬 처리(Data Parallelism, DP)를 통해 옵티마이저 상태(optimizer states)를 여러 GPU에 분산 저장하여 메모리 제약을 완화했습니다。
이러한 복합적인 병렬 처리 전략과 함께, DeepSeek-V3는 특히 'Auxiliary-loss-free'라는 독창적인 로드 밸런싱 전략을 선구적으로 도입했습니다.
기존 MoE 모델들은 전문가(expert)들 간의 부하를 균등하게 분배하기 위해 추가적인 손실 함수(auxiliary loss function)를 사용하는 경우가 많았는데, 이는 훈련의 복잡성을 증가시키고 때로는 안정성을 저해하는 요인이 되기도 했습니다.
DeepSeek-V3는 이러한 추가 손실 함수 없이도 전문가들의 부하를 효과적으로 균등하게 분배하는 기술을 구현했습니다.
이는 DeepSeekMoE 아키텍처와 시너지 효과를 내어 훈련 과정을 단순화하고, 훈련의 안정성을 획기적으로 향상시켰습니다.
결과적으로 DeepSeek-V3는 557만 6천 달러라는 상대적으로 '경제적인' 비용으로 GPT-4o, Claude-3.5-Sonnet과 같은 선도적인 비공개 모델과 견줄 만한 성능을 달성했으며, 이는 최적화된 공동 설계(co-design)와 혁신적인 엔지니어링의 승리라고 할 수 있습니다.
3. 벤치마크로 입증된 성능: GPT-4o와 동급에 오른 오픈소스 모델
최첨단 인공지능 모델 DeepSeek-V3는 2026년 8월 9일 현재, 오픈소스 거대 언어 모델(LLM) 영역에서 독보적인 성능을 입증하며 새로운 기준을 제시하고 있습니다.
특히 마이크로소프트의 GPT-4o, 앤트로픽의 Claude-3.5-Sonnet과 같은 최상위 클로즈드 소스 모델과 어깨를 나란히 하는 경쟁 구도를 형성하며, 오픈소스 생태계의 비약적인 발전을 상징하는 존재로 평가받고 있습니다.
DeepSeek-AI가 개발한 이 모델은 다양한 벤치마크 테스트에서 인상적인 결과를 기록하며, 그 기술적 역량을 전 세계에 과시했습니다.
종합 추론 능력: 최상위권에 합류한 DeepSeek-V3
DeepSeek-V3는 복잡한 추론 능력을 평가하는 핵심 벤치마크에서 클로즈드 소스 모델에 필적하는 뛰어난 성과를 달성했습니다.
특히, 다중 작업 언어 이해도를 측정하는 대표적인 벤치마크인 MMLU Pro에서 75.9점이라는 높은 점수를 기록했습니다.
이는 모델이 다양한 학문 분야와 전문 지식 영역에 걸쳐 깊이 있는 이해력과 추론 능력을 갖추고 있음을 명확히 보여주는 수치입니다.
또한, 고난도 질의응답 데이터셋인 GPQA Diamond Pass@1에서도 59.1점을 획득하며, 정교하고 미묘한 질문에 대한 정확한 답변을 도출하는 능력이 탁월함을 입증했습니다.
이러한 결과는 DeepSeek-V3가 단순히 지식을 나열하는 것을 넘어, 복잡한 정보를 통합하고 분석하여 논리적인 결론을 도출하는 데 있어 인간 수준의 인지 능력에 근접했음을 시사합니다.
수학과 코딩 분야의 압도적인 역량
DeepSeek-V3는 특히 수학 및 코딩 분야에서 타의 추종을 불허하는 압도적인 성능을 선보여 업계 전문가들의 찬사를 받고 있습니다.
고급 수학 문제를 푸는 능력을 평가하는 MATH 500 벤치마크에서 무려 90.2점이라는 경이로운 점수를 달성했습니다.
이는 복잡한 계산과 논리적 추론이 필요한 수학 문제 해결에 있어 DeepSeek-V3가 독보적인 강점을 가지고 있음을 의미합니다.
2024년에 실시된 AIME(American Invitational Mathematics Examination) 테스트에서도 39.2점을 기록하며, 모델이 실질적인 수학 경시 문제 해결 능력까지 갖추었음을 입증했습니다.
더 나아가, 실제 소프트웨어 버그를 찾아내고 수정하는 능력을 평가하는 SWE_bench Verified Resolved 부문에서 42.0점을 기록했으며, 경쟁 프로그래밍 플랫폼인 Codeforces 순위에서는 51.6 퍼센타일에 도달했습니다.
이러한 수치들은 DeepSeek-V3가 단순한 코드 생성기를 넘어, 실제 개발 환경에서 복잡한 문제 해결과 코드 디버깅에 기여할 수 있는 수준의 코딩 역량을 보유하고 있음을 명확히 보여줍니다.
국내 기업들은 이 모델을 활용해 소프트웨어 개발 프로세스를 혁신하고, 기술 경쟁력을 한층 강화할 수 있을 것으로 기대됩니다.
인간 선호도 기반 평가: 클로즈드 소스와의 진정한 경쟁
DeepSeek-V3의 진정한 경쟁력은 인간의 선호도를 직접적으로 반영하는 벤치마크에서 GPT-4o와 같은 최상위 클로즈드 소스 모델과 견줄 만한 성과를 보였다는 점에 있습니다.
어려운 대화 시나리오에서 모델의 응답 품질을 평가하는 Arena Hard 벤치마크에서 기준 모델인 GPT-4-0314 대비 무려 85.5%의 압도적인 승률을 기록했습니다.
이는 DeepSeek-V3가 단순히 정확한 답변을 제공하는 것을 넘어, 사용자의 의도를 깊이 이해하고 맥락에 맞는 자연스럽고 유용한 응답을 생성하는 능력이 매우 뛰어나다는 것을 의미합니다.
또한, 언어 모델의 유용성과 지시 따르기 능력을 평가하는 AlpacaEval 2.0(길이 제어 버전)에서도 70.0%의 높은 승률을 달성했습니다.
이러한 결과는 DeepSeek-V3가 사용자 경험 측면에서 GPT-4o 및 Claude-3.5-Sonnet과 같은 시장 선도 모델들과 비교했을 때 거의 차이가 없거나, 특정 영역에서는 오히려 우위를 점할 수 있음을 강력하게 시사합니다.
DeepSeek-V3는 보상 모델(Reward Model)의 성능을 측정하는 RewardBench에서도 개별 평가 87.0점, 투표 기반 89.6점을 기록하며, 인간이 선호하는 응답을 생성하도록 정교하게 훈련되었음을 입증했습니다.
이러한 포괄적인 벤치마크 성과는 DeepSeek-V3가 단순한 오픈소스의 한계를 넘어, 범용 AI 모델로서 최고 수준의 경쟁력을 확보했음을 분명히 보여줍니다.
4. 종합 평가: 압도적 장점과 명확한 배포 시 고려사항
종합적인 평가에서 DeepSeek-V3 모델은 오픈소스 언어 모델 분야에 새로운 기준점을 제시하며 강력한 입지를 구축하고 있습니다.
총 671B개의 매개변수와 토큰당 37B개의 활성화된 매개변수를 가진 이 Mixture-of-Experts (MoE) 모델은 그 규모만큼이나 인상적인 성능을 보여주며, 오픈소스 생태계에서 독보적인 위치를 차지하고 있습니다.
특히 2026년 8월 9일 현재, 여러 벤치마크에서 기존 오픈소스 모델들을 압도하는 성과를 보였을 뿐만 아니라, GPT-4o나 Claude-3.5-Sonnet과 같은 선도적인 클로즈드소스 모델들과도 견줄만한 성능을 달성하여 기술적 진보의 최전선에 서 있음을 입증했습니다.
이는 DeepSeek-AI가 독자적으로 개발한 Multi-head Latent Attention (MLA) 및 DeepSeekMoE와 같은 핵심 아키텍처, 그리고 Multi-token prediction (MTP)과 같은 혁신적인 훈련 목적 함수가 시너지를 낸 결과로 평가됩니다.
압도적인 성능과 경제성: 오픈소스 AI의 새 지평
DeepSeek-V3의 가장 큰 강점 중 하나는 수학 및 코딩 능력에서 발휘하는 탁월함입니다.
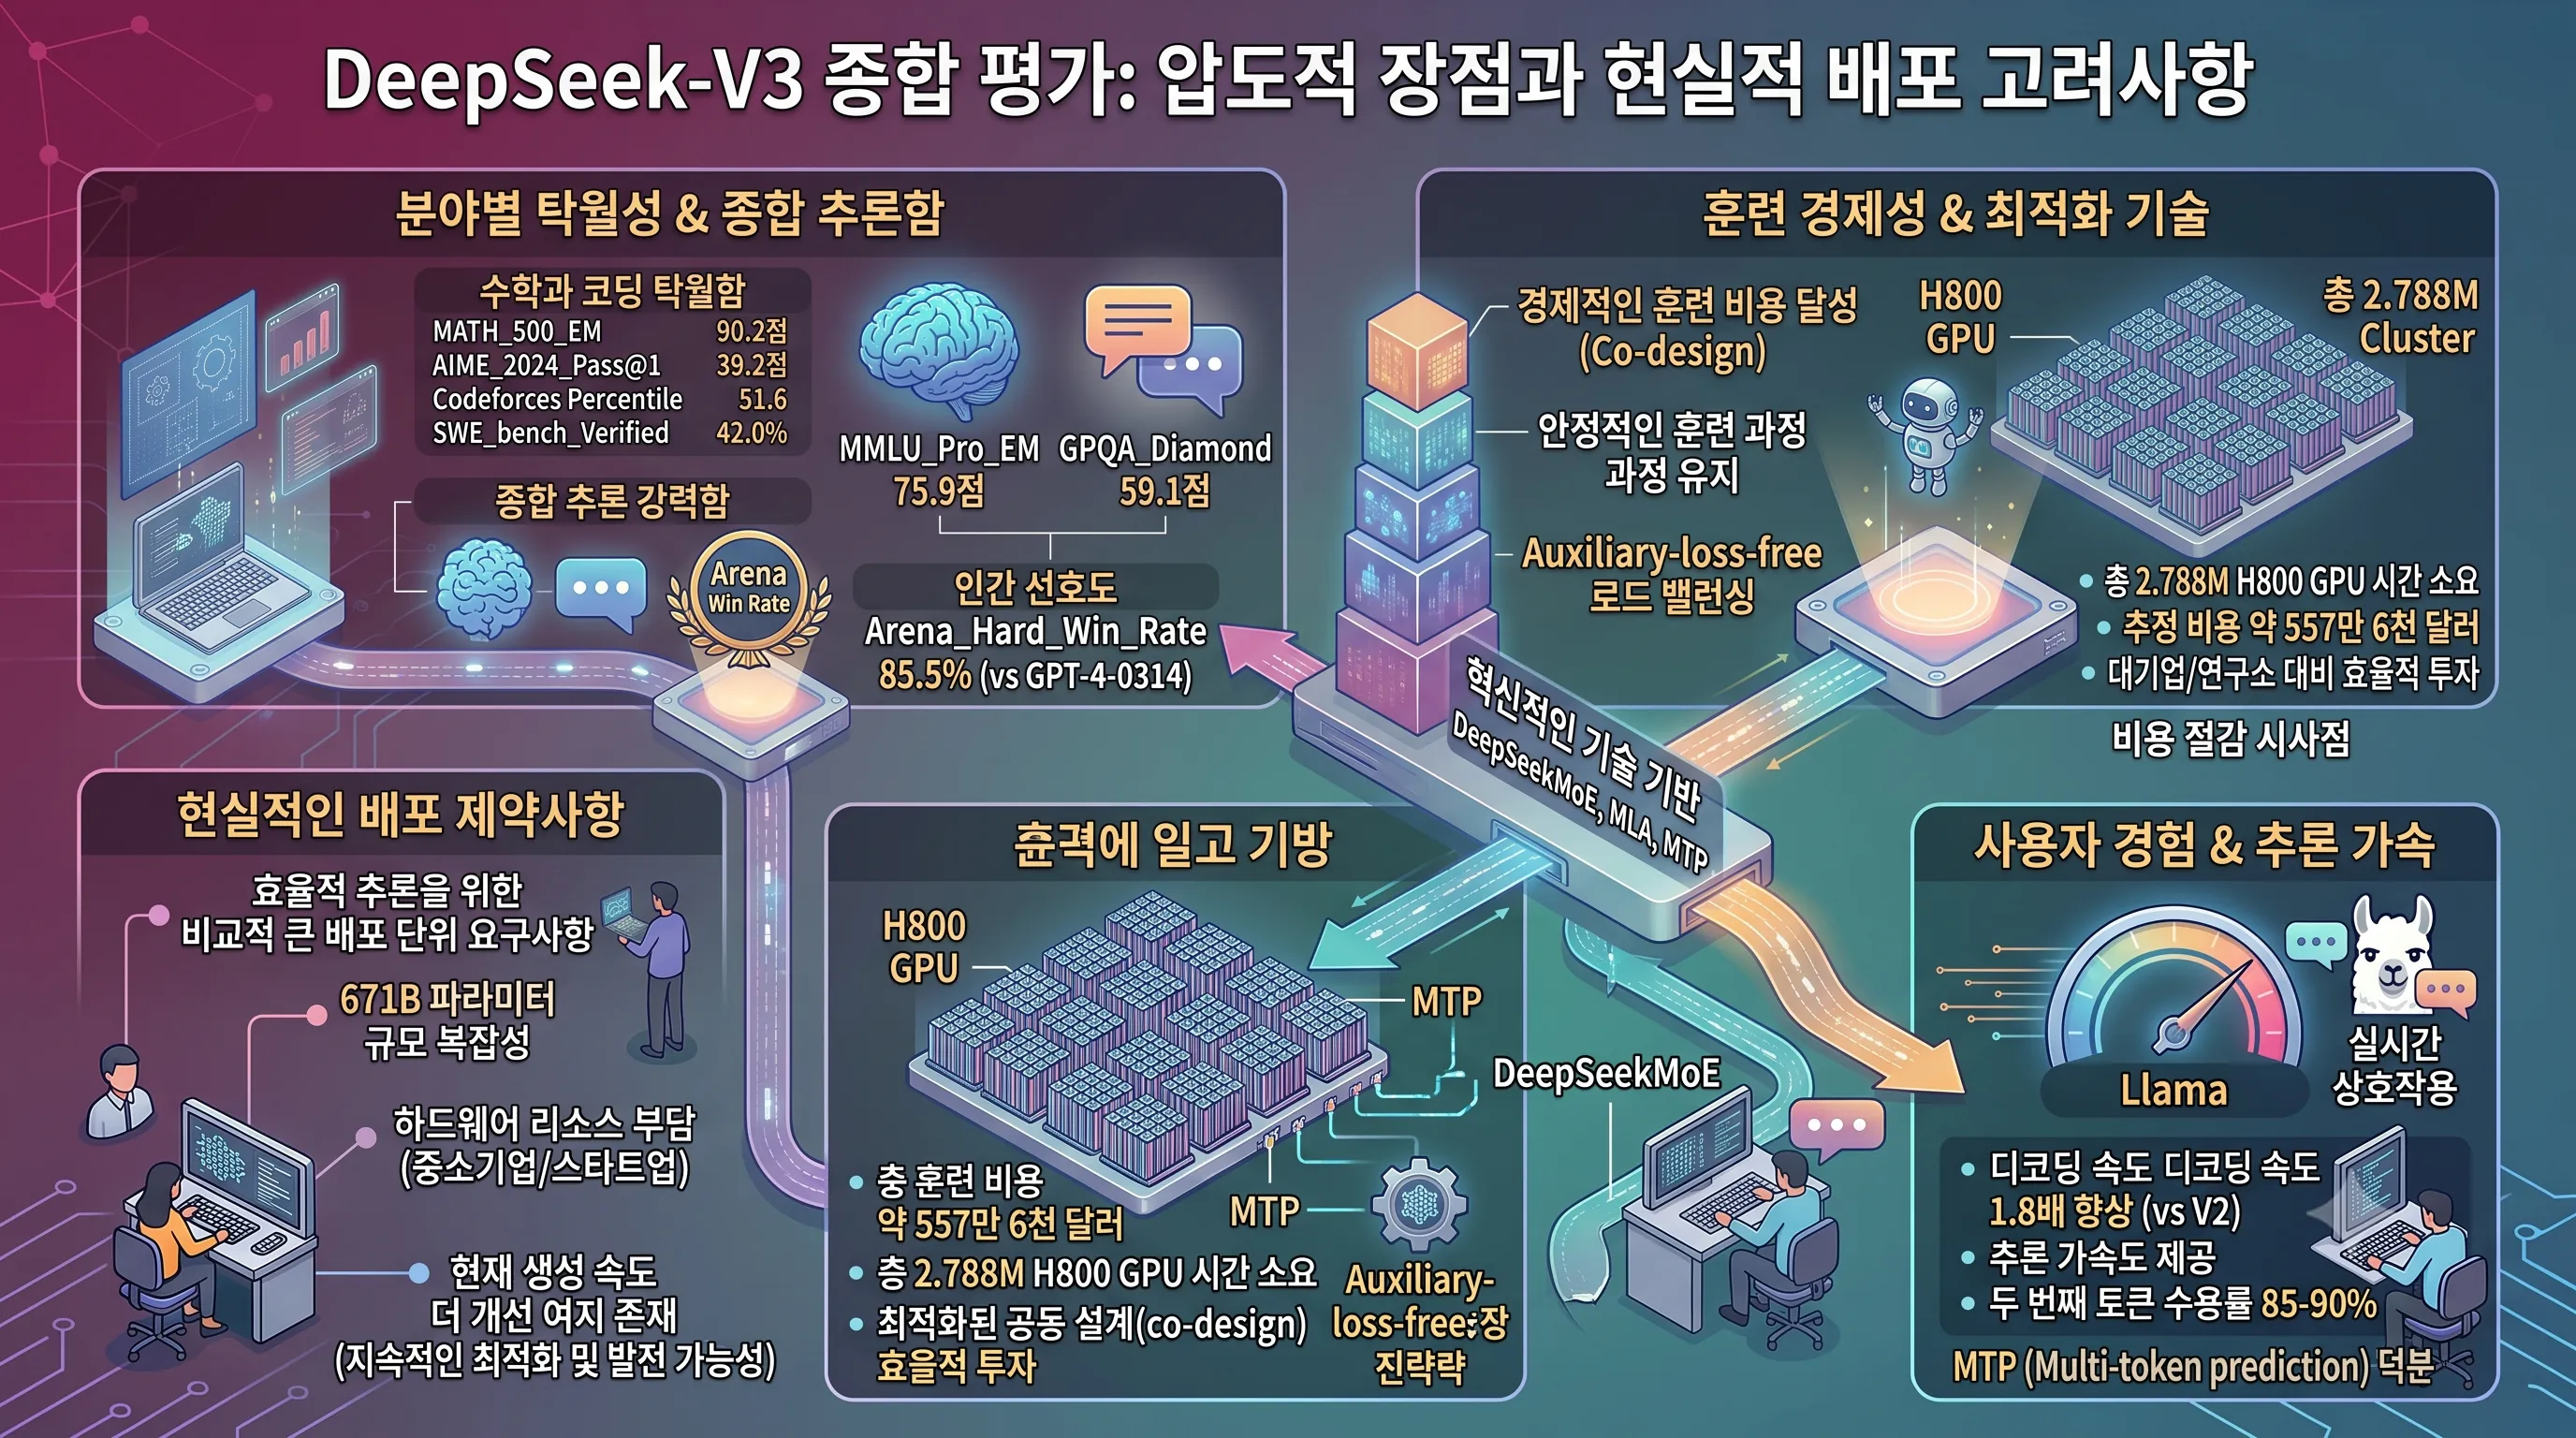
| 카테고리 | 벤치마크 | 점수/승률 |
|---|---|---|
| 수학 | MATH_500_EM | 90.2점 |
| 수학 | AIME_2024_Pass@1 | 39.2점 |
| 코딩 | Codeforces Percentile | 51.6 |
| 코딩 | SWE_bench_Verified_Resolved | 42.0% |
| 추론 | MMLU_Pro_EM | 75.9점 |
| 추론 | GPQA_Diamond_Pass@1 | 59.1점 |
| 인간 선호도 | Arena_Hard_Win_Rate (vs GPT-4-0314) | 85.5% |
이러한 성능은 국내 소프트웨어 개발 및 연구 환경에서 DeepSeek-V3가 혁신적인 도구로 활용될 잠재력을 의미합니다.
또한, MMLU_Pro_EM에서 75.9점, GPQA_Diamond_Pass@1에서 59.1점을 기록하며 일반적인 추론 능력에서도 뛰어난 모습을 보였습니다.
특히 GPT-4-0314 모델을 상대로 Arena_Hard_Win_Rate에서 85.5%의 승률을 기록한 것은 이 모델이 얼마나 강력한 경쟁력을 가졌는지 명확히 보여주는 지표입니다.
모델의 훈련 경제성 또한 주목할 만한 장점입니다.
총 2.788M H800 GPU 시간이 소요된 전체 훈련 과정에서 추정되는 비용은 약 557만 6천 달러에 불과합니다.
이러한 수치는 국내 대기업이나 연구 기관에서 자체 대규모 언어 모델을 개발하거나 도입할 때 직면하는 막대한 비용과 비교해 볼 때, 최적화된 공동 설계(co-design)를 통해 매우 효율적인 투자가 이루어졌음을 시사합니다.
이러한 경제성은 DeepSeek-AI가 개척한 보조 손실 없는 부하 분산 전략과 Multi-token prediction (MTP) 훈련 방식을 통해 달성되었으며, 안정적인 훈련 과정을 유지하면서도 높은 성능을 구현했습니다.
이는 특히 AI 개발 비용 절감에 대한 관심이 높은 국내 산업계에 중요한 시사점을 제공합니다.
사용자 경험 측면에서는 MTP를 통한 디코딩 속도 향상이 큰 이점으로 작용합니다.
DeepSeek-V3는 MTP 덕분에 이전 버전인 DeepSeek-V2 대비 1.8배 빠른 추론 가속도를 제공하며, 이는 실시간 상호작용이 중요한 애플리케이션에서 사용자 만족도를 크게 높일 수 있습니다.
특히 MTP는 하나의 예측 깊이에서 추가 토큰을 예측하며, 두 번째 토큰 수용률이 85~90%에 달해 실제 사용 환경에서의 체감 속도 향상에 크게 기여하고 있습니다.
이러한 속도 개선은 대규모 텍스트 생성, 실시간 질의응답 시스템, 복잡한 코드 자동 완성 등 다양한 국내 서비스에 긍정적인 영향을 미칠 것으로 예상됩니다.
현실적인 배포 고려사항: 최적화를 위한 조건
이처럼 강력한 장점에도 불구하고, DeepSeek-V3를 실제 환경에 배포할 때 고려해야 할 몇 가지 현실적인 제약 사항이 있습니다.
가장 중요한 것은 효율적인 추론을 위한 비교적 큰 배포 단위 요구사항입니다.
모델의 복잡성과 규모(671B 파라미터)로 인해, DeepSeek-V3는 최적의 성능을 발휘하기 위해 상당한 수준의 하드웨어 리소스를 필요로 합니다.
이는 GPU 메모리와 컴퓨팅 파워 측면에서 중소 규모의 국내 기업이나 스타트업에게는 잠재적으로 높은 초기 투자 비용과 운영 부담으로 작용할 수 있습니다.
따라서 배포를 고려하는 기업은 현재 보유한 인프라와 예상되는 운영 비용을 면밀히 분석하고, 필요한 경우 클라우드 기반의 대규모 인스턴스 사용을 검토해야 할 것입니다.
또한, 현재의 생성 속도는 이전 버전에 비해 크게 개선되었음에도 불구하고 '현재보다 더 개선될 여지가 있다'고 명시되어 있습니다.
비록 DeepSeek-V2 대비 1.8배 빠른 속도를 자랑하지만, 더욱 빠른 응답 속도를 요구하는 특정 고성능 애플리케이션의 경우, 향후 추가적인 최적화와 발전 가능성을 염두에 두어야 합니다.
이는 DeepSeek-AI가 지속적으로 모델을 개선하고 있음을 시사하며, 미래 버전에서는 더욱 향상된 생성 속도를 기대할 수 있음을 의미합니다.
국내 AI 개발자들이나 서비스 제공자들은 이러한 한계를 인지하고, 애플리케이션의 요구사항과 모델의 현재 성능 사이의 균형을 신중하게 평가하여 배포 전략을 수립해야 합니다.
관련 글