LLM 구조적 한계 극복: Outlines, Pydantic, Dottxt API로 안정적 구조화
- LLM의 Simple_Prompt_Method는 예측 불가능한 출력, 마크다운 백틱 오류, 누락된 쉼표, 타입 불일치 등을 야기하여 JSONDecodeError와 같은 파싱 오류를 초래하는 구조적 한계를 가집니다.
- Outlines는 LLM의 이러한 한계를 해결하기 위해 등장한 프레임워크로, 100% 수학적 보장을 통해 구조화된 LLM 출력을 직접 보장하며, 스키마를 위반하는 토큰 생성을 차단합니다.
- Outlines의 주요 특징은 압도적인 속도와 안정성 (마이크로초 단위 오버헤드, 100% 스키마 준수), 유연한 공급자 독립성 (코드 변경 없는 모델 전환, 다양한 LLM 호환), 그리고 탁월한 단순성 (저추상화 라이브러리, model(prompt, output_type) 형태의 쉬운 통합)입니다.
- Pydantic은 LLM 응답, API 페이로드 등 신뢰할 수 없는 원시 데이터의 정교한 검증을 위한 파이썬 라이브러리로, 필드 유효성 검사기 (Wrap, Plain, Before, AfterValidator) 및 모델 유효성 검사기를 통해 데이터 무결성을 보장합니다.
- Pydantic은 Annotated_Pattern과 Decorator_Pattern을 활용하여 검증 로직의 재사용성을 높이고, ValueError 및 PydanticCustomError로 상세한 예외 처리를 지원합니다.
- Dottxt API는 Outlines를 개발한 .txt에서 제공하는 상용 솔루션으로, 자체 GPU나 설정 없이 단순한 REST API 호출만으로 100% 스키마 준수의 구조화된 LLM 출력을 보장합니다.
1. LLM의 구조적 한계와 Outlines의 등장
대규모 언어 모델(LLM)의 급격한 발전은 인공지능(AI) 분야에 혁혁한 공헌을 했지만, 그 본질적인 특성에서 비롯되는 몇 가지 구조적 한계를 내포하고 있습니다.
특히, 전통적인 Simple_Prompt_Method 방식을 통해 LLM으로부터 원하는 형식의 데이터를 얻으려 할 때, 그 출력 데이터는 예측 불가능성과 다양한 파싱 오류의 위험을 안고 있습니다.
이는 LLM이 기본적으로 다음 토큰을 확률적으로 예측하여 생성하기 때문이며, 이러한 방식은 사용자에게 필요한 엄격한 데이터 구조를 보장하기 어렵습니다.
LLM Simple_Prompt_Method의 구조적 한계
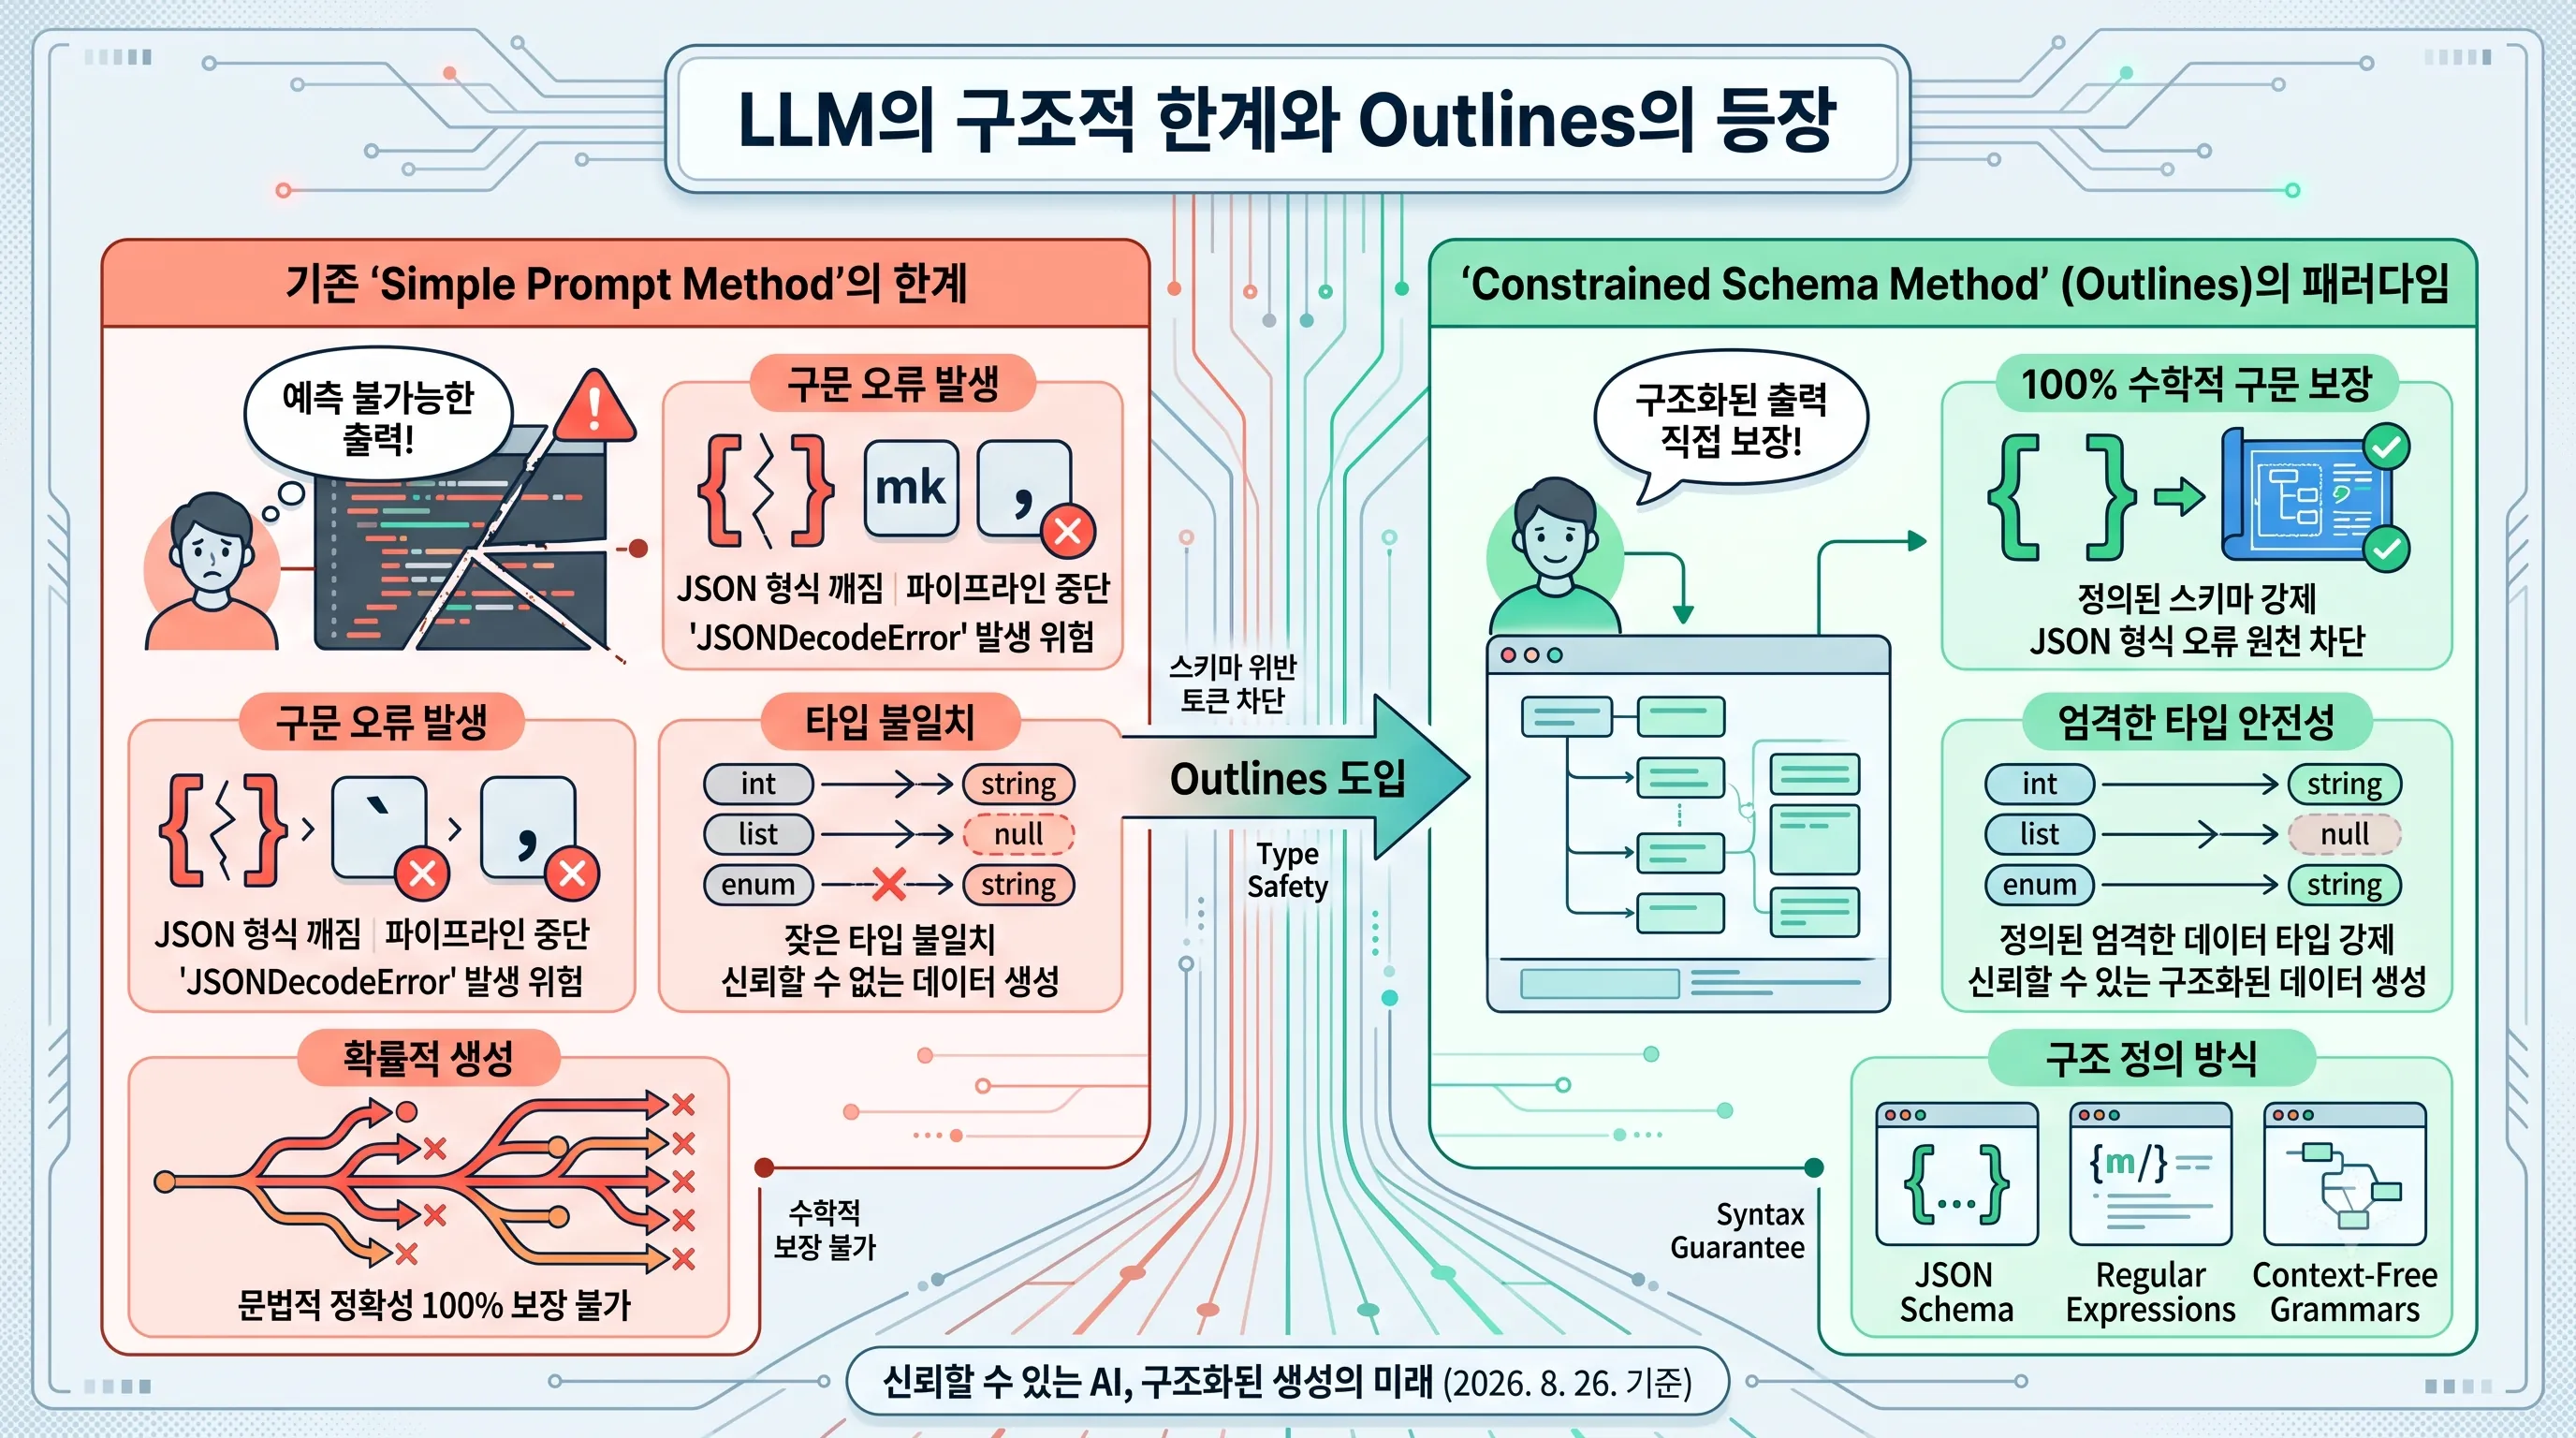
Simple_Prompt_Method를 사용할 경우, LLM의 출력은 종종 예상치 못한 구문 오류를 발생시킵니다.
가장 흔한 사례로는 마크다운 백틱이 올바르게 닫히지 않거나, 누락된 쉼표로 인해 JSON 형식이 깨지는 경우가 있습니다.
이는 `Structured_Output_Comparison` 데이터에서 `Simple_Prompt_Method`의 `Syntax_Guarantee`가 '확률적(Probabilistic)'이라고 명시된 것처럼, LLM이 문법적 정확성을 100% 보장하지 못하기 때문입니다.
결과적으로, 서버에서 `JSONDecodeError`가 발생하여 전체 파이프라인이 중단되는 치명적인 오류로 이어질 수 있습니다.
| 특징 | Simple_Prompt_Method | Constrained_Schema_Method (Outlines) |
|---|---|---|
| 구문 보장 (Syntax_Guarantee) | 확률적 (Probabilistic), 100% 보장 불가 | 100% 수학적 보장 (100% mathematical guarantee) |
| 출력 구조 | 예측 불가능, 마크다운 백틱 오류, 쉼표 누락 등 구문 오류 발생 | 구조화된 출력을 직접 보장, 스키마 위반 토큰 생성 차단 |
| 타입 안전성 (Type_Safety) | 잦은 타입 불일치 (Type Mismatches) 문제, 필수 필드 `null` 누락 | 정의된 엄격한 데이터 타입(int, list, enum) 강제, 타입 불일치 원천 방지 |
| 오류 복구 (Error_Recovery) | 서버 `JSONDecodeError` 발생 및 파이프라인 중단 위험 | 서버 `JSONDecodeError` 위험 제거, Pydantic과 함께 사용 시 자동 재시도 루프를 통한 자가 치유(self-healing) 가능 |
또한, LLM은 `Simple_Prompt_Method`에서 빈번한 타입 불일치(Type Mismatches) 문제를 야기합니다.
예를 들어, 숫자여야 할 데이터가 문자열로 출력되거나, 필수 필드가 `null`로 누락되는 경우가 발생합니다.
이러한 문제는 정의된 엄격한 데이터 타입을 지키지 못하여 데이터 처리의 신뢰성을 크게 저해합니다.
이러한 한계점들은 LLM이 원시적이고 신뢰할 수 없는 데이터(untrusted data)를 생성할 가능성을 보여주며, 이는 API 페이로드, 설정 파일, 사용자 입력 등 중요한 시스템과의 통합 시 심각한 문제를 초래할 수 있습니다.
Outlines: 구조화된 출력을 보장하는 새로운 패러다임
이러한 LLM의 구조적 한계를 근본적으로 해결하기 위해 Outlines가 등장했습니다.
Outlines의 핵심 기능은 `LLM으로부터의 생성 과정에서 구조화된 출력을 직접 보장`하는 것입니다.
이는 `Structured_Output_Comparison` 데이터에서 `Constrained_Schema_Method`가 100% 수학적 보장(100% mathematical guarantee)을 제공하며, '스키마를 위반하는 토큰 생성을 차단(blocks token generation that violates schema)'한다고 설명된 원리와 동일합니다.
Outlines는 LLM이 토큰을 생성하는 과정 자체에 제약 조건을 부여하여, 미리 정의된 스키마에 부합하는 출력만을 생성하도록 강제합니다.
Outlines는 LLM의 예측 불가능성을 극복하고 `Syntax_Guarantee` 및 `Type_Safety` 측면에서 혁신적인 솔루션을 제공합니다.
특히, `Constrained_Schema_Method`는 정의된 엄격한 데이터 타입(int, list, enum)을 강제하여, `Simple_Prompt_Method`에서 발생하던 잦은 타입 불일치 문제를 원천적으로 방지합니다.
또한, 스키마 위반 토큰 생성을 차단함으로써 `Error_Recovery` 단계에서 서버 `JSONDecodeError`와 같은 파이프라인 중단 위험을 제거합니다.
만약 Pydantic과 같은 유효성 검사 도구를 함께 사용한다면, 스키마 유효성 검사에 실패하더라도 구체적인 오류 메시지를 제공하여 자동 재시도 루프를 통해 자체 치유(self-healing) 메커니즘을 구현할 수 있습니다.
Outlines의 핵심 기능 및 장점
Outlines는 단순히 구조적 출력을 보장하는 것을 넘어, 개발자와 사용자 모두에게 강력한 이점을 제공합니다.
주요 기능으로는 간단한 통합(Simple integration)이 있습니다. 사용자는 원하는 출력 타입을 `model(prompt, output_type)` 형태로 전달하기만 하면 됩니다.
이를 통해 파싱 오류나 깨진 JSON 없이 100% 유효한 구조를 보장받을 수 있습니다.
또한, OpenAI, Ollama, vLLM, Transformers, llama.cpp, MLX-LM, SgLang, TGI, Anthropic, Gemini, Dottxt 등 다양한 LLM 프로바이더와 호환되므로, 코드 변경 없이 모델을 전환할 수 있는 '프로바이더 독립성(Provider independence)'을 제공합니다.
Outlines는 JSON 스키마, 정규 표현식(regular expressions), 문맥 자유 문법(context-free grammars)과 같은 풍부한 구조 정의 방식을 지원하여 매우 복잡하고 정교한 출력 요구사항도 충족시킬 수 있습니다.
특히, Outlines는 `100% 스키마 준수(100% schema compliance)`를 보장하며, 이는 신뢰할 수 없는 원시 데이터로부터 신뢰할 수 있는 구조화된 데이터를 생성하는 데 필수적입니다.
성능 측면에서도 뛰어나, 몇 초에 달하는 재시도 대신 마이크로초 단위의 오버헤드(한 번의 컴파일)만으로 작업을 완료할 수 있어 매우 빠릅니다.
Outlines는 또한 저수준 추상화 라이브러리(low-abstraction library)로서, 복잡한 에이전트 프레임워크 없이도 간결하고 직관적인 사용법을 제공합니다.
오늘 날짜인 2026년 8월 26일 기준으로, Outlines는 이미 수백 개의 조직에서 활용되고 있으며, vLLM, TGI, LoRAX, xinference, SGLang과 같은 주요 LLM 서빙 프레임워크에서도 사용되고 있습니다.
Outlines를 개발한 닷텍스트(.txt)는 Dottxt API라는 상업적 서비스를 제공하며, 이를 통해 사용자들은 자체 GPU나 설정 없이도 단순한 REST API 호출만으로 100% 스키마 준수 출력을 보장받을 수 있습니다.
이는 닷텍스트(Dottxt) 라이브러리가 LLM의 신뢰할 수 있는 구조화된 출력 생성이라는 핵심 문제를 해결하고 있으며, 오픈소스 대안보다 뛰어난 신뢰성, 성능, 엔터프라이즈 지원을 제공한다는 긍정적인 평가를 뒷받침합니다.
결론적으로, Outlines는 LLM의 고질적인 구조적 한계를 극복하고, 구조화된 생성의 미래를 구축하고 있는 중요한 기술입니다.
2. Pydantic의 정교한 데이터 검증 시스템: 필드부터 모델까지
Pydantic 데이터 검증 시스템의 핵심 개요
Pydantic은 데이터 검증 및 설정을 위한 강력한 파이썬 라이브러리로, 특히 LLM(거대 언어 모델) 응답, API 페이로드, 설정 파일, 사용자 입력과 같이 신뢰할 수 없는 원시 데이터의 유효성을 검사하는 데 필수적인 기능을 제공합니다.
Pydantic은 내장된 검증 기능뿐만 아니라, 필드 및 모델 수준에서 사용자 정의 검사기를 통해 복잡한 제약 조건과 데이터 무결성을 보장하는 데 특화되어 있습니다.
2026년 8월 26일 현재, Pydantic은 그 정교함을 통해 데이터 구조의 신뢰성을 극대화하며 다양한 애플리케이션의 견고한 기반을 제공하고 있습니다.
필드 유효성 검사기 (Field_Validators)의 심층 해부
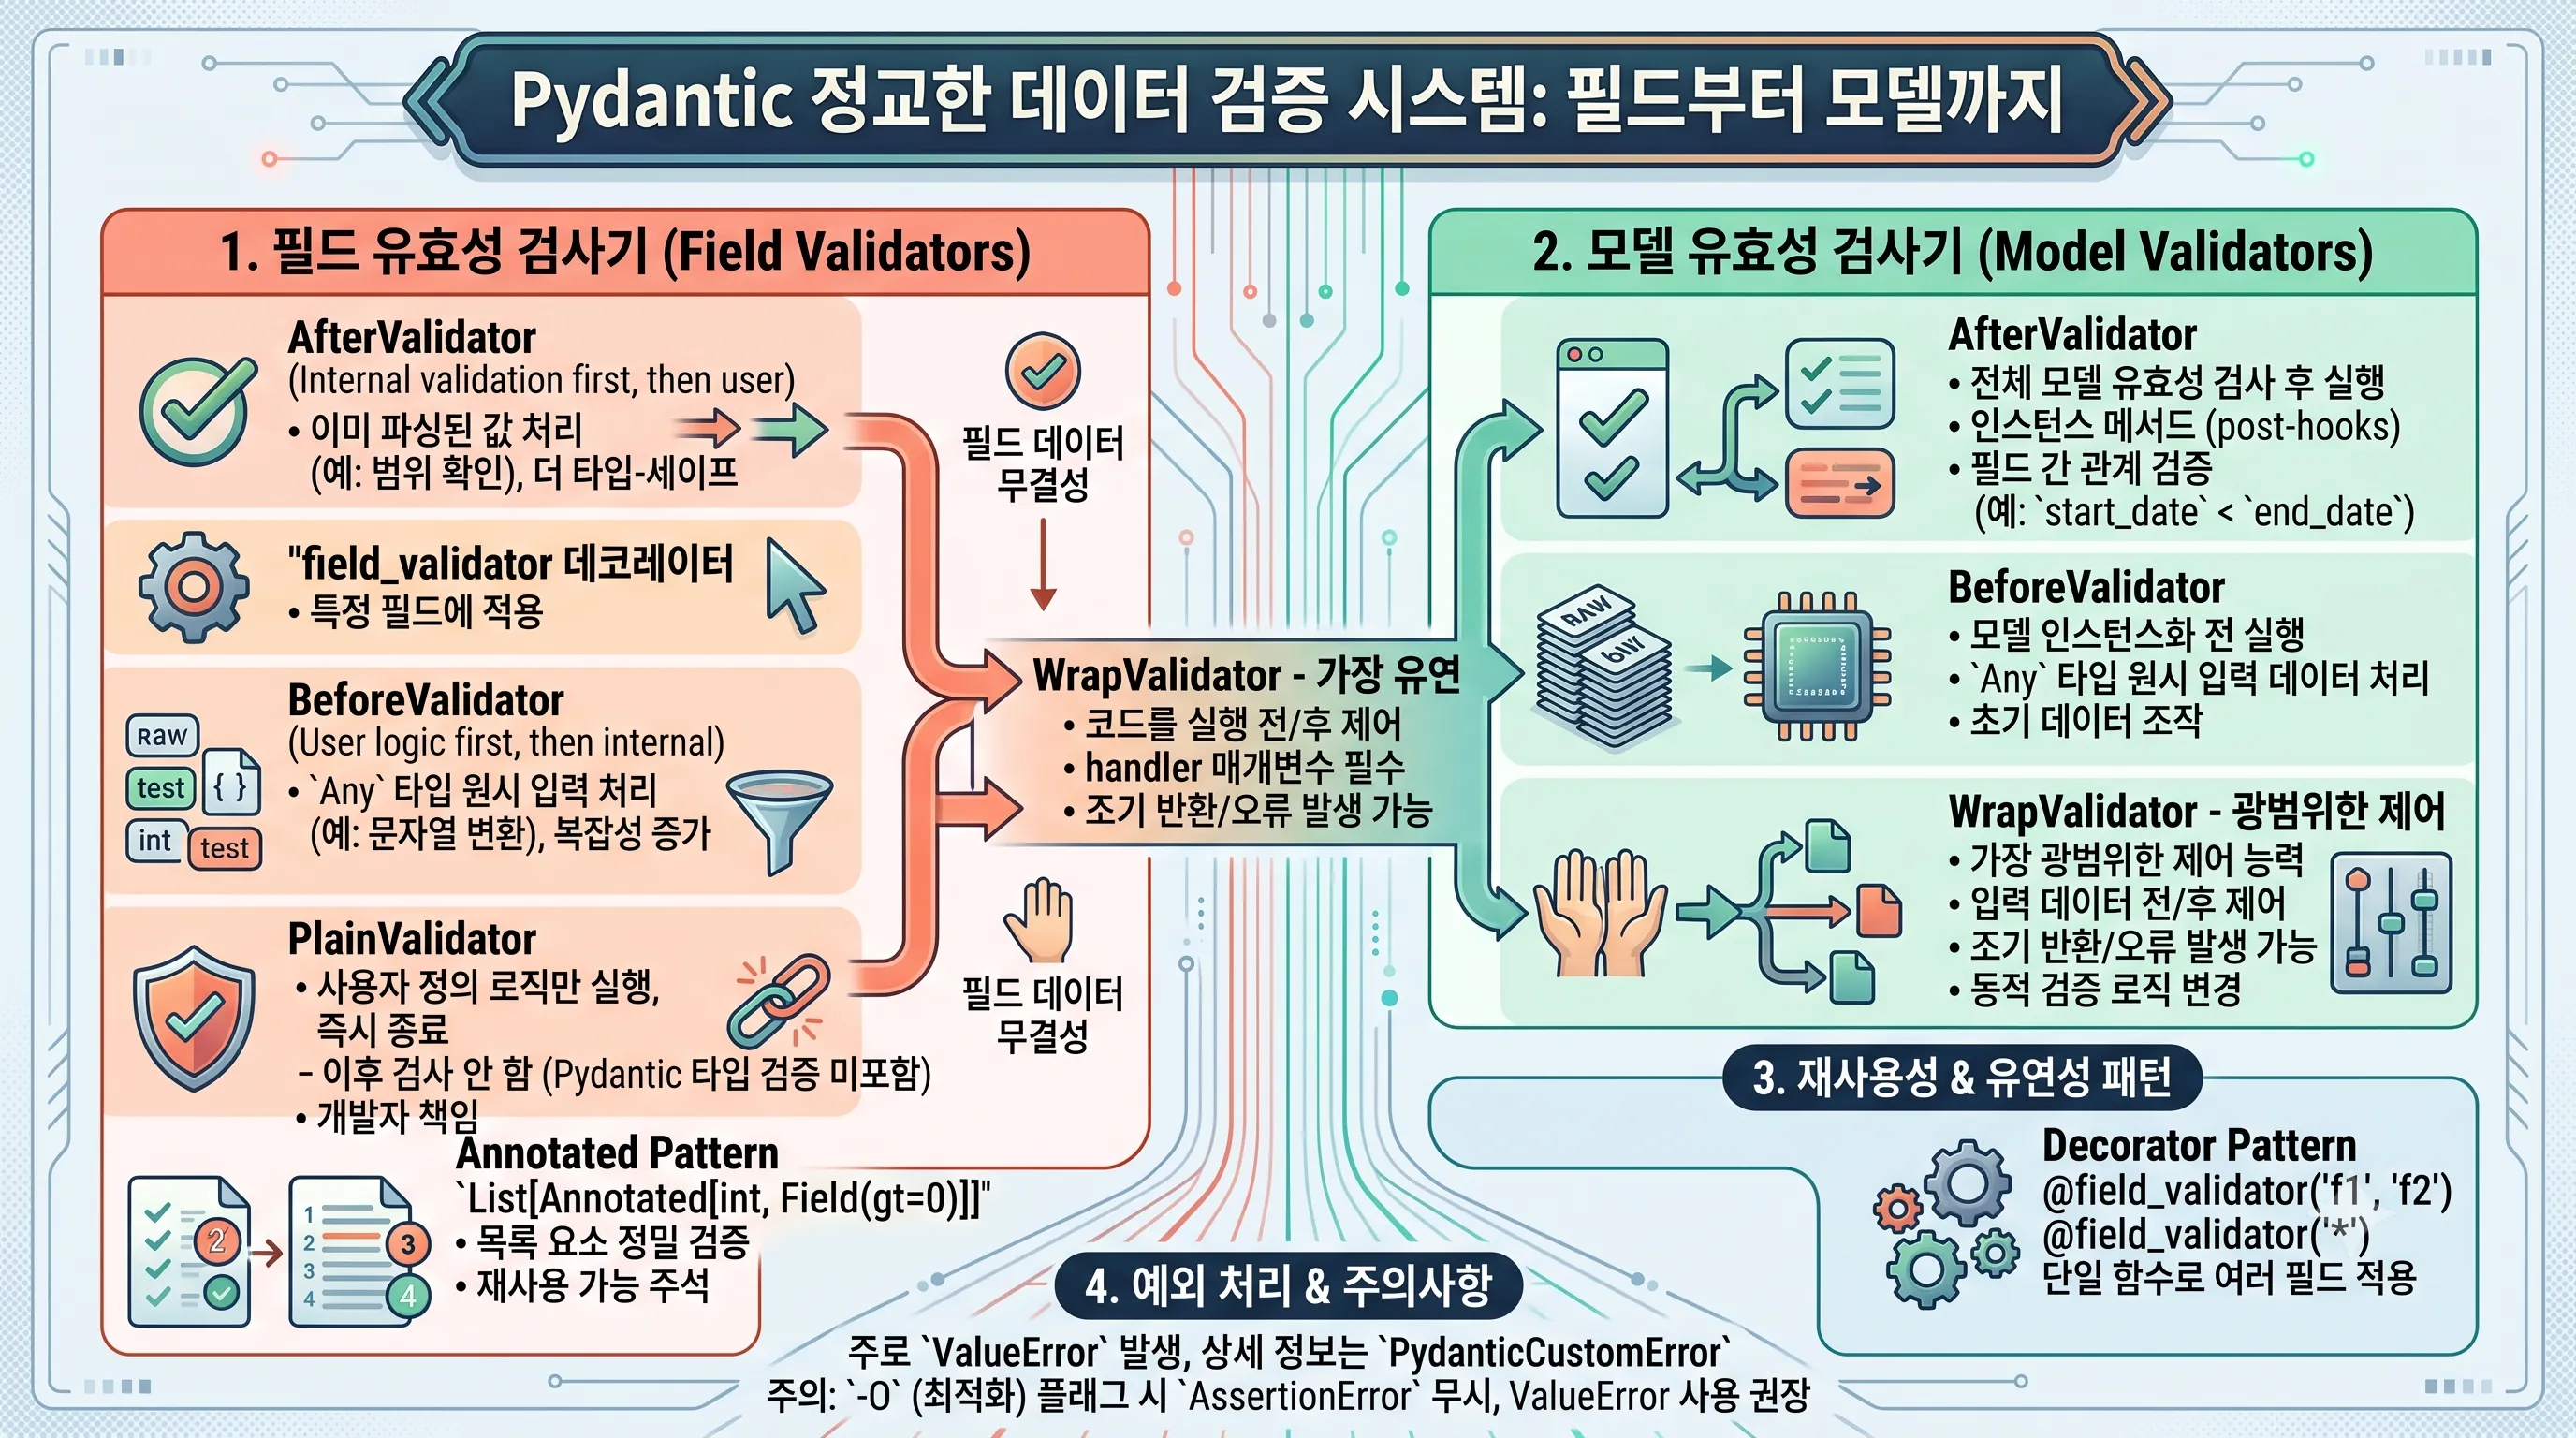
Pydantic의 필드 유효성 검사기는 특정 모델 필드에 대한 검증 로직을 정의하는 강력한 도구입니다.
이는 값을 검증하고, 필요에 따라 강제 변환(coercion)하거나 변경(mutation)하여 유효한 값을 반환하는 호출 가능한(callable) 함수로 작동합니다.
주요 유형으로는 `WrapValidator`, `PlainValidator`, `BeforeValidator`, `AfterValidator`, 그리고 `field_validator` 데코레이터가 있습니다.
`AfterValidator`는 Pydantic의 내부 검증이 완료된 후에 실행됩니다.
이는 일반적으로 더 타입-세이프(type-safe)하고 구현하기 쉬우며, 필드 유형에 대한 Pydantic의 기본 검증을 활용하면서 추가적인 로직을 적용할 때 유용합니다.
예를 들어, 이미 정수로 변환된 값에 대해 특정 범위 내에 있는지 확인하는 작업 등이 이에 해당합니다.
반면 `BeforeValidator`는 Pydantic의 내부 파싱 및 검증(예: 문자열을 정수로 변환하는 과정)이 시작되기 전에 실행됩니다.
이 검사기는 `Any` 타입의 원시 입력을 다루므로, 모든 가능한 경우의 수를 고려해야 하는 복잡성이 있습니다.
예를 들어, 숫자처럼 보이는 문자열을 정수로 명시적으로 변환해야 할 때 유용하게 사용될 수 있습니다.
`PlainValidator`는 `BeforeValidator`와 유사하게 작동하지만, 한 가지 중요한 차이점이 있습니다.
`PlainValidator`는 값을 반환하는 즉시 검증 과정을 종료시키며, 이후 추가적인 검사기가 호출되지 않고 Pydantic의 내부 필드 타입 검증도 진행되지 않습니다.
이는 특정 필드에 대한 검증을 전적으로 사용자 정의 로직에 맡기고 싶을 때 사용되지만, 그만큼 모든 검증 책임을 개발자가 져야 하는 한계를 가집니다.
가장 유연한 유형인 `WrapValidator`는 Pydantic 및 다른 검사기들이 코드를 실행하기 전 또는 후에 코드를 실행할 수 있도록 합니다.
이 검사기는 필수적으로 `handler` 매개변수(검증할 값을 받는 호출 가능한 객체)를 요구하며, 유효성 검사를 즉시 종료(일찍 반환하거나 오류 발생)할 수 있는 기능을 제공하여 매우 정교한 제어가 가능합니다.
모델 유효성 검사기 (Model_Validators)의 역할과 활용
필드 유효성 검사기가 개별 필드에 초점을 맞춘다면, 모델 유효성 검사기는 전체 모델 수준에서 데이터의 일관성과 무결성을 검증합니다.
이는 `model_validator()` 데코레이터를 사용하여 정의되며, 모델 내의 여러 필드 간의 관계를 검증하거나 전체 모델의 상태를 확인하는 데 사용됩니다.
`AfterValidator` 유형의 모델 검사기는 전체 모델이 유효성 검사를 마친 후에 실행됩니다.
이들은 종종 인스턴스 메서드(post-initialization hooks)로 정의되며, 검증된 인스턴스를 반환함으로써 모델 생성 후 추가적인 로직을 적용할 수 있게 합니다.
예를 들어, `start_date`가 `end_date`보다 이전인지 확인하는 등의 로직이 여기에 해당합니다.
`BeforeValidator` 유형의 모델 검사기는 모델이 인스턴스화되기 전에 실행되며, `Any` 타입의 원시 입력 데이터를 처리합니다.
이는 필드 검사기의 `BeforeValidator`와 유사하게, 모델이 파싱되기 전의 원시 데이터를 조작하거나 초기 검증을 수행할 때 사용됩니다.
모델 수준에서도 가장 유연한 `WrapValidator`가 존재합니다.
이는 Pydantic 및 다른 검사기들이 입력 데이터를 처리하기 전 또는 후에 코드를 실행할 수 있도록 하며, 데이터를 조기에 반환하거나 오류를 발생시켜 검증을 즉시 종료하는 등 가장 광범위한 제어 능력을 제공합니다.
필드 검사기와 마찬가지로, 모델의 특정 조건에 따라 동적으로 검증 로직을 변경해야 할 때 매우 유용합니다.
재사용성과 유연성을 위한 검증 패턴
Pydantic은 검증 로직의 재사용성과 유연성을 높이기 위해 `Annotated_Pattern`과 `Decorator_Pattern` 두 가지 주요 패턴을 제공합니다.
`Annotated_Pattern`은 검사기를 재사용 가능하게 만들고, 특정 타입에 어떤 검사기가 적용되는지 더 쉽게 이해할 수 있도록 돕습니다.
이 패턴은 특히 목록 항목과 같은 주석의 특정 부분에 검사기를 적용할 수 있게 하여, 전체 목록이 아닌 개별 요소에 대한 정밀한 검증을 가능하게 합니다.
예를 들어, `List[Annotated[int, Field(gt=0)]]`와 같이 리스트 내의 각 정수가 0보다 커야 함을 명확히 명시할 수 있습니다.
`Decorator_Pattern`은 단일 함수를 사용하여 여러 필드에 검사기를 적용할 수 있도록 합니다.
`@field_validator('f1', 'f2')`와 같이 특정 필드 이름에 적용하거나, `@field_validator('*')`를 사용하여 모든 필드에 일괄적으로 적용할 수 있습니다.
또한, 클래스 생성 중에 필드 이름 검사를 비활성화하기 위해 `check_fields=False` 매개변수를 사용할 수 있어, 더욱 유연한 설계가 가능합니다.
정교한 예외 처리 및 주의사항
데이터 검증 시스템의 신뢰성은 예외 처리 메커니즘에 크게 좌우됩니다.
Pydantic은 유효성 검사 실패 시 주로 `ValueError`를 발생시키는데, 이는 가장 일반적인 형태의 오류 보고 방식입니다.
보다 상세하고 유연한 오류 메시징이 필요할 경우, `PydanticCustomError`를 사용하여 추가적인 정보를 제공할 수 있습니다.
주의할 점은 파이썬이 `-O` (최적화) 플래그로 실행될 경우, 검사기 내에서 발생하는 `AssertionError`는 건너뛰어진다는 것입니다.
이는 배포 환경에서 예기치 않은 동작을 유발할 수 있으므로, 검증 로직에서는 `ValueError` 또는 `PydanticCustomError`와 같은 명시적인 예외를 사용하는 것이 안전합니다.
또한, `BeforeValidator`를 사용할 때는 `Any` 타입의 원시 입력을 다루며 모든 가능한 경우를 고려해야 하는 복잡성을 인지해야 합니다.
이는 예상치 못한 입력에 대한 견고한 처리를 요구하며, 개발자의 세심한 설계가 필요합니다.
마찬가지로 `PlainValidator`는 값을 반환하는 즉시 검증을 종료시키고 더 이상의 검사기 호출이나 Pydantic의 내부 필드 타입 검증을 수행하지 않으므로, 이 검사기를 사용할 때는 모든 검증 책임을 개발자가 진다는 점을 명확히 이해하고 있어야 합니다.
이러한 제한 사항을 이해하고 적절히 활용하는 것이 Pydantic을 이용한 견고한 데이터 검증 시스템 구축의 핵심입니다.
3. Outlines 프레임워크: 100% 스키마 준수를 위한 3가지 핵심 요소
1. 압도적인 속도와 안정성: 100% 스키마 준수를 위한 핵심 동력
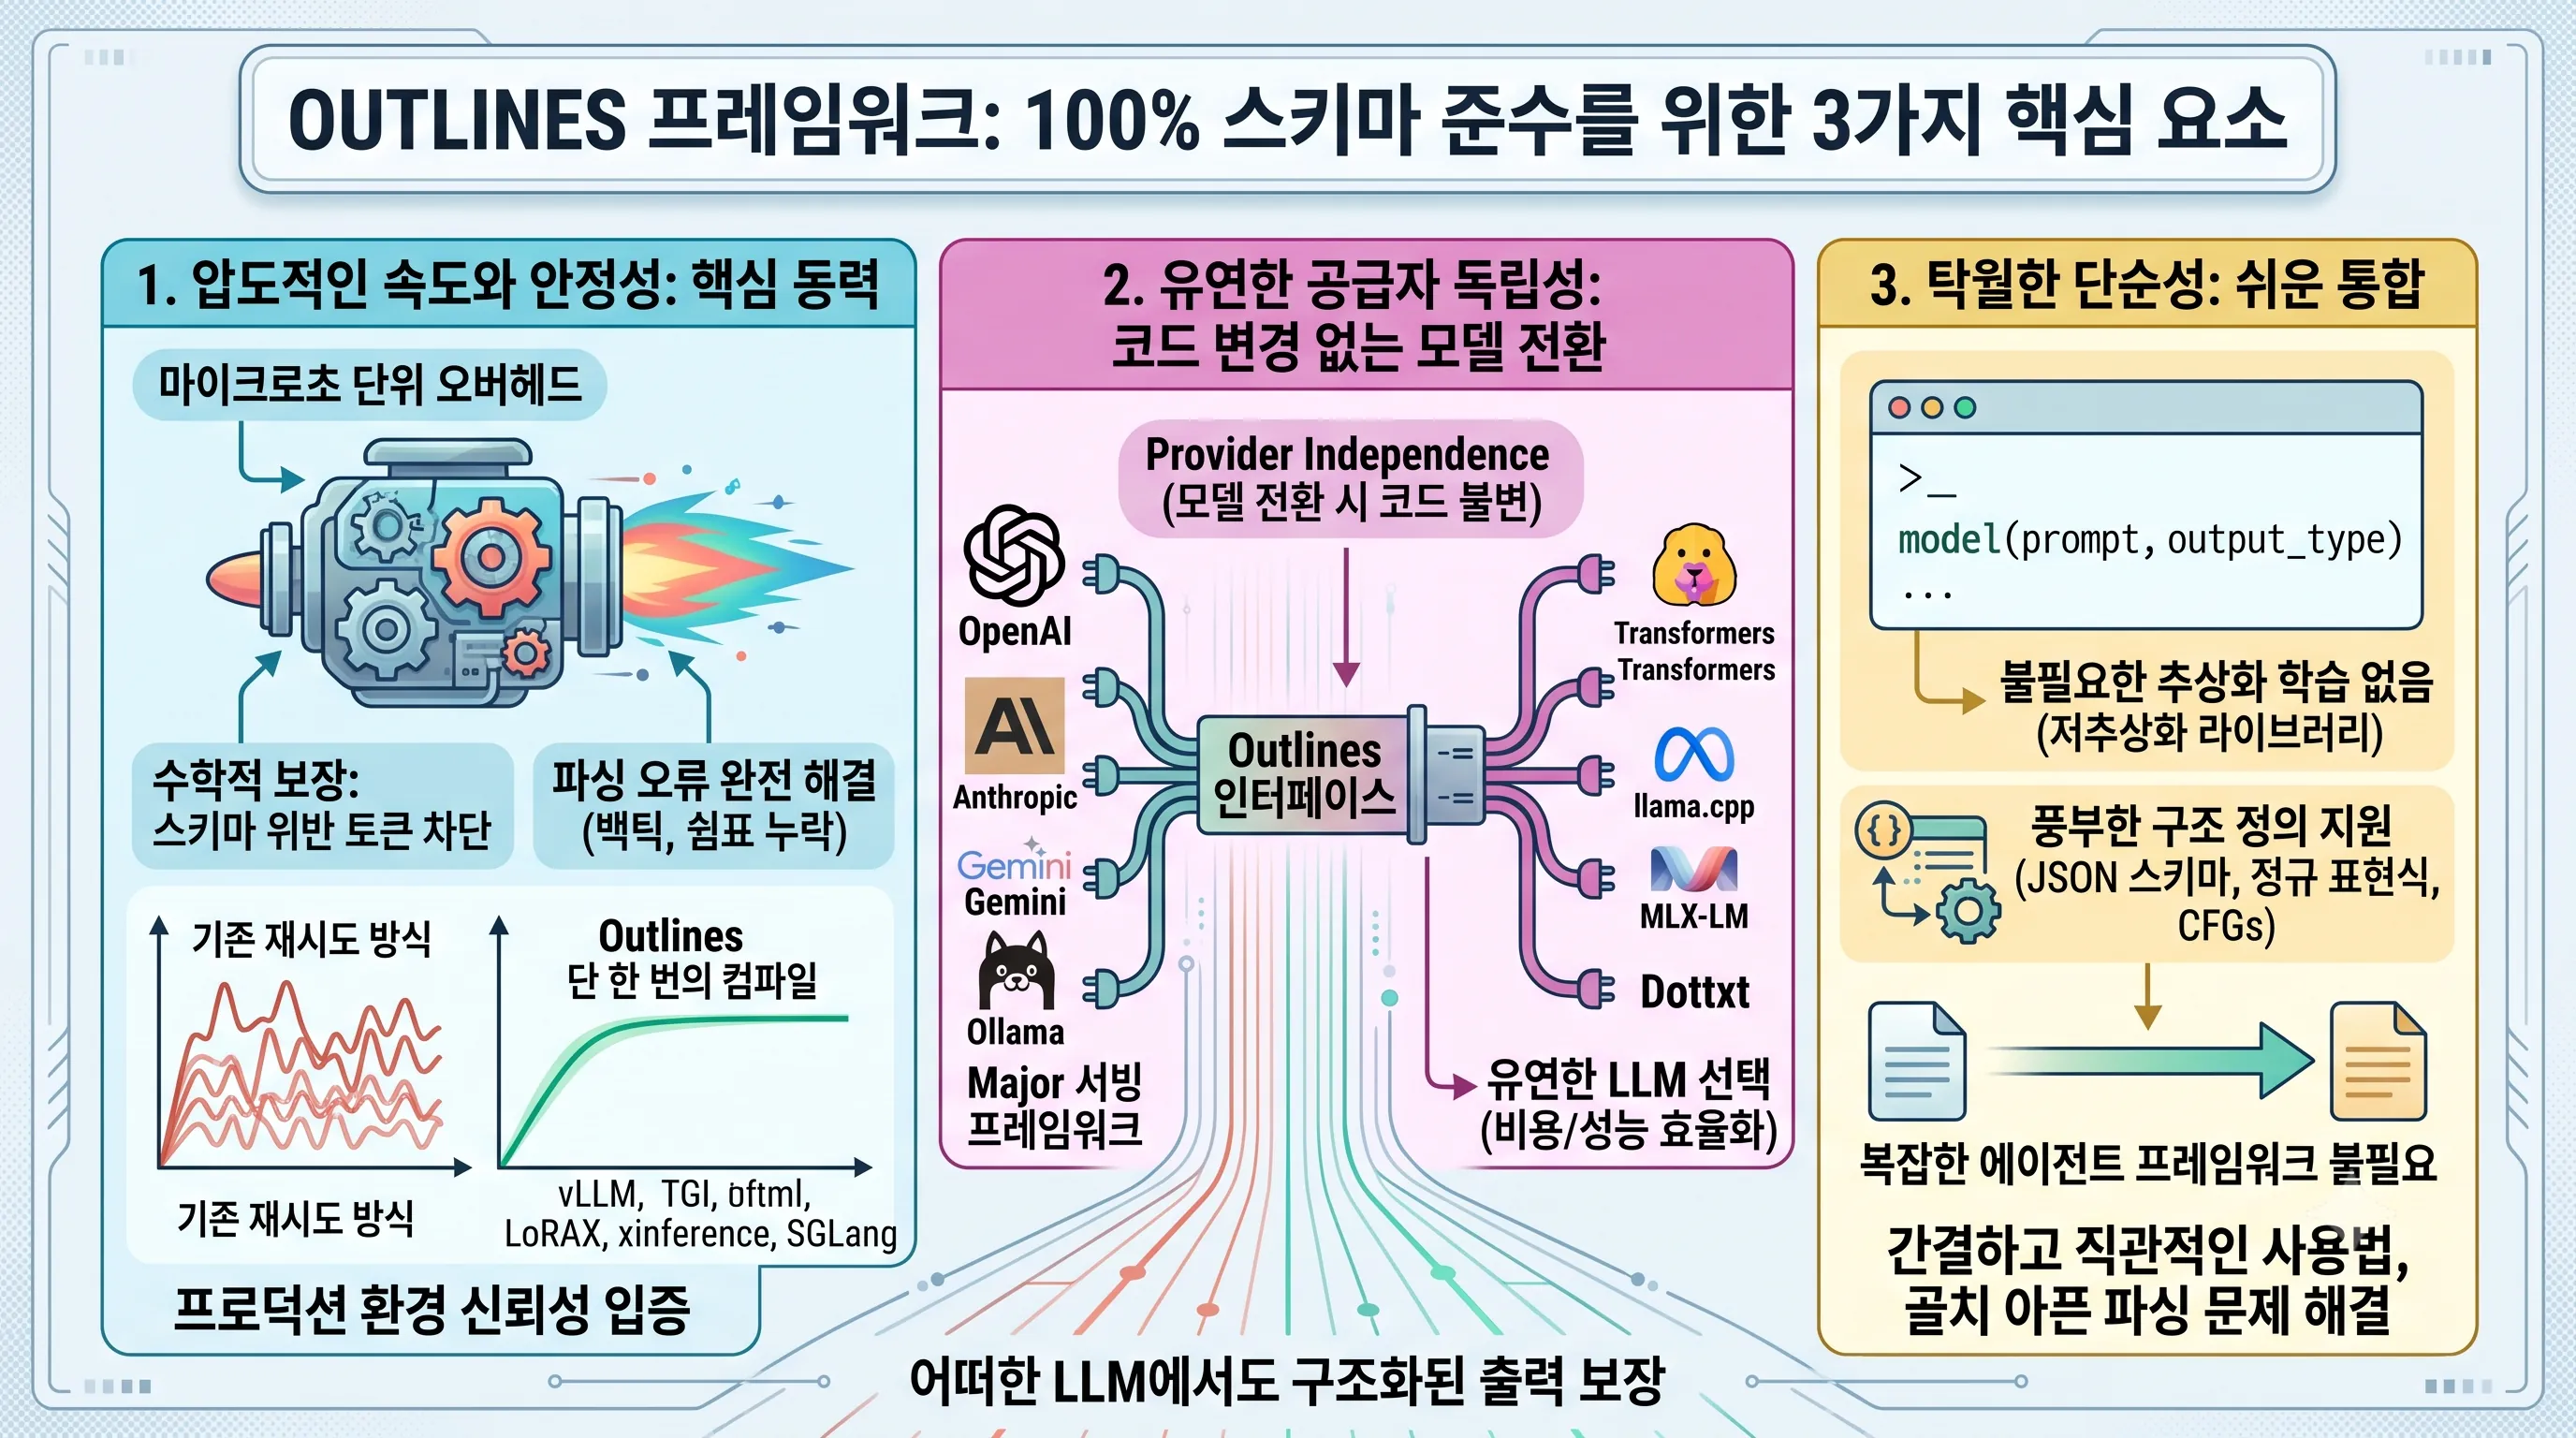
Outlines 프레임워크의 가장 강력한 특징 중 하나는 타의 추종을 불허하는 속도와 안정성입니다.
이 프레임워크는 대규모 언어 모델(LLM)이 생성하는 출력을 100% 스키마 준수를 보장하도록 설계되었습니다.
이는 단순한 확률적 접근 방식을 넘어, 토큰 생성 단계에서 스키마를 위반하는 모든 토큰 생성을 차단하는 수학적 보장을 제공합니다.
일반적인 프롬프트 방식에서 발생할 수 있는 파싱 오류(예: 마크다운 백틱 누락, 쉼표 누락)나 서버의 JSONDecodeError로 인한 파이프라인 중단과 같은 문제로부터 완전히 자유롭습니다.
Outlines는 단 한 번의 컴파일을 통해 마이크로초 단위의 오버헤드로 이러한 엄격한 스키마 준수를 달성합니다.
이는 재시도를 반복하며 시간을 소모하는 기존 방식과 비교했을 때 현저한 성능 우위를 제공합니다.
LLM의 예측 불가능한 출력이 야기하는 구조화된 출력의 문제점을 해결하기 위해 Outlines는 생성 과정에서 직접 구조화된 출력을 보장합니다.
실제로 Outlines는 수백 개의 조직과 vLLM, TGI, LoRAX, xinference, SGLang 등 주요 LLM 서빙 프레임워크에서 활발하게 사용되며 그 안정성과 성능을 입증하고 있습니다.
이는 Outlines가 단순한 실험적 도구를 넘어, 실제 프로덕션 환경에서 요구되는 신뢰성을 갖춘 솔루션임을 의미합니다.
2. 유연한 공급자 독립성: 코드 변경 없는 모델 전환
Outlines 프레임워크는 공급자 독립성이라는 중요한 강점을 가지고 있습니다.
이는 개발자가 특정 LLM 공급업체에 종속되지 않고, 필요에 따라 다양한 모델과 프레임워크를 코드 변경 없이 자유롭게 전환할 수 있도록 합니다.
Outlines는 OpenAI, Ollama, vLLM, Transformers, llama.cpp, MLX-LM, SgLang, TGI, Anthropic, Gemini, Dottxt 등 광범위한 LLM과 호환됩니다.
이러한 폭넓은 호환성은 기업과 개발 팀이 프로젝트의 요구사항이나 비용 효율성, 성능 변화에 따라 유연하게 LLM을 선택하고 변경할 수 있게 합니다.
특히 "provider independence (switch models without changing code)" 기능은 개발 과정의 복잡성을 크게 줄여줍니다.
동일한 Outlines 인터페이스를 사용하여 프롬프트와 원하는 출력 유형(output_type)을 모델에 전달하는 방식으로 간단하게 통합할 수 있습니다.
이러한 유연성은 기술 스택을 확장하거나 진화하는 LLM 생태계에 발맞춰 빠르게 대응해야 하는 조직에게 핵심적인 이점을 제공합니다.
궁극적으로 Outlines는 어떠한 LLM에서도 생성 시점에 구조화된 출력을 보장하는 핵심 기능을 제공하며, 이를 통해 개발자는 모델 선택의 자유를 누릴 수 있습니다.
3. 탁월한 단순성: 저추상화 라이브러리의 쉬운 통합
Outlines 프레임워크의 또 다른 중요한 특징은 탁월한 단순성입니다.
이는 복잡한 에이전트 프레임워크 없이 저추상화 라이브러리로서 기능하여 기존 시스템에 매우 쉽게 통합될 수 있다는 것을 의미합니다.
개발자는 원하는 출력 유형을 `model(prompt, output_type)`과 같이 간단하게 전달하는 방식으로 Outlines를 사용할 수 있습니다.
이처럼 간결한 통합 방식은 개발자가 불필요한 추상화 계층에 대한 학습 없이 핵심 로직에 집중할 수 있도록 돕습니다.
Outlines는 JSON 스키마, 정규 표현식, 문맥 자유 문법(Context-Free Grammars) 등 풍부한 구조 정의 방식을 지원하여 개발자가 복잡한 출력 형식을 명확하게 정의할 수 있도록 합니다.
이러한 기능을 저추상화 라이브러리 형태로 제공함으로써, 개발자는 복잡한 파싱 문제나 깨진 JSON 형식으로 인한 골치 아픈 상황 없이 유효한 구조를 보장받을 수 있습니다.
별도의 에이전트 프레임워크가 필요 없다는 점은 코드 베이스를 단순하게 유지하고, 통합 비용을 절감하며, 개발 속도를 향상시키는 데 기여합니다.
Outlines는 단순하지만 강력한 도구로서, LLM의 구조화된 출력 생성이라는 핵심 문제를 효율적으로 해결합니다.
4. 실무 적용 및 상용 솔루션: Dottxt API와 생태계
Outlines, LLM 서빙 프레임워크의 핵심 동력
대규모 언어 모델(LLM)의 예측 불가능한 출력은 실질적인 활용에 있어 고질적인 문제점으로 지적되어 왔습니다.
이러한 난제를 해결하고 LLM이 항상 구조화된 결과물을 생성하도록 보장하는 핵심 기술이 바로 Outlines입니다.
Outlines는 2026년 8월 26일 현재, 어떠한 LLM에서도 생성 과정 중에 구조화된 출력을 보장하는 코어 기능을 제공하며, LLM이 제시하는 구조적 출력 문제를 효과적으로 해결하고 있습니다.
이는 단순한 파싱 오류나 JSON 깨짐 현상 없이 유효한 구조를 보장하는 것을 목표로 합니다.
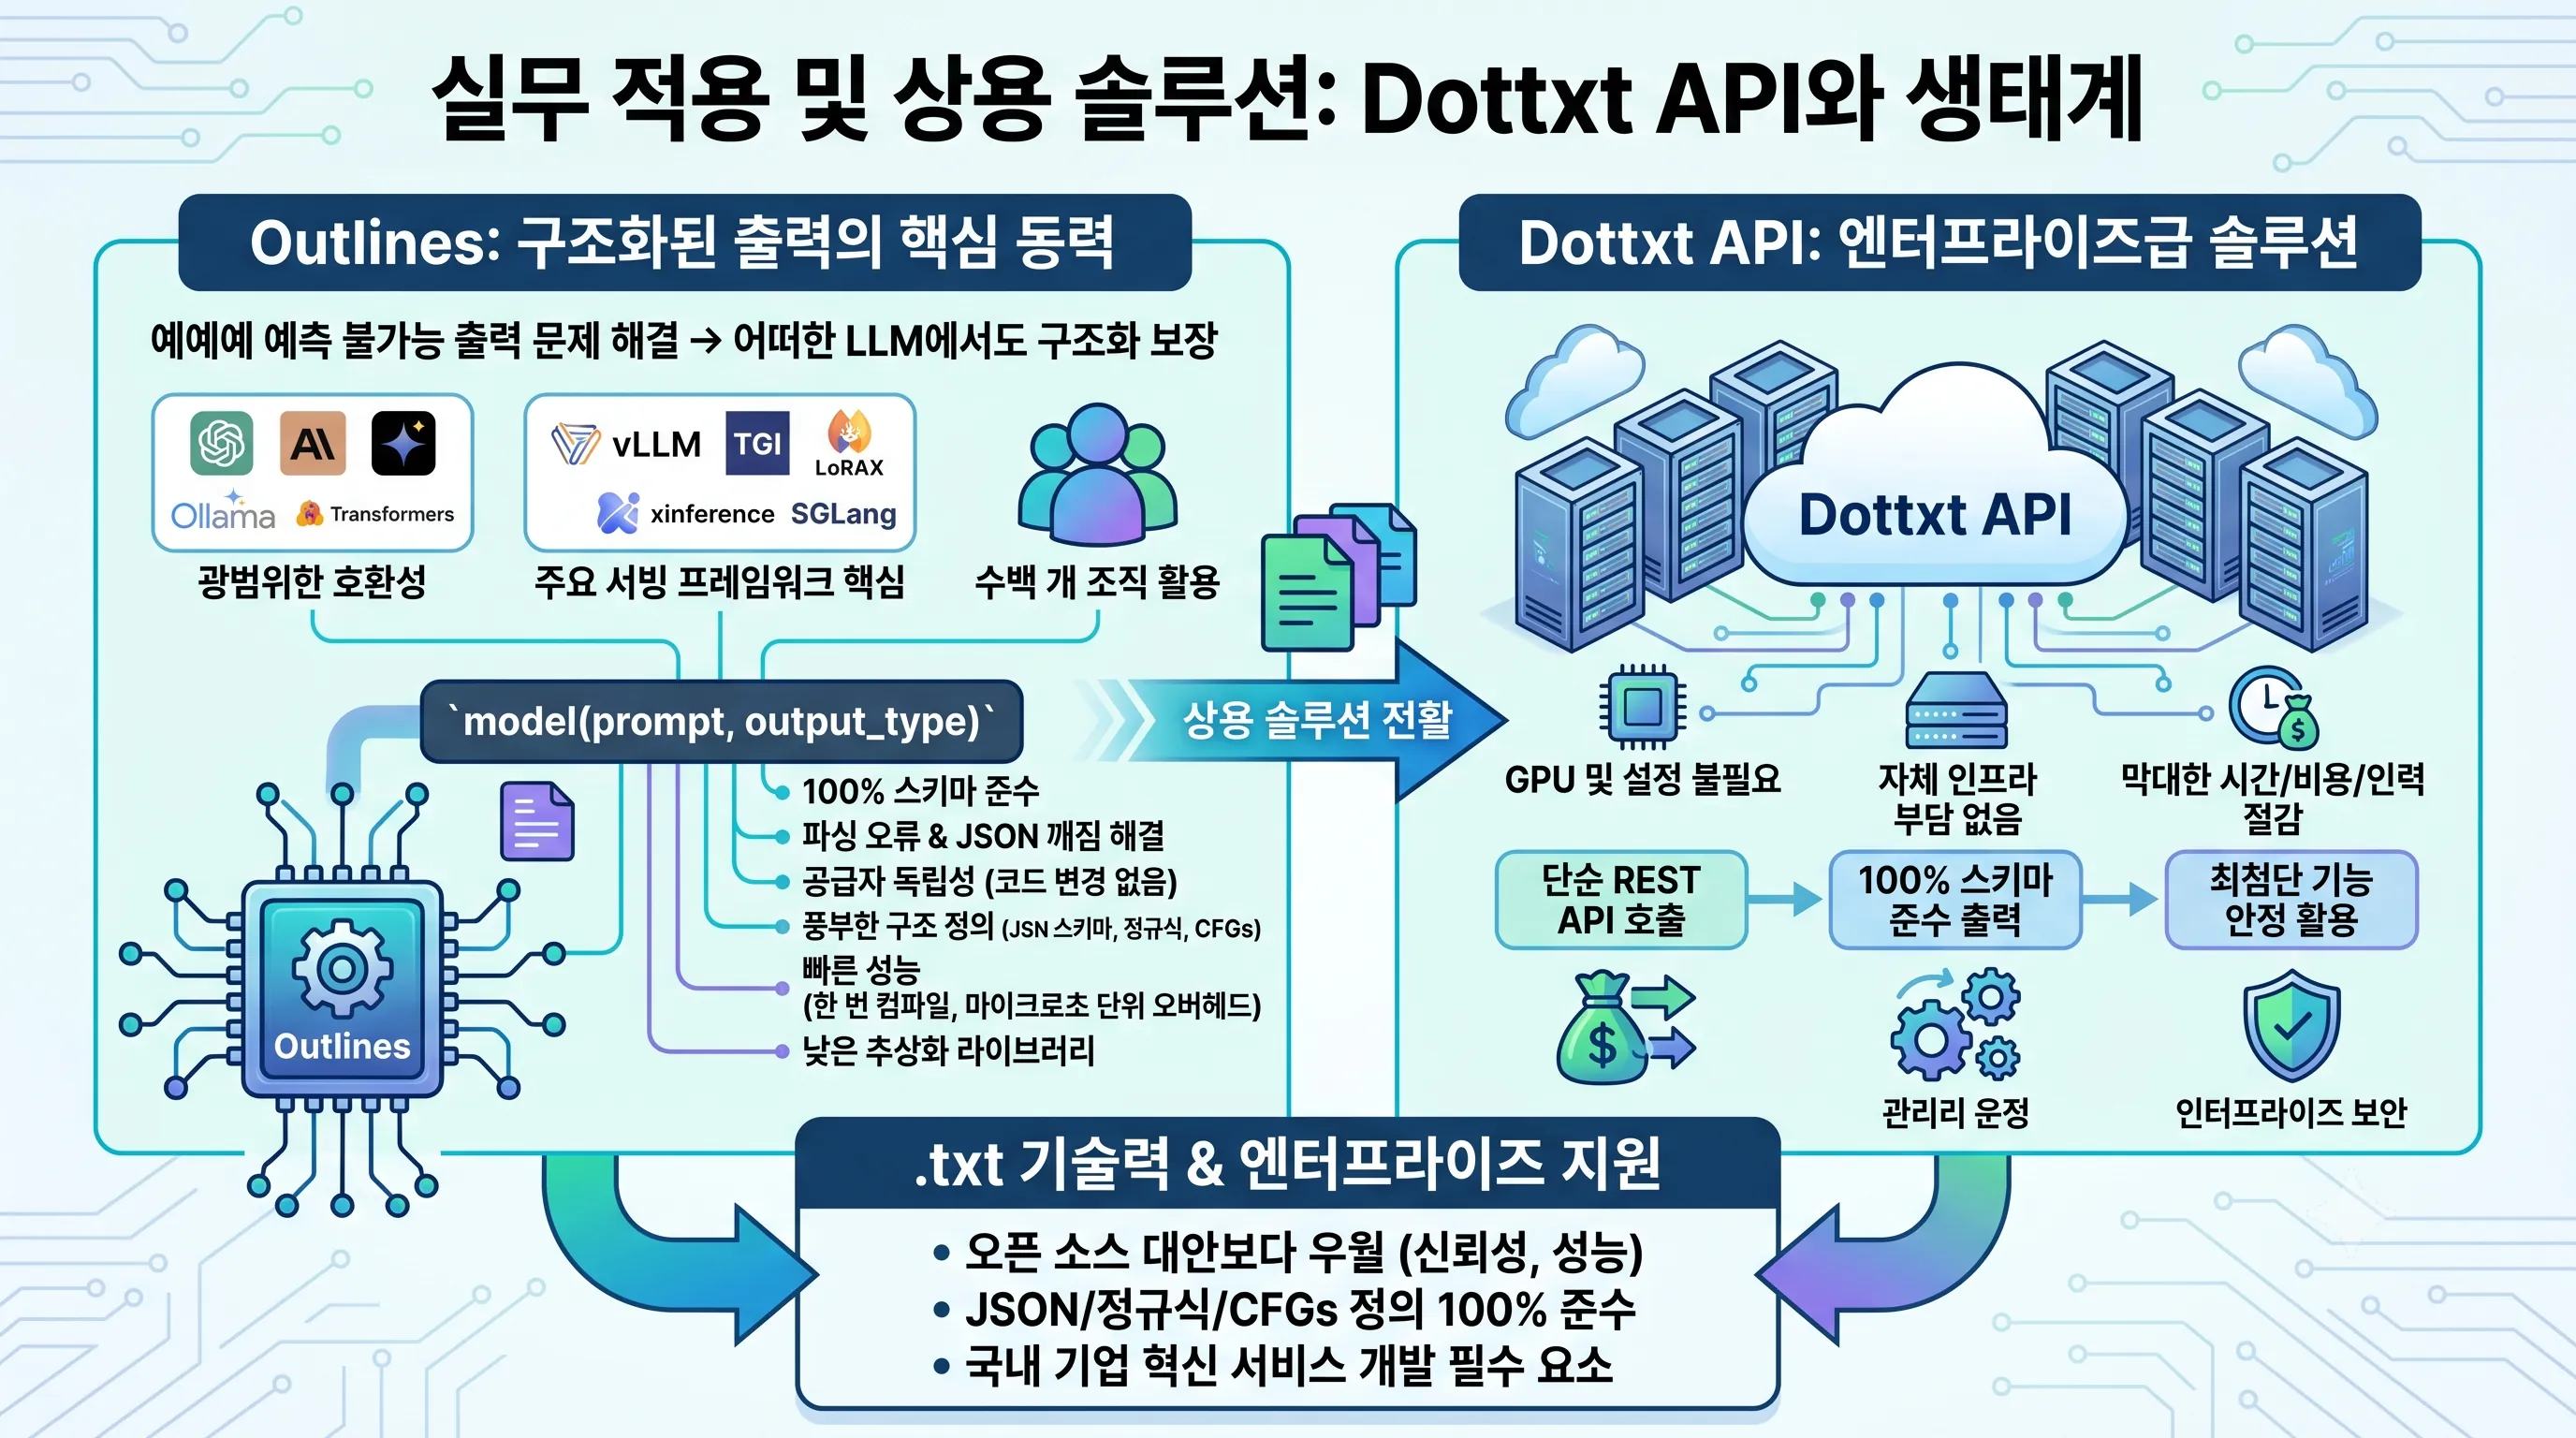
Outlines의 호환성은 매우 광범위하여, OpenAI, Ollama, vLLM, Transformers, llama.cpp, MLX-LM, SgLang, TGI, Anthropic, Gemini, 그리고 Dottxt 등 주요 LLM 및 서비스들과 유기적으로 통합되어 있습니다.
특히, vLLM, TGI, LoRAX, xinference, SGLang과 같은 주요 LLM 서빙 프레임워크에서 널리 사용되고 있으며, 현재 수백 개의 조직에서 활발히 채택하여 활용하고 있습니다.
이러한 광범위한 채택은 Outlines가 제공하는 신뢰성과 효율성을 입증하는 강력한 증거입니다.
Outlines의 핵심 기능으로는 단순한 통합 방식이 돋보입니다.
사용자는 원하는 출력 타입을 (model(prompt, output_type))과 같이 모델에 전달하기만 하면 됩니다.
이를 통해 파싱 오류나 손상된 JSON과 같은 문제 없이 100% 스키마 준수를 보장하는 신뢰할 수 있는 구조를 얻을 수 있습니다.
또한 공급자 독립성을 제공하여, 코드 변경 없이 다른 모델로 전환할 수 있는 유연성을 제공합니다.
JSON 스키마, 정규 표현식(regular expressions), 문맥 자유 문법(context-free grammars) 등을 활용한 풍부한 구조 정의 기능을 지원하며, 한 번의 컴파일로 마이크로초 단위의 오버헤드만을 발생시켜 빠른 성능을 제공합니다.
이는 수초 단위의 재시도에 따른 지연을 방지하여 생산성을 크게 향상시킵니다.
복잡한 에이전트 프레임워크가 필요 없는 낮은 추상화 라이브러리로서의 단순함 또한 Outlines의 강점입니다.
Dottxt API: GPU 및 설정 없는 엔터프라이즈급 솔루션
LLM 기반 애플리케이션 개발에 있어 구조화된 출력의 중요성이 커지면서, 이를 상업적으로 지원하는 솔루션에 대한 요구도 증가하고 있습니다.
`.txt`에서 개발한 Dottxt API는 이러한 요구에 부응하는 상용 솔루션으로, 자체 GPU나 복잡한 설정 없이 단순한 REST API를 통해 100% 스키마 준수 출력을 제공합니다.
이는 곧 기업들이 LLM 인프라 구축 및 관리에 대한 부담 없이 구조화된 생성 기능을 즉시 활용할 수 있게 됨을 의미합니다.
Dottxt API의 핵심 가치는 모델을 직접 운영할 필요 없이 구조화된 생성을 보장한다는 점에 있습니다.
즉, LLM 서빙 환경을 구축하고 유지보수하는 데 필요한 막대한 시간과 비용, 그리고 전문 인력을 절감할 수 있습니다.
개발자는 오직 단순한 REST API 호출만으로 필요한 데이터를 정확한 스키마에 맞춰 받아볼 수 있으며, 이 모든 과정에서 100% 스키마 준수가 보장됩니다.
이는 특히 민감한 데이터 처리나 엄격한 규제가 요구되는 엔터프라이즈 환경에서 매우 중요한 이점으로 작용합니다.
Dottxt API는 현재 API 접근 요청을 통해 상업적으로 제공되고 있습니다.
Dottxt의 기술력과 엔터프라이즈 지원의 이점
Outlines와 Dottxt API를 개발한 Dottxt는 LLM의 신뢰할 수 있는 구조화된 출력 생성이라는 핵심적인 문제를 해결하고 있습니다.
특히 Dottxt 라이브러리는 오픈 소스 대안들보다 우월한 신뢰성, 성능, 그리고 엔터프라이즈 지원을 제공합니다.
이는 JSON 스키마, 정규 표현식, 문맥 자유 문법 등 다양한 방식으로 정의된 출력 형식에 대해 100% 준수를 보장함으로써 달성됩니다.
기업 고객의 입장에서 이는 시스템의 안정성과 예측 가능성을 크게 향상시키며, 개발 및 운영 비용을 절감하는 효과를 가져옵니다.
Dottxt의 솔루션은 LLM의 불확실한 출력을 비즈니스 로직에 통합하기 위한 중요한 기술적 기반을 제공합니다.
이는 단순히 기술적 우위를 넘어, 구조화된 생성의 미래를 구축하겠다는 Dottxt의 비전을 반영합니다.
기업들은 Dottxt API와 같은 상업적 제안을 통해 자체 인프라 부담 없이 최첨단 LLM 기능을 안정적으로 활용할 수 있게 됩니다.
이는 국내 기업들이 글로벌 AI 경쟁에서 우위를 점하고 혁신적인 서비스를 개발하는 데 필수적인 요소가 될 것입니다.
- https://pydantic.dev/docs/validation/latest/concepts/validators/
- https://dottxt-ai.github.io/outlines/latest/
- LLM(Large Language Models)이란 무엇입니까? - 주요 사용 사례, 데이터 ...
- Structured Output for LLMs in 2026 — Pydantic AI, Instructor, and the End …
- LLM structured output built with Pydantic: implementing JSON Sche…
- Pydantic AI Tutorial 2026: Type-Safe Python Agents With Automatic Valid…
관련 글