Liquid AI LFM2.5-VL-3B: 엣지 AI 혁신! 초고속 16개 언어 VLM 분석
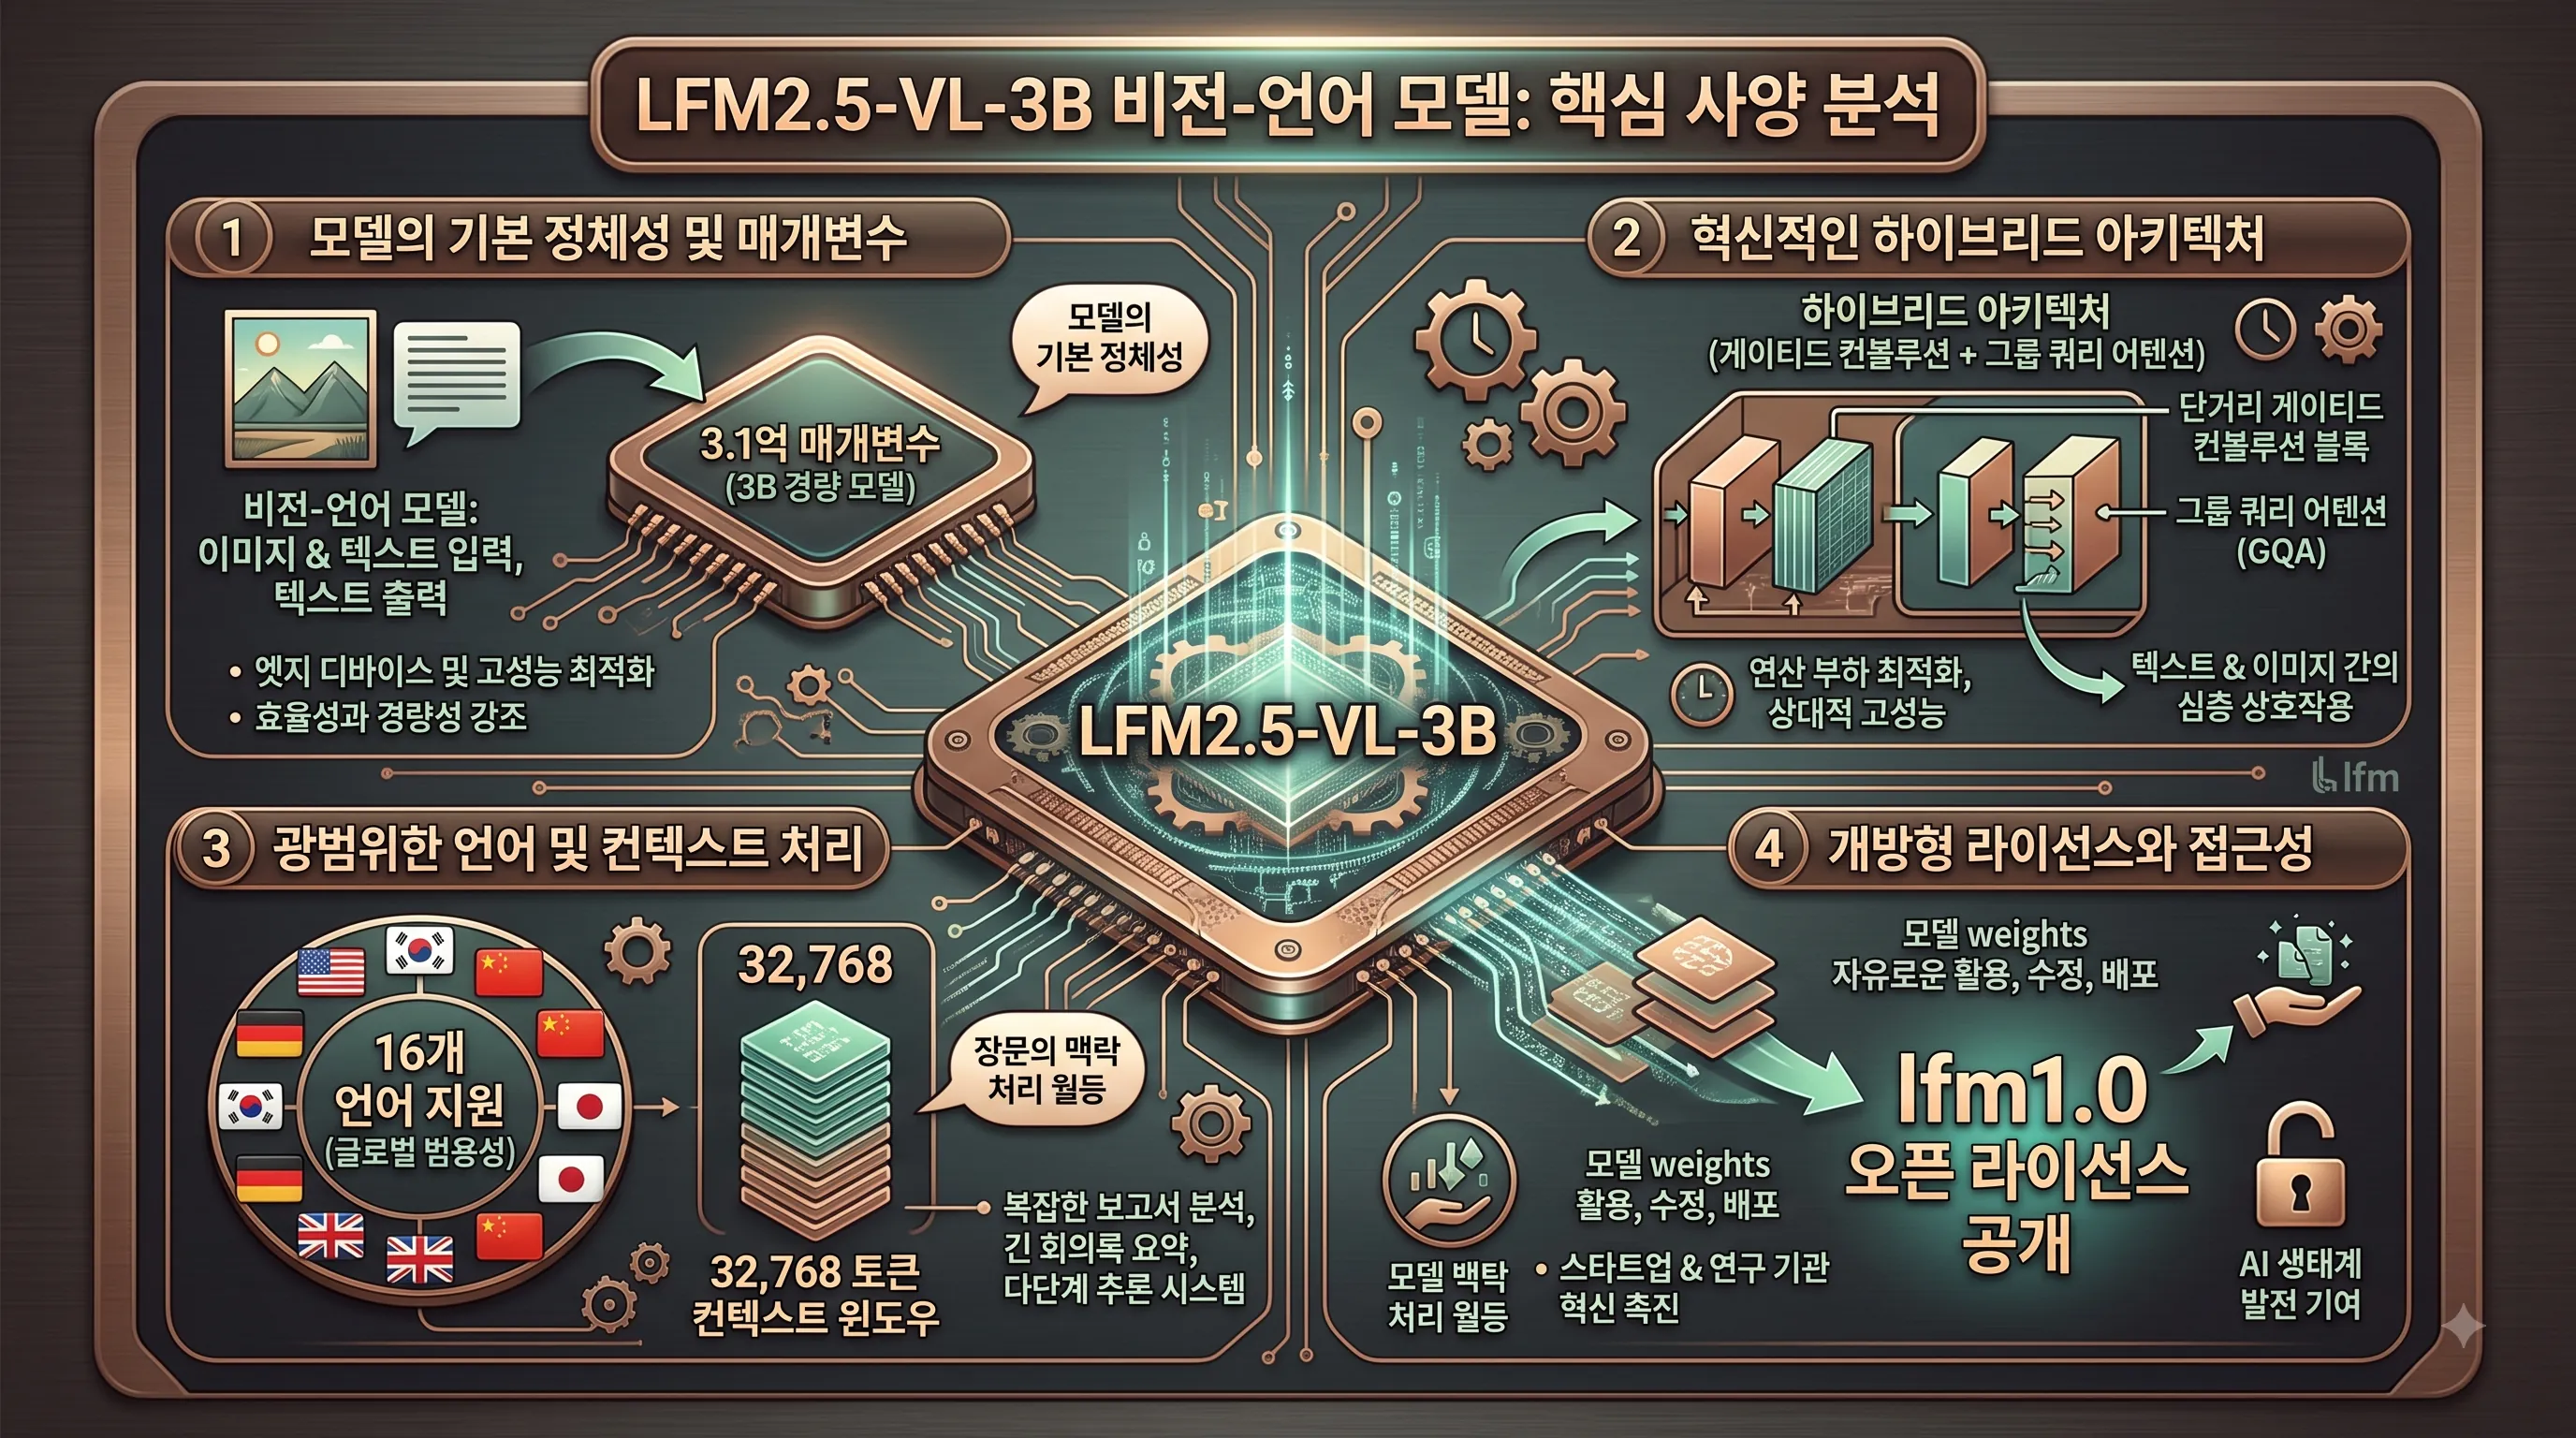
- Liquid AI의 새로운 3.1억 매개변수 비전-언어 모델(VLM), LFM2.5-VL-3B 공개 (2026년 8월 14일 현재).
- 하이브리드 아키텍처 (단거리 게이티드 컨볼루션 + 그룹 쿼리 어텐션) 기반으로 경량성 및 고성능 추구.
- 16개 언어 지원 (한국어, 중국어, 일본어 포함) 및 32,768 토큰의 넓은 컨텍스트 윈도우.
- Liquid의 lfm1.0 오픈 라이선스를 통해 자유롭게 활용 가능.
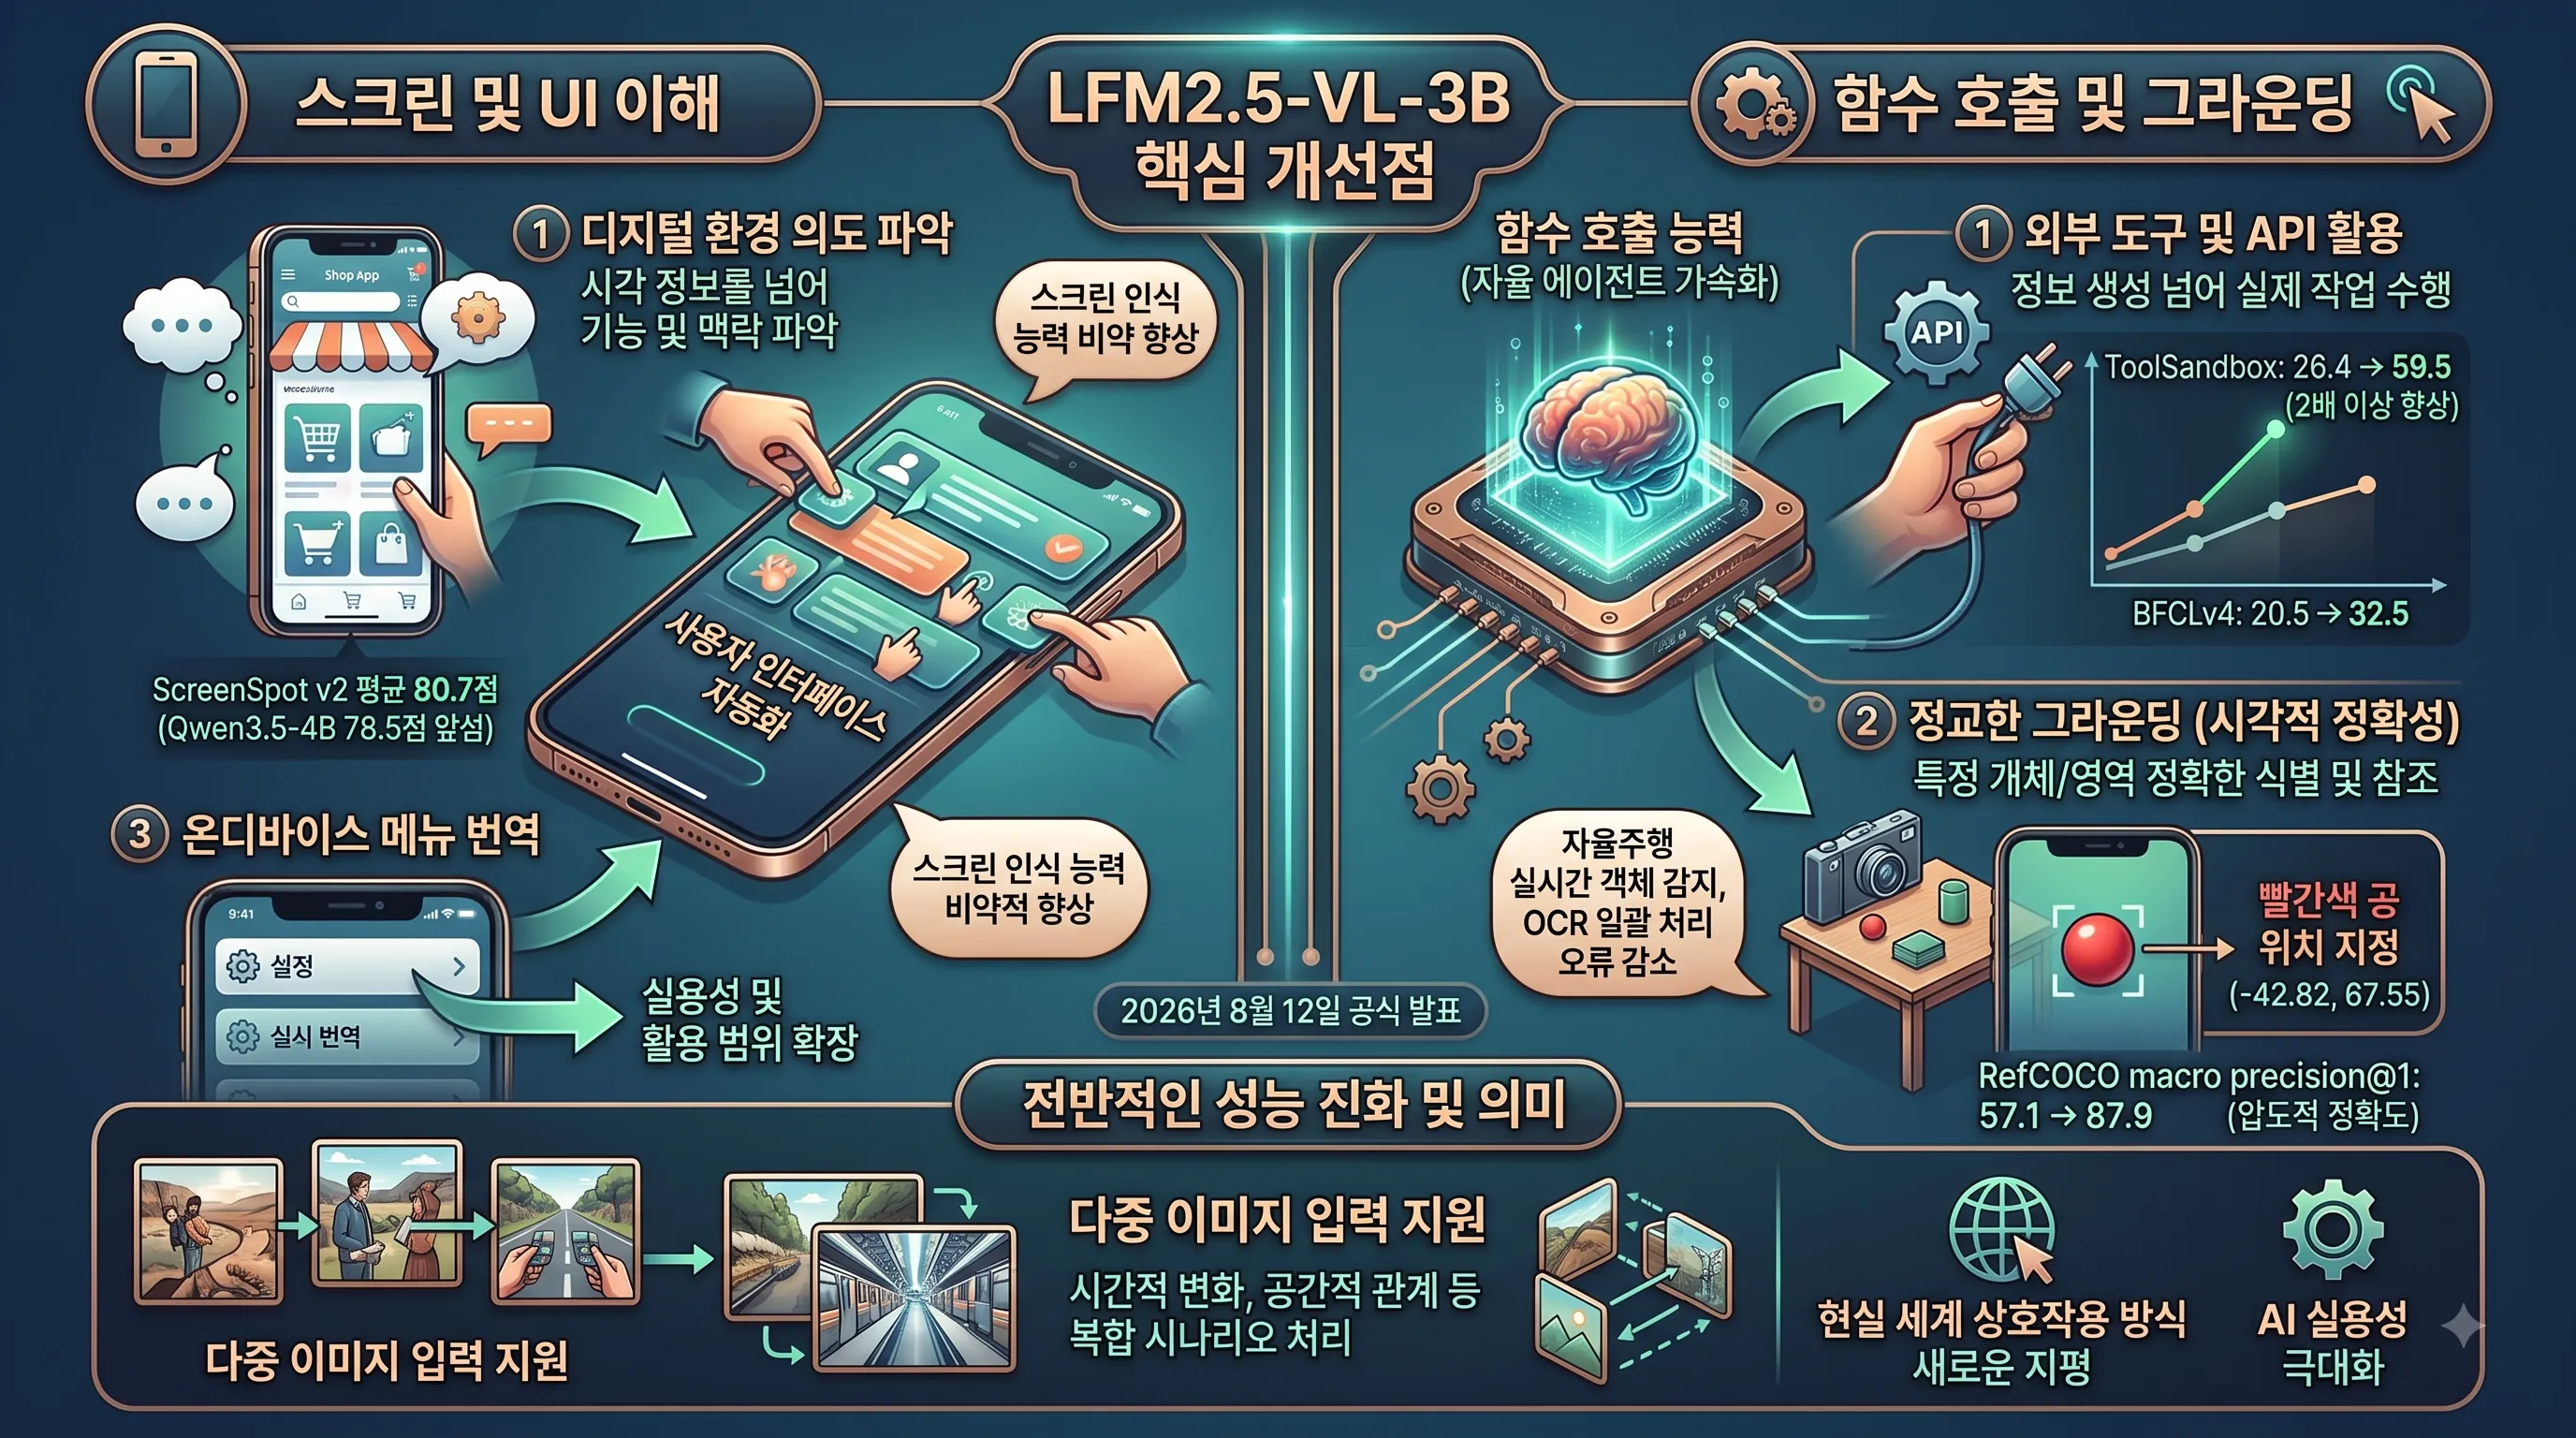
- 주요 개선점: 스크린 및 UI 이해도 비약적 향상 (ScreenSpot v2 80.7점), 함수 호출 능력 강화 (ToolSandbox 59.5점, BFCLv4 32.5점), 그라운딩 정교화 (RefCOCO 87.9점), 다중 이미지 입력 지원.
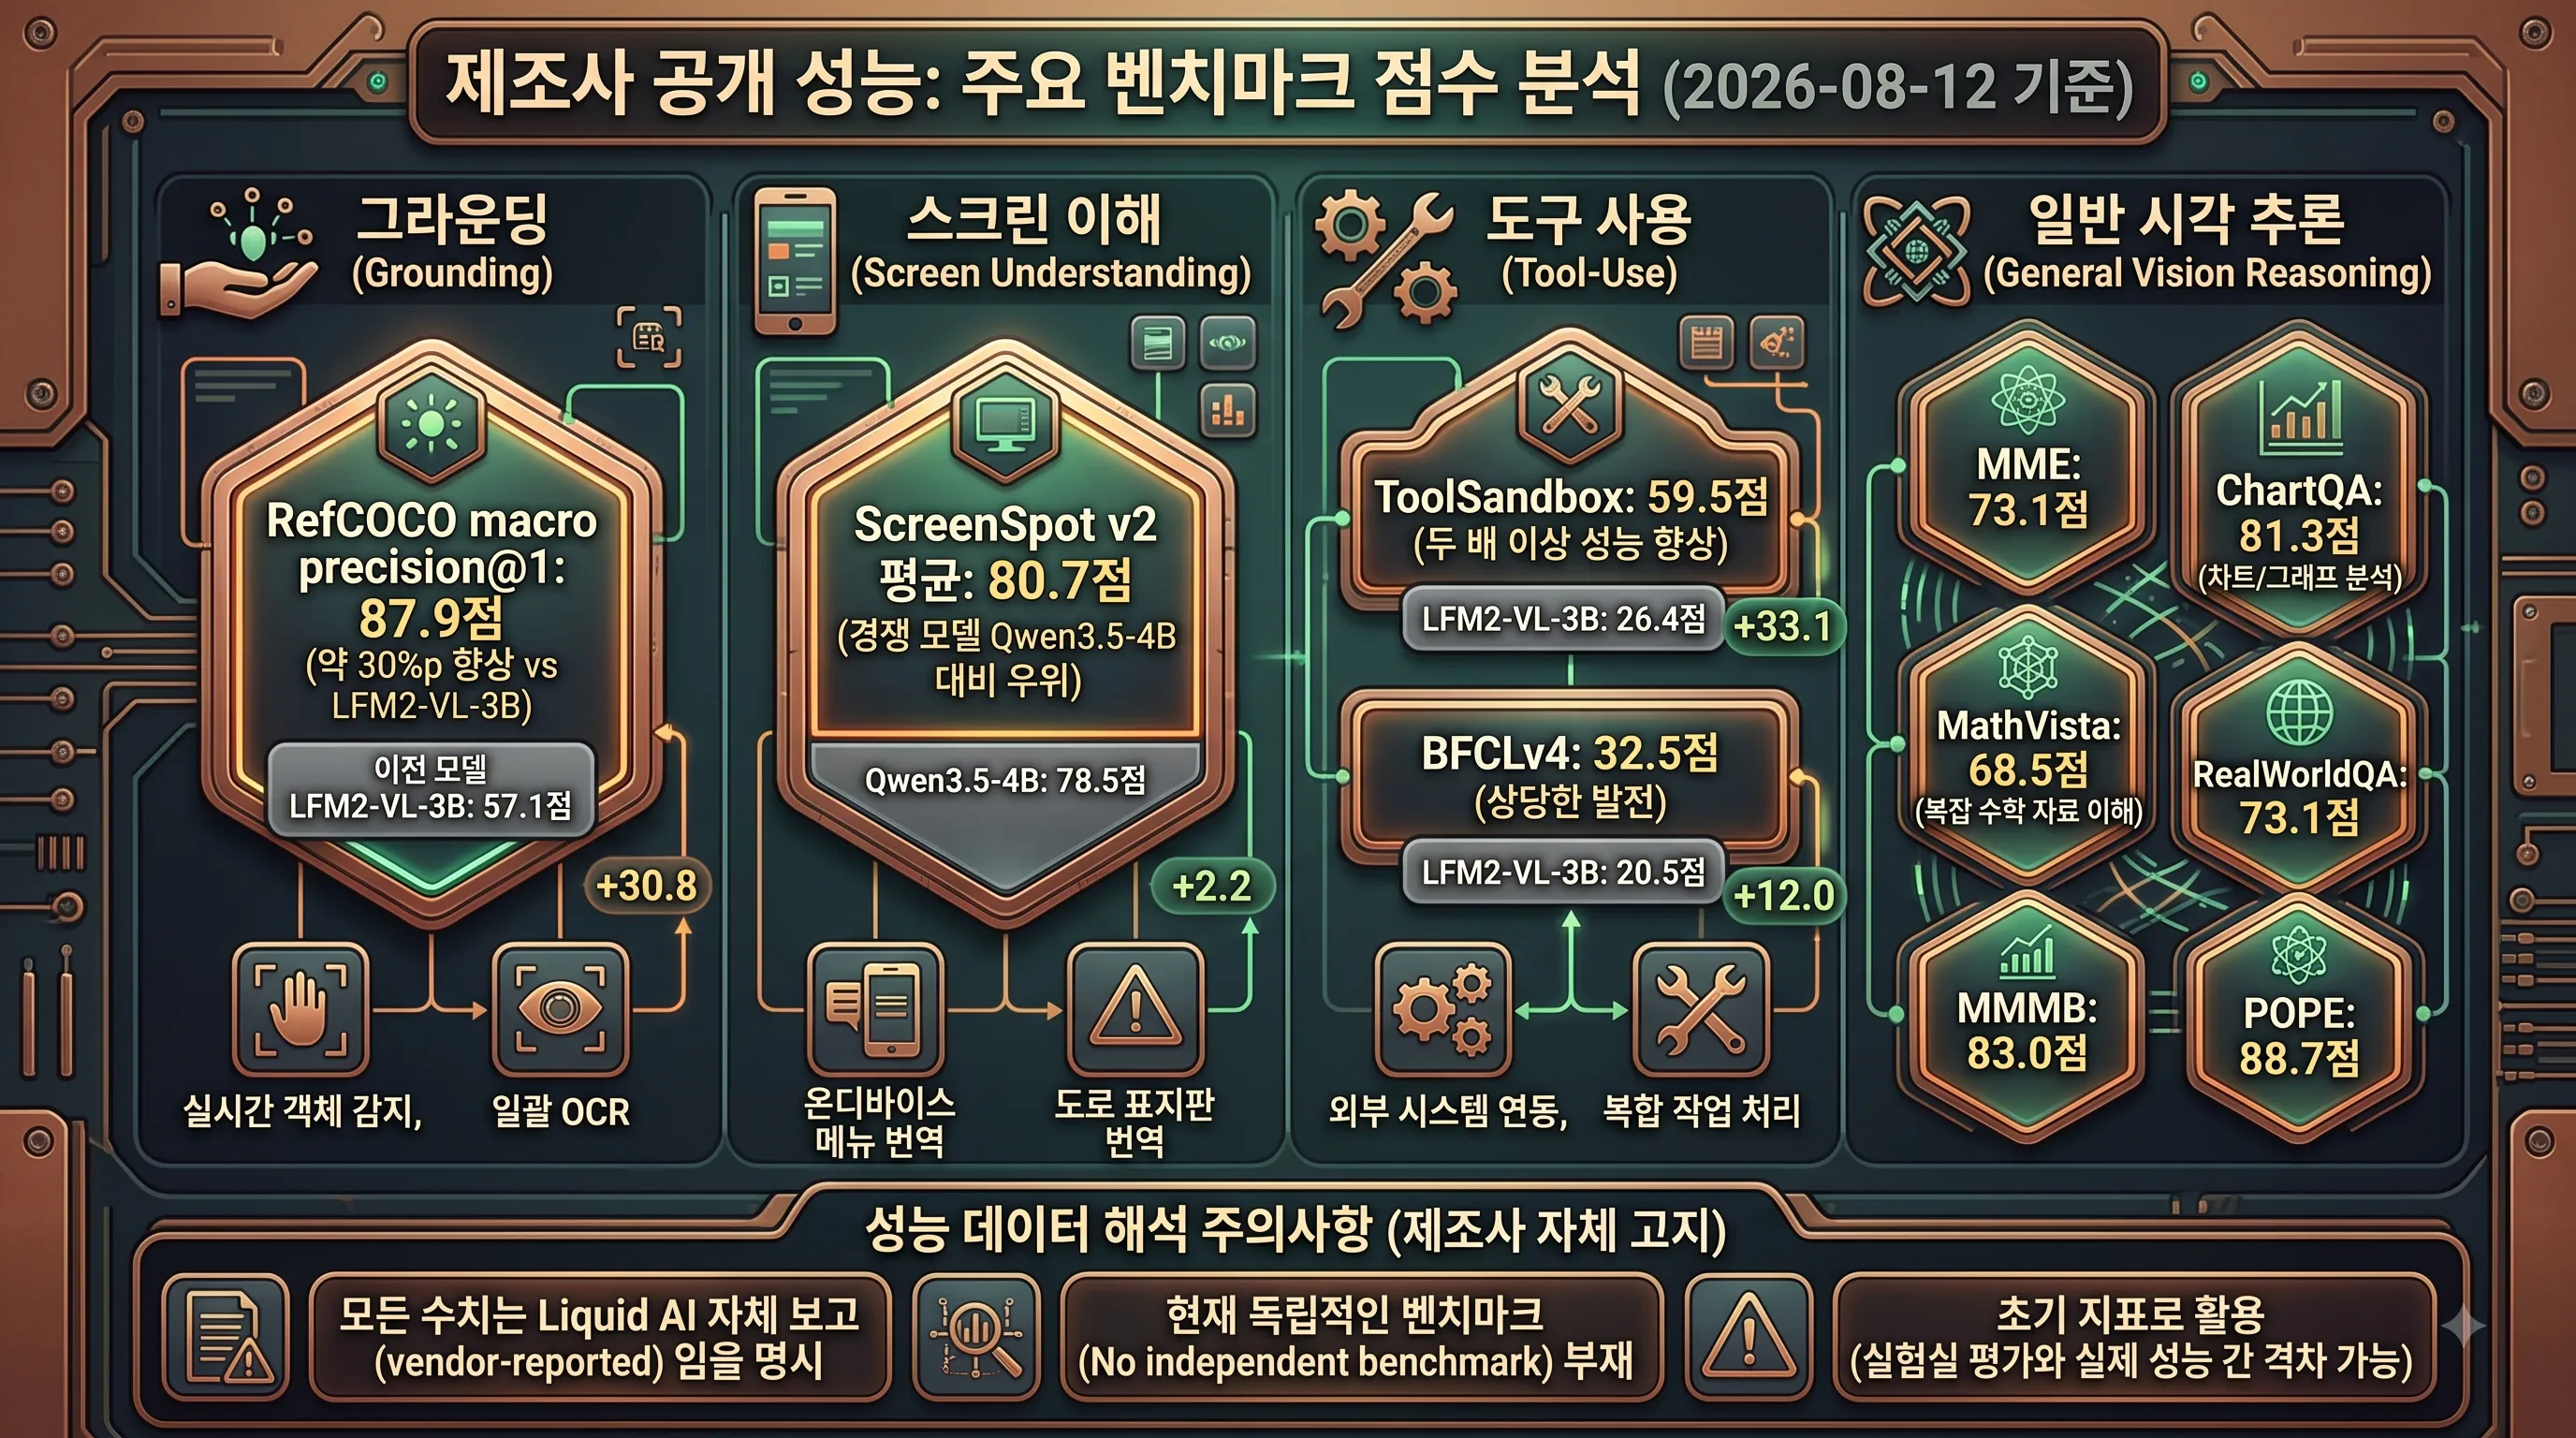
- 성능 벤치마크 (제조사 보고): RefCOCO 87.9점, ScreenSpot v2 80.7점, ToolSandbox 59.5점, OCRBenchv2 47.5점 등 다양한 멀티모달 영역에서 높은 점수 기록.
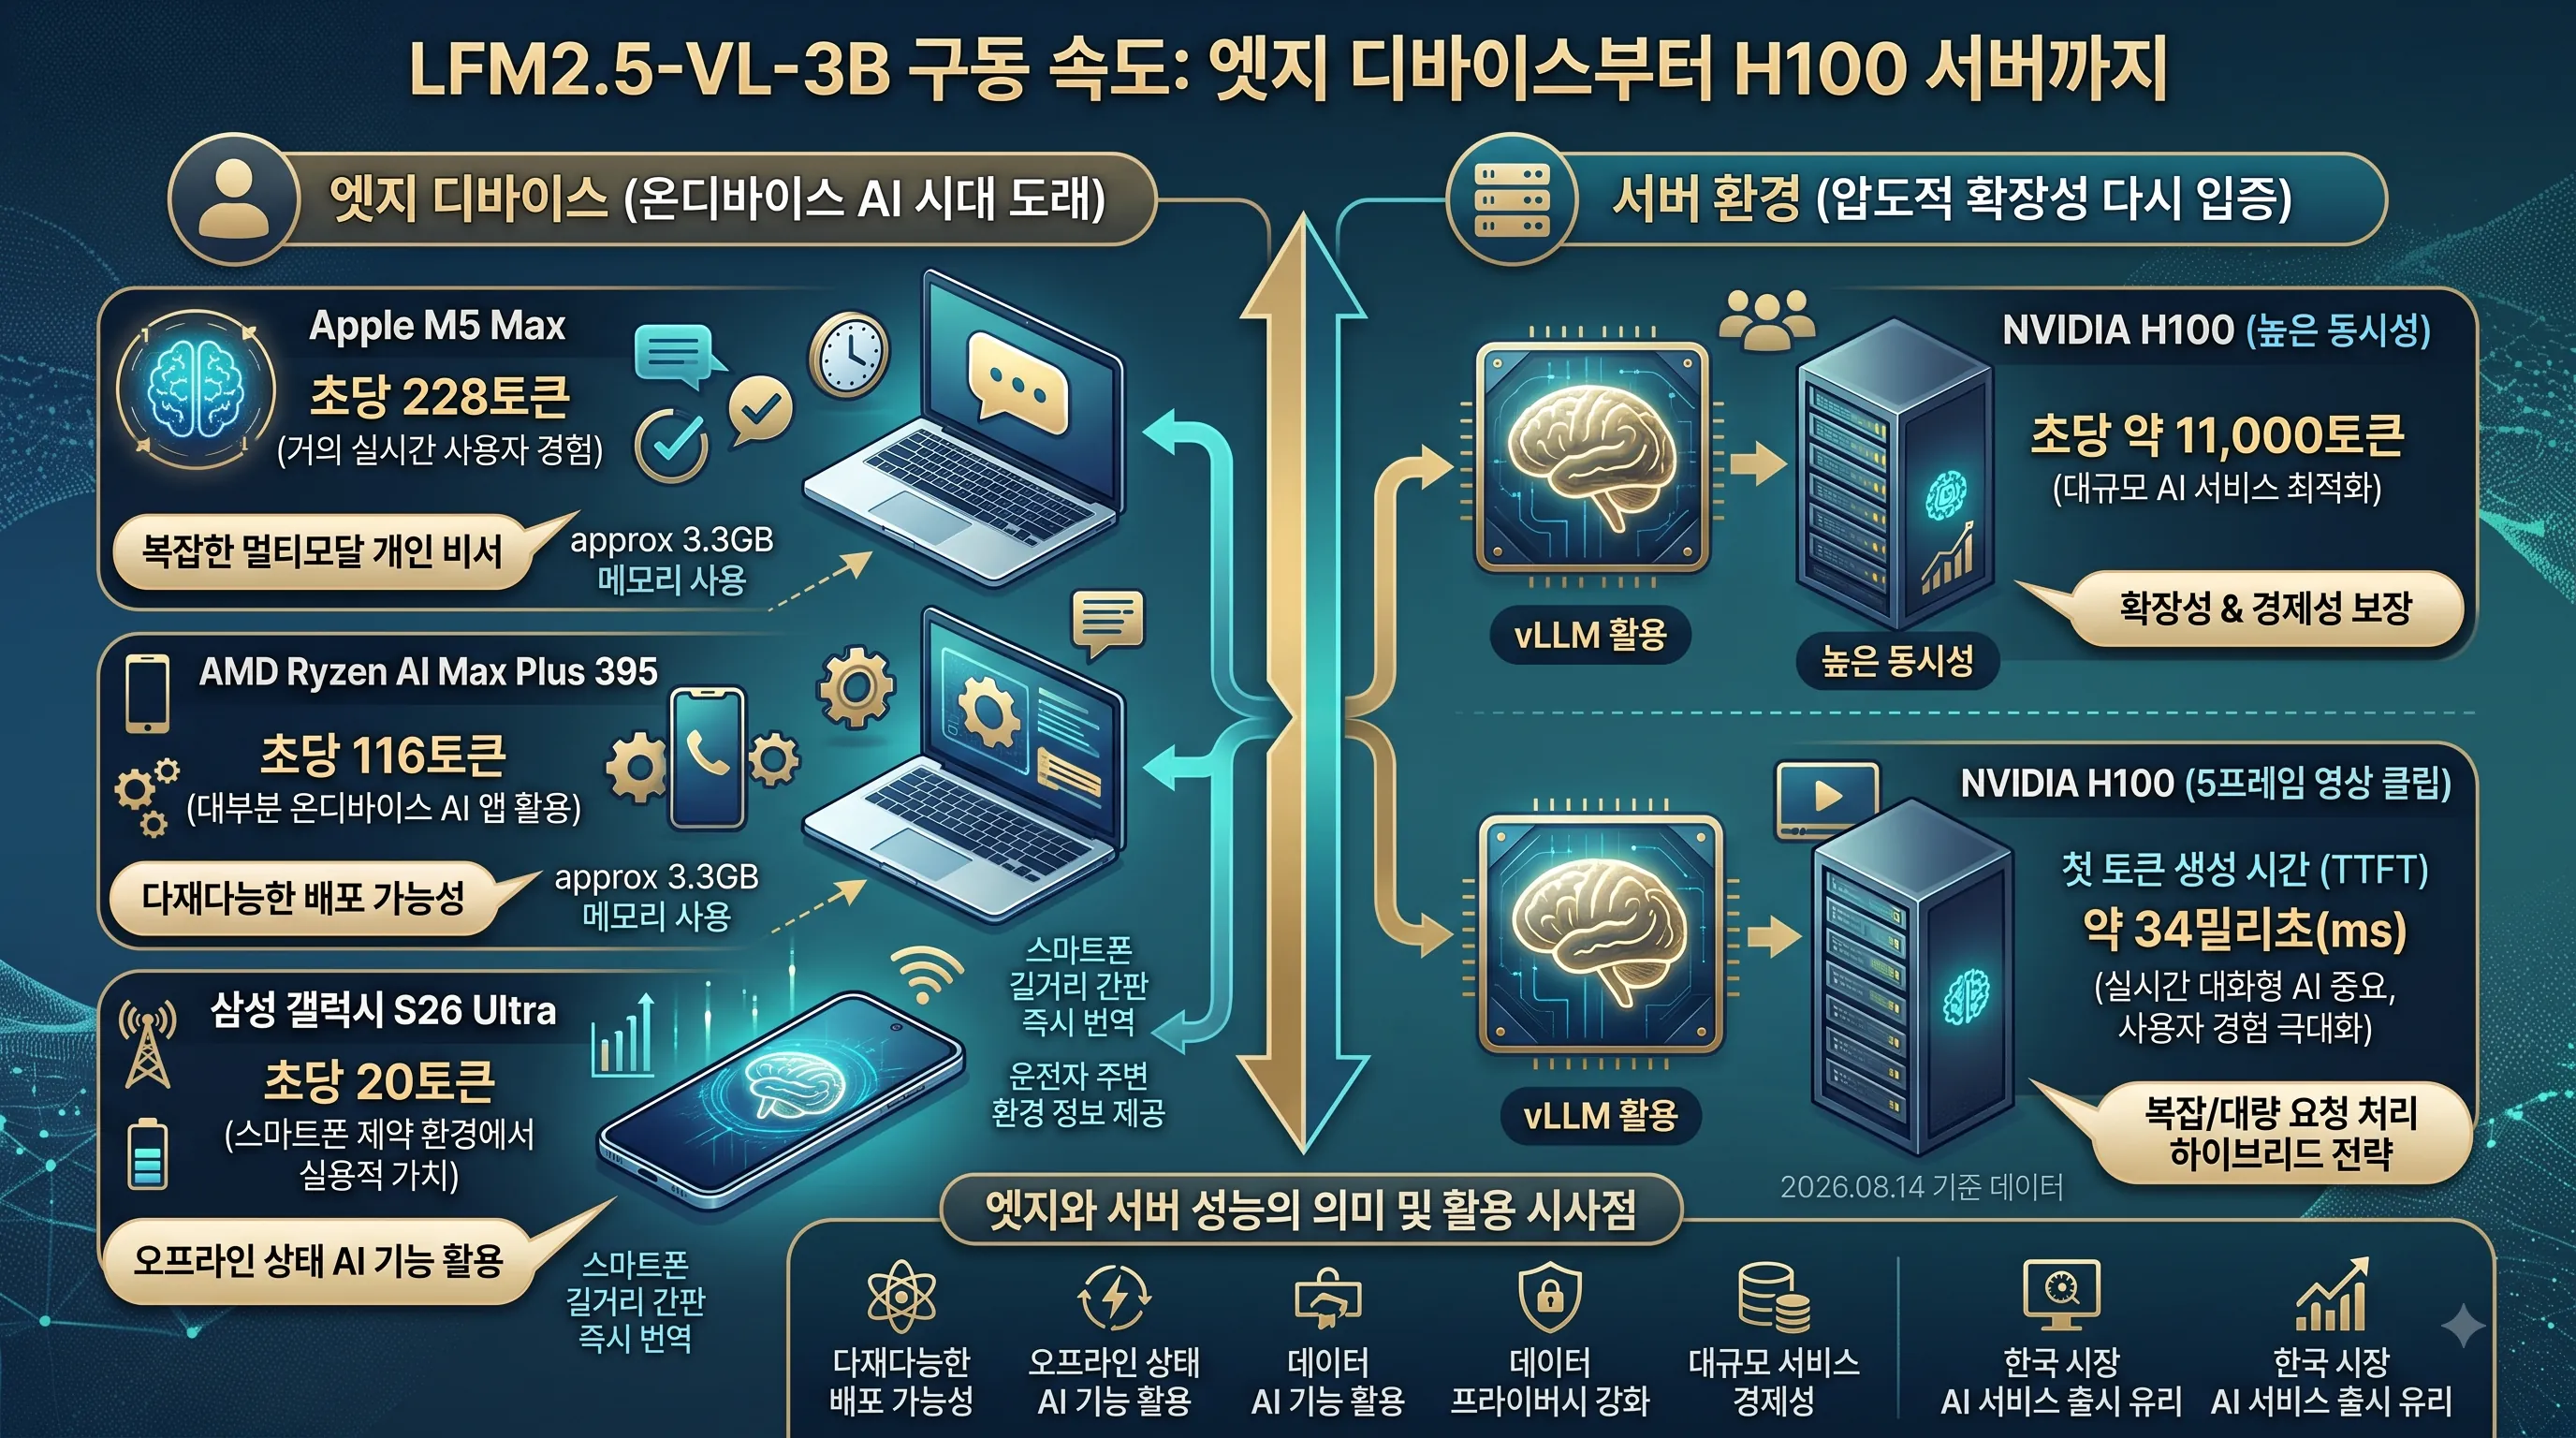
- 구동 속도: 엣지 디바이스 (Apple M5 Max: 228토큰/초, AMD Ryzen AI Max Plus 395: 116토큰/초, 삼성 갤럭시 S26 Ultra: 20토큰/초), 서버 환경 (NVIDIA H100 vLLM: 11,000토큰/초, 첫 토큰 생성 시간(TTFT): 34ms).
- 배포 전략: API 없는 자체 호스팅(Self-host) 전용. llama.cpp, MLX, vLLM, SGLang, ONNX, Transformers 등 광범위한 런타임 및 GGUF, ONNX, MLX 양자화, bf16 체크포인트 등 다양한 형식 지원.
- 초기 한계: 독립 검증 부재, 실사용 데이터 전무 ('zero downloads' 상태), 일부 실험적 기능 (레이아웃 주석 출력), 장문 맥락 추론 및 시각적 웹 디자인 등 특정 사용 제한.
- [주의] 본 모델은 국내 온라인 쇼핑몰 'lfm.kr'과는 전혀 무관한 해외 AI 모델임.
1. Liquid AI의 30억 매개변수 비전-언어 모델, LFM2.5-VL-3B 핵심 사양
모델의 기본 정체성: Liquid AI의 비전-언어 모델
2026년 8월 14일 현재, 인공지능 분야의 신흥 강자인 Liquid AI가 개발한 혁신적인 비전-언어 모델인 LFM2.5-VL-3B가 업계의 주목을 받고 있습니다.
이 모델은 이름에서 짐작할 수 있듯이, 이미지와 텍스트를 모두 입력으로 받아들여 텍스트를 출력하는 비전-언어 모델(Vision-Language Model)의 범주에 속합니다.
이러한 모델은 시각적 정보와 언어적 정보를 통합적으로 이해하고 추론하는 능력을 바탕으로, 복잡한 멀티모달(multi-modal) 환경에서 광범위한 애플리케이션에 활용될 잠재력을 가집니다.
특히 LFM2.5-VL-3B는 약 3.1억 개의 매개변수(Total Parameters)를 지닌 경량 모델로, 모델명에 포함된 '3B'가 이를 명확히 보여줍니다.
이는 수백억에서 수조 개의 매개변수를 지닌 거대 모델들이 주류를 이루는 현 AI 시장에서, 경량성과 효율성을 강조하며 엣지 디바이스나 특정 고성능 요구 환경에 최적화된 솔루션임을 시사합니다.
Liquid AI는 이 모델을 통해 막대한 연산 자원이 필요한 기존 모델들의 한계를 극복하고, 더욱 다양한 환경에서 AI의 가치를 실현하고자 하는 비전을 제시하고 있습니다.
혁신적인 아키텍처와 기술적 기반
LFM2.5-VL-3B의 성능 뒤에는 하이브리드(Hybrid) 아키텍처라는 독특한 기술적 기반이 자리 잡고 있습니다.
이 아키텍처는 단거리 게이티드 컨볼루션 블록(short-range gated convolution blocks)과 그룹 쿼리 어텐션(grouped-query attention)을 결합한 형태로 설계되었습니다.
전통적인 트랜스포머 기반 모델들이 주로 어텐션 메커니즘에 의존하는 것과 달리, 컨볼루션 블록의 활용은 특정 유형의 시퀀스 데이터 처리에서 효율성을 높이고, 모델의 전반적인 연산 부담을 줄이는 데 기여할 수 있습니다.
특히 그룹 쿼리 어텐션은 어텐션 계산 시 발생하는 메모리 및 연산 부하를 최적화하여, 상대적으로 적은 매개변수로도 높은 성능을 달성할 수 있도록 돕는 핵심 기술입니다.
이러한 아키텍처의 선택은 LFM2.5-VL-3B가 고성능과 함께 경량성을 동시에 추구하는 Liquid AI의 개발 철학을 반영합니다.
모델의 기본 언어 모델은 LFM2.5-2.6B이며, 시각 인코더로는 SigLIP2 NaFlex 400M을 채택하여 이미지 처리 능력을 강화했습니다.
이는 텍스트와 이미지 간의 심층적인 상호작용을 가능하게 하며, 시각적 질문 응답, 이미지 캡셔닝, 오브젝트 감지 등 다양한 비전-언어 작업에서 강력한 성능을 발휘하도록 설계된 것입니다.
광범위한 언어 지원 및 컨텍스트 처리 능력
LFM2.5-VL-3B는 글로벌 시장을 겨냥하여 매우 광범위한 언어 지원을 제공합니다.
영어(English)는 물론, 아시아 주요 언어인 한국어(Korean), 중국어(Chinese), 일본어(Japanese)를 포함하여, 아랍어, 프랑스어, 독일어, 힌디어, 인도네시아어, 이탈리아어, 폴란드어, 포르투갈어, 러시아어, 스페인어, 태국어, 베트남어 등 총 16개 언어를 지원합니다.
이는 다양한 국가 및 문화권의 사용자들이 언어 장벽 없이 이 모델을 활용할 수 있도록 함으로써, 모델의 범용성과 접근성을 크게 향상시킵니다.
특히 한국어 지원은 국내 기업 및 개발자들에게 LFM2.5-VL-3B를 활용할 수 있는 중요한 기회를 제공합니다.
또한 이 모델은 32,768 토큰(tokens)에 달하는 매우 넓은 컨텍스트 윈도우(Context_Window)를 자랑합니다.
이는 모델이 한 번에 처리하고 이해할 수 있는 정보의 양을 의미하며, 긴 문서나 복잡한 대화, 여러 장의 이미지 시퀀스 등 장문의 맥락을 필요로 하는 작업에서 월등한 성능을 발휘할 수 있게 합니다.
넓은 컨텍스트 윈도우는 특히 복잡한 보고서 분석, 긴 회의록 요약, 다단계 추론이 필요한 질의응답 시스템 등에서 사용자에게 탁월한 경험을 제공할 것입니다.
개방형 라이선스와 접근성
LFM2.5-VL-3B는 Liquid의 lfm1.0 오픈 라이선스(Liquid's lfm1.0 open license)를 통해 공개되었습니다.
이는 개발자들이 이 모델을 자유롭게 활용하고, 수정하며, 배포할 수 있음을 의미하며, AI 생태계의 발전과 혁신을 촉진하는 중요한 요소입니다.
오픈 라이선스는 특히 스타트업이나 연구 기관과 같이 자체적인 모델 개발 여력이 부족한 곳에서도 LFM2.5-VL-3B의 강력한 기능을 활용하여 새로운 서비스나 애플리케이션을 개발할 수 있는 길을 열어줍니다.
이러한 개방성은 모델의 기술적 잠재력을 더욱 광범위하게 확산시키고, 다양한 산업 분야에서의 적용 가능성을 높이는 데 크게 기여할 것으로 기대됩니다.
2. 이전 모델 대비 핵심 개선점: 스크린 인식 및 함수 호출 능력
2026년 8월 11일, HuggingFace에 가중치가 공개되고 8월 12일 Liquid AI에 의해 공식 상세 설명이 게시된 LFM2.5-VL-3B 모델은 전작인 LFM2-VL-3B의 멀티모달 변형으로, 중간 및 사후 훈련(mid- and post-training)을 통해 중요한 발전을 이루어냈습니다.
이러한 진화는 단순히 성능 수치의 개선을 넘어, AI가 현실 세계와 상호작용하는 방식에 있어 새로운 지평을 열었다고 평가받고 있습니다.
특히 스크린 및 UI 이해, 함수 호출 능력, 그라운딩(Grounding), 그리고 다중 이미지 입력(Multi-image input) 기능의 강화는 AI의 실용성과 활용 범위를 크게 확장시키는 핵심 요소로 지목됩니다.
스크린 및 UI 이해도 비약적 향상
LFM2.5-VL-3B의 가장 두드러진 개선점 중 하나는 스크린 및 UI 이해 능력의 비약적인 향상입니다.
이는 모델이 스마트폰 앱 화면, 웹페이지 인터페이스, 다양한 디지털 디스플레이와 같은 시각적 정보를 단순히 이미지로 인식하는 것을 넘어, 그 안에 담긴 요소들의 기능과 상호작용 맥락을 파악할 수 있게 되었음을 의미합니다.
이러한 능력은 사용자 인터페이스 자동화, 디지털 접근성 향상, 그리고 온디바이스 메뉴 번역과 같은 응용 분야에서 핵심적인 역할을 합니다.
실제로 벤더가 보고한 벤치마크에 따르면, ScreenSpot v2 평균 점수에서 80.7점을 기록하여, 경쟁 모델인 Qwen3.5-4B의 78.5점을 앞서는 강력한 성능을 보여주었습니다.
이는 LFM2.5-VL-3B가 디지털 환경에서 사용자의 의도를 더 정확하게 이해하고 적절한 동작을 수행할 잠재력을 가졌음을 시사합니다.
강화된 함수 호출 능력으로 자율 에이전트 시대 가속화
또 다른 핵심 개선점은 모델의 함수 호출 능력(Function calling)입니다.
이는 LFM2.5-VL-3B가 특정 이미지나 텍스트 입력에 대한 응답으로 외부 도구나 API를 호출하고 활용할 수 있는 능력을 갖췄다는 의미입니다.
이는 AI 모델이 단순히 정보를 생성하는 것을 넘어, 실제 작업을 수행하는 자율 에이전트 시스템의 핵심 구성 요소가 될 수 있음을 의미합니다.
이전 모델인 LFM2-VL-3B와 비교했을 때, ToolSandbox 벤치마크에서는 26.4점에서 59.5점으로 두 배 이상 성능이 향상되었으며, BFCLv4에서도 20.5점에서 32.5점으로 상당한 발전을 이루었습니다.
이러한 능력의 강화는 챗봇이 사용자의 요청에 따라 특정 애플리케이션 기능을 실행하거나, 이미지 분석을 통해 얻은 정보로 외부 시스템을 제어하는 등 실제 세계와의 상호작용을 더욱 매끄럽게 만들 수 있는 기반을 제공합니다.
정교해진 그라운딩: 시각적 정확성 극대화
그라운딩(Grounding) 능력의 강화는 LFM2.5-VL-3B가 시각적 정보 내에서 특정 개체나 영역을 보다 정확하게 식별하고 참조할 수 있음을 의미합니다.
예를 들어, "이 이미지에서 빨간색 공은 어디에 있어?"라는 질문에 대해 모델이 단순히 텍스트로 답변하는 것을 넘어, 이미지 내에서 해당 '빨간색 공'의 정확한 위치를 시각적으로 지정할 수 있게 되는 것입니다.
이는 자율주행 차량의 실시간 객체 감지나 스캔된 문서의 OCR 일괄 처리와 같은 정교한 작업에서 오류율을 현저히 줄일 수 있는 중요한 기술적 진보입니다.
실제로 RefCOCO macro precision@1 벤치마크에서 LFM2-VL-3B의 57.1점 대비 LFM2.5-VL-3B는 87.9점이라는 월등히 높은 정확도를 달성하여, 시각적 정보의 이해와 표현에 있어 압도적인 개선을 입증했습니다.
다중 이미지 입력 지원으로 복합적 시나리오 처리 능력 확보
마지막으로, 다중 이미지 입력(Multi-image input) 지원은 LFM2.5-VL-3B가 여러 장의 이미지를 동시에 처리하고 그로부터 복합적인 정보를 추론할 수 있게 되었음을 의미합니다.
이는 단일 이미지로는 파악하기 어려운 시간적 변화, 공간적 관계, 혹은 다양한 각도에서의 정보 등을 종합적으로 분석해야 하는 복잡한 시나리오에 특히 유용합니다.
예를 들어, 연속적으로 촬영된 여러 장의 사진을 통해 특정 상황의 전개를 이해하거나, 한 제품의 여러 면을 촬영한 사진들을 통해 완벽한 3D 모델을 구축하는 데 기여할 수 있습니다.
이러한 기능은 기존 모델의 한계를 뛰어넘어, 더욱 현실적이고 복합적인 시각 정보 처리 요구에 대응할 수 있는 길을 열어줍니다.
3. 제조사 공개 성능: 주요 벤치마크 점수 분석 (2026-08-12 기준)
2026년 8월 12일 Liquid AI가 공식적으로 공개한 LFM2.5-VL-3B 모델의 성능 벤치마크 결과는 다양한 멀티모달 역량에서 인상적인 진전을 보여주었습니다.
다만, 모든 수치는 Liquid AI 자체 보고(vendor-reported)임을 명확히 인지해야 합니다.
현재까지는 독립적인 벤치마크(No independent benchmark)가 부재하므로, 이 점수들은 모델의 잠재력을 가늠하는 초기 지표로 활용될 수 있습니다.
이는 "새로운 모델의 경우 실험실 평가 점수와 실제 성능 간에 격차가 발생하는 것이 일반적"이라는 제조사의 자체 고지 사항과도 일맥상통합니다.
주요 벤치마크 성능 비교
| 벤치마크 범주 | 벤치마크명 | LFM2.5-VL-3B 점수 | 이전/경쟁 모델 점수 | 비고 |
|---|---|---|---|---|
| 그라운딩 (Grounding) | RefCOCO macro precision@1 | 87.9점 | LFM2-VL-3B: 57.1점 | 약 30%p 향상, 실시간 객체 감지, 일괄 OCR 등 활용 |
| 스크린 이해 (Screen Understanding) | ScreenSpot v2 평균 | 80.7점 | Qwen3.5-4B: 78.5점 | 경쟁 모델 대비 우위, 온디바이스 메뉴/도로 표지판 번역 활용 |
| 도구 사용 (Tool-Use) | ToolSandbox | 59.5점 | LFM2-VL-3B: 26.4점 | 두 배 이상 성능 향상, 외부 시스템 연동 및 복합 작업 처리 |
| BFCLv4 | 32.5점 | LFM2-VL-3B: 20.5점 | 상당한 발전 | |
| 일반 시각 추론 (General Vision Reasoning) | MME | 73.1점 | - | 다양한 시각 데이터 처리 능력 |
| MMStar | 63.3점 | - | - | |
| RealWorldQA | 73.1점 | - | - | |
| MMMB | 83.0점 | - | - | |
| ChartQA | 81.3점 | - | 차트/그래프 데이터 분석 | |
| MathVista | 68.5점 | - | 복잡한 수학적 시각 자료 이해 | |
| POPE | 88.7점 | - | - | |
| OCR 성능 (OCR) | OCRBenchv2 (영어 서브셋) | 47.5점 | 이전 모델: 43.9점 | 소폭 상승, 배치 OCR 등 활용 가능성 증대 |
| 복합적 멀티모달 추론 (Hard Multimodal Reasoning) | MMMU_Pro | 30.5점 | - | 고차원 지식 및 추론 능력 요구 |
| BLINK | 61.5점 | - | - | |
| MuirBench | 58.3점 | - | - |
이러한 결과는 LFM2.5-VL-3B가 차트나 그래프의 데이터를 분석하거나, 복잡한 수학적 시각 자료를 이해하고, 일상적인 이미지 속의 추론 문제를 해결하는 등 다양한 형태의 시각적 정보를 효과적으로 처리할 수 있음을 의미합니다.
4. 엣지 디바이스와 서버에서의 속도: Apple M5 Max부터 H100까지
최근 공개된 Liquid AI의 비전-언어 모델(VLM)인 LFM2.5-VL-3B는 엣지 디바이스부터 고성능 서버 환경까지 다양한 플랫폼에서 인상적인 구동 속도를 보여주고 있습니다.
특히 이미지와 텍스트를 동시에 처리하며 텍스트를 출력하는 이 모델의 실제 토큰 생성 속도는 온디바이스 AI 시대의 도래를 명확히 시사하며, 동시에 클라우드 환경의 압도적인 확장성을 다시 한번 입증합니다.
LFM2.5-VL-3B 구동 속도 (엣지 디바이스 및 서버)
| 구동 환경 | 디바이스/GPU | 성능 지표 | LFM2.5-VL-3B 속도 | 비고 |
|---|---|---|---|---|
| 엣지 디바이스 (약 3.3GB 메모리 사용) | Apple M5 Max | 텍스트 생성 속도 | 초당 228토큰 | 거의 실시간 사용자 경험 제공 |
| AMD Ryzen AI Max Plus 395 | 텍스트 생성 속도 | 초당 116토큰 | 대부분의 온디바이스 AI 앱에 활용 가능 | |
| 삼성 갤럭시 S26 Ultra (플래그십 스마트폰) | 텍스트 생성 속도 | 초당 20토큰 | 스마트폰 제약 환경에서 실용적 가치 | |
| 서버 환경 | NVIDIA H100 (vLLM, 높은 동시성) | 텍스트 생성 속도 | 초당 약 11,000토큰 | 대규모 AI 서비스 환경에 최적화 |
| NVIDIA H100 (vLLM, 5프레임 영상 클립 기준) | 첫 토큰 생성 시간 (TTFT) | 약 34밀리초(ms) | 실시간 대화형 AI에 중요, 사용자 경험 극대화 |
엣지와 서버 성능의 의미 및 활용 시사점
LFM2.5-VL-3B의 엣지 및 서버 환경에서의 속도 측정 결과는 이 모델의 다재다능한 배포 가능성을 명확히 보여줍니다.
Apple M5 Max와 같은 고성능 엣지 디바이스에서는 복잡한 멀티모달 작업을 거의 실시간으로 처리할 수 있는 개인 비서와 같은 기능을 구현할 수 있으며, 갤럭시 S26 Ultra와 같은 스마트폰에서는 모바일 기기 자체적으로 강력한 시각 및 언어 이해 능력을 제공하여 오프라인 상태에서도 AI 기능을 활용할 수 있는 길을 열었습니다.
이는 '자동차가 내비게이션 없이 주변 환경을 이해하여 운전자에게 정보를 제공'하거나, '스마트폰으로 길거리 간판을 찍으면 즉시 번역해주는' 등 Liquid AI가 제시하는 사용 사례에 완벽하게 부합합니다.
반면, H100 기반 서버 환경의 압도적인 속도는 대규모 서비스 제공을 위한 확장성과 경제성을 보장합니다.
이는 동시에 수많은 요청을 처리해야 하는 기업이나 개발자들에게 LFM2.5-VL-3B가 강력한 선택지가 될 수 있음을 의미합니다.
특히 한국 시장에서 AI 기반 서비스를 출시하려는 스타트업이나 대기업에게는, 특정 기능을 온디바이스로 제공하여 데이터 프라이버시를 강화하고, 동시에 클라우드 서버를 통해 복잡하거나 대량의 요청을 처리하는 하이브리드 전략을 구사하는 데 있어 이 모델이 핵심적인 역할을 할 수 있을 것입니다.
이러한 속도 데이터는 LFM2.5-VL-3B가 '엣지를 위한 더 나은, 더 빠른 비전-언어 모델'이라는 Liquid AI의 주장을 뒷받침하는 강력한 근거가 됩니다.
5. API 없는 직접 배포: LFM2.5-VL-3B의 자체 호스팅 생태계와 활용법
Liquid AI가 개발한 최신 비전-언어 모델(VLM)인 LFM2.5-VL-3B는, 2026년 8월 11일 HuggingFace에 가중치가 공개되고 2026년 8월 12일 Liquid AI의 공식 문서가 게시되면서 세간의 주목을 받았습니다.
하지만 이 모델은 기존의 클라우드 기반 API 서비스와는 다른 독특한 배포 전략을 취하고 있습니다.
오늘 날짜인 2026년 8월 14일을 기준으로, LFM2.5-VL-3B는 호스팅 엔드포인트가 전혀 제공되지 않으며 오직 자체 호스팅(Self-host)만을 지원하는 모델입니다.
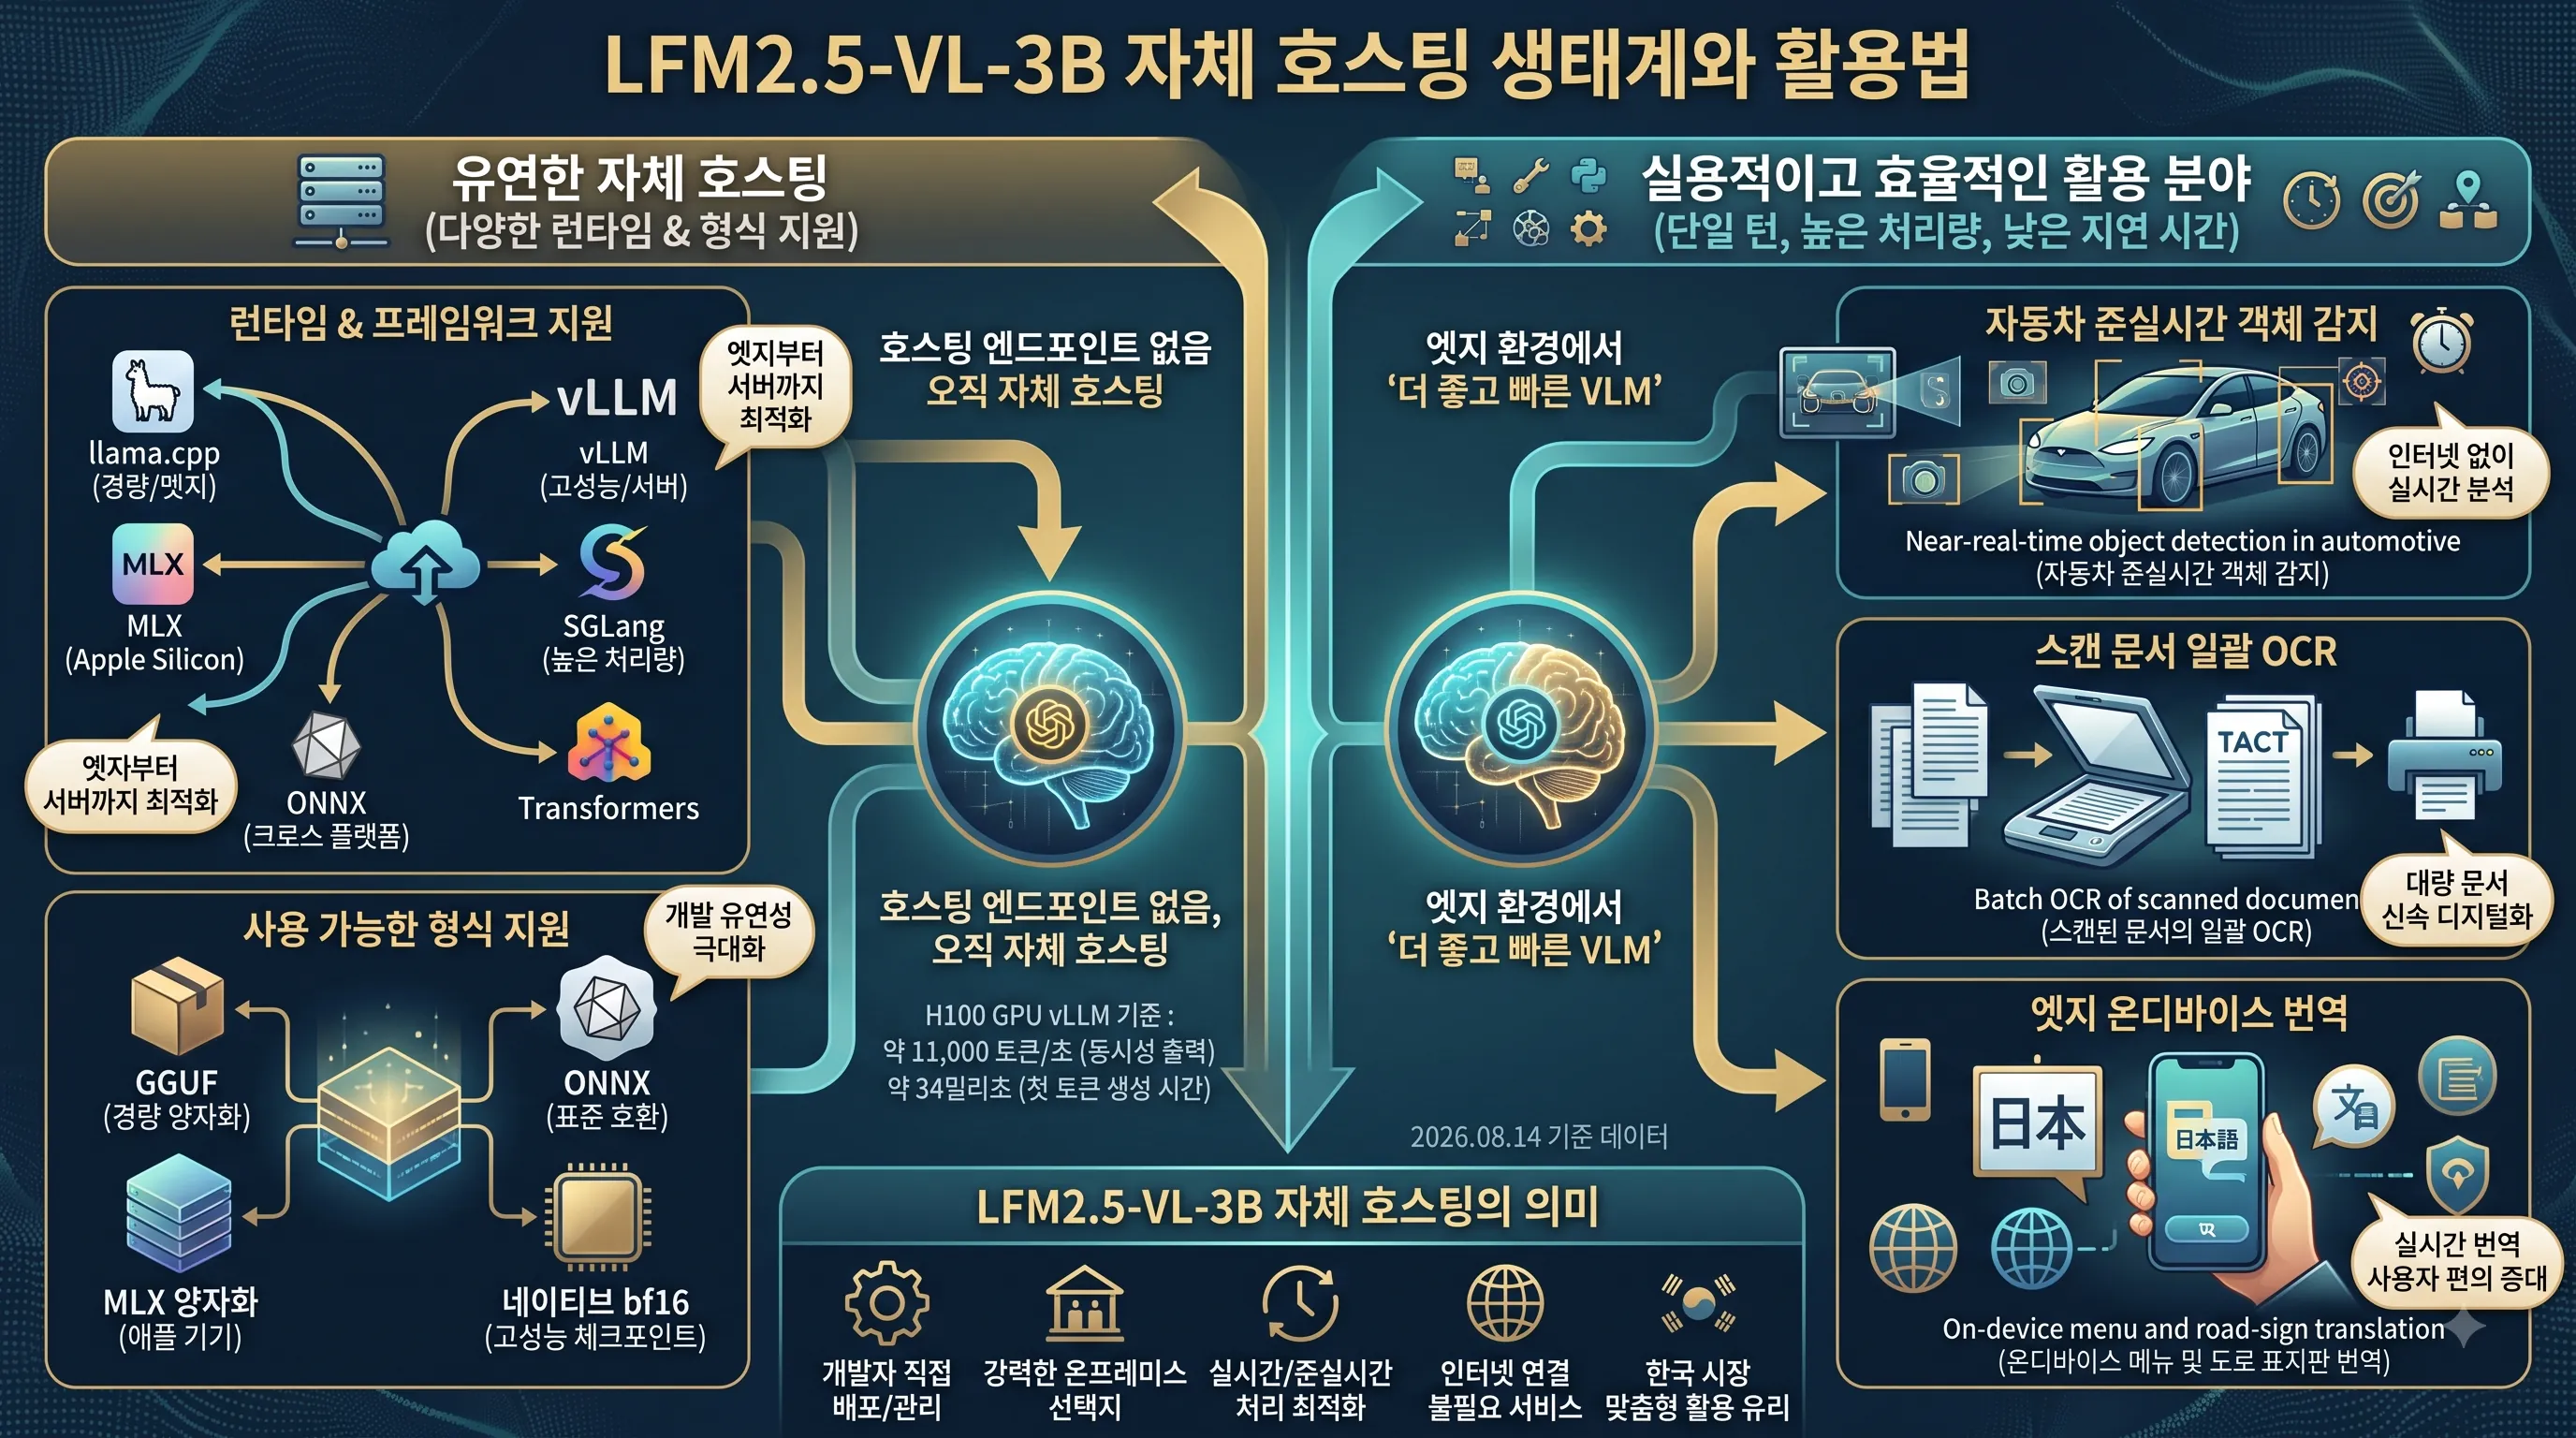
이는 개발자가 모델을 직접 다운로드하여 자체 서버나 기기에 배포하고 관리해야 함을 의미하지만, 동시에 Liquid AI는 자체 호스팅 생태계를 이례적으로 잘 구축하여 매우 유망한 선택지임을 보여줍니다.
유연한 자체 호스팅을 위한 광범위한 런타임 및 형식 지원
LFM2.5-VL-3B의 가장 큰 강점 중 하나는 자체 호스팅 환경을 위한 폭넓고 유연한 지원입니다.
다양한 런타임 및 프레임워크를 지원하여 개발자들이 각자의 인프라와 요구사항에 맞춰 최적의 환경을 구축할 수 있도록 돕습니다.
지원되는 주요 런타임 및 프레임워크로는 llama.cpp, MLX, vLLM, SGLang, ONNX, 그리고 Transformers가 있습니다.
이러러한 선택지는 엣지 디바이스부터 고성능 서버까지 다양한 컴퓨팅 환경에서 모델을 효율적으로 운영할 수 있게 합니다.
특히 llama.cpp는 로컬 및 엣지 디바이스에서의 경량화된 실행에 강점을 가지며, vLLM과 SGLang은 고성능 추론 및 높은 동시성 처리에 최적화되어 있어 서버 환경에서 최대의 처리량을 달성하는 데 유리합니다.
실제로 벤더 보고에 따르면, H100 GPU 환경에서 vLLM을 사용할 경우 약 11,000 토큰/초에 달하는 높은 동시성 출력 속도와 5프레임 클립 기준 약 34밀리초의 빠른 첫 토큰 생성 시간을 보여줍니다.
이러한 속도는 실시간 또는 준실시간 처리가 중요한 애플리케이션에 매우 적합합니다.
또한, LFM2.5-VL-3B는 다양한 형식으로 제공되어 개발 유연성을 극대화합니다.
사용 가능한 형식으로는 GGUF, ONNX, MLX 양자화(Apple Silicon용), 그리고 네이티브 bf16 체크포인트가 있습니다.
GGUF는 주로 llama.cpp와 같은 경량 런타임에서 효율적인 메모리 사용과 빠른 추론을 가능하게 하는 양자화된 모델 파일 형식입니다.
ONNX는 크로스 플랫폼 호환성이 뛰어나 다양한 하드웨어 및 운영체제에서 모델을 배포할 수 있는 표준 형식이며, Apple Silicon 사용자들을 위한 MLX 양자화는 애플 기기에서의 최적화된 성능을 보장합니다.
이러한 폭넓은 지원은 개발자들이 특정 환경에 얽매이지 않고 자유롭게 LFM2.5-VL-3B를 활용할 수 있게 합니다.
실용적이고 효율적인 활용 분야
LFM2.5-VL-3B의 자체 호스팅 생태계는 모델의 강력한 성능과 결합하여 다양한 실용적 활용 분야에서 빛을 발합니다.
추천되는 사용 사례는 주로 단일 턴(single-turn), 높은 처리량(high-throughput), 낮은 지연 시간(low-latency)이 요구되는 작업에 초점을 맞추고 있습니다.
이는 모델이 특히 속도와 효율성 면에서 강점을 가지며, 엣지 디바이스 및 온프레미스 환경에서 최적의 성능을 낼 수 있기 때문입니다.
구체적인 활용 분야로는 자동차 분야의 준실시간 객체 감지(Near-real-time object detection in automotive)가 있습니다.
차량 내부 또는 외부 환경에서 발생하는 시각 정보를 즉각적으로 분석하여 안전 기능이나 운전자 보조 시스템에 활용할 수 있습니다.
또한, 스캔된 문서의 일괄 OCR(Batch OCR of scanned documents)은 대량의 문서를 신속하게 디지털화하고 텍스트를 추출하는 데 매우 효과적입니다.
수많은 기업과 기관에서 축적된 아날로그 문서를 디지털 데이터로 전환하는 데 드는 시간과 비용을 획기적으로 절감할 수 있을 것입니다.
엣지 디바이스에서의 활용성도 뛰어납니다.
온디바이스 메뉴 및 도로 표지판 번역(On-device menu and road-sign translation)과 같은 애플리케이션은 인터넷 연결 없이도 실시간으로 시각 정보를 번역하여 사용자 편의성을 크게 높일 수 있습니다.
예를 들어, 해외 여행 중 스마트폰 카메라로 메뉴판이나 도로 표지판을 비추면 즉시 한국어로 번역된 내용을 볼 수 있어 사용자의 경험을 풍부하게 만들 수 있습니다.
이러한 활용 사례들은 LFM2.5-VL-3B가 엣지 환경에서 '더 좋고 빠른 비전-언어 모델'이라는 벤더의 주장을 뒷받침합니다.
6. 출시 초기 명확한 한계: 독립 검증 부재와 실사용 데이터 '0'
독립 검증 부재: 신뢰성 확보의 첫 번째 난관
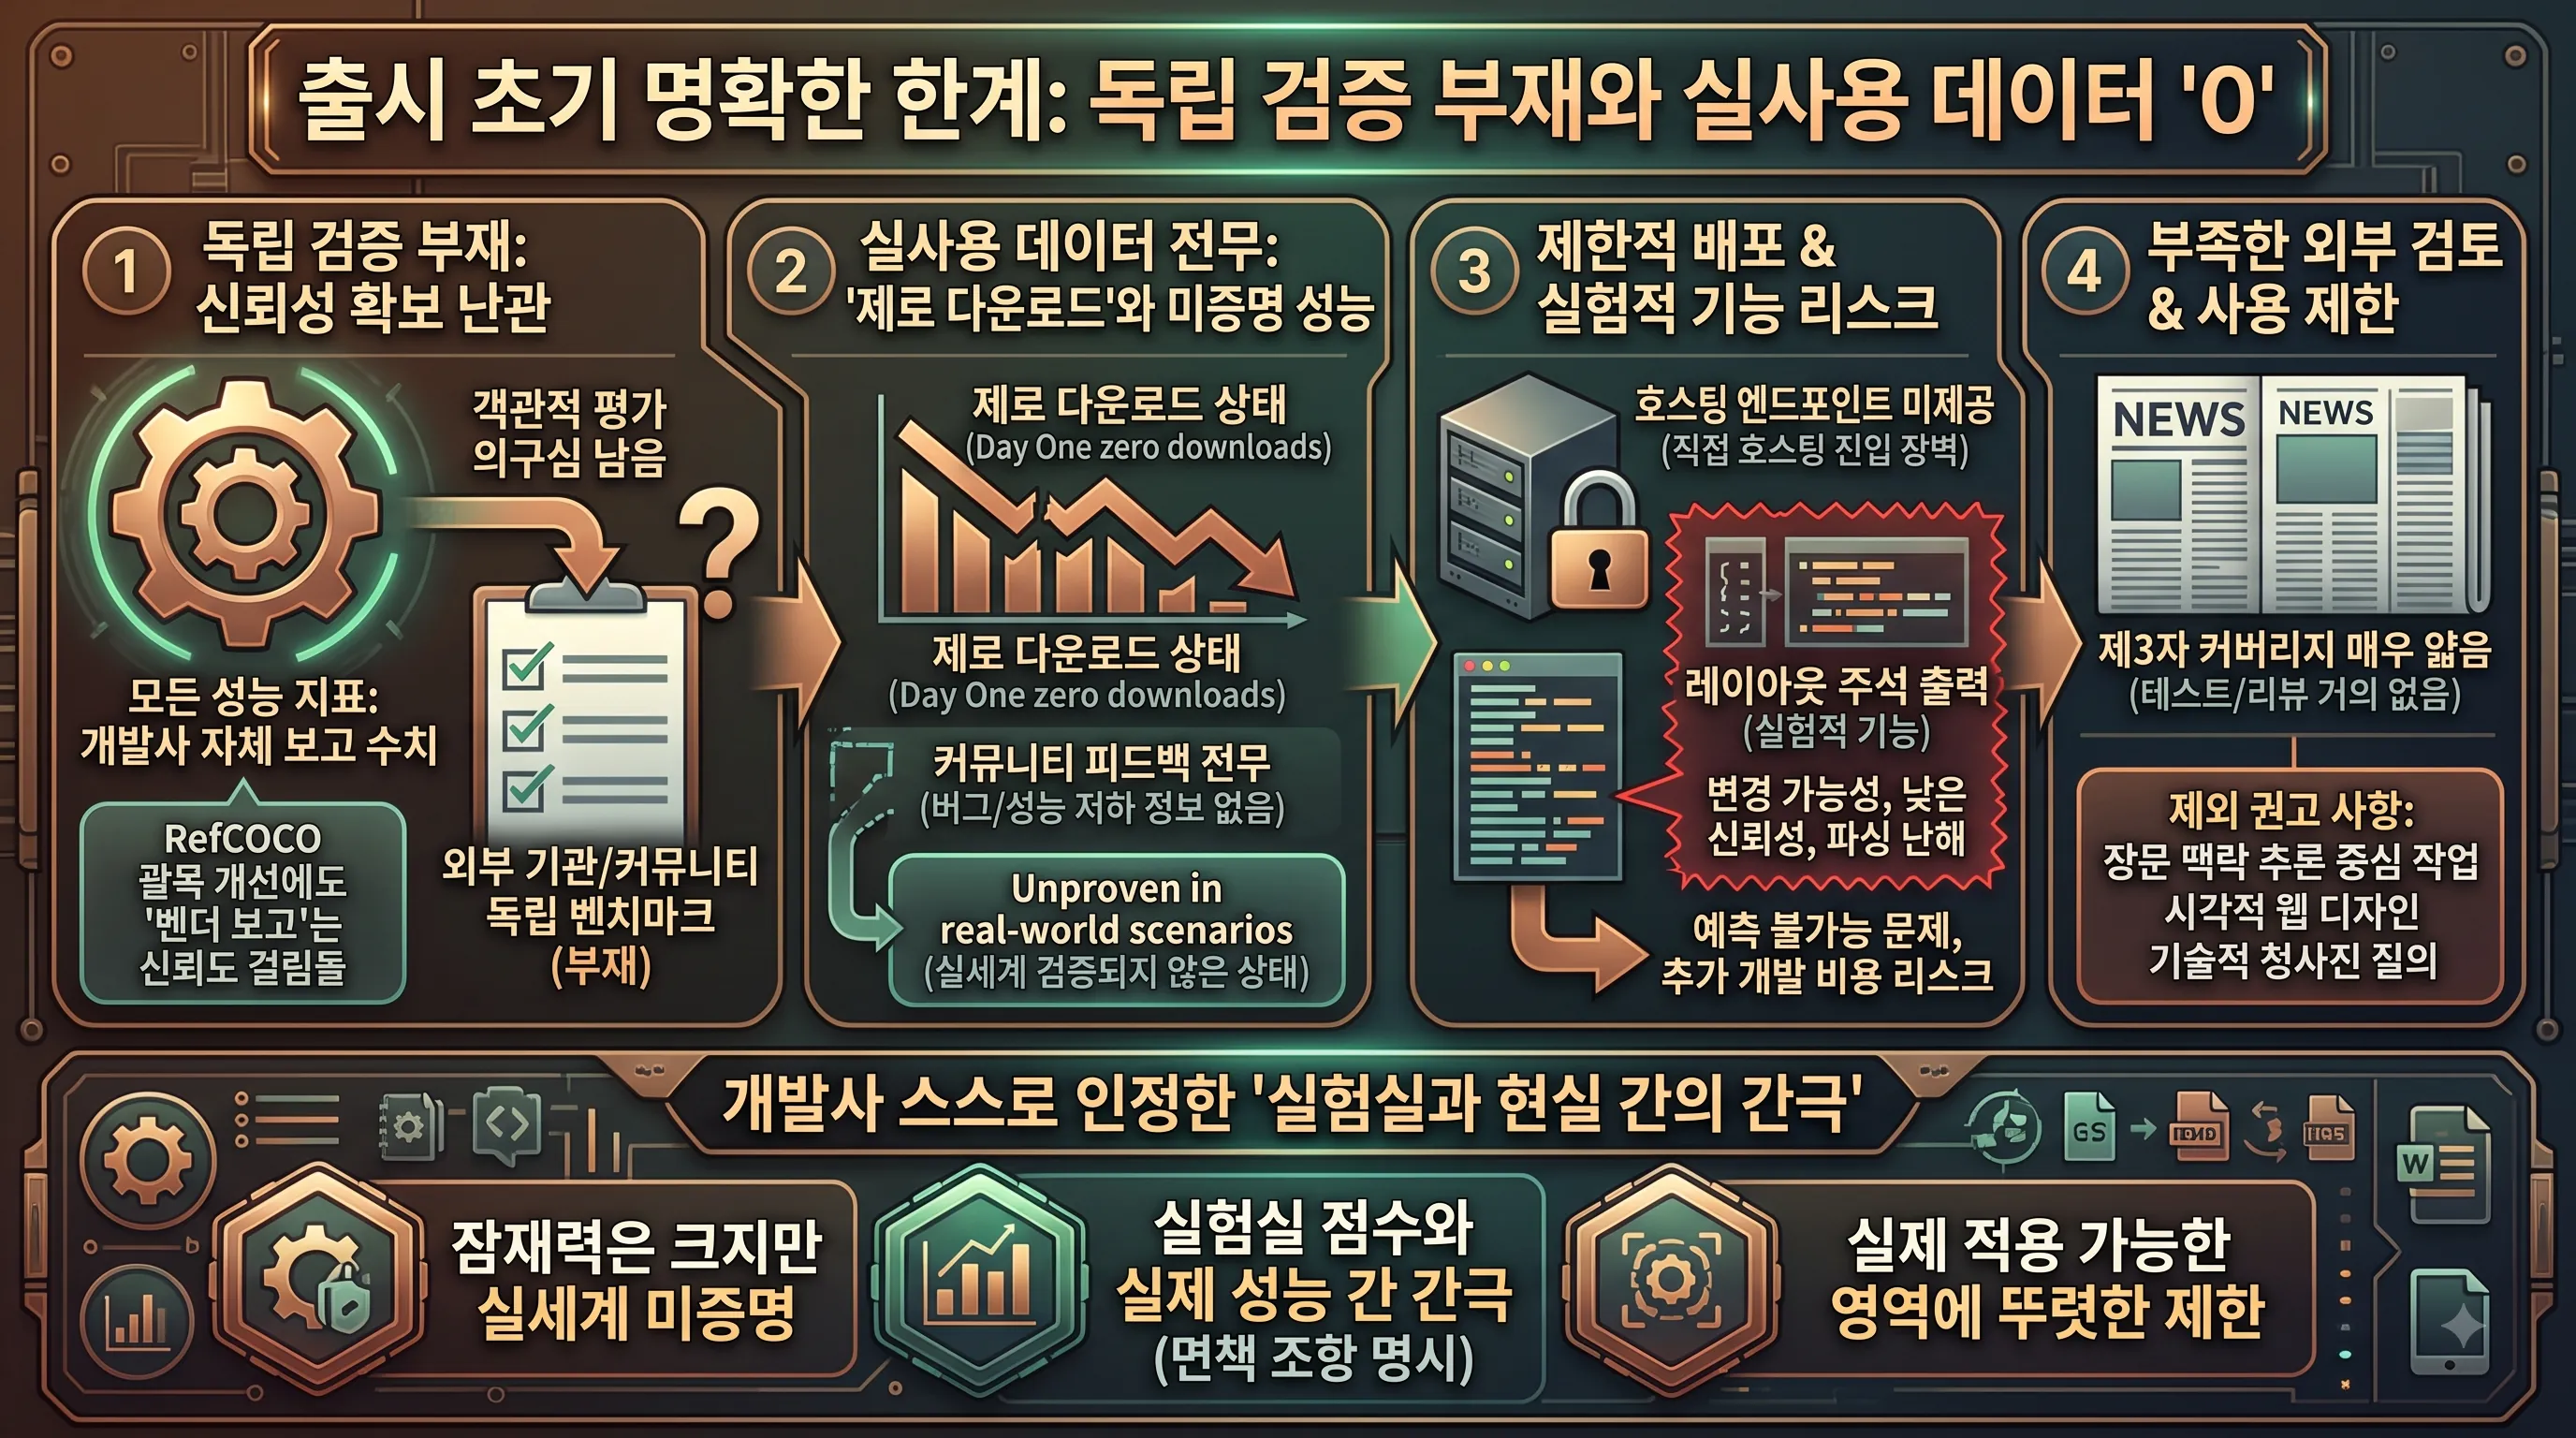
Liquid AI의 LFM2.5-VL-3B 모델은 공개된 벤치마크 점수만 놓고 보면 인상적인 성능을 보여주지만, 출시 초기 단계에서 가장 명확한 한계점은 독립적인 검증의 부재에 있습니다.
현재 공개된 모든 성능 지표는 개발사 자체 보고 수치이며, 이는 객관적인 성능 평가에 대한 의구심을 남길 수밖에 없습니다.
외부 기관이나 연구 커뮤니티의 독립적인 벤치마크 결과 없이는, 모델이 실제 환경에서 주장하는 만큼의 성능을 발휘할지 여부를 단언하기 어렵습니다.
특히, RefCOCO와 같은 주요 멀티모달 벤치마크에서 이전 버전 대비 괄목할 만한 개선을 보였음에도 불구하고, 이 모든 것이 '벤더 보고'라는 점은 잠재 사용자들에게 신뢰도 측면에서 큰 걸림돌로 작용할 수 있습니다.
실사용 데이터 전무: '제로 다운로드' 상태와 미증명된 실제 성능
LFM2.5-VL-3B는 2026년 8월 11일 HuggingFace에 가중치가 처음 공개되었고, 2026년 8월 12일 공식 설명이 게시되었습니다.
그러나 오늘 2026년 8월 14일을 기준으로 볼 때, 이 모델은 아직 실사용 데이터를 전혀 축적하지 못한 상태입니다.
특히 "zero downloads on day one"이라는 팩트는 출시 직후 며칠 동안 커뮤니티의 관심이 미미했거나, 혹은 접근성 문제로 인해 실제 활용이 전무했음을 시사합니다.
이는 곧 커뮤니티 피드백이 전무하다는 의미이며, 실제 운영 환경에서의 버그, 성능 저하, 예상치 못한 행동 등에 대한 정보가 전혀 없다는 뜻입니다.
개발사가 "엣지 AI를 위한 더 빠르고 더 나은 비전-언어 모델"이라고 강조했지만, 이러한 주장은 아직 실세계 시나리오에서 검증되지 않은 상태(Unproven in real-world scenarios)로 남아있습니다.
제한적인 배포 환경과 실험적 기능의 리스크
현재 LFM2.5-VL-3B는 호스팅 엔드포인트가 제공되지 않습니다.
이는 곧 사용자가 모델을 활용하기 위해서는 직접 호스팅 환경을 구축해야 함을 의미하며, 이는 일반 사용자나 소규모 개발팀에게는 상당한 진입 장벽으로 작용합니다.
또한, 모델의 특정 기능인 레이아웃 주석 출력(Layout-annotation output)은 현재 실험적인 기능으로 분류되어 있습니다.
이는 해당 기능이 향후 변경될 수 있고, 신뢰성이 떨어질 수 있으며, 파싱하기 어려울 수 있다는 점을 시사합니다.
제품이나 서비스에 이러한 실험적인 기능을 통합하려는 시도는 예측 불가능한 문제와 추가 개발 비용이라는 리스크를 수반하게 됩니다.
부족한 외부 검토와 명확한 사용 제한
모델 출시 초기임에도 불구하고, LFM2.5-VL-3B는 제3자 커버리지가 매우 얇습니다.
즉, 아직 깊이 있는 독립적인 테스트나 리뷰가 거의 없다는 뜻입니다.
이는 개발사의 자체 보고서 외에는 모델의 장단점을 객관적으로 평가할 수 있는 자료가 부족함을 의미하며, 사용자들이 모델 도입을 결정하는 데 있어 정보의 불균형을 겪을 수밖에 없습니다.
개발사 스스로도 모델의 사용에 있어 명확한 제외 권고 사항을 제시하고 있는데, 장문 맥락의 추론 중심 작업, 시각적 웹 디자인, 그리고 고도로 기술적인 청사진 관련 질의 등에서는 모델 사용을 권장하지 않습니다.
이는 모델의 한계를 명확히 인지하고 있음을 보여주지만, 동시에 실제 적용 가능한 영역에 대한 뚜렷한 제한이 있음을 시사합니다.
개발사도 인정한 '실험실과 현실 간의 간극'
Liquid AI는 "새로운 모델의 경우 실험실 평가 점수와 실제 성능 사이에 간극이 발생하는 것이 일반적이다"라고 스스로 언급하며 면책 조항을 명시했습니다.
이는 모델의 잠재력을 인정하면서도, 출시 초기에 예상치 못한 문제나 성능 편차가 발생할 수 있음을 개발사조차도 인지하고 있다는 점을 방증합니다.
따라서 현재 LFM2.5-VL-3B는 '잠재력은 크지만, 아직 실제 세계에서 증명되지 않은' 모델로 평가될 수밖에 없으며, 실제 도입을 고려하는 사용자들은 이러한 초기 한계점과 리스크를 충분히 인지하고 신중하게 접근해야 할 것입니다.
7. [주의] 국내 쇼핑몰 'lfm.kr'과는 무관한 AI 모델입니다
최근 국내 AI 커뮤니티와 사용자들 사이에서 혼동을 야기할 수 있는 정보가 있어 명확히 안내해 드립니다.
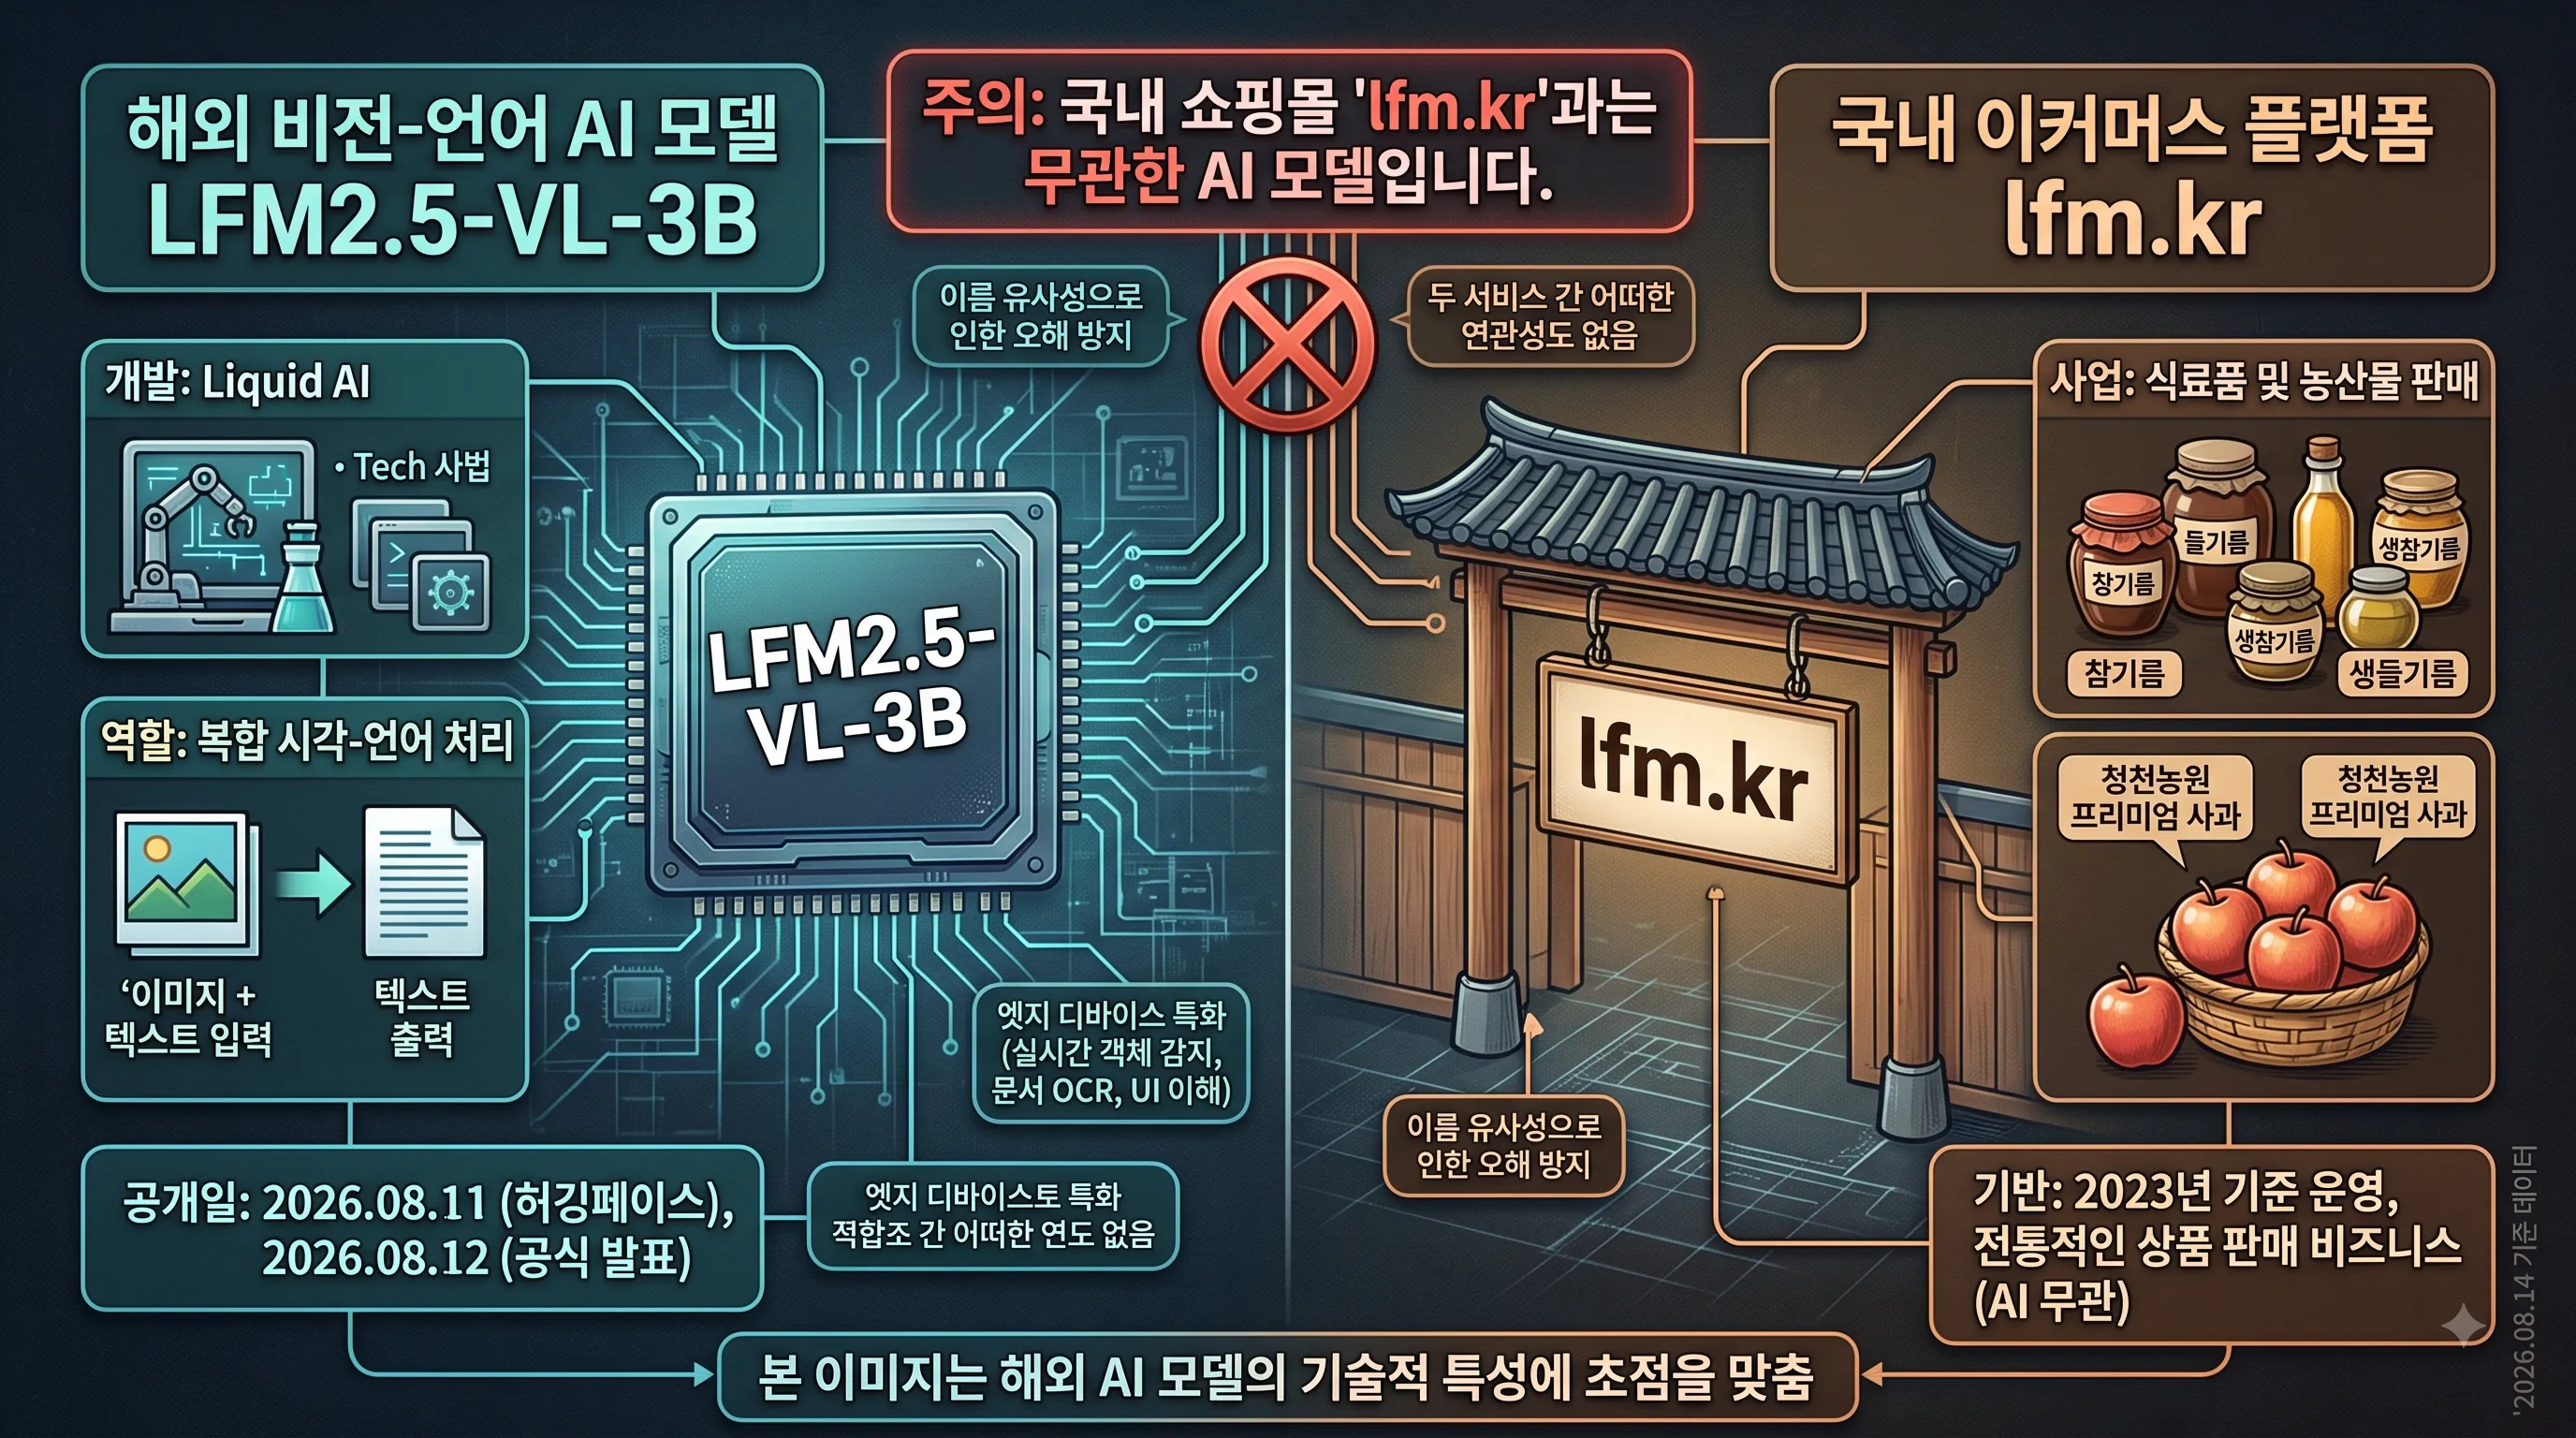
해외에서 새롭게 등장한 비전-언어 AI 모델 'LFM2.5-VL-3B'는 국내 사용자들에게 익숙한 온라인 쇼핑몰 'lfm.kr'과는 이름만 유사할 뿐, 그 어떤 관련성도 없는 별개의 존재입니다.
이 두 플랫폼은 사업 영역, 개발 주체, 서비스 내용 등 모든 면에서 완전히 다릅니다.
해외 비전-언어 AI 모델, LFM2.5-VL-3B
먼저, 기사에서 다루는 'LFM2.5-VL-3B'는 Liquid AI가 개발한 최신 해외 비전-언어 AI 모델입니다.
이 모델은 이미지와 텍스트를 모두 입력받아 텍스트를 출력하는 방식으로 작동하며, 지난 2026년 8월 11일 허깅페이스에 가중치가 공개되었고, 8월 12일 Liquid AI의 공식 발표가 있었습니다.
약 3.1억 개의 매개변수를 가진 이 AI는 주로 '엣지 디바이스'에서의 실시간 객체 감지, 문서 OCR, UI 이해 등 복합적인 시각-언어 처리 작업에 특화되어 설계되었습니다.
국내 이커머스 플랫폼, lfm.kr
반면, 국내 사용자들에게 널리 알려진 'lfm.kr'은 대한민국에 기반을 둔 이커머스 플랫폼입니다.
이 플랫폼은 주로 식료품 및 농산물을 판매하며, 대표적인 상품으로는 참기름, 들기름, 생참기름, 생들기름, 그리고 청천농원 프리미엄 사과 등이 있습니다.
해당 쇼핑몰은 2023년 정보를 기준으로 운영되고 있으며, AI 기술 개발과는 무관한 전통적인 상품 판매 비즈니스를 영위하고 있습니다.
이름 유사성으로 인한 오해 방지
따라서, Liquid AI가 개발한 해외 AI 모델 LFM2.5-VL-3B와 국내 이커머스 플랫폼 lfm.kr은 단순히 이름이 유사할 뿐이며, 두 서비스 간에는 개발, 소유, 운영, 목적 등 어떠한 사업적 또는 기술적 연관성도 존재하지 않습니다.
독자 여러분께서는 이 점을 명확히 인지하시어 혼동이 없으시기를 당부드립니다.
본 기사는 순수하게 해외 AI 모델 'LFM2.5-VL-3B'의 기술적 특성과 시장 영향력에 초점을 맞춰 분석하고 있습니다.
관련 글