장황한 프롬프트는 그만! 에이전트의 성공률을 결정하는 액션 모듈화 가이드
- 기존 CoT의 56% 환각 실패 한계를 극복하기 위해 언어 추론과 환경 상호작용을 결합한 ReAct 패러다임을 적용하고, ALFWorld 성공률 34% 향상 등 정량적 성능을 검증합니다.
- 통합 액션 공간(^A = A ∪ L)을 기반으로 search·lookup·finish 단위의 원자적 API 모듈화를 설계하여 컨텍스트 부하를 줄이고 추론 투명성을 확보합니다.
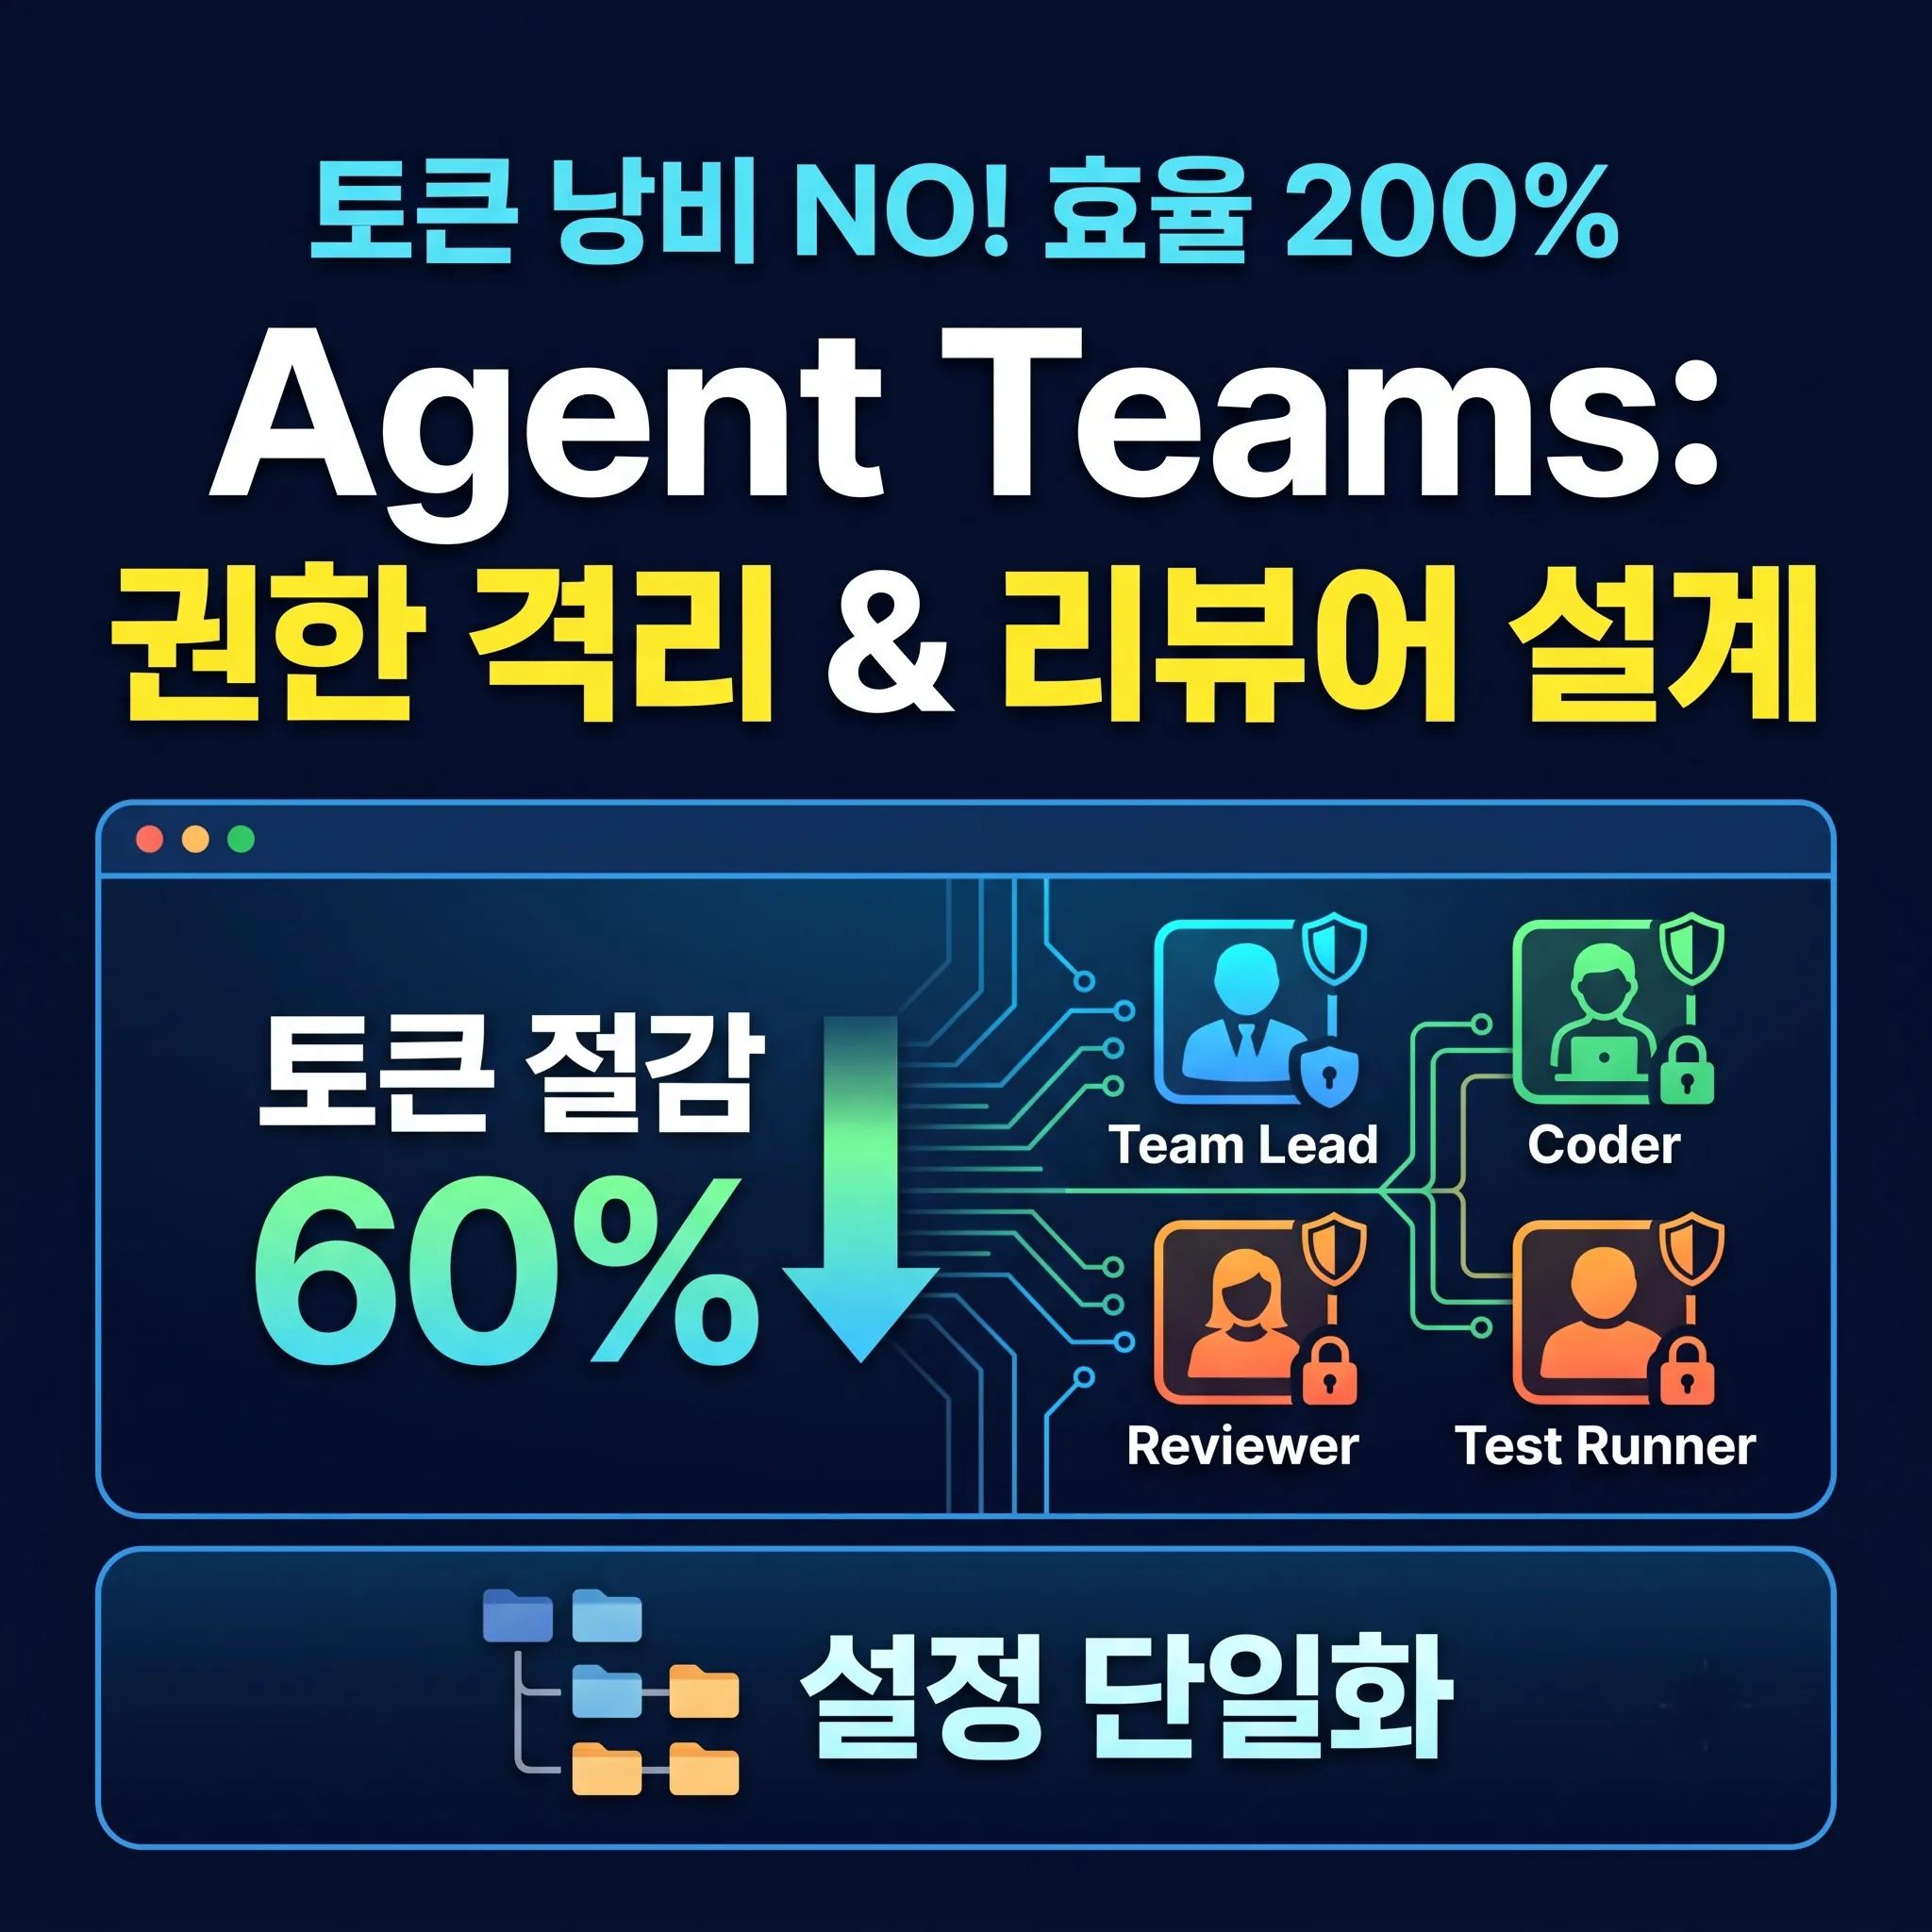
- 블랙박스 제어와 달리 단 2회의 Thought 수정만으로 실패 궤적을 역전시키는 Human-in-the-Loop 런타임 진단 및 개입 체계를 구축합니다.
- strict: true 및 additionalProperties: false 기반의 표준 스키마 제약과 call_id 매핑 5단계 라이프사이클을 통해 함수 호출 안정성을 극대화합니다.
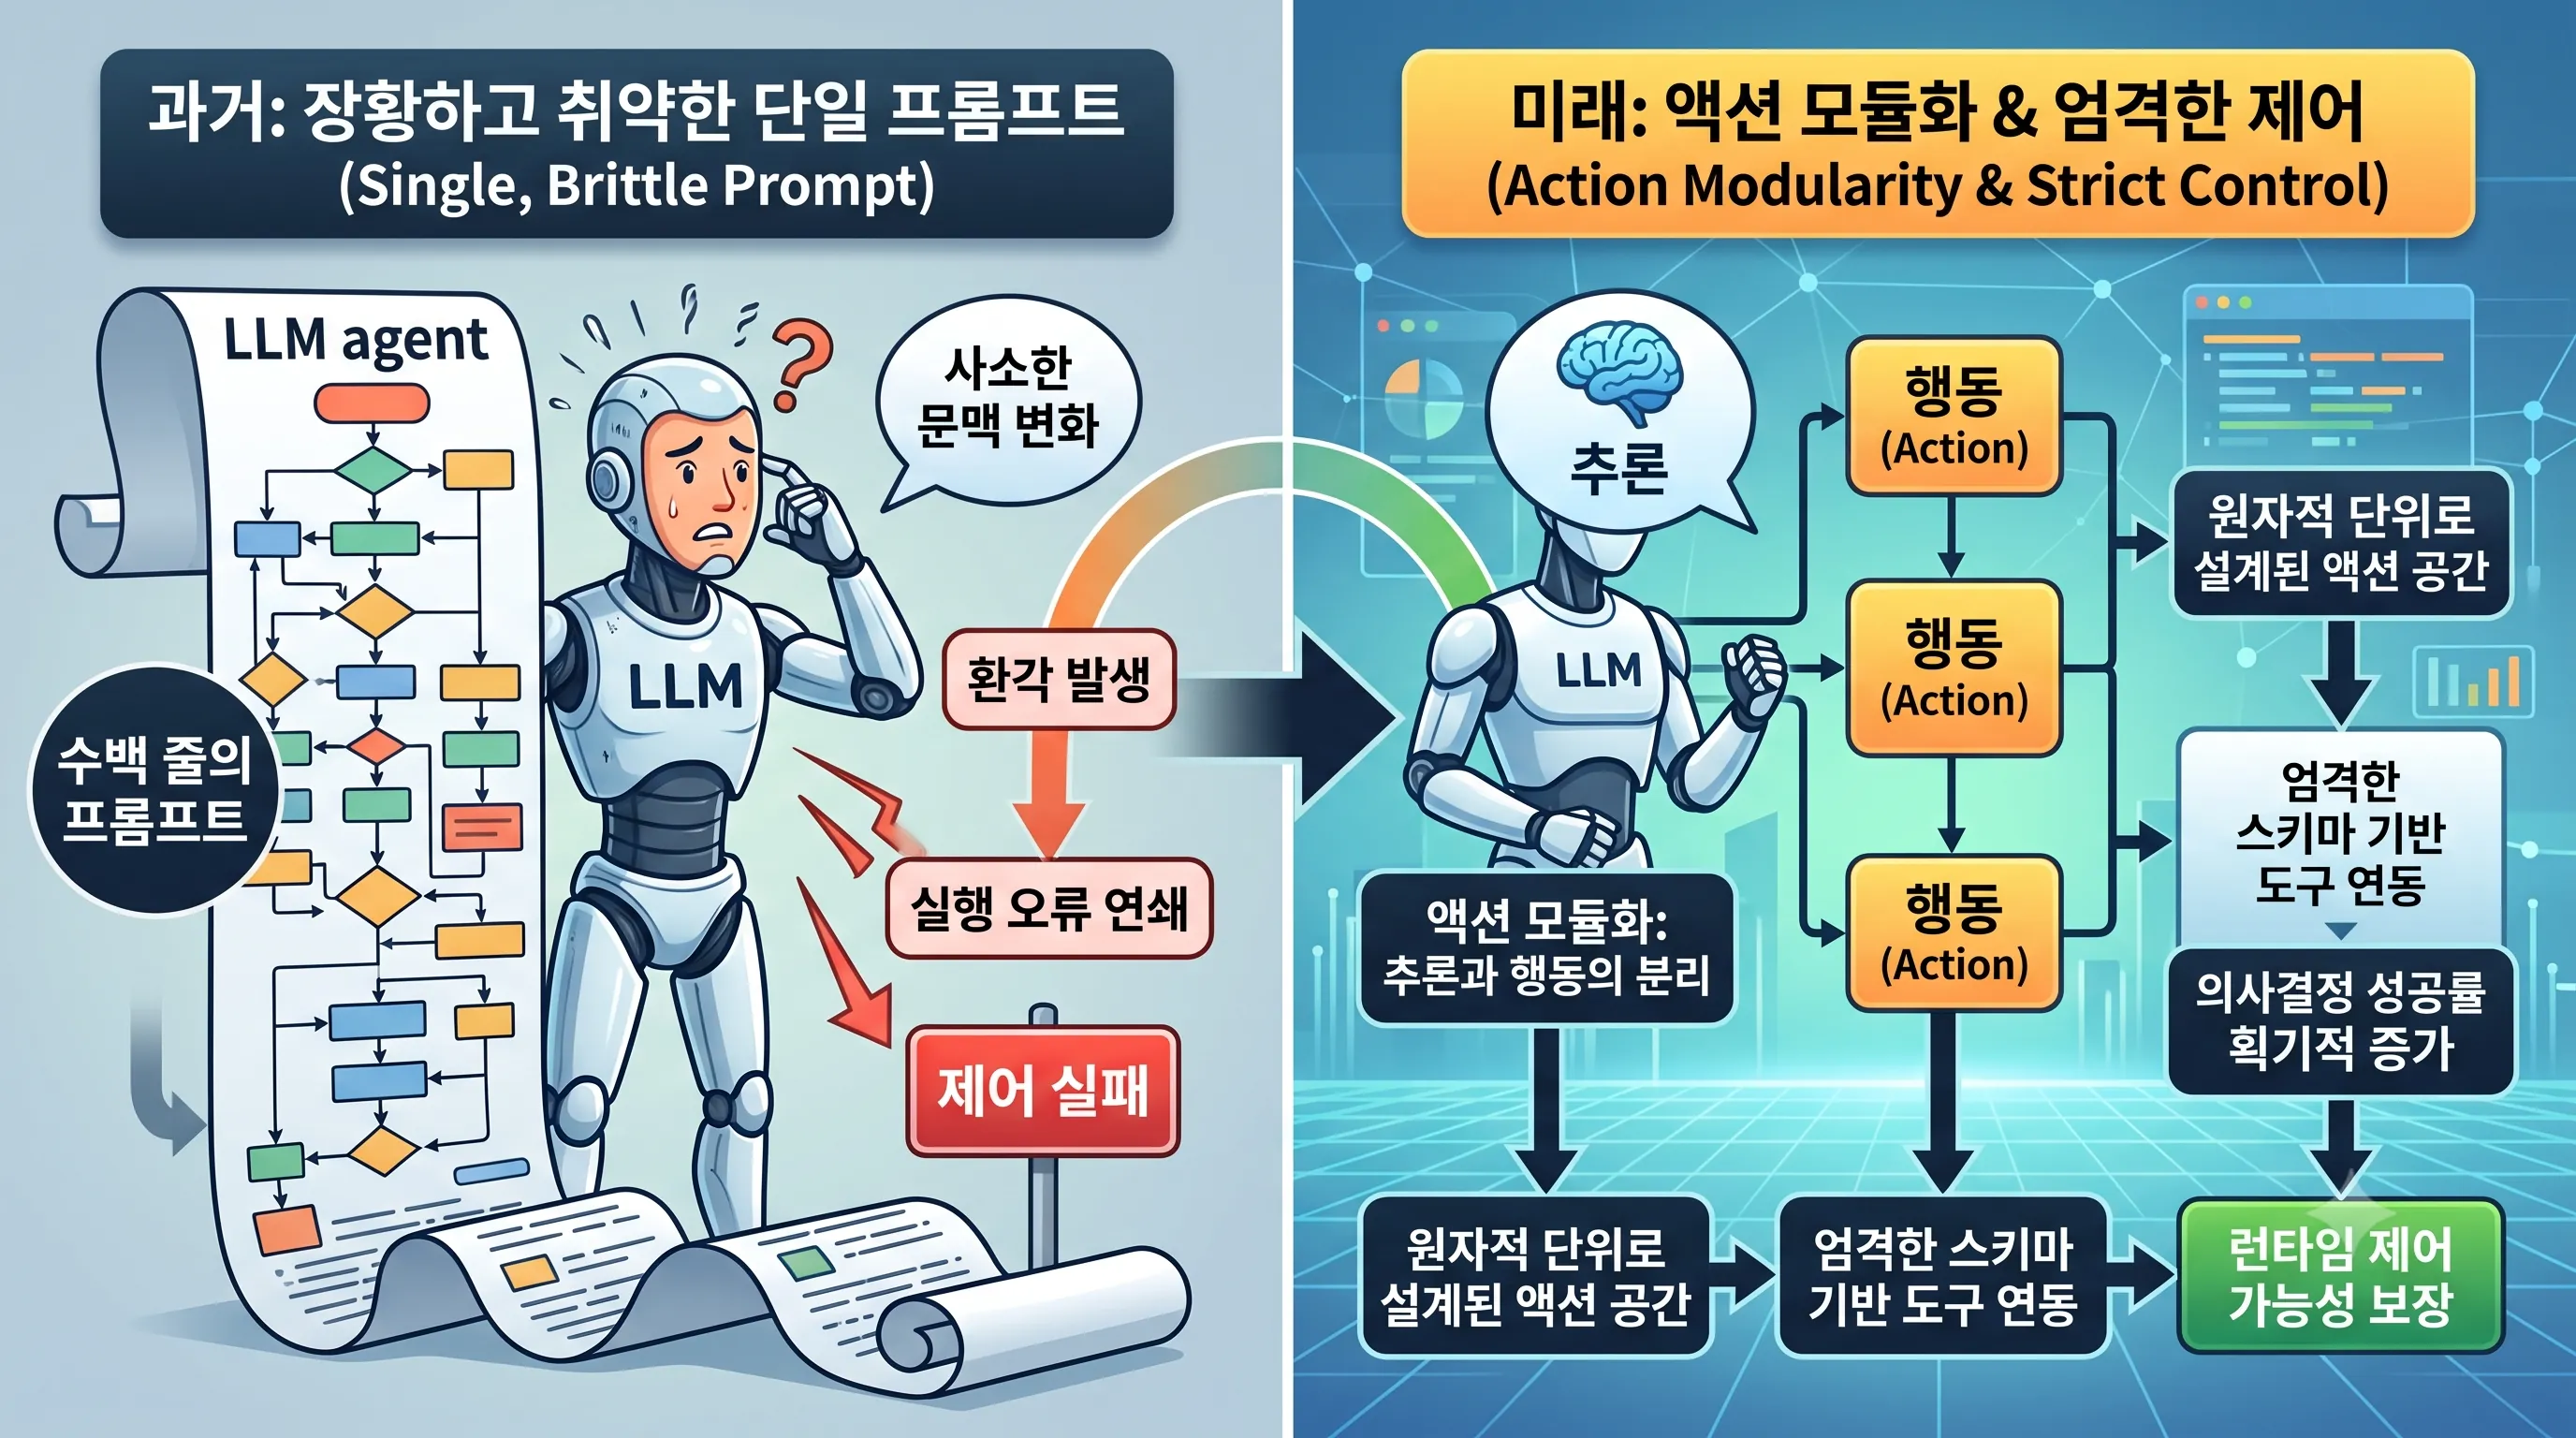
수백 줄에 달하는 장황한 프롬프트에 모든 업무 규칙과 예외 상황을 욱여넣는 방식은 복잡한 작업을 수행하는 LLM 에이전트 환경에서 명확한 한계에 부딪히고 있습니다.
외부 환경과 단절된 채 단일 지시문에만 의존하는 에이전트는 사소한 문맥 변화에도 환각을 일으키거나 실행 오류를 연쇄적으로 전파하기 쉽습니다.
이제 고성능 에이전트 구축의 핵심은 지시문의 길이가 아니라, 추론(Thought)과 행동(Action)을 명확히 분리하고 연결하는 액션 모듈화에 있습니다.
원자적 단위로 정교하게 설계된 액션 공간과 엄격한 스키마 기반 도구 연동은 에이전트의 의사결정 성공률을 획기적으로 높이고 런타임 제어 가능성을 보장합니다.
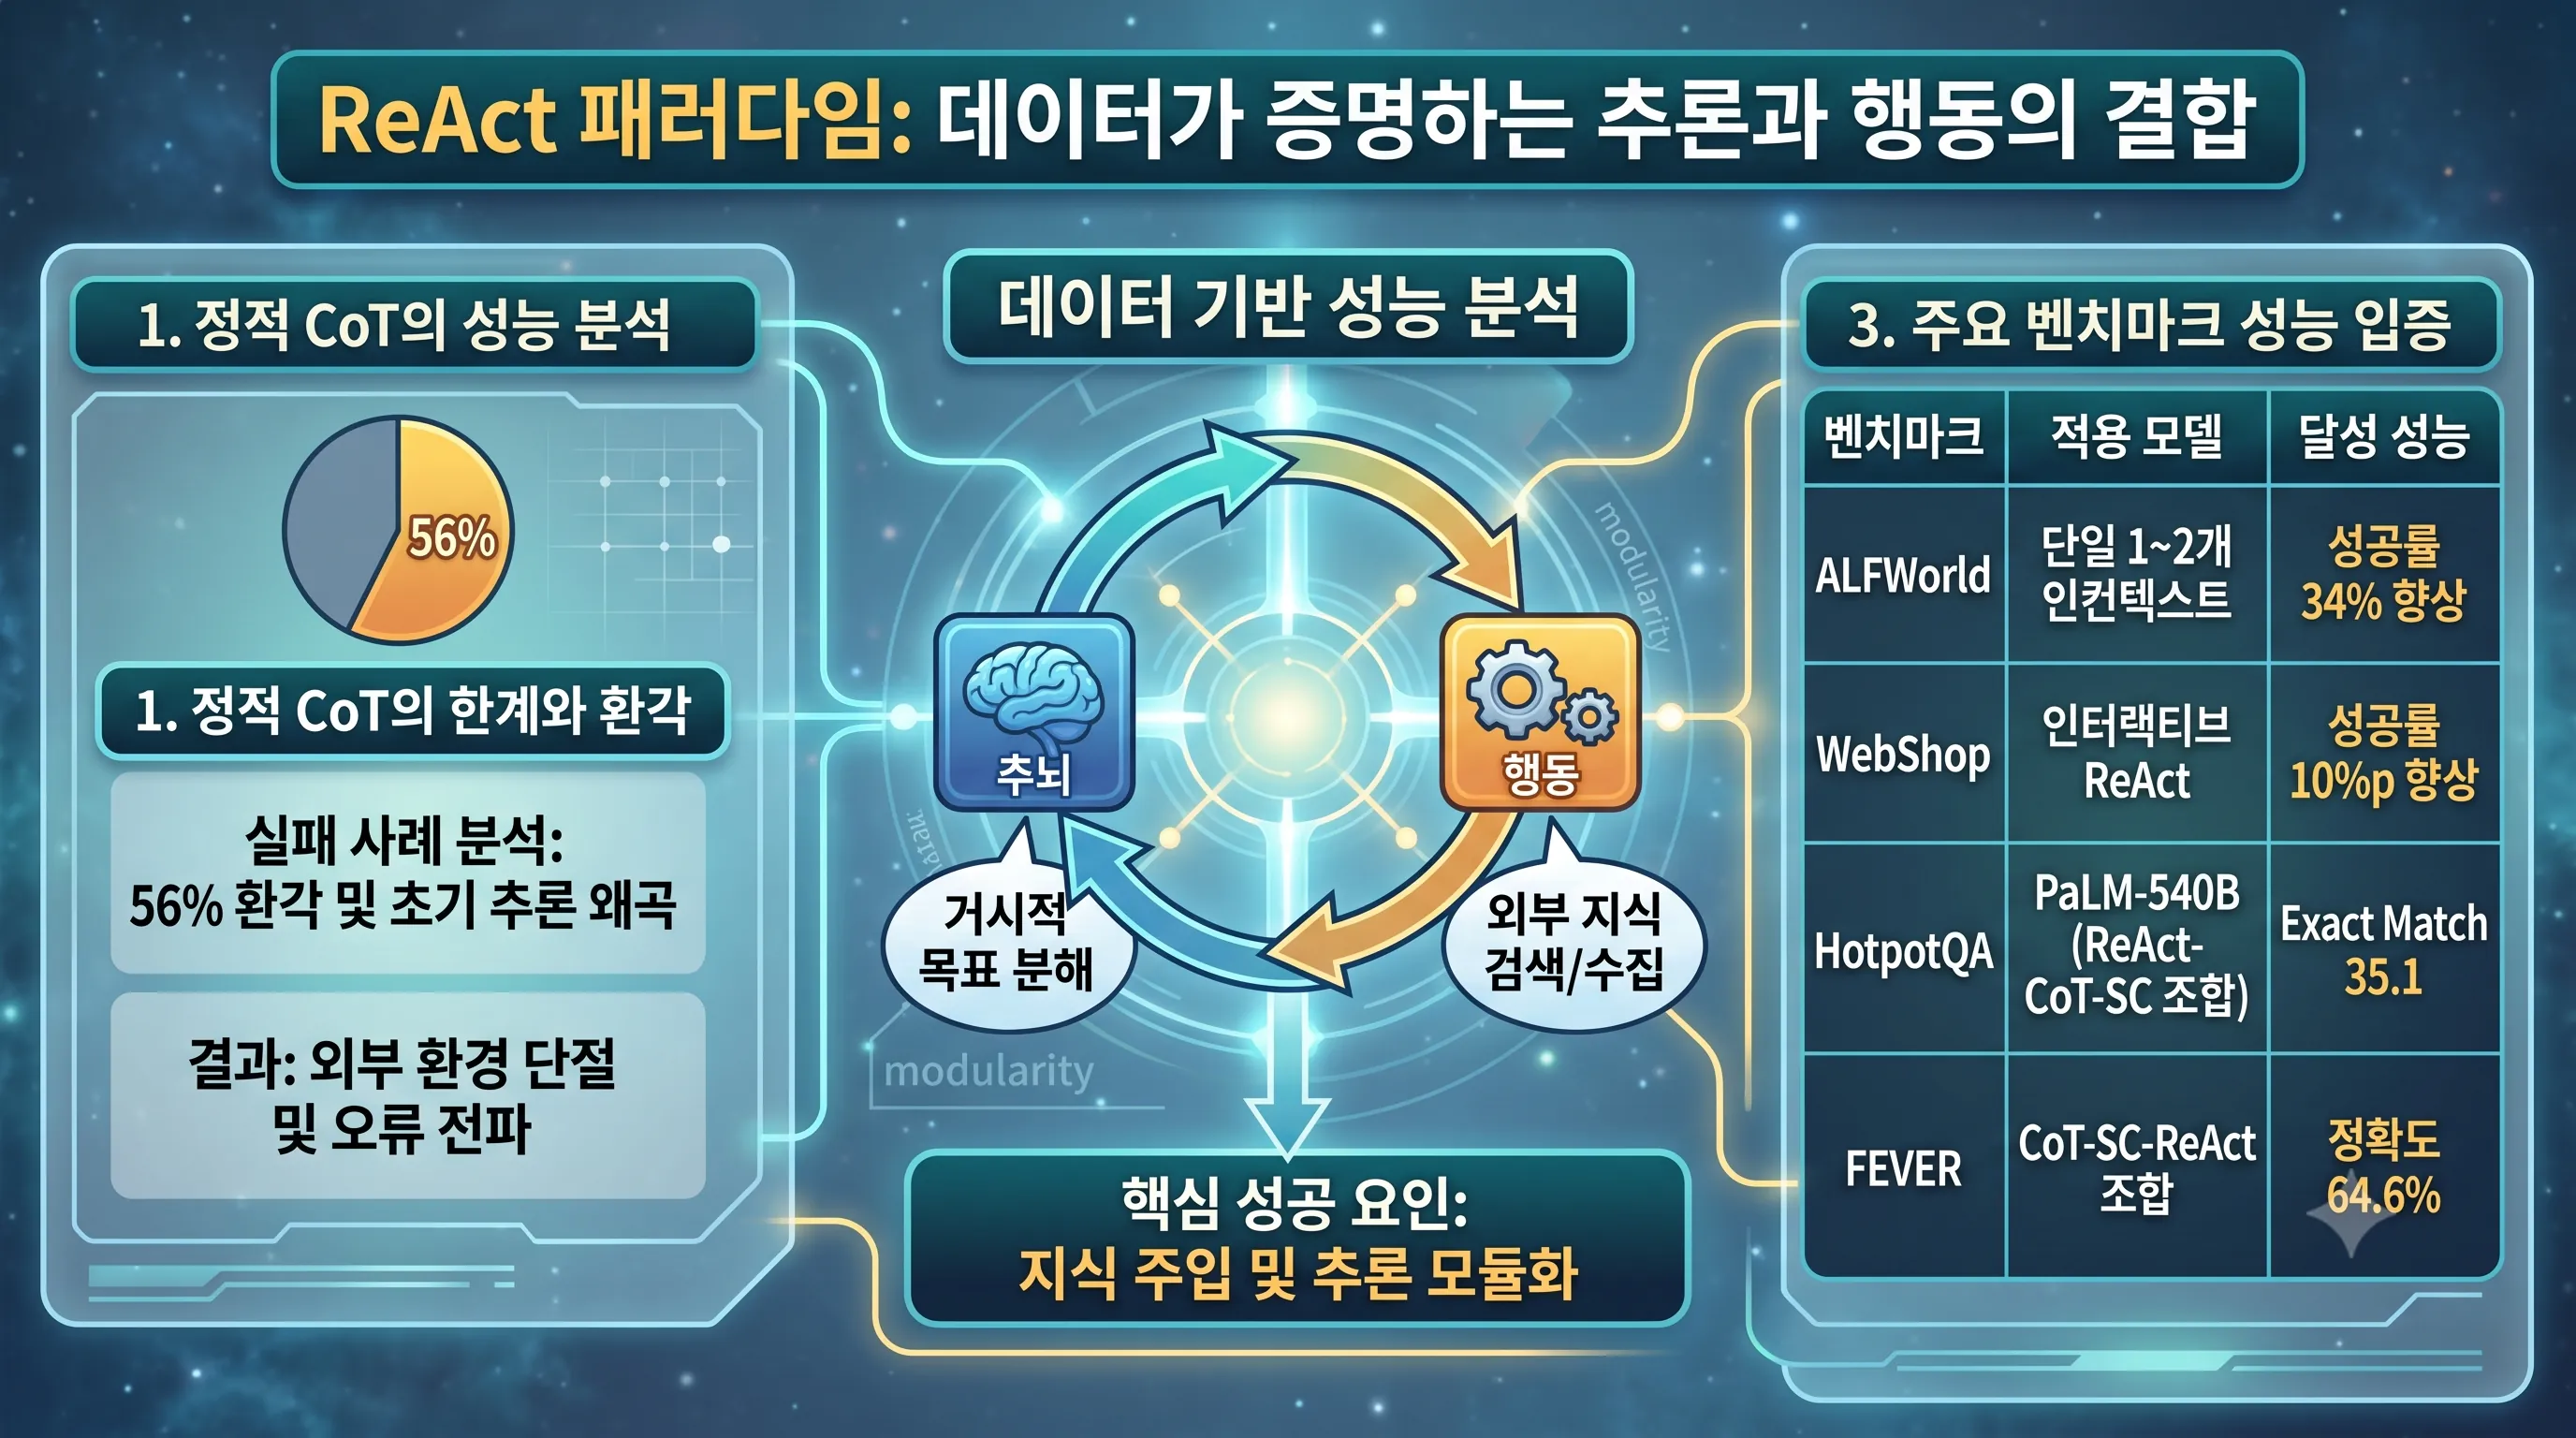
1. ReAct 패러다임: 장황한 프롬프트를 넘어서는 추론(Thought)과 행동(Action)의 상호작용
정적 CoT의 한계와 환각 발생 구조
단일의 장황한 프롬프트나 단순 연쇄 생각(Chain-of-Thought, CoT) 프롬프팅 방식은 대규모 언어 모델(LLM)이 복잡한 작업을 수행할 때 심각한 취약점을 드러냈습니다.
기존 CoT 방식은 외부 환경과 완전히 격리된 정적 블랙박스 형태로 작동하기 때문에, 모델 자체의 내부 파라미터 지식에만 의존하여 문제를 해결하려는 경향을 보입니다.
관련 연구 논문(2210.03629v3.pdf)의 오류 분석에 따르면, CoT 단독 구조에서 발생한 전체 실패 사례 중 56%의 실패가 모델 자체의 환각(Hallucination) 및 초기 추론의 왜곡이 다음 단계로 누적되는 오류 전파에서 비롯된 것으로 밝혀졌습니다.
이러한 단절적 구조에서는 잘못된 가정이 생성되는 순간 이를 검증하거나 수정할 피드백 루프가 존재하지 않아 장황한 텍스트만 나열되다 결국 실패로 이어집니다.
ReAct 아키텍처의 Thought-Action 상호작용 메커니즘
이러한 한계를 극복하기 위해 제안된 패러다임이 바로 언어 추론 흔적(Thought)과 환경 상호작용 행동(Action)을 교차 생성하는 ReAct 패러다임입니다.
ReAct 구조에서 추론(Thought) 단계는 거시적 목표를 하위 과제로 분해하고, 현재 진행 상황을 추적하며, 예외 상황에 직면했을 때 액션 계획을 유연하게 수정하는 두뇌 역할을 수행합니다.
동시에 행동(Action) 단계는 Wikipedia API나 웹 인터페이스와 같은 외부 환경과 직접 연동하여 최신 정보를 검색·수집하고, 이를 다시 추론 과정의 컨텍스트로 주입하는 실행기 역할을 담당합니다.
다만 ReAct 단독 방식 역시 외부 검색 결과가 누락되었을 때(전체 에러의 23% 비중) 이를 원활히 복구하지 못하거나 동일한 쿼리를 반복하는 루프에 빠지는 추론 오류(전체 에러의 47% 비중)가 발생할 수 있습니다.
따라서 고도화된 에이전트 설계에서는 단순 ReAct 단독 구동에 그치지 않고, 자기 일관성(Self-Consistency) 기법을 결합한 CoT-SC와의 상호 보완적 조합을 통해 환각 억제와 탐색 복원력을 동시에 확보하는 아키텍처가 핵심 표준으로 자리 잡았습니다.
주요 벤치마크(ALFWorld·WebShop·HotpotQA) 성능 검증
ReAct 패러다임의 유효성은 텍스트 게임, 전자상거래 의사결정, 다단계 사실 검증 등 다양한 도메인 벤치마크(2210.03629v3.pdf)를 통해 정량적으로 입증되었습니다.
대화형 의사결정 환경인 ALFWorld 벤치마크에서는 복잡한 모방 학습이나 강화학습(RL) 모델을 별도로 훈련하지 않고도, 단 1~2개의 모듈화된 인컨텍스트 예제 프롬프팅만으로 기존 대비 절대 성공률 34% 향상이라는 뛰어난 성과를 기록했습니다.
웹 쇼핑 탐색 환경인 WebShop 벤치마크에서도 기존 최고 성공률 대비 10%p 절대 성능 향상을 달성하여 동적 상호작용 환경에서의 적응력을 증명했습니다.
| 벤치마크 환경 | 적용 기법 및 모델 기준 | 달성 성능 지표 | 핵심 성능 개선 요인 |
|---|---|---|---|
| ALFWorld | 모듈화된 1~2개 인컨텍스트 예제 | 절대 성공률 34% 향상 | 모방/강화학습 대비 간결한 액션 모듈화 및 상황 추적 |
| WebShop | 인터랙티브 ReAct 의사결정 | 기존 최고 대비 10%p 향상 | 외부 환경 피드백을 실시간 반영한 행동 계획 수정 |
| HotpotQA | PaLM-540B (ReAct-CoT-SC 조합) | Exact Match(EM) 35.1 | 지식 검색(Action)과 다단계 추론(Thought)의 상호 교차 |
| FEVER | CoT-SC-ReAct 상호 보완 조합 | 정확도 64.6% 달성 | 환각(56%) 억제 및 외부 API 연동을 통한 사실 검증 |
복합적인 사실 검증과 다단계 질의응답에서도 뚜렷한 성능 개선이 확인되었습니다.
HotpotQA 벤치마크에서 PaLM-540B 모델을 기반으로 ReAct와 CoT-SC 기법을 결합했을 때 Exact Match 35.1을 기록하며 단일 프롬프트의 지식 탐색 한계를 극복했습니다.
또한 팩트 검증 데이터셋인 FEVER 벤치마크에서도 CoT-SC와 ReAct를 결합한 파이프라인을 적용해 64.6%의 정확도를 달성함으로써, 외부 지식 주입과 추론 모듈화가 에이전트 성공률을 결정짓는 핵심 기둥임을 명확히 보여주었습니다.
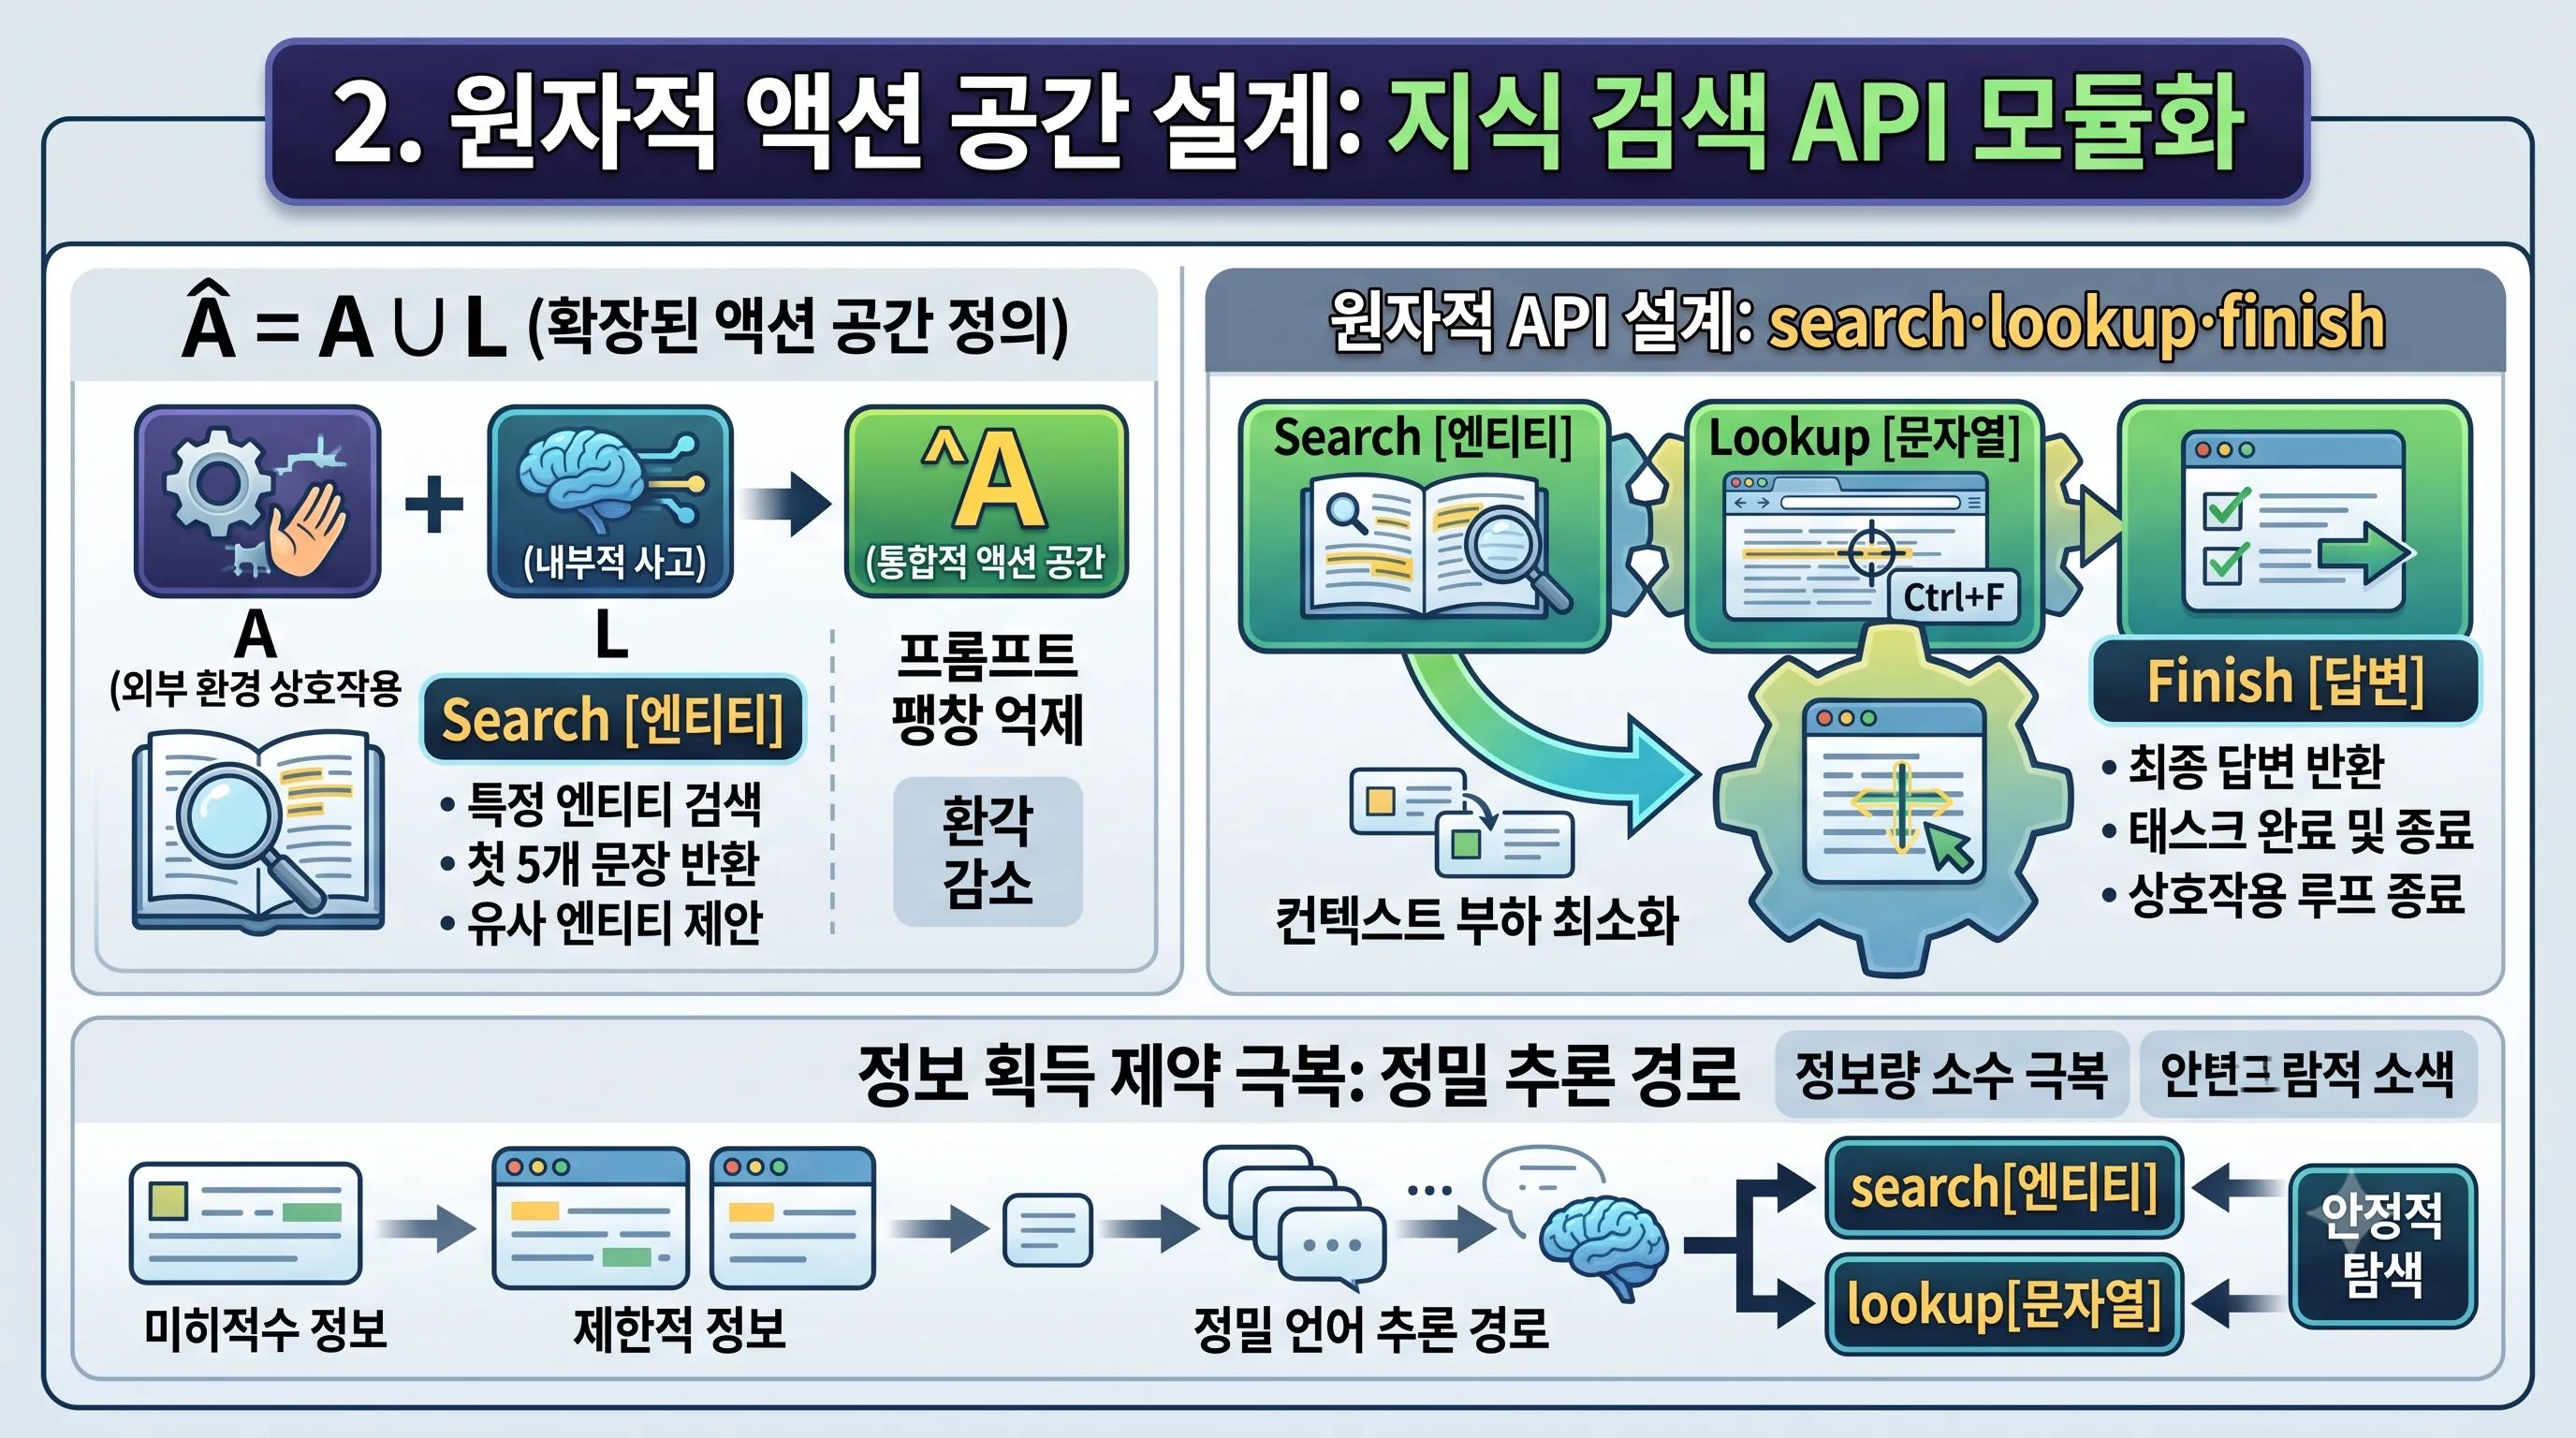
2. 원자적 액션 공간 설계: 지식 검색 API 모듈화 기법
확장된 액션 공간(^A = A ∪ L) 정의
지식 집약적 작업을 자율적으로 수행하는 언어 모델 에이전트 구축 시, 프롬프트의 무분별한 팽창을 막고 성공률을 끌어올리기 위해서는 명확한 액션 공간 정의가 선행되어야 합니다.
논문 2210.03629v3.pdf에 따르면 에이전트의 액션 공간은 단순한 도구 호출에 머무르지 않고, 외부 환경과 상호작용하는 액션 공간 A와 내부적 사고를 전개하는 언어 추론 공간 L의 합집합인 ^A = A ∪ L로 확장됩니다.
이러한 통합적 액션 공간 구조는 모델이 외부 환경의 피드백을 수용하면서 동시에 스스로 다음 행동을 논리적으로 계획할 수 있는 기반을 제공합니다.
인터페이스를 세분화된 원자적 단위의 액션으로 모듈화하면 모델이 한 번에 방대한 텍스트를 처리하려다 발생하는 환각을 줄일 수 있습니다.
원자적 액션 모듈화는 에이전트가 단계별로 필요한 정보만을 명시적으로 탐색하도록 유도하여 추론 과정 전체의 투명성과 제어 가능성을 대폭 향상시킵니다.
search·lookup·finish 원자적 단위 API 설계
지식 집약적 환경에서 위키 텍스트를 효율적으로 탐색하기 위해 정의된 3가지 기본 상호작용 액션은 search[entity], lookup[string], finish[answer]로 구성됩니다.
이들 각각의 API는 에이전트가 과도한 컨텍스트 부하 없이 최소한의 필수 정보에만 순차적으로 접근하도록 설계되었습니다.
먼저 search[entity] 액션은 특정 엔티티를 검색하여 대상 위키 페이지의 첫 5개 문장을 반환하거나, 정확히 일치하는 문서가 없을 경우 상위 5개의 유사 엔티티를 제안하는 방식으로 작동합니다.
이를 통해 에이전트는 전체 문서를 불필요하게 로드하지 않고도 핵심 개요를 파악하거나 올바른 검색어로 신속하게 궤도를 수정할 수 있습니다.
이어서 lookup[string] 액션은 웹 브라우저의 Ctrl+F 기능을 모사하여 현재 페이지 내에서 특정 문자열이 포함된 다음 문장을 정밀하게 추출합니다.
에이전트는 전체 본문을 스캔하는 대신 이 액션을 반복 호출함으로써 긴 문서 내에 흩어져 있는 세부 단서를 표적 탐색하듯 수집할 수 있습니다.
최종적으로 탐색된 근거를 바탕으로 답안 도출이 완료되면 finish[answer] 액션을 호출하여 상호작용 루프를 명시적으로 종료하고 결과를 확정합니다.
| 원자적 액션 | 입력 매개변수 | 동작 메커니즘 및 반환 정보 |
|---|---|---|
| search | 엔티티(entity) | 해당 엔티티 위키 페이지의 첫 5개 문장 반환 또는 상위 5개 유사 엔티티 제안 |
| lookup | 문자열(string) | 브라우저의 Ctrl+F 기능을 모사하여 특정 문자열이 포함된 다음 문장 추출 |
| finish | 최종 답변(answer) | 답안을 반환하며 태스크 완료 및 상호작용 루프 종료 |
정보 획득량 제약 극복을 위한 정밀 언어 추론 경로
단순한 API 기반의 원자적 액션 공간은 한 번의 호출로 방대한 문맥을 끌어오는 최신 신경망 검색기에 비해 단위 호출당 획득하는 정보량이 상대적으로 적습니다.
한정된 문장 단위의 데이터만 주어지므로 에이전트가 다음 액션을 올바르게 선택하지 못하면 탐색 경로에서 이탈할 위험이 존재합니다.
따라서 이러한 구조적 제약을 극복하기 위해서는 각 단계마다 수집된 제한적 정보를 해석하고 다음 탐색 키워드를 도출하는 정밀한 언어적 추론 경로가 필수적입니다.
언어 추론 공간(L)을 통해 중간 판단을 체계화하고 검색(search)과 세부 탐색(lookup)을 교차 실행할 때, 에이전트는 최소한의 토큰 소비만으로도 복잡한 지식 기반 질의를 안정적으로 완수할 수 있습니다.
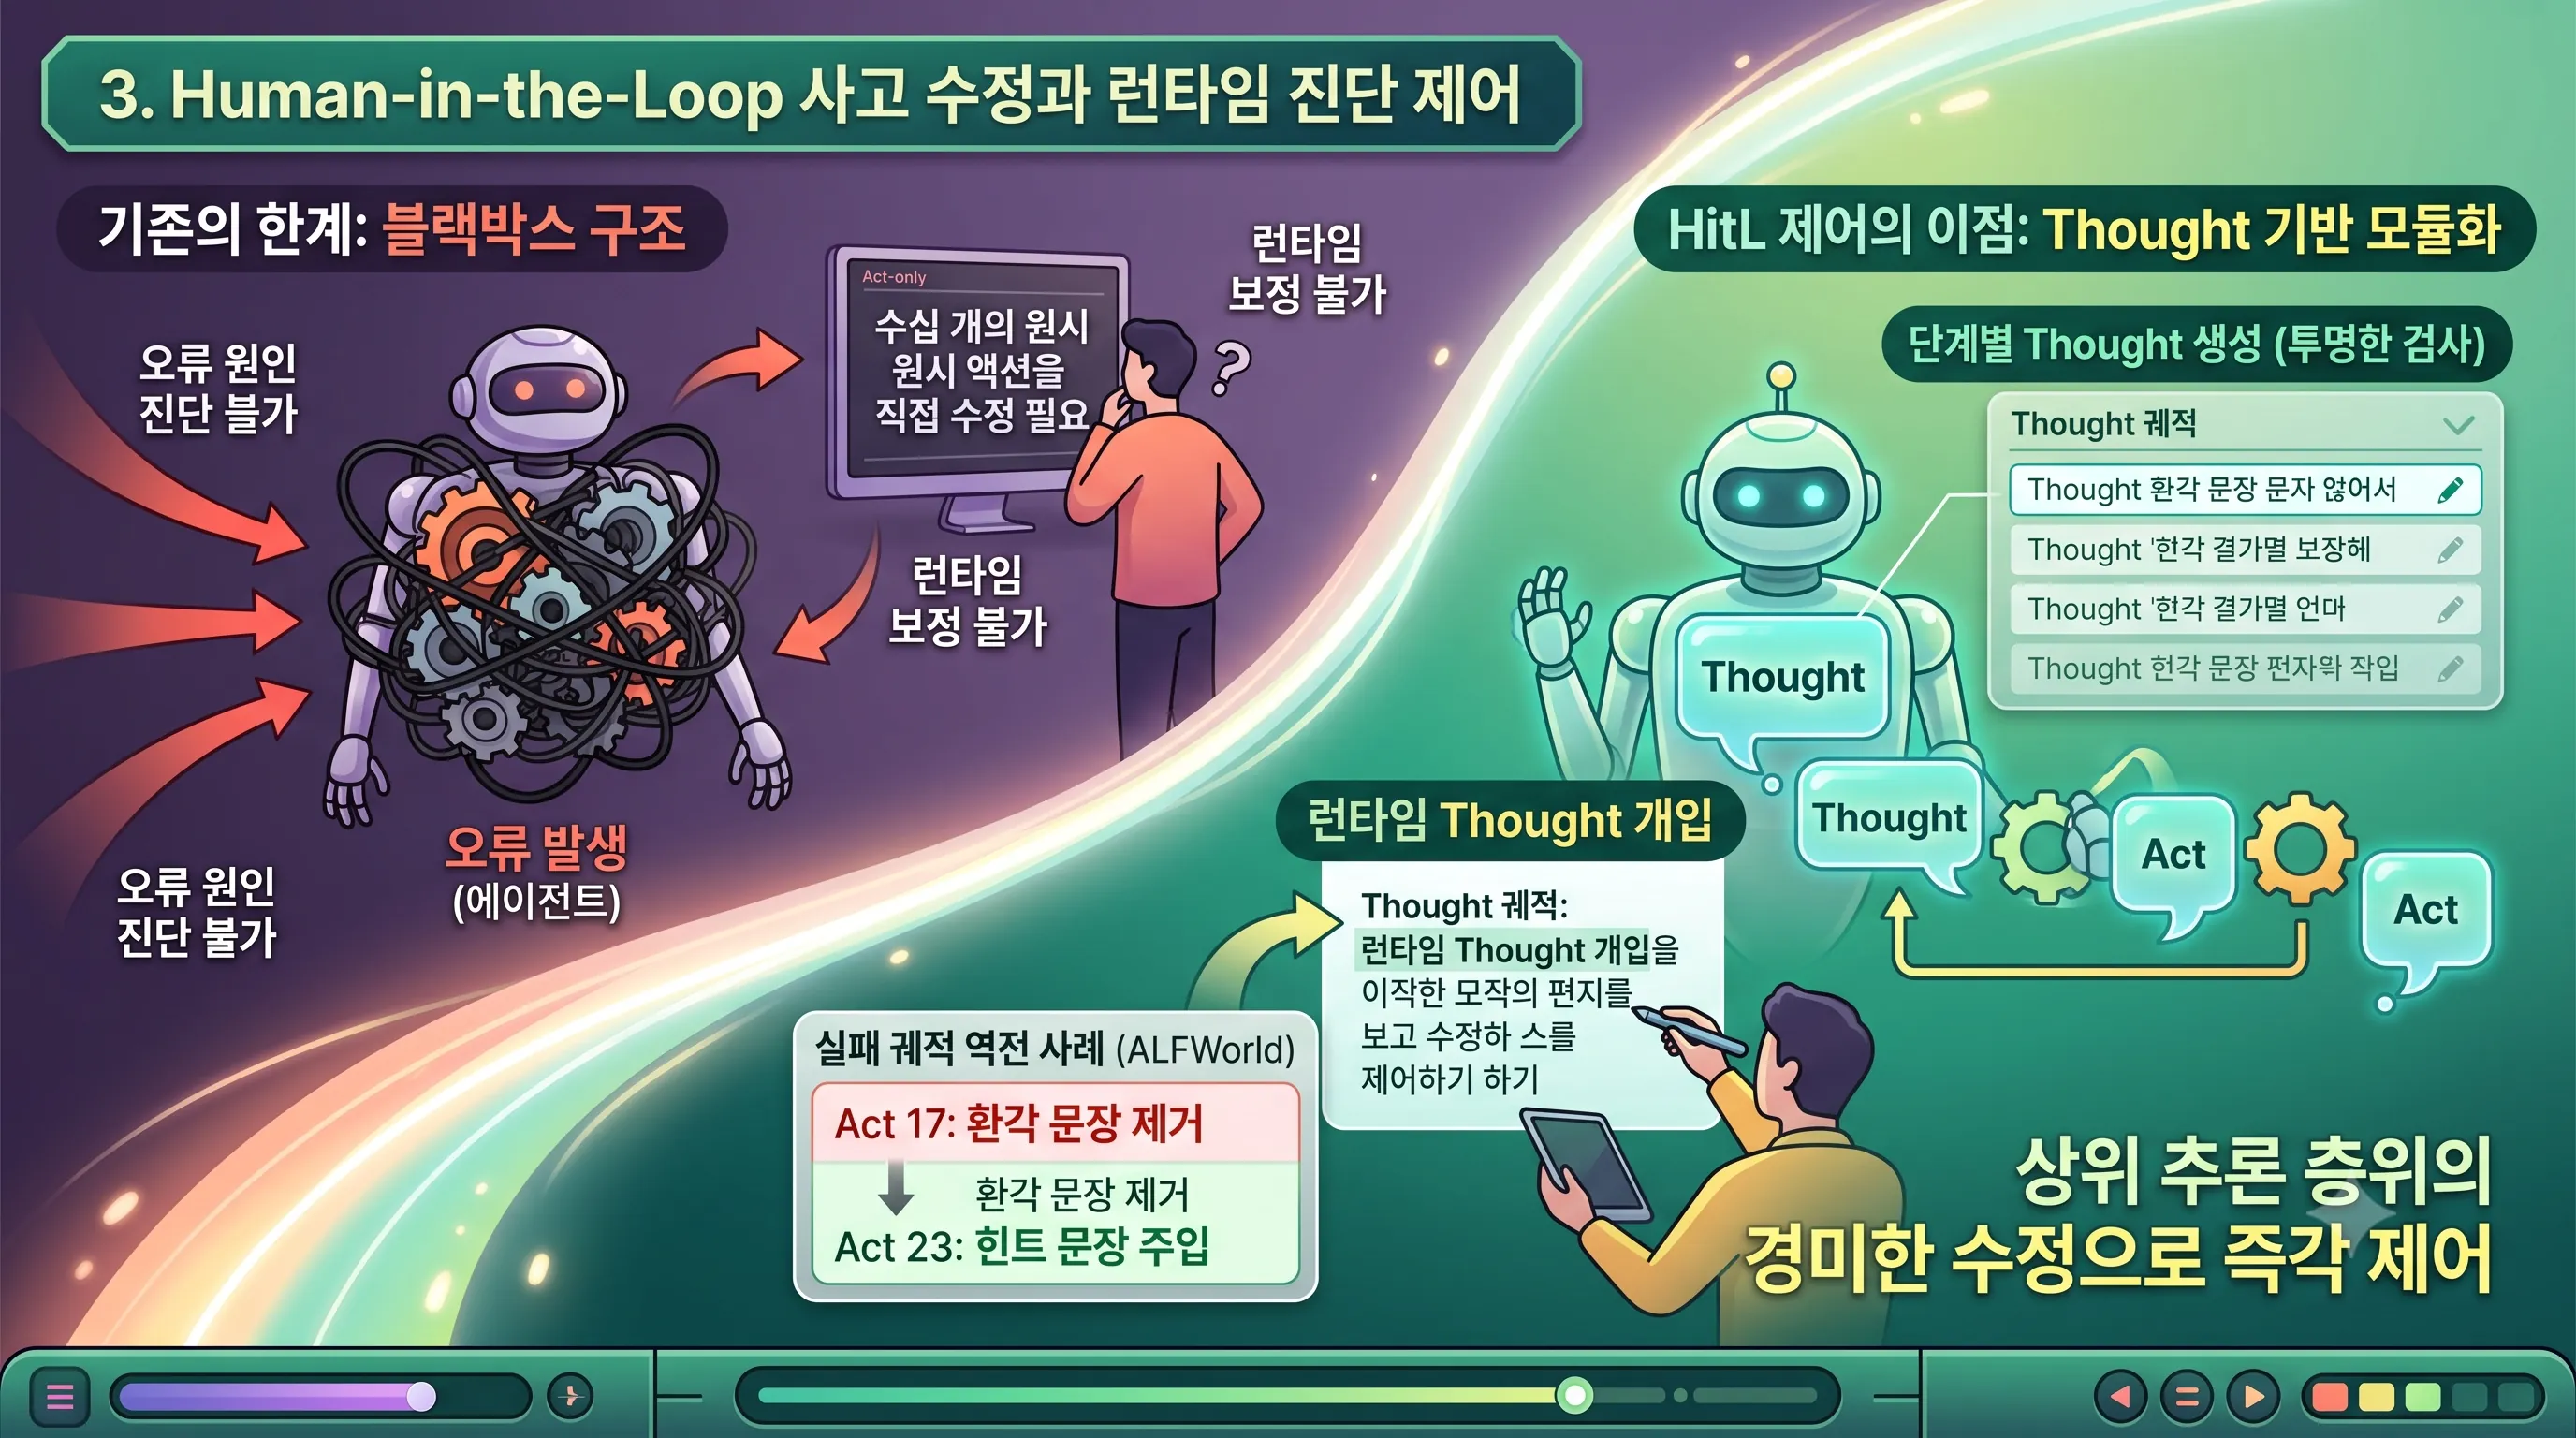
3. Human-in-the-Loop 사고 수정과 런타임 진단 제어
추론 궤적(Thought) 진단과 투명성 확보
자율 에이전트 시스템에서 발생 가능한 예기치 않은 오류를 방지하기 위해서는 모델이 어떠한 판단 근거로 특정 행동을 선택했는지 명확히 파악할 수 있어야 합니다.
액션 모듈화와 단계별 Thought 생성 메커니즘을 적용하면 에이전트가 실행하는 매 단계의 의사결정 과정이 텍스트 형태의 추론 흔적으로 고스란히 기록됩니다.
이에 따라 시스템 운영자는 에이전트가 오작동하거나 작업 루프에 빠졌을 때 내부적인 판단 근거를 투명하게 검사하고 문제 발생 원인을 신속하게 진단할 수 있습니다.
런타임 Thought 개입을 통한 실패 궤적 역전 사례
에이전트 제어의 핵심은 하위의 원시 액션을 일일이 교정하는 비효율을 없애고, 상위 추론 단계에 직접 개입하는 데 있습니다.
연구 문서(2210.03629v3.pdf)에 수록된 ALFWorld 환경 실험에 따르면, 에이전트의 실패 궤적을 성공 궤적으로 전환하는 데 많은 수정이 필요하지 않았습니다.
복잡하게 꼬인 수십 개의 원시 액션을 직접 수정하는 대신, 단 2개의 Thought 수정만으로 전체 작업 흐름을 정상화할 수 있었습니다.
실제 제어 과정에서는 Act 17 시점에 생성되었던 모델의 환각 문장을 제거하여 왜곡된 추론 경로를 바로잡았습니다.
이어서 Act 23 시점에 적절한 방향성을 제시하는 힌트 문장을 Thought에 추가 주입함으로써 에이전트의 올바른 후속 행동을 유도했습니다.
이처럼 단 두 차례의 상위 추론 흔적(Thought) 보정만으로도 에이전트가 자율적으로 목표를 완수하도록 궤적을 완벽히 역전시키는 성과를 입증했습니다.
블랙박스 RL 대비 Human-in-the-Loop 제어의 이점
기존의 강화학습(RL) 방식이나 행동만을 출력하는 Act-only 블랙박스 구조는 모델이 잘못된 판단을 내릴 때 외부에서 개입하여 경로를 수정하기가 극히 어렵습니다.
반면 단계적 사고 흔적이 가시화되는 모듈화 구조에서는 Human-in-the-Loop 방식으로 운영자가 런타임 중에 모델의 내부 신념과 추론 스타일을 즉각 보정할 수 있습니다.
상위 추론 층위에서의 직관적인 텍스트 수정이 하위의 연속적인 행동 변화를 이끌어내므로, 시스템의 제어 가능성(Diagnosability)과 신뢰성을 동시에 극대화합니다.
| 구분 | 기존 블랙박스 및 Act-only 구조 | Thought 기반 모듈화 및 HitL 제어 구조 |
|---|---|---|
| 의사결정 투명성 | 내부 추론 과정이 은닉되어 오류 원인 진단 불가 | 단계별 Thought 생성을 통한 의사결정 근거의 투명한 검사 |
| 오류 수정 방식 | 수십 개의 원시 액션을 직접 수정하거나 재학습 필요 | 상위 추론 흔적(Thought)의 경미한 수정만으로 즉각 제어 |
| 런타임 개입성 | 실행 중 모델 신념 및 추론 스타일 보정 불가 | 런타임 환경에서 환각 제거 및 힌트 주입을 통한 궤적 보정 지원 |
4. OpenAI 함수 호출(Function Calling) 표준 스키마 및 실행 라이프사이클
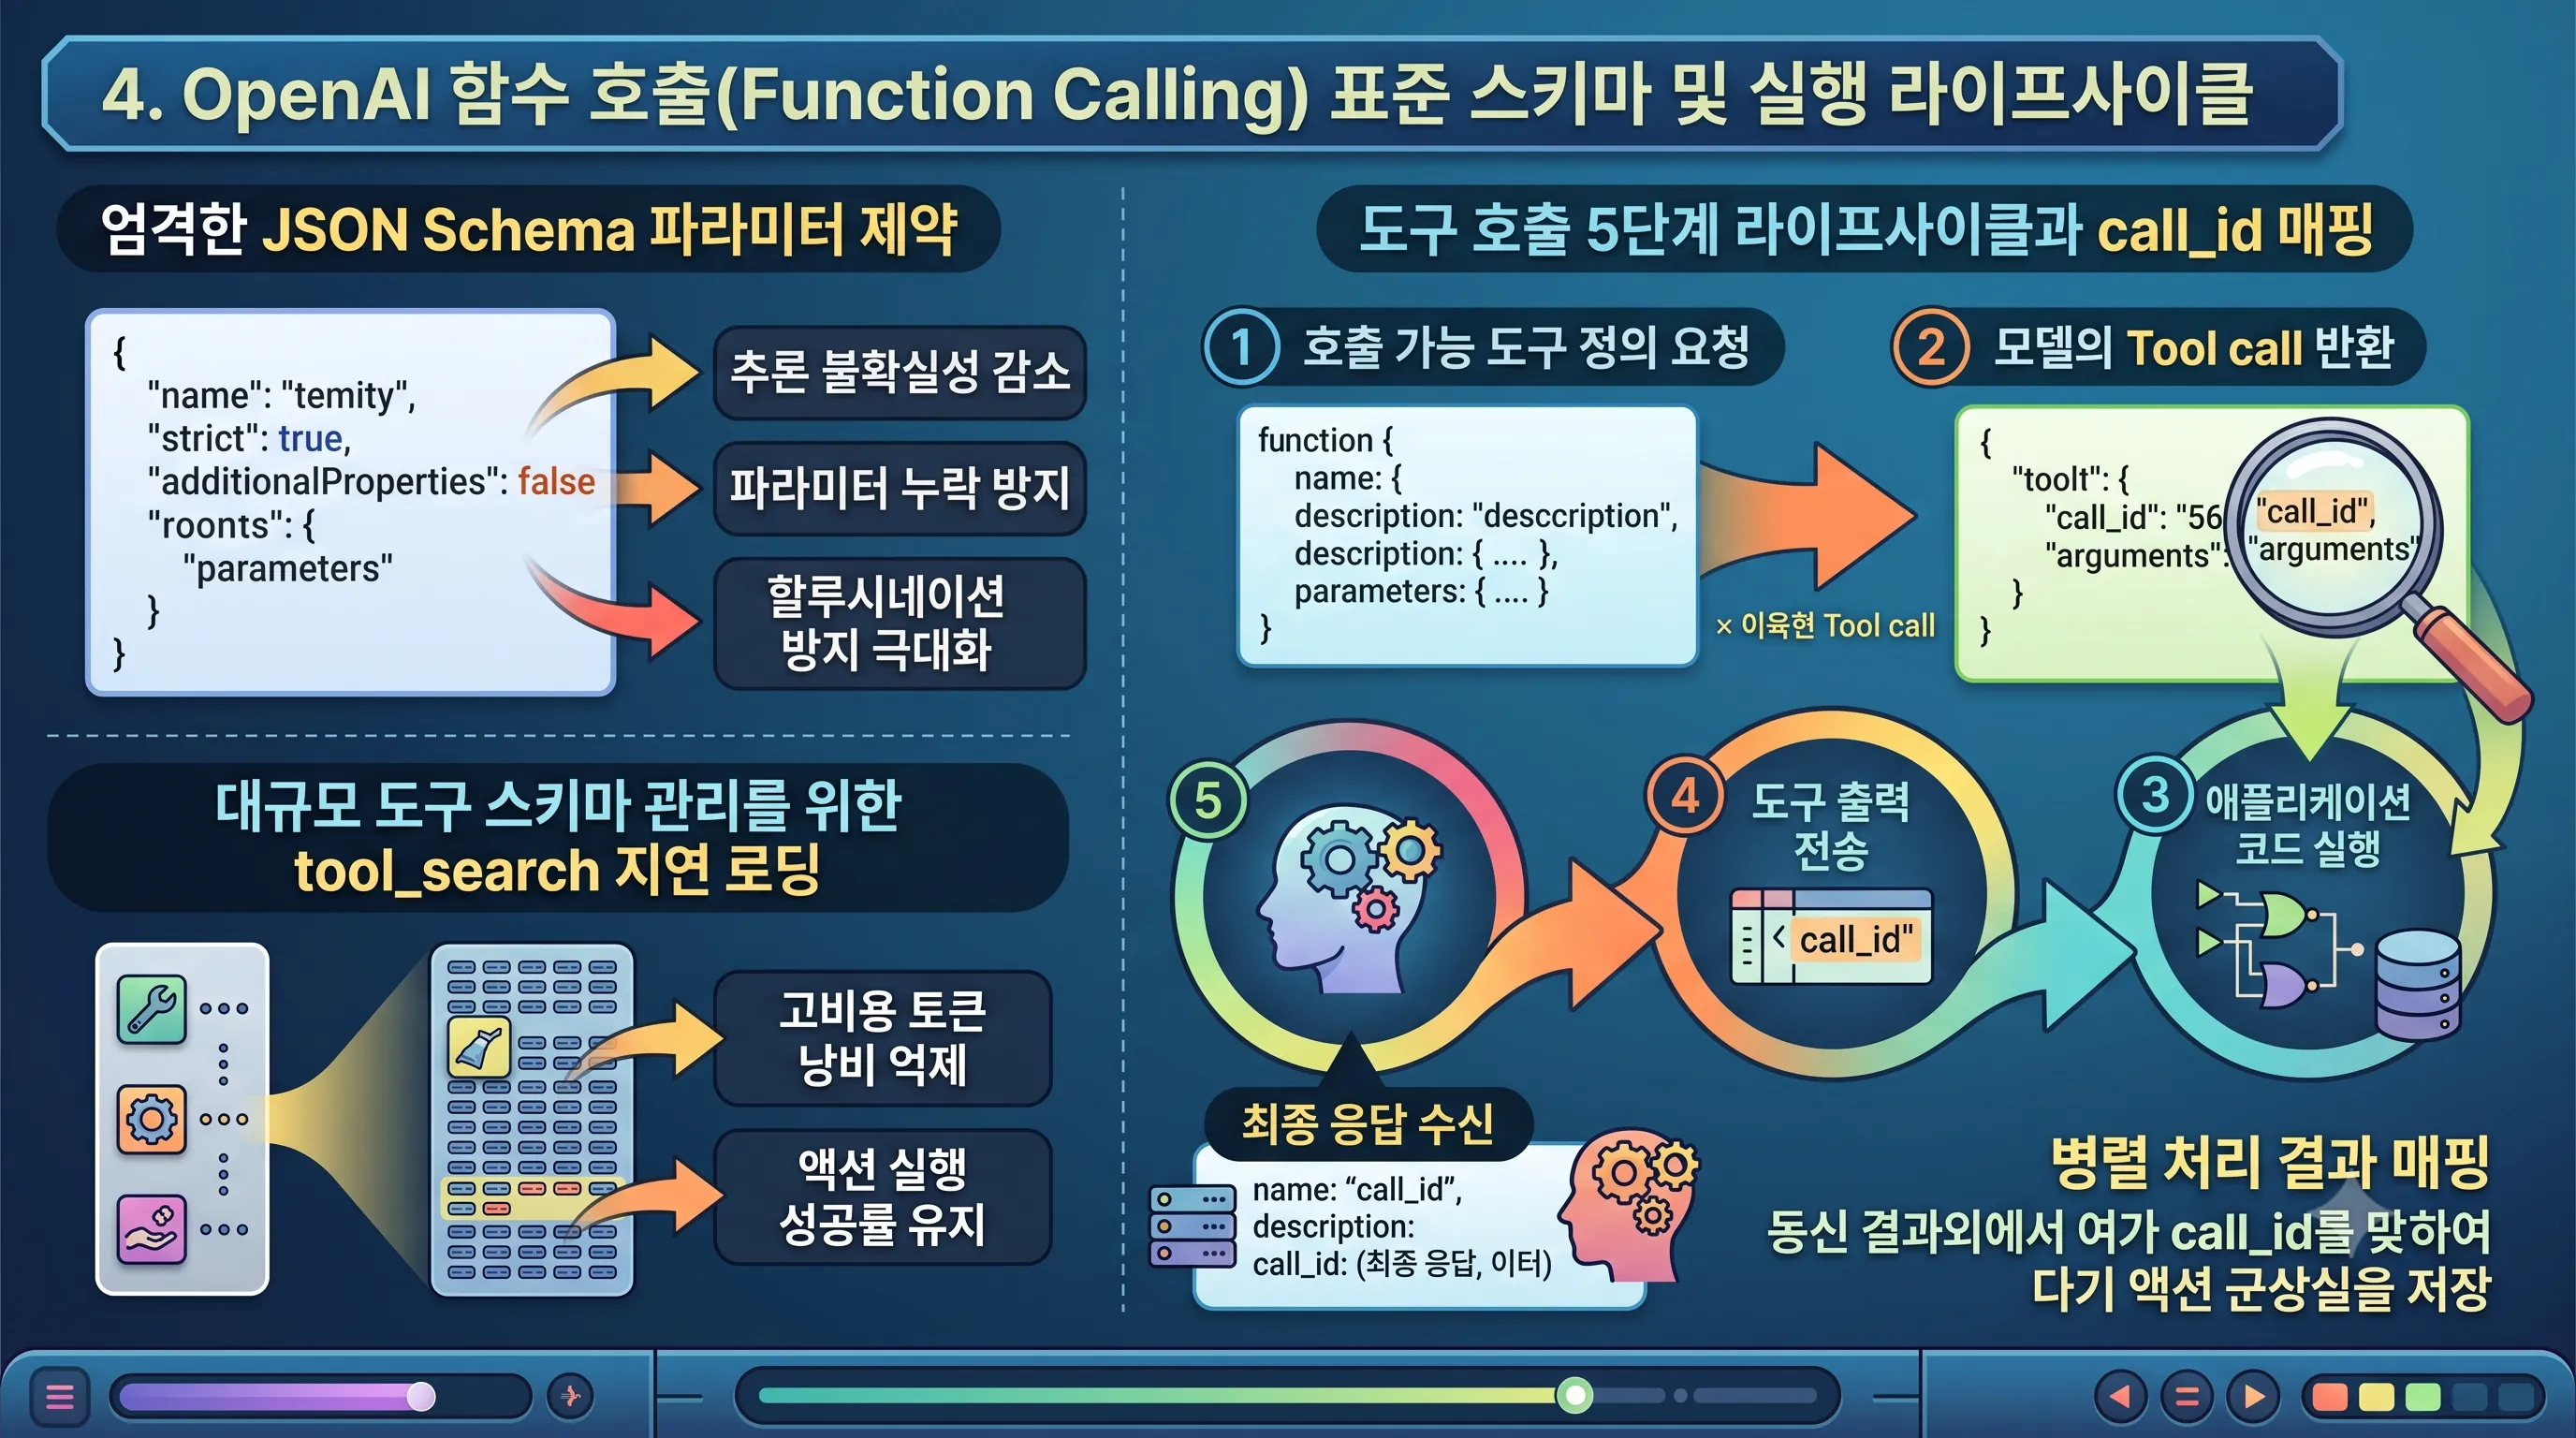
엄격한 JSON Schema(strict: true)를 통한 파라미터 제약
에이전트 아키텍처에서 자연어로 작성된 장황한 시스템 프롬프트에만 의존해 출력을 제어하는 방식은 모델의 추론 불확실성과 파라미터 누락 문제를 유발하기 쉽습니다.
OpenAI 공식 개발자 가이드(developers.openai.com)에 명시된 함수 호출(Function Calling) 표준 스키마는 프롬프트 본문에 복잡한 행동 지시문을 나열하는 대신, 호출 가능한 도구 목록의 이름(name), 기능 설명(description), 매개변수 규격(parameters)을 명시적인 스키마로 분리하여 제공합니다.
이를 통해 대규모 언어 모델은 사용자의 요청 맥락을 파악하고 실행해야 할 도구와 인수를 선별하는 데 집중할 수 있습니다.
파라미터 정의 단계에서 strict: true 옵션을 활성화하면 모델이 개발자가 선언한 JSON Schema 규격을 엄격하게 준수하도록 강제할 수 있습니다.
여기에 additionalProperties: false 제약을 추가하면 스키마에 정의되지 않은 임의의 필드가 응답에 생성되는 것을 원천 차단하여 인자 생성 과정에서의 할루시네이션 방지 효과를 극대화합니다.
이러한 구조화된 선언 방식은 백엔드 시스템과의 연동 시 데이터 유효성 검증 실패를 예방하고 통신 안정성을 높입니다.
도구 호출 5단계 라이프사이클과 call_id 매핑
함수 호출 기반 에이전트의 구동은 표준화된 5단계 라이프사이클을 거쳐 완결됩니다.
전체 실행 흐름은 클라이언트가 호출 가능한 도구 정의를 포함해 요청을 전송하는 1단계로 시작하여, 모델이 Tool call 및 인수를 반환하는 2단계, 반환된 인수를 바탕으로 애플리케이션 코드가 실제 함수를 실행하는 3단계, 도구의 실행 출력을 모델에 재전송하는 4단계, 이를 바탕으로 모델이 최종 응답을 수신하는 5단계로 유기적으로 연결됩니다.
| 단계 | 라이프사이클 단계명 | 주요 역할 및 입출력 제어 |
|---|---|---|
| 1단계 | 호출 가능 도구 정의 요청 | name, description, JSON Schema 매개변수를 담은 도구 목록 전달 |
| 2단계 | 모델의 Tool call 반환 | 질의 분석 후 호출 대상 함수명 및 call_id, 생성된 인수(Arguments) 응답 |
| 3단계 | 애플리케이션 코드 실행 | 수신된 인수를 바탕으로 로컬 또는 원격 시스템에서 실제 비즈니스 로직 실행 |
| 4단계 | 도구 출력 전송 | 함수 실행 결과를 해당 call_id와 매핑하여 모델 컨텍스트로 전달 |
| 5단계 | 최종 응답 수신 | 도구 반환 데이터를 통합하여 사용자 질의에 부합하는 자연어 응답 완료 |
에이전트가 복잡한 태스크를 해결하기 위해 한 번에 여러 외부 API를 호출해야 하는 다중 툴 콜 환경에서는 식별자의 정밀한 관리가 필수적입니다.
모델은 각 도구 호출마다 고유한 call_id 식별자를 부여하여 반환하므로, 애플리케이션은 병렬로 수행되는 비동기 결과 매핑 작업을 혼선 없이 처리할 수 있습니다.
각 실행 결과에 할당된 call_id를 일치시켜 대화 이력에 적재함으로써 다중 액션의 인과 관계를 정확하게 보존합니다.
대규모 도구 스키마 관리를 위한 tool_search 지연 로딩
에이전트가 처리해야 하는 액션의 가짓수가 늘어남에 따라 수십 개 이상의 함수 스키마를 단일 프롬프트에 지속해서 주입하는 구조는 한계에 봉착합니다.
함수 정의가 너무 많거나 스키마가 거대해지면 토큰 소모로 인한 컨텍스트 비용 증가가 발생하며, 후보군이 지나치게 방대해져 모델의 호출 선택 정확도가 저하되는 위험이 존재합니다.
이러한 확장성 문제를 해결하기 위해 gpt-5.4 이상 모델에서는 방대한 도구 스키마의 지연 로딩(Lazy Loading)을 지원하는 tool_search 메커니즘이 지원됩니다.
수많은 액션 모듈의 전체 스키마를 초기 컨텍스트에 무조건 적재하지 않고, 질의 처리에 필요한 시점에 관련 도구를 색인하여 불러오는 tool_search 방식을 적용함으로써 고비용 토큰 낭비를 억제하고 대규모 에이전트 환경에서도 높은 액션 실행 성공률을 유지할 수 있습니다.
관련 글