AI 웹 에이전트 'browser-use' 핵심 분석: 기능, 성능, 활용법
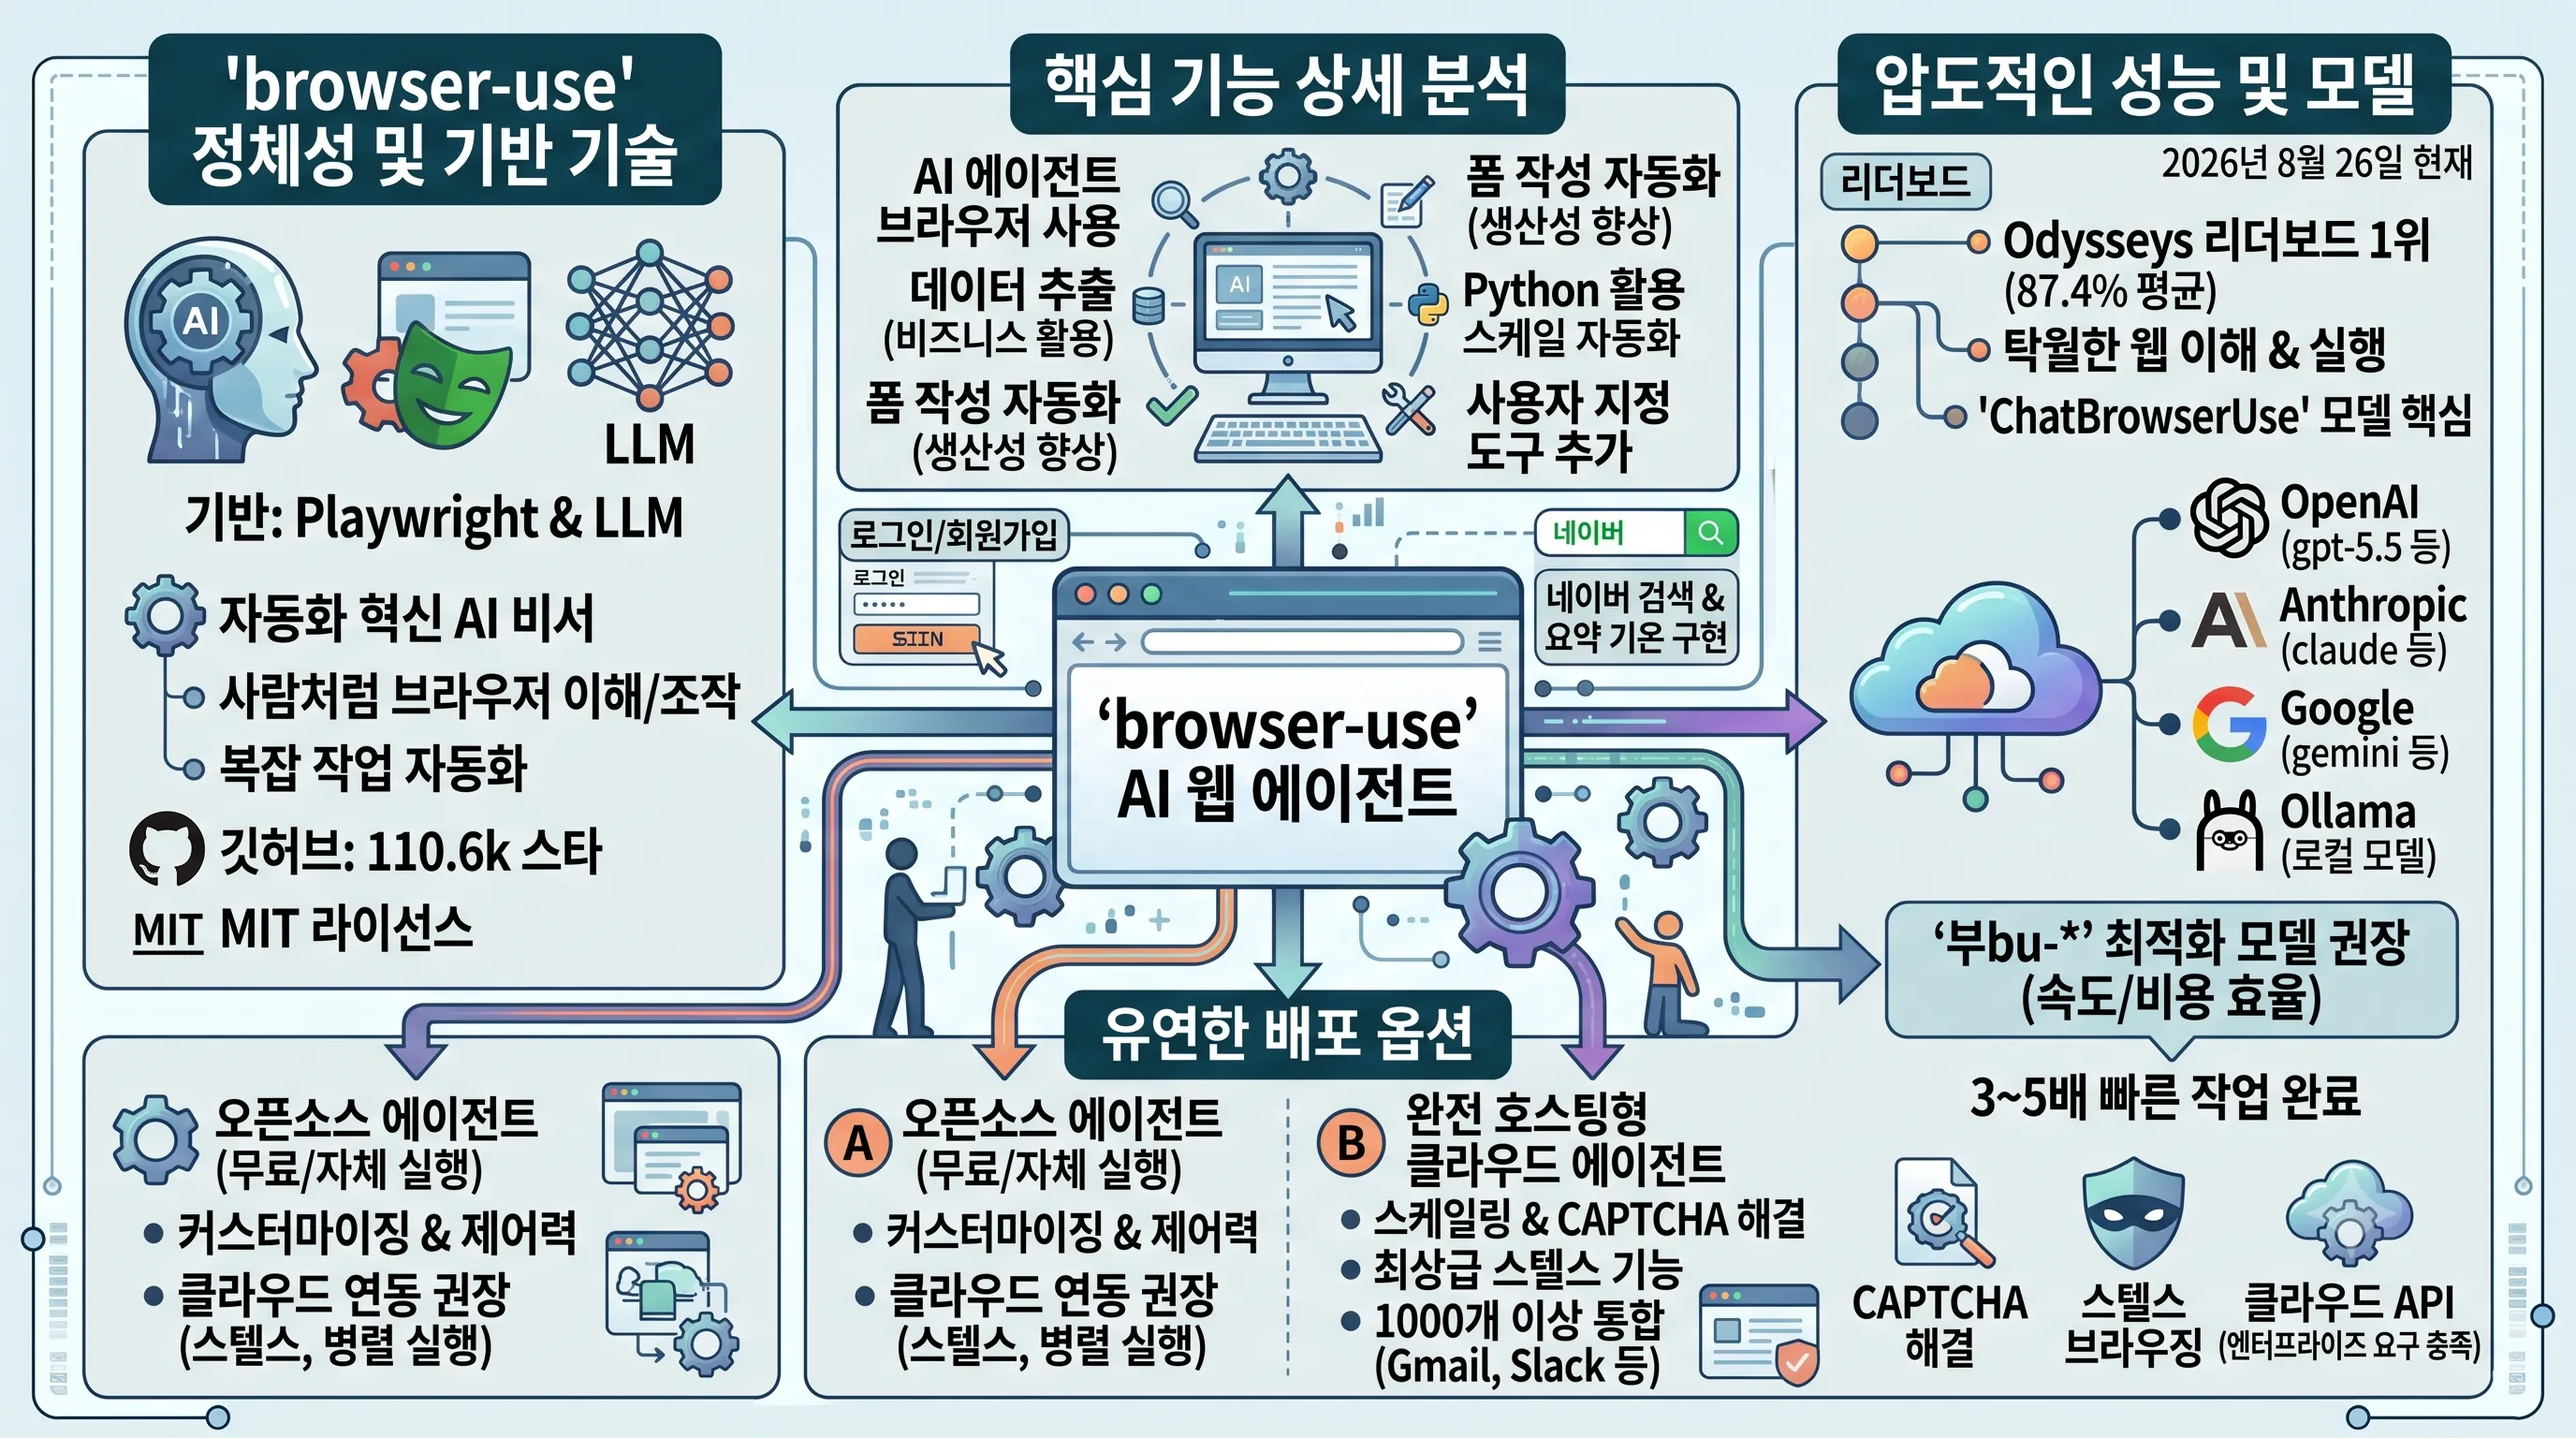
- 'browser-use'는 Playwright와 LLM 기반의 웹 자동화 AI 에이전트로, GitHub 110.6k 스타를 기록하며 MIT 라이선스로 제공됩니다.
- 핵심 기능으로 AI 웹 브라우저 조작(클릭, 타이핑, 폼 작성), 자연어 기반 작업 지시, 정형화된 데이터 추출, Python 라이브러리를 통한 스케일 자동화, 사용자 지정 도구 추가 등을 제공합니다.
- 성능 면에서 Odysseys 리더보드 1위(평균 87.4%)를 차지하며 OpenAI, Anthropic, Google 등 주요 경쟁사를 능가하고, ChatBrowserUse 모델로 3~5배 빠른 작업 완료 및 SOTA 정확도를 구현합니다.
- 배포 옵션은 무료 오픈소스 에이전트와 강력한 완전 호스팅형 클라우드 에이전트로 나뉘며, 클라우드 에이전트는 CAPTCHA 해결, 프록시 로테이션, 1000개 이상 서비스 통합 등 고급 스텔스 및 확장성을 제공합니다.
- 시작하기는 Python 3.12+ 환경에서
pip install browser-use후 CLI 또는 Python 라이브러리(API 키 필수)로 가능하며, 네이버 검색 자동화 예제 등 국내 활용도가 높습니다. - 웹 자동화 안정성을 위해 Playwright의 `getByRole()`, `getByText()` 등 내장 로케이터 사용이 권장되며, `data-testid`가 가장 탄력적이고 CSS/XPath는 DOM 변경에 취약하여 비권장됩니다.
- AI 에이전트 생태계에서 Microsoft(AutoGen, Semantic Kernel), LangGraph(워크플로우), Anthropic(신뢰성 연구, MeNTi 논문) 등 주요 플레이어 속 'browser-use'는 독보적인 웹 자동화 성능으로 선두를 달리고 있습니다.
1. AI 웹 에이전트 'browser-use' 핵심 기능 및 성능 분석
AI 웹 에이전트 'browser-use'의 정체성 및 기반 기술
AI 웹 에이전트 'browser-use'는 Playwright와 대규모 언어 모델(LLM)을 기반으로 웹 자동화를 혁신하는 강력한 도구입니다.
이 제품은 AI 비서로서, 웹 브라우저를 사람처럼 이해하고 조작하여 복잡한 온라인 작업을 자동화하도록 설계되었습니다.
Playwright의 강력한 웹 브라우저 제어 능력과 LLM의 자연어 처리 및 추론 능력이 결합되어, 사용자가 간편하게 웹 환경에서 원하는 바를 이룰 수 있도록 돕습니다.
특히 깃허브에서 110.6k 스타를 기록하며 개발자 커뮤니티의 뜨거운 관심을 받고 있으며, MIT 라이선스를 통해 자유로운 사용을 지원하고 있습니다.
'browser-use'의 핵심 기능 상세 분석
'browser-use'는 다양한 핵심 기능을 통해 사용자에게 차원이 다른 웹 자동화 경험을 제공합니다.
가장 기본적인 기능은 AI 에이전트의 웹 브라우저 사용으로, 페이지 열기, 클릭, 타이핑, 스크롤, 폼 작성 등 사람이 하는 모든 브라우저 조작을 AI가 대신 수행합니다.
이는 사용자가 복잡한 코드를 작성할 필요 없이 자연어 기반 작업 지시만으로 원하는 웹 작업을 실행할 수 있게 해줍니다.
예를 들어, "유튜브 비디오 업로드"나 "노트북 비교", "채용 지원서 작성"과 같은 고차원적인 지시도 이해하고 처리할 수 있습니다.
또한, 특정 웹페이지에서 정형화된 데이터 추출이 가능하여 시장 조사, 경쟁사 분석 등 다양한 비즈니스 용도에 활용될 수 있습니다.
웹사이트 로그인 및 회원가입 시 필수적인 폼 작성 자동화 기능은 반복적인 수작업을 없애 생산성을 크게 향상시킵니다.
Python 라이브러리를 활용한 스케일 웹 자동화를 지원하여, 개발자들은 자체 코드와 LLM을 결합해 더욱 정교하고 대규모의 자동화 솔루션을 구축할 수 있습니다.
사용자는 필요에 따라 사용자 지정 도구 추가가 가능하여 'browser-use'의 기능을 무한히 확장할 수 있습니다.
보안과 편의성을 위해 실제 브라우저 프로필을 이용한 인증 처리 및 세션 유지 기능을 제공하며, AgentMail을 통해 임시 계정을 사용하거나 profile-use를 통해 원격 브라우저와 인증 프로필을 동기화할 수 있습니다.
실제 국내 환경에서는 Python 코드를 통해 네이버 검색창에 '오늘의 날씨'를 검색하고 최상단 요약 기온을 알려주는 에이전트를 손쉽게 구현할 수 있어 활용도가 높습니다.
압도적인 성능: Odysseys 리더보드 1위와 ChatBrowserUse
'browser-use'의 가장 강력한 경쟁력은 단연 최상급 성능입니다.
2026년 8월 26일 현재, 이 제품은 웹 자동화 에이전트의 성능을 평가하는 Odysseys 리더보드에서 87.4%의 평균 점수로 당당히 1위를 차지하고 있습니다.
이는 OpenAI, Anthropic, Google, Microsoft 등 주요 AI 기업의 에이전트들을 능가하는 수치로, 'browser-use'의 탁월한 웹 이해 및 실행 능력을 입증합니다.
이러한 성능의 핵심에는 브라우저 자동화에 특화된 최적화 모델인 'ChatBrowserUse'가 있습니다.
'ChatBrowserUse'는 SOTA(State-Of-The-Art) 정확도를 자랑하며, 다른 모델 대비 3~5배 빠른 작업 완료 속도를 제공하여 효율성을 극대화합니다.
'browser-use'는 OpenAI (gpt-5.5, gpt-4o 등), Anthropic (claude-opus-4-8, claude-sonnet-4-6 등), Google (gemini-3-pro), Ollama (로컬 모델 실행) 등 다양한 LLM 제공자를 지원하여 사용자에게 폭넓은 선택지를 제공합니다.
하지만 최상의 속도와 비용 효율성을 위해서는 기본 'bu-*' 모델 사용이 권장됩니다.
또한 Browser Use Cloud를 통해 CAPTCHA 해결 및 최상급 스텔스 브라우징 기능을 제공하여 웹 환경에서의 제약을 최소화하고 에이전트의 안정적인 동작을 보장합니다.
확장 가능한 브라우저 인프라, 메모리 관리, 프록시 로테이션, 스텔스 브라우저 핑거프린팅, 고성능 병렬 실행을 위한 클라우드 API는 엔터프라이즈급 웹 자동화 요구사항을 충족합니다.
유연한 배포 옵션과 클라우드 에이전트의 강점
'browser-use'는 사용자의 필요에 따라 두 가지 주요 배포 옵션을 제공하여 유연성을 더합니다.
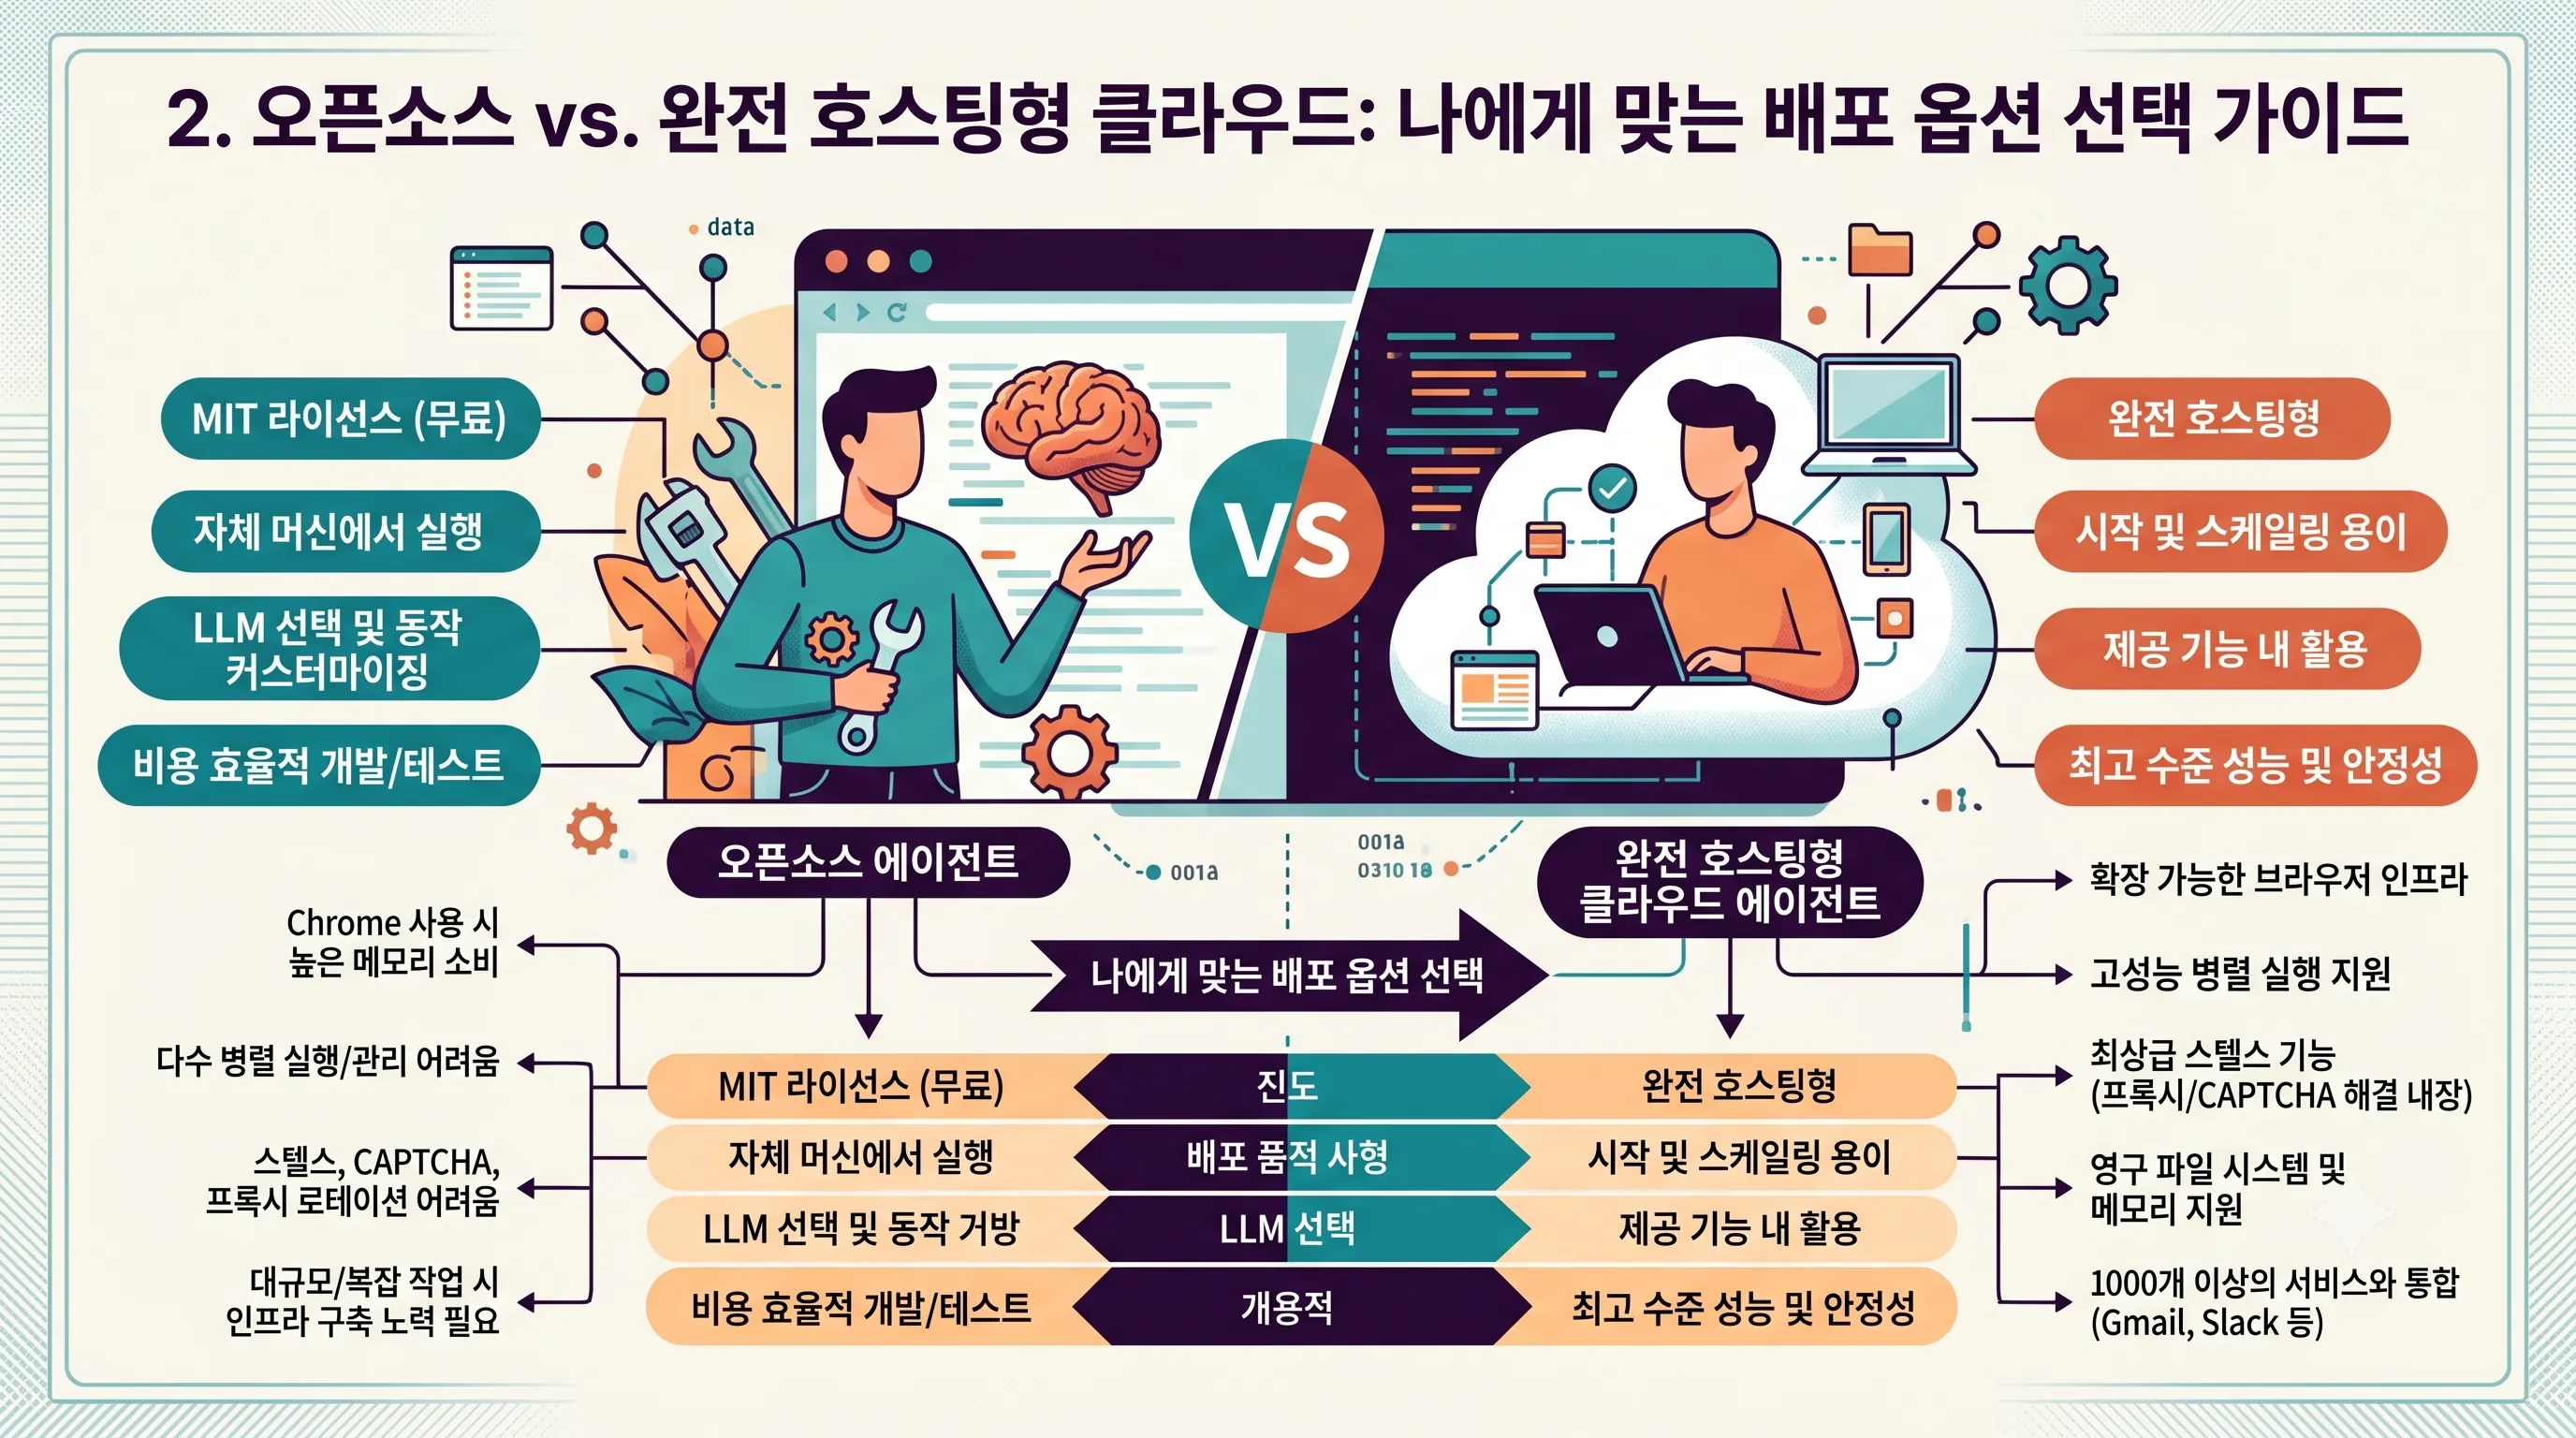
첫 번째는 오픈소스 에이전트로, 무료로 사용할 수 있으며 사용자가 자체 머신에서 직접 실행할 수 있습니다.
이는 LLM 선택 및 에이전트 동작을 자유롭게 커스터마이징할 수 있는 높은 제어력을 제공합니다.
다만, 오픈소스 환경에서 Chrome 사용 시 높은 메모리 소비와 다수의 에이전트 병렬 실행 관리의 어려움이 있을 수 있어, 선행 스텔스, 프록시 로테이션, 스케일링을 위해서는 클라우드 브라우저와의 연동이 권장됩니다.
CAPTCHA 처리를 위해서는 Browser Use Cloud의 지원이 필요합니다.
두 번째 옵션은 완전 호스팅형 클라우드 에이전트입니다.
이 서비스는 복잡한 작업에 더 강력하며, 시작 및 스케일링이 용이하다는 장점을 가집니다.
프록시 로테이션 및 CAPTCHA 해결을 통한 최상급 스텔스 기능은 웹사이트 차단을 회피하고 안정적인 작업을 보장합니다.
또한 1000개 이상의 통합을 지원하여 Gmail, Slack, Notion 등 다양한 서비스와 연동할 수 있으며, 영구 파일 시스템 및 메모리, 실시간 데이터 fetch를 위한 재실행 가능한 스크립트 등 강력한 기능을 제공합니다.
2. 오픈소스 vs. 완전 호스팅형 클라우드: 나에게 맞는 배포 옵션 선택 가이드
AI 비서: Playwright + LLM 웹 자동화 에이전트의 두 가지 배포 전략
AI 에이전트의 웹 브라우저 사용 기능을 제공하는 AI 비서: Playwright + LLM 웹 자동화 에이전트 (browser-use)는 사용자의 특정 요구사항과 운영 환경에 따라 크게 두 가지 배포 옵션을 제공합니다.
하나는 높은 자유도를 자랑하는 오픈소스 에이전트이며, 다른 하나는 강력한 성능과 관리 편의성을 제공하는 완전 호스팅형 클라우드 에이전트입니다.
각 옵션은 고유한 장점과 한계를 가지고 있어, 사용자는 자신의 프로젝트 규모, 예산, 기술 스택 등을 고려하여 최적의 선택을 할 수 있습니다.
오픈소스 에이전트: 자유와 커스터마이징의 보고, 그러나 고려해야 할 제약
AI 비서: Playwright + LLM 웹 자동화 에이전트는 그 핵심 기능인 Playwright와 LLM (Large Language Model)을 기반으로 하는 웹 자동화 솔루션으로, MIT 라이선스하에 무료로 사용할 수 있는 오픈소스 라이브러리 형태로 제공됩니다.
사용자는 이 오픈소스 에이전트를 자신의 자체 머신에서 실행하며, LLM 선택과 에이전트의 동작 방식을 자유롭게 커스터마이징할 수 있다는 강력한 장점을 가집니다.
이는 개발자가 특정 비즈니스 로직이나 복잡한 웹 환경에 맞춰 에이전트를 미세 조정하고, 비용 효율적인 방식으로 AI 웹 자동화를 구현할 수 있게 합니다.
그러나 오픈소스 환경에서 에이전트를 운영하는 것은 몇 가지 한계를 동반합니다.
특히 Chrome 브라우저를 사용하는 경우 높은 메모리 소비가 발생할 수 있으며, 이는 제한된 하드웨어 리소스에서 여러 에이전트를 동시에 실행할 때 문제가 될 수 있습니다.
또한, 다수의 에이전트를 병렬로 실행하고 관리하는 것이 기술적으로 어려울 수 있습니다.
선행 스텔스, 프록시 로테이션, CAPTCHA 처리와 같은 고급 기능들은 오픈소스 에이전트 자체만으로는 해결하기 어렵습니다.
이러한 기능들을 위해서는 클라우드 브라우저(예: Browser Use Cloud)와의 연동이 권장되며, 특히 CAPTCHA 처리를 위해서는 Browser Use Cloud가 필수적으로 요구됩니다.
결국, 오픈소스의 무료 사용이라는 장점에도 불구하고, 대규모 또는 복잡한 작업에는 추가적인 인프라 구축과 관리 노력이 필요하다는 점을 명심해야 합니다.
완전 호스팅형 클라우드 에이전트: 복잡성 해소와 강력한 성능
오픈소스 에이전트의 한계를 극복하고 더욱 강력하며 편리한 웹 자동화 환경을 제공하기 위해 완전 호스팅형 클라우드 에이전트 옵션이 마련되어 있습니다.
이 클라우드 에이전트는 복잡한 작업에 더 강력한 성능을 발휘하며, 사용자가 에이전트를 시작하고 스케일링하는 과정을 매우 용이하게 만듭니다.
특히, 오픈소스 에이전트에서 해결하기 어려웠던 문제들을 클라우드 에이전트는 자체적으로 해결합니다.
예를 들어, 최상급의 스텔스 기능을 제공하는데, 이는 프록시 로테이션 및 CAPTCHA 해결 기능을 내장하고 있기 때문입니다.
Browser Use Cloud를 통해 제공되는 이러한 스텔스 브라우징 및 CAPTCHA 해결 기능은 웹 스크래핑이나 자동화 작업 시 발생할 수 있는 차단을 효과적으로 우회할 수 있도록 돕습니다.
또한, 클라우드 에이전트는 영구 파일 시스템 및 메모리를 지원하여 작업의 연속성을 보장하며, 실시간 데이터 fetch를 위한 재실행 가능한 스크립트 기능을 통해 동적인 웹 환경에서도 안정적인 데이터 수집이 가능합니다.
가장 큰 장점 중 하나는 Gmail, Slack, Notion 등 1000개 이상의 서비스와 통합을 지원한다는 점입니다.
이는 다양한 비즈니스 워크플로우에 AI 에이전트를 Seamless하게 연동하여 활용 범위를 극대화할 수 있음을 의미합니다.
클라우드 API를 활용하면 확장 가능한 브라우저 인프라, 메모리 관리, 프록시 로테이션, 스텔스 브라우저 핑거프린팅, 고성능 병렬 실행 등 오픈소스 환경에서의 관리 어려움을 손쉽게 해결할 수 있습니다.
| 특징/기능 | 오픈소스 에이전트 | 완전 호스팅형 클라우드 에이전트 |
|---|---|---|
| 기반 | Playwright + LLM 기반, MIT 라이선스 (무료) | 완전 호스팅형, Playwright + LLM 기반 (서비스 이용료 추정) |
| 실행 환경 | 자체 머신에서 실행 | 클라우드 환경에서 호스팅 |
| 커스터마이징 | LLM 선택 및 에이전트 동작 방식 자유롭게 커스터마이징 가능 | 제공되는 기능 내에서 활용, API를 통한 연동 가능 |
| 확장성/스케일링 | 다수 에이전트 병렬 실행 및 관리 기술적으로 어려움, 클라우드 브라우저 연동 권장 | 시작 및 스케일링 매우 용이, 확장 가능한 브라우저 인프라, 고성능 병렬 실행 지원 |
| 고급 기능 (스텔스, CAPTCHA, 프록시 로테이션) | 선행 스텔스, 프록시 로테이션, CAPTCHA 처리 어려움, Browser Use Cloud 연동 필수 | 최상급 스텔스 기능 (프록시 로테이션 및 CAPTCHA 해결 내장) 제공 |
| 자원 관리 | Chrome 사용 시 높은 메모리 소비, 영구 파일 시스템/메모리 관리 필요 | 메모리 관리, 영구 파일 시스템 및 메모리 지원 |
| 통합 | 자체적으로 통합 구축 필요 | Gmail, Slack, Notion 등 1000개 이상의 서비스와 통합 지원 |
| 비용 | 무료 (단, 고급 기능에 추가 비용 발생 가능) | 유료 서비스 추정 (복잡성 해소 및 강력한 성능 대가) |
| 주요 장점 | 높은 자유도, 비용 효율적 개발/테스트 | 복잡성 해소, 강력한 성능, 관리 편의성, 최고 수준의 안정성 |
| 주요 고려사항 | 대규모/복잡한 작업 시 인프라 구축 및 관리 노력 필요 | 서비스 이용료 발생 |
비용 측면 분석 및 선택 가이드
배포 옵션 선택에 있어 비용은 중요한 고려 사항입니다.
오픈소스 라이브러리 형태로 제공되는 AI 비서: Playwright + LLM 웹 자동화 에이전트는 무료로 사용할 수 있습니다.
이는 초기 비용 부담 없이 웹 자동화 에이전트를 개발하고 테스트하려는 개인 개발자나 소규모 프로젝트에 매우 매력적인 옵션입니다.
그러나 앞서 언급했듯이, 대규모 스케일링, 복잡한 스텔스 기능, CAPTCHA 해결 등을 위해서는 클라우드 브라우저 연동이나 Browser Use Cloud와 같은 추가 서비스가 필요하며, 이에 따른 별도 비용이 발생할 수 있습니다.
반면, 완전 호스팅형 클라우드 에이전트는 이러한 모든 기능을 통합하여 제공하므로, 서비스 이용료가 부과될 것으로 예상됩니다.
현재 제공된 정보에 따르면 클라우드 서비스의 명확한 요금제 정보는 명시되어 있지 않지만, 유료 서비스로 추정됩니다.
초기 구축 및 운영에 필요한 인력과 시간 비용을 절감하고, 최고 수준의 성능과 안정성, 그리고 관리 편의성을 추구한다면 클라우드 에이전트가 더 효율적인 선택일 수 있습니다.
따라서 사용자는 예산, 필요한 기능의 복잡성, 관리 리소스 가용성, 그리고 장기적인 스케일링 계획을 종합적으로 고려하여 자신에게 가장 적합한 배포 옵션을 선택해야 합니다.
단순하고 소규모의 자동화 작업에는 오픈소스가 유리할 수 있으며, 대규모의 복잡하고 지속적인 웹 자동화가 필요한 경우에는 클라우드 에이전트가 더 나은 해답이 될 것입니다.
3. 실전! 'browser-use' 시작하기: 국내 네이버 검색 자동화 예제 포함
AI 비서 'browser-use' 핵심: 설치 및 CLI 활용
AI 에이전트의 웹 브라우저 사용을 혁신하는 'browser-use'는 Playwright와 LLM(Large Language Model)을 결합하여 복잡한 웹 자동화 작업을 자연어 지시만으로 수행할 수 있도록 돕는 솔루션입니다.
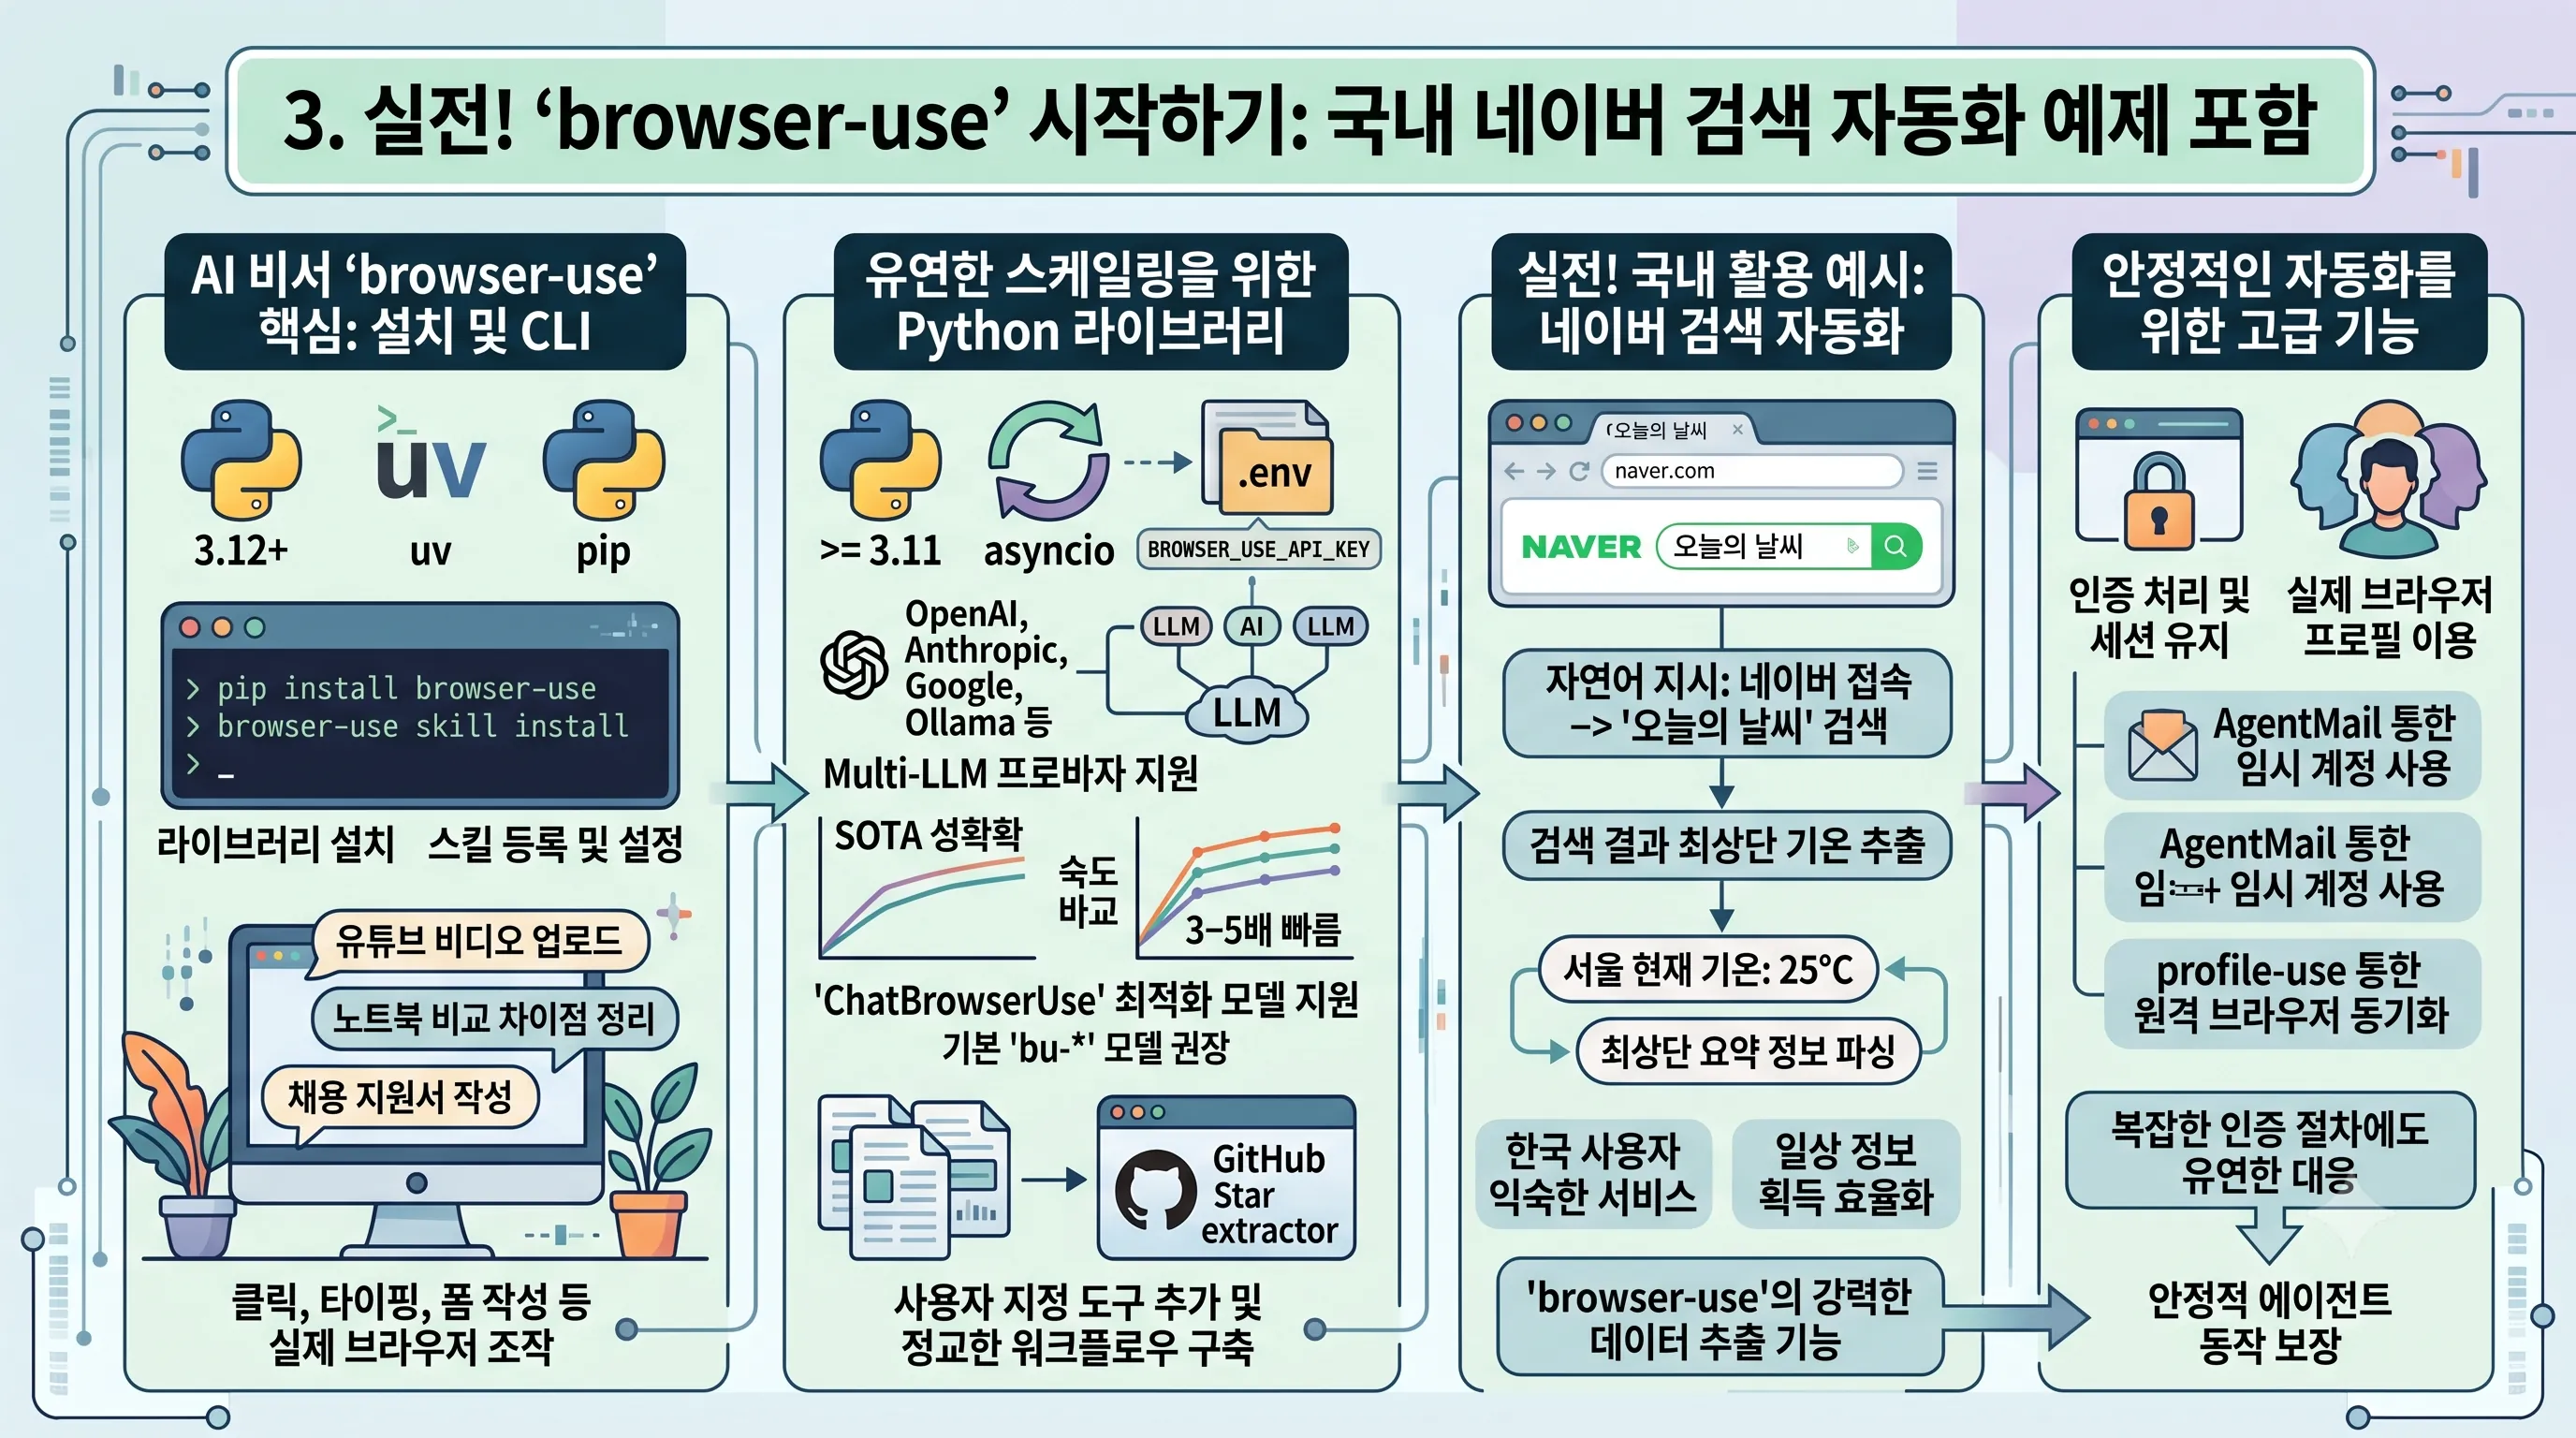
이 강력한 도구를 CLI(명령줄 인터페이스) 환경에서 시작하려면 먼저 Python 3.12 환경을 구축하고 uv 또는 pip를 사용하여 라이브러리를 설치해야 합니다.
설치는 간단합니다.
터미널에서 다음 명령어를 실행하여 'browser-use'를 설치하십시오.
pip install browser-use 또는 uv pip install browser-use
설치 후에는 'browser-use' 에이전트가 다양한 웹 작업을 수행할 수 있도록 스킬을 등록하고 브라우저 연결을 설정하는 과정이 필요합니다.
이를 위해 browser-use skill install 명령어를 실행하면 필요한 설정이 자동으로 진행됩니다.
설치가 완료되면, 사용자는 자연어를 통해 에이전트에게 작업을 지시할 수 있습니다.
예를 들어, "YouTube에 비디오 업로드", "두 개의 노트북을 비교하여 차이점 정리", "특정 기업의 채용 지원서 작성"과 같은 복잡한 작업도 지시할 수 있습니다.
이는 'browser-use'가 단순히 웹 페이지를 여는 것을 넘어, 클릭, 타이핑, 폼 작성 등 실제 사용자의 브라우저 사용 패턴을 모방하여 목표를 달성할 수 있음을 의미합니다.
유연한 스케일링을 위한 Python 라이브러리 활용
보다 세밀한 제어와 확장 가능한 웹 자동화 시스템을 구축하고자 한다면, 'browser-use' Python 라이브러리를 활용하는 것이 효과적입니다.
Python >= 3.11 환경에서 다음 명령어를 통해 라이브러리를 설치할 수 있습니다.
pip install browser-use 또는 uv add browser-use
라이브러리 사용을 위해서는 API 키 설정이 필수적입니다.
.env 파일에 BROWSER_USE_API_KEY를 설정해야 하며, 이 키는 Browser Use Cloud에서 발급받거나 OpenAI, Anthropic, Google, Ollama 등 지원되는 다른 LLM 제공자의 키를 사용할 수 있습니다.
특히, 'browser-use'는 브라우저 자동화에 최적화된 ChatBrowserUse 모델을 지원하여 SOTA(State-Of-The-Art) 정확도와 3-5배 빠른 작업 완료 속도를 제공합니다.
기본 'bu-*' 모델을 권장하며, 이는 최상의 속도 및 비용 효율을 자랑합니다.
Python 라이브러리를 사용한 에이전트 실행은 asyncio를 활용하여 비동기적으로 이루어집니다.
가령, 'browser-use' GitHub 저장소의 스타 개수를 찾아내는 예제와 같이, 특정 웹사이트에서 정형화된 데이터를 추출하거나 복잡한 상호작용을 프로그래밍 방식으로 정의할 수 있습니다.
이를 통해 사용자 지정 도구를 추가하거나, 자체 코드와 LLM을 결합하여 더욱 정교한 웹 자동화 워크플로우를 구축하는 것이 가능합니다.
실전! 국내 활용 예시: 네이버 검색 자동화 워크플로우
이제 'browser-use'를 국내 환경에서 어떻게 실용적으로 활용할 수 있는지, 네이버 검색 자동화 예제를 통해 구체적인 워크플로우를 제시합니다.
이 예제는 네이버 검색창에 '오늘의 날씨'를 검색하고, 검색 결과 최상단에 요약된 기온 정보를 추출하여 사용자에게 알려주는 파이썬 코드입니다.
한국 사용자들에게 매우 익숙한 네이버 검색을 자동화함으로써, 일상적인 정보 획득을 효율화하는 실용적인 시나리오를 제공합니다.
다음은 'browser-use' Python 라이브러리를 활용한 네이버 검색 자동화 코드의 핵심적인 구성 요소를 보여줍니다.
실제 코드에서는 asyncio를 통해 에이전트를 비동기적으로 실행하고, 자연어 지시를 통해 네이버 웹사이트 내에서 검색 작업을 수행하도록 유도합니다.
에이전트가 검색을 완료하면, 최상단에 나타나는 기온 정보를 정확히 파싱하여 반환하도록 지시할 수 있습니다.
이는 'browser-use'의 정형화된 데이터 추출 기능과 자연어 기반 작업 지시 능력이 결합된 결과입니다.
예를 들어, 에이전트에게 "네이버에 접속하여 '오늘의 날씨'를 검색하고, 검색 결과에서 현재 서울의 기온을 찾아 알려줘."와 같은 자연어 프롬프트를 전달할 수 있습니다.
'browser-use'는 실제 브라우저 프로필을 이용하여 인증 처리 및 세션 유지가 가능하므로, 로그인 기반의 서비스에서도 안정적인 자동화를 기대할 수 있습니다.
또한, AgentMail을 통한 임시 계정 사용이나 profile-use를 통한 원격 브라우저와 인증 프로필 동기화 기능은 국내 특정 웹 서비스의 복잡한 인증 절차에도 유연하게 대응할 수 있도록 돕습니다.
4. 웹 자동화의 안정성을 좌우하는 'Playwright Locators' 핵심 원칙
웹 자동화 테스트의 성공 여부는 얼마나 견고하고 안정적으로 웹 요소를 식별하는지에 달려 있습니다. 여기에서 핵심적인 역할을 하는 것이 바로 Playwright Locators입니다.
이는 페이지 내 요소(들)를 찾는 방법을 의미하며, Playwright의 강력한 자동 대기(auto-wait) 및 재시도(retry) 기능의 핵심 구성 요소로 작용합니다.
즉, 동적으로 변화하는 웹 환경에서도 스크립트가 목표 요소를 안정적으로 찾아내고 상호작용할 수 있도록 보장하는 기반 기술이라 할 수 있습니다.
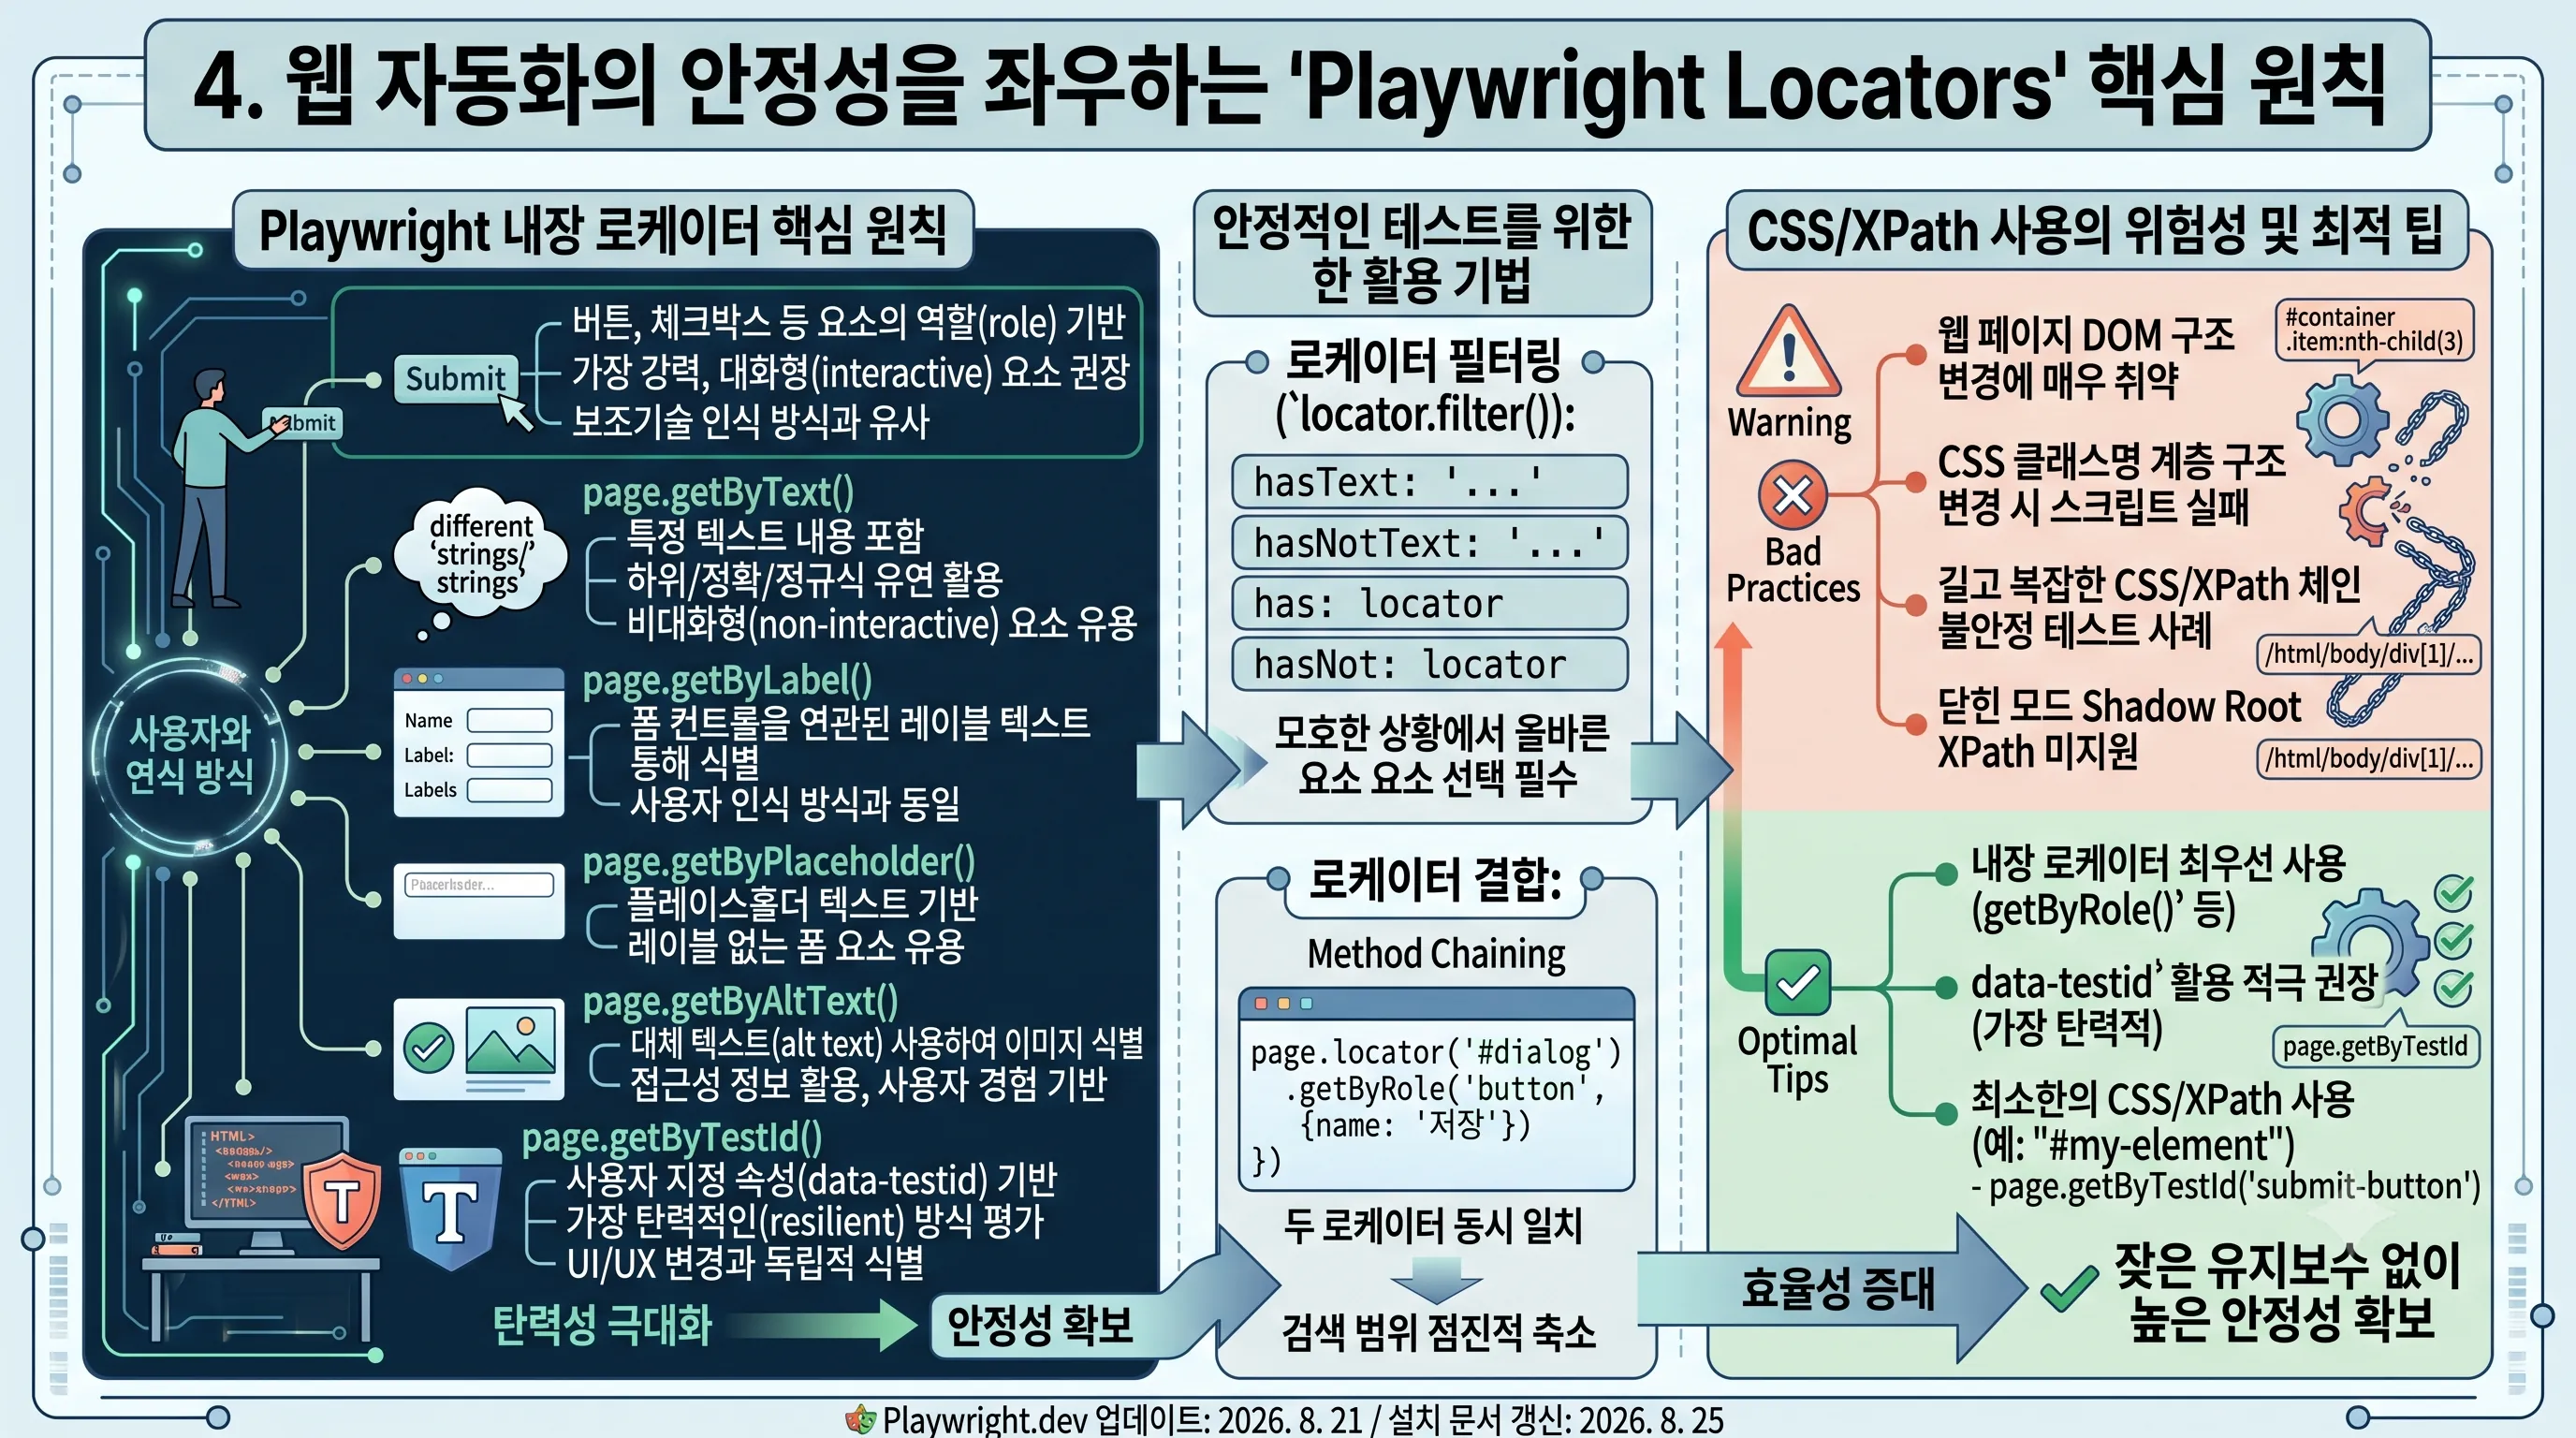
최근 2026년 8월 21일 Playwright.dev 웹사이트가 업데이트되었고, 설치 문서는 2026년 8월 25일에 최신 정보로 갱신될 정도로 Playwright의 로케이터 기술은 지속적으로 발전하고 있습니다.
Playwright 내장 로케이터의 핵심 원칙과 활용
Playwright는 개발자가 가장 안정적이고 사용자 친화적인 방식으로 요소를 찾을 수 있도록 다양한 내장 로케이터(Built-in Locators)를 제공합니다.
이들은 단순히 DOM 구조에 의존하는 것을 넘어, 사용자가 페이지를 인지하고 보조 기술(assistive technology)이 웹 콘텐츠와 상호작용하는 방식에 가깝게 설계되어 테스트의 탄력성(resilience)을 극대화합니다.
가장 대표적이며 권장되는 로케이터는 다음과 같습니다.
-
`page.getByRole()`: 이 로케이터는 버튼(button), 체크박스(checkbox), 헤딩(heading) 등 요소의 역할(role)과 접근성 속성을 기반으로 요소를 찾습니다.
예를 들어, 웹 페이지의 "제출" 버튼을 찾을 때, 단순히 CSS 선택자가 아닌 `getByRole('button', {name: '제출'})`과 같이 명확하고 의미론적인 방식으로 접근할 수 있습니다.
이는 대화형(interactive) 요소를 찾는 데 가장 강력하고 사용자 및 보조 기술의 페이지 인식 방식과 가장 가깝기 때문에 적극 권장됩니다. -
`page.getByText()`: 특정 텍스트 내용을 포함하는 요소를 찾는 데 사용됩니다.
하위 문자열(substring), 정확한 문자열(exact string), 정규 표현식(regular expression)을 활용하여 유연하게 요소를 식별할 수 있습니다.
주로 비대화형(non-interactive) 요소, 예를 들어 특정 문구가 포함된 단락이나 제목을 찾을 때 유용합니다. -
`page.getByLabel()`: 폼 컨트롤(form control)을 연관된 레이블(label) 텍스트를 통해 찾습니다.
사용자가 폼 필드 옆의 레이블을 보고 해당 입력란을 식별하는 방식과 동일하게 작동하여 폼(form) 필드 자동화에 이상적입니다. -
`page.getByPlaceholder()`: 입력 요소의 플레이스홀더(placeholder) 텍스트를 기반으로 요소를 찾습니다.
레이블이 없는 폼 요소에 특히 유용하며, 사용자에게 보이는 정보를 직접 활용하므로 안정적입니다. -
`page.getByAltText()`: 대체 텍스트(alt text)를 사용하여 이미지(img)나 영역(area) 요소를 식별합니다.
시각 장애인을 위한 접근성 정보를 활용하므로, 사용자 경험에 기반한 테스트에 적합합니다. -
`page.getByTitle()`: 요소의 `title` 속성을 사용하여 요소를 찾습니다.
-
`page.getByTestId()`: 개발자가 HTML 요소에 `data-testid`와 같은 사용자 지정 속성을 추가하여 이를 기반으로 요소를 찾습니다.
이는 가장 탄력적인(resilient) 테스트 방식 중 하나로 평가받지만, 사용자에게 노출되지 않는 속성을 사용한다는 특징이 있습니다.
테스트 ID를 사용하는 것은 DOM 구조 변경에 가장 덜 영향을 받으므로 장기적인 테스트 유지보수에 유리합니다.
이러한 로케이터들은 항상 최신 DOM 요소를 찾아내며, 로케이터 생성 메서드 체이닝을 통해 검색 범위를 좁힐 수 있습니다.
또한, Shadow DOM을 지원하여 복잡한 웹 컴포넌트 내부의 요소도 효과적으로 식별할 수 있습니다 (단, XPath 및 닫힌 모드(Closed-mode) Shadow Root는 예외입니다).
필요에 따라 CSS 또는 XPath 로케이터를 사용해야 할 경우 `page.locator()` 메서드를 통해 사용할 수 있으며, CSS 또는 XPath 접두사를 자동으로 감지합니다.
안정적인 테스트를 위한 로케이터 필터링 및 결합 기법
복잡한 웹 페이지에서 특정 요소를 정확하게 식별하려면 로케이터 필터링(filtering) 및 결합(combination) 기법을 활용하는 것이 중요합니다.
이러한 기법들은 모호한 상황에서 올바른 요소를 선택하는 데 필수적입니다.
-
로케이터 필터링: Playwright는 `locator.filter()` 메서드를 통해 다양한 기준으로 요소를 필터링할 수 있도록 합니다.
`locator.filter({hasText: '...'})`: 특정 텍스트를 포함하는 요소를 필터링합니다.
하위 문자열, 정확한 문자열 또는 정규 표현식을 사용할 수 있어 유연합니다.`locator.filter({hasNotText: '...'})`: 특정 텍스트를 포함하지 않는 요소를 필터링합니다.
`locator.filter({has: locator})`: 특정 자손 요소(descendant locator)를 포함하는 요소를 필터링합니다.
이때 필터링에 사용되는 로케이터는 원본 로케이터에 상대적이어야 합니다.`locator.filter({hasNot: locator})`: 특정 자손 요소를 포함하지 않는 요소를 필터링합니다.
-
로케이터 결합: 여러 로케이터를 조합하여 더욱 정교한 선택자를 만들 수 있습니다.
메서드 체이닝: `locator.getByRole()`과 같이 로케이터 메서드를 연쇄적으로 호출하여 검색 범위를 점진적으로 좁혀나갈 수 있습니다.
예를 들어, `page.locator('#dialog').getByRole('button', {name: '저장'})`과 같이 특정 대화 상자 내의 '저장' 버튼을 정확히 찾을 수 있습니다.두 로케이터 동시 일치: 특정 부모 요소 내에서 자식 요소를 찾는 등, 두 로케이터가 동시에 일치하는 경우를 활용하여 요소를 정확히 식별할 수 있습니다.
CSS/XPath 사용의 위험성 및 최적의 사용 팁
Playwright는 CSS(Cascading Style Sheets) 및 XPath(XML Path Language) 로케이터의 사용을 허용하지만, 테스트 안정성 측면에서는 사용을 비권장합니다.
그 이유는 이러한 로케이터들이 웹 페이지의 DOM(Document Object Model) 구조 변경에 매우 취약하기 때문입니다.
예를 들어, 웹 디자이너가 UI를 개선하거나 개발자가 내부 구조를 리팩토링할 때, CSS 클래스명이나 요소 계층 구조가 변경되면 기존의 CSS 또는 XPath 로케이터는 더 이상 유효하지 않게 되어 테스트가 쉽게 실패하게 됩니다.
특히, 길고 복잡한 CSS 또는 XPath 체인은 불안정한 테스트로 이어지는 나쁜 사례로 꼽힙니다.
또한, XPath는 Shadow Root를 관통하지 못하며 닫힌 모드(Closed-mode) Shadow Root는 아예 지원되지 않는다는 기술적인 한계도 있습니다.
이는 웹 컴포넌트 기반의 최신 웹 애플리케이션에서 XPath의 유용성을 크게 저하시킵니다.
따라서 테스트 안정성을 높이는 최적의 사용 팁은 다음과 같습니다.
-
내장 로케이터 우선 사용: 앞서 소개된 `getByRole()`, `getByText()`, `getByLabel()` 등 Playwright의 내장 로케이터를 최우선으로 사용하십시오.
이들은 사용자 관점과 접근성 측면에서 요소를 식별하므로, DOM 구조의 사소한 변경에도 훨씬 더 탄력적입니다. -
`data-testid` 활용: 개발팀과 협력하여 웹 요소에 `data-testid`와 같은 테스트 전용 속성을 추가하는 것을 적극 권장합니다.
비록 이 속성이 사용자에게 직접 노출되지는 않지만, UI/UX 변경과 독립적으로 테스트 요소를 식별할 수 있는 가장 탄력적인 방법입니다.
`page.getByTestId()`를 사용하면 DOM 구조가 바뀌더라도 테스트 스크립트를 수정할 필요 없이 안정적으로 테스트를 유지할 수 있습니다. -
최소한의 CSS/XPath 사용: 부득이하게 CSS 또는 XPath를 사용해야 할 경우, 가능한 한 짧고 명확하며 특정 요소에만 고유하게 적용되는 선택자를 사용하십시오.
예를 들어, ID 속성(예: `#my-element`)이나 고유한 클래스(예: `.unique-class`)를 활용하는 것이 DOM 계층 구조에 깊이 의존하는 것보다 훨씬 안전합니다.
이러한 원칙들을 준수함으로써, 웹 자동화 테스트는 잦은 유지보수 없이도 높은 안정성과 신뢰성을 확보할 수 있으며, 이는 곧 개발 및 배포 과정의 효율성 증대로 이어집니다.
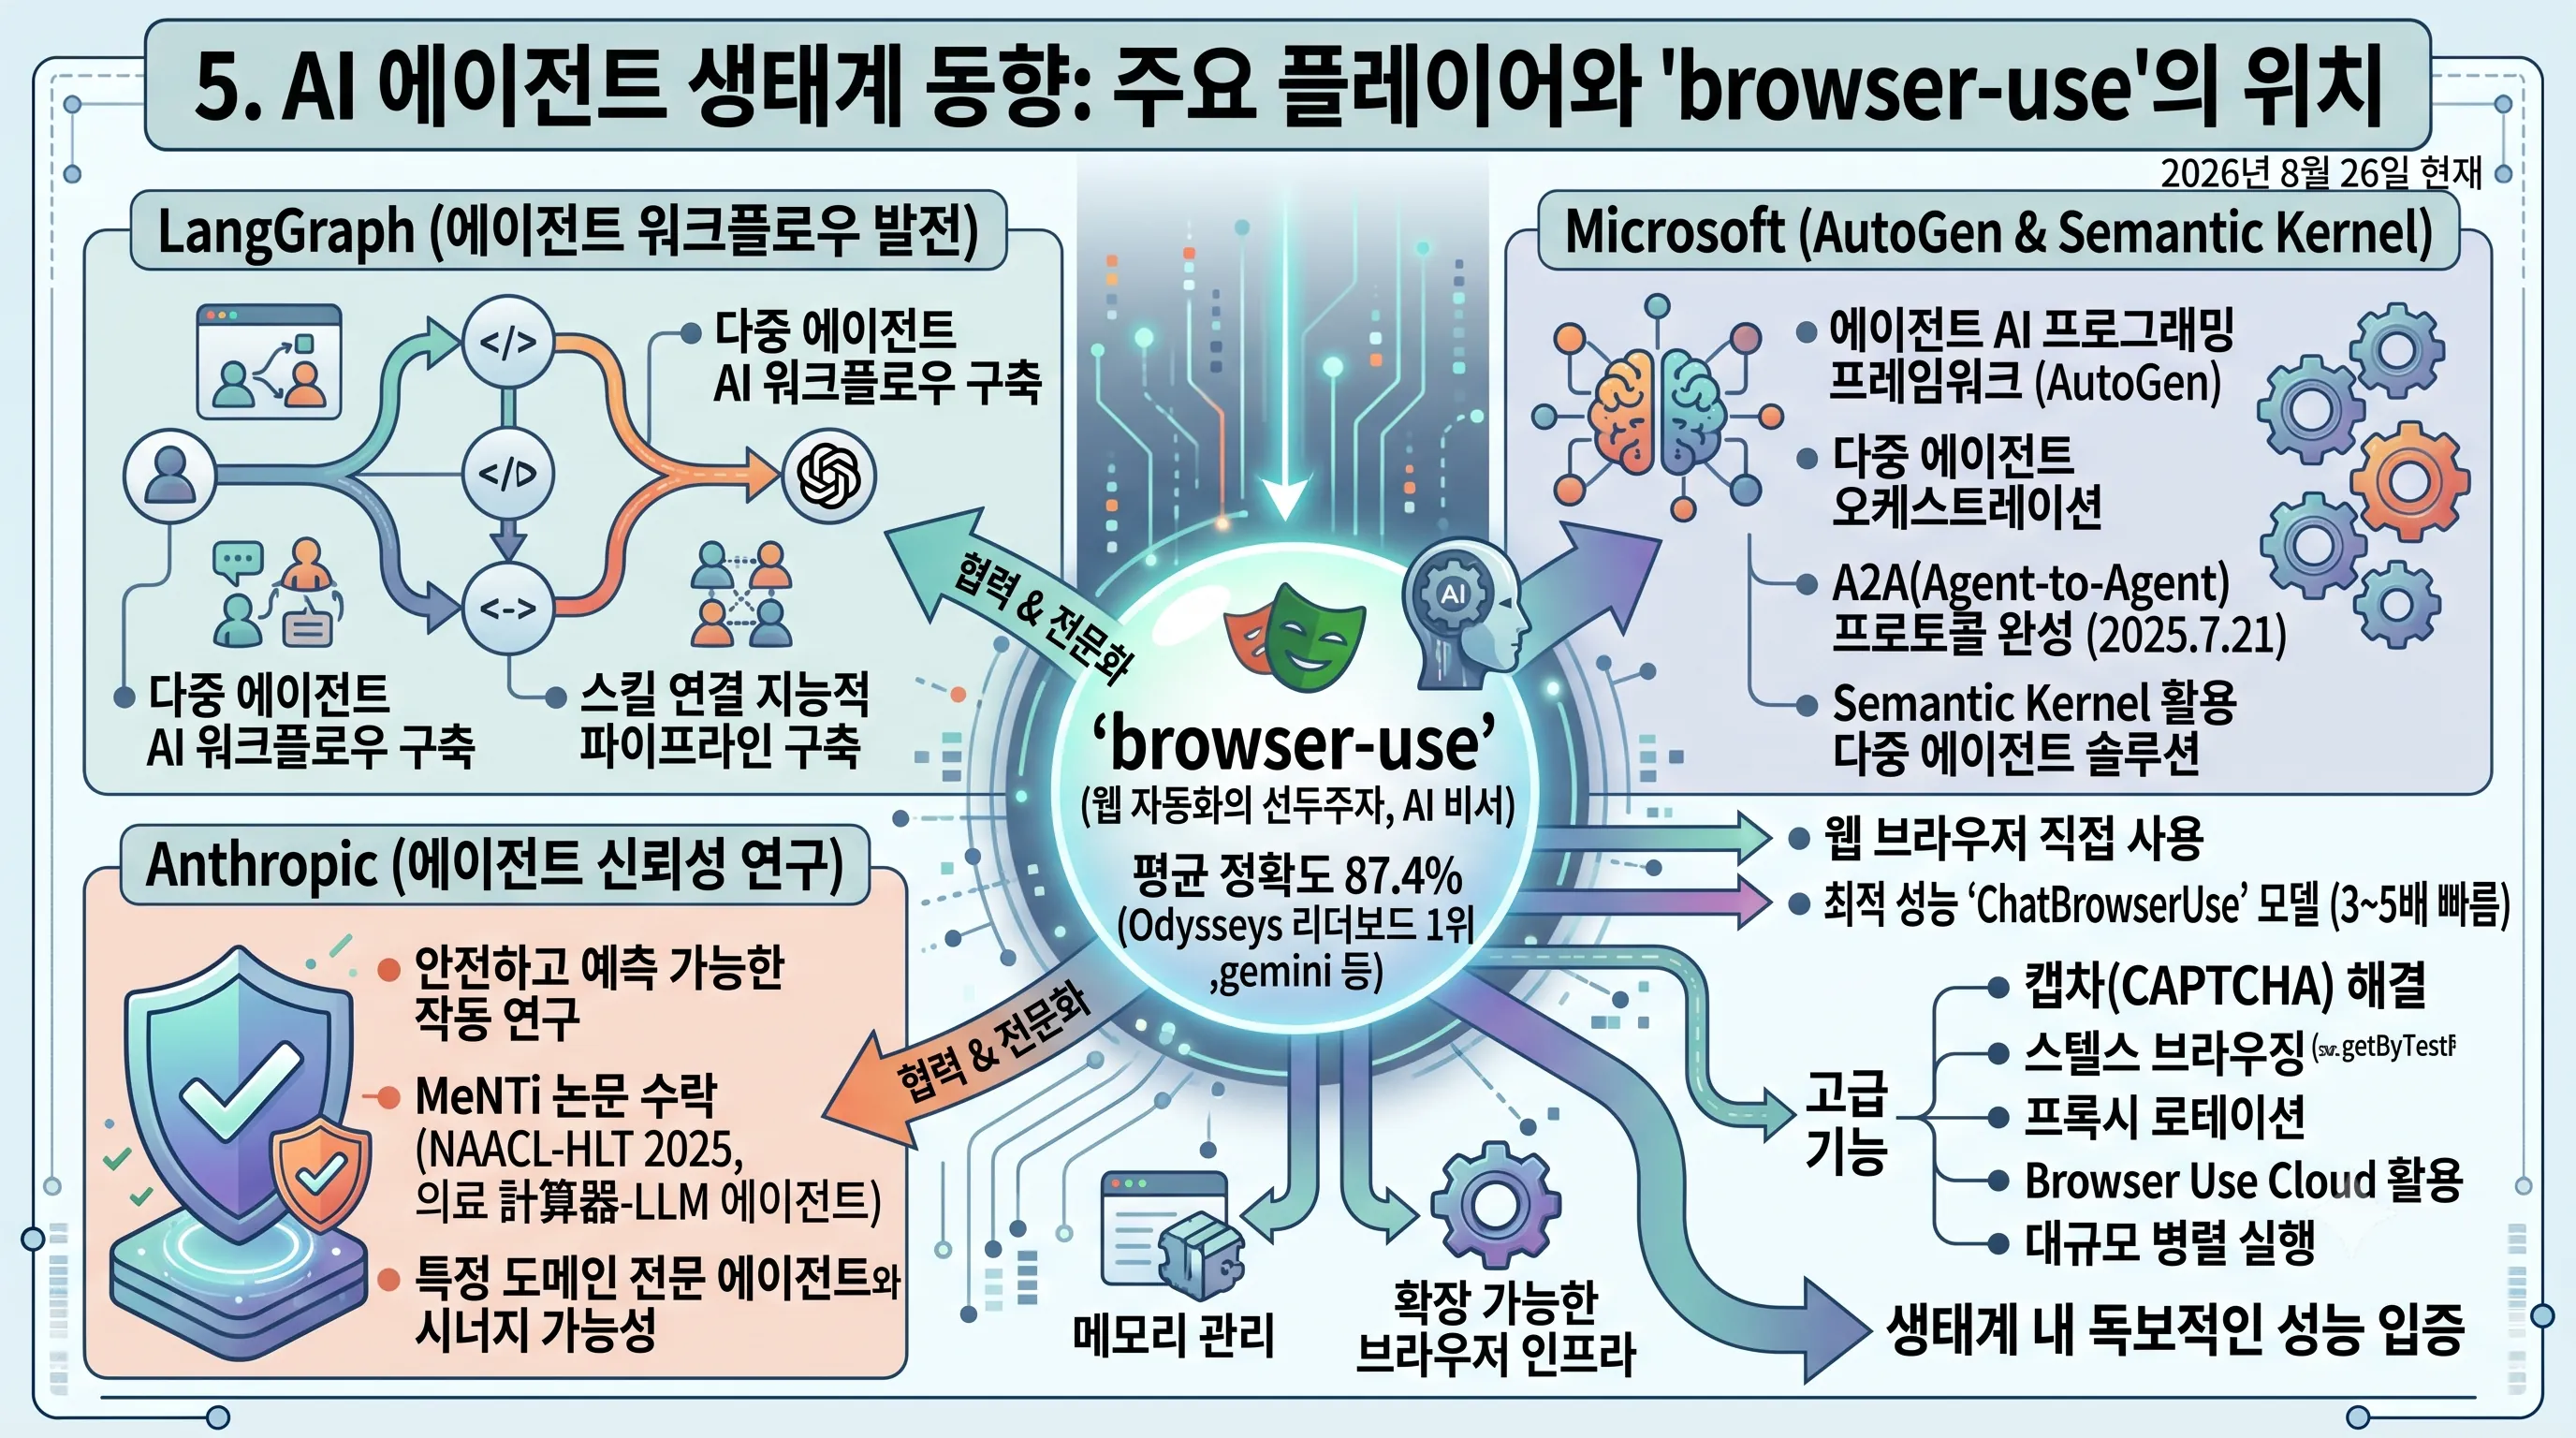
5. AI 에이전트 생태계 동향: Microsoft, Anthropic 등 주요 플레이어와 'browser-use'의 위치
AI 에이전트 생태계의 주요 동향과 'browser-use'의 위치
2026년 8월 26일 현재, 인공지능 에이전트 생태계는 빠르게 진화하고 있으며, 특히 웹 브라우저를 활용한 자동화 에이전트가 중요한 한 축을 담당하고 있습니다.
이 생태계는 단순히 단일 LLM(Large Language Model)의 성능을 넘어, 여러 에이전트가 협력하거나 특정 작업을 전문화하는 방향으로 발전하고 있습니다.
여기에는 Microsoft와 Anthropic 같은 거대 기술 기업의 프레임워크 및 연구 활동, 그리고 LangGraph와 같은 전문 도구들이 핵심적인 역할을 수행하고 있습니다.
웹 브라우저 자동화의 선두주자, 'browser-use'
'browser-use'는 Playwright와 LLM(Large Language Model)을 결합한 AI 비서 웹 자동화 에이전트로서, 현재 AI 에이전트 생태계에서 돋보이는 위치를 차지하고 있습니다.
이 에이전트는 웹 브라우저를 직접 사용하여 페이지 열기, 클릭, 타이핑, 폼 작성 등 실제 사용자와 유사한 방식으로 복잡한 웹 작업을 수행합니다.
특히 ChatBrowserUse 모델을 통해 브라우저 자동화에 최적화된 성능과 SOTA(State-of-the-Art) 정확도를 보여주며, 기존 방식 대비 3~5배 빠른 작업 완료 속도를 자랑합니다.
OpenAI(gpt-5.5, gpt-4o), Anthropic(claude-opus-4-8), Google(gemini-3-pro) 등 다양한 LLM 제공자를 지원하며, 로컬 모델 실행을 위한 Ollama도 활용 가능합니다.
이는 'browser-use'가 단순한 도구를 넘어, 여러 LLM 백엔드를 아우르는 유연한 플랫폼으로서 기능하고 있음을 시사합니다.
Microsoft의 다중 에이전트 프레임워크와 오케스트레이션
Microsoft는 AI 에이전트 생태계 확장에 적극적으로 기여하고 있습니다.
AutoGen은 개발자들이 다중 에이전트 시스템을 쉽게 구축할 수 있도록 돕는 에이전트 AI 프로그래밍 프레임워크로서, 에이전트 간의 대화와 협업을 통해 복잡한 작업을 해결하는 데 중점을 둡니다.
더 나아가 Microsoft는 Semantic Kernel을 통해 오케스트레이션 기능과 A2A(Agent-to-Agent) 프로토콜을 성공적으로 결합하여 다중 에이전트 솔루션 구축을 완료했습니다.
이 사실은 2025년 7월 21일 관련 블로그 발행을 통해 공식적으로 발표되었으며, 이는 에이전트들이 서로 복잡하게 상호작용하며 더 큰 가치를 창출하는 시대가 도래했음을 알리는 중요한 이정표가 되었습니다.
LangGraph와 에이전트 워크플로우의 발전
LangGraph는 다중 에이전트 AI 워크플로우를 구축하는 데 필수적인 도구로 자리매김했습니다.
이는 에이전트들이 순차적으로 또는 병렬적으로 작업을 처리하고, 조건에 따라 다음 단계를 결정하는 등 복잡한 논리 흐름을 구현할 수 있게 합니다.
'browser-use'와 같은 웹 자동화 에이전트가 특정 작업을 수행하는 '스킬' 역할을 한다면, LangGraph는 이러한 스킬들을 연결하여 더 크고 지능적인 자동화 파이프라인을 구축하는 데 기여합니다.
Anthropic의 에이전트 신뢰성 연구와 MeNTi 논문
Anthropic은 AI 에이전트 개발뿐만 아니라 에이전트 신뢰성 연구에도 깊이 관여하고 있습니다.
2024년 12월 19일 발행된 블로그를 통해 관련 활동과 연구 방향을 공유하며, 에이전트가 복잡한 환경에서 안전하고 예측 가능하게 작동하도록 하는 데 중요한 통찰력을 제공했습니다.
또한, 의료 분야 LLM 에이전트 연구에서도 주목할 만한 성과를 보였습니다.
'MeNTi' (의료 계산기와 LLM 에이전트 연결) 논문이 NAACL-HLT 2025에 수락 완료되었음이 2026년 7월 4일 확인되었습니다.
이는 LLM 에이전트가 전문적인 영역에서 실질적인 문제 해결 도구로 활용될 수 있음을 보여주는 사례로, 'browser-use'와 같은 범용 에이전트가 특정 도메인에 특화된 에이전트와 어떻게 상호작용하며 시너지를 낼 수 있을지에 대한 가능성을 제시합니다.
생태계 내 'browser-use'의 독보적인 성능
이러한 AI 에이전트 생태계의 복잡한 역학 속에서 'browser-use'는 Odysseys 리더보드 1위라는 인상적인 성과를 기록하며 그 능력을 입증했습니다.
평균 87.4%의 정확도로 OpenAI, Anthropic, Google, Microsoft 등 주요 기술 기업의 에이전트들을 능가하는 성능을 보여주었습니다.
이는 'browser-use'가 단순히 웹 자동화 기능을 제공하는 것을 넘어, 복잡한 웹 환경에서 캡차(CAPTCHA) 해결, 스텔스 브라우징, 확장 가능한 브라우저 인프라, 메모리 관리, 프록시 로테이션 등 고급 기능을 통해 최상급의 스텔스와 고성능 병렬 실행을 제공하는 강력한 솔루션임을 의미합니다.
특히 Browser Use Cloud를 통해 제공되는 이러한 기능들은 오픈소스 환경의 한계를 극복하고 대규모 웹 자동화 작업의 효율성을 극대화합니다.
관련 글