LLM 성능, 이제 '감' 아닌 '데이터'로! G-Eval & Ragas 분석
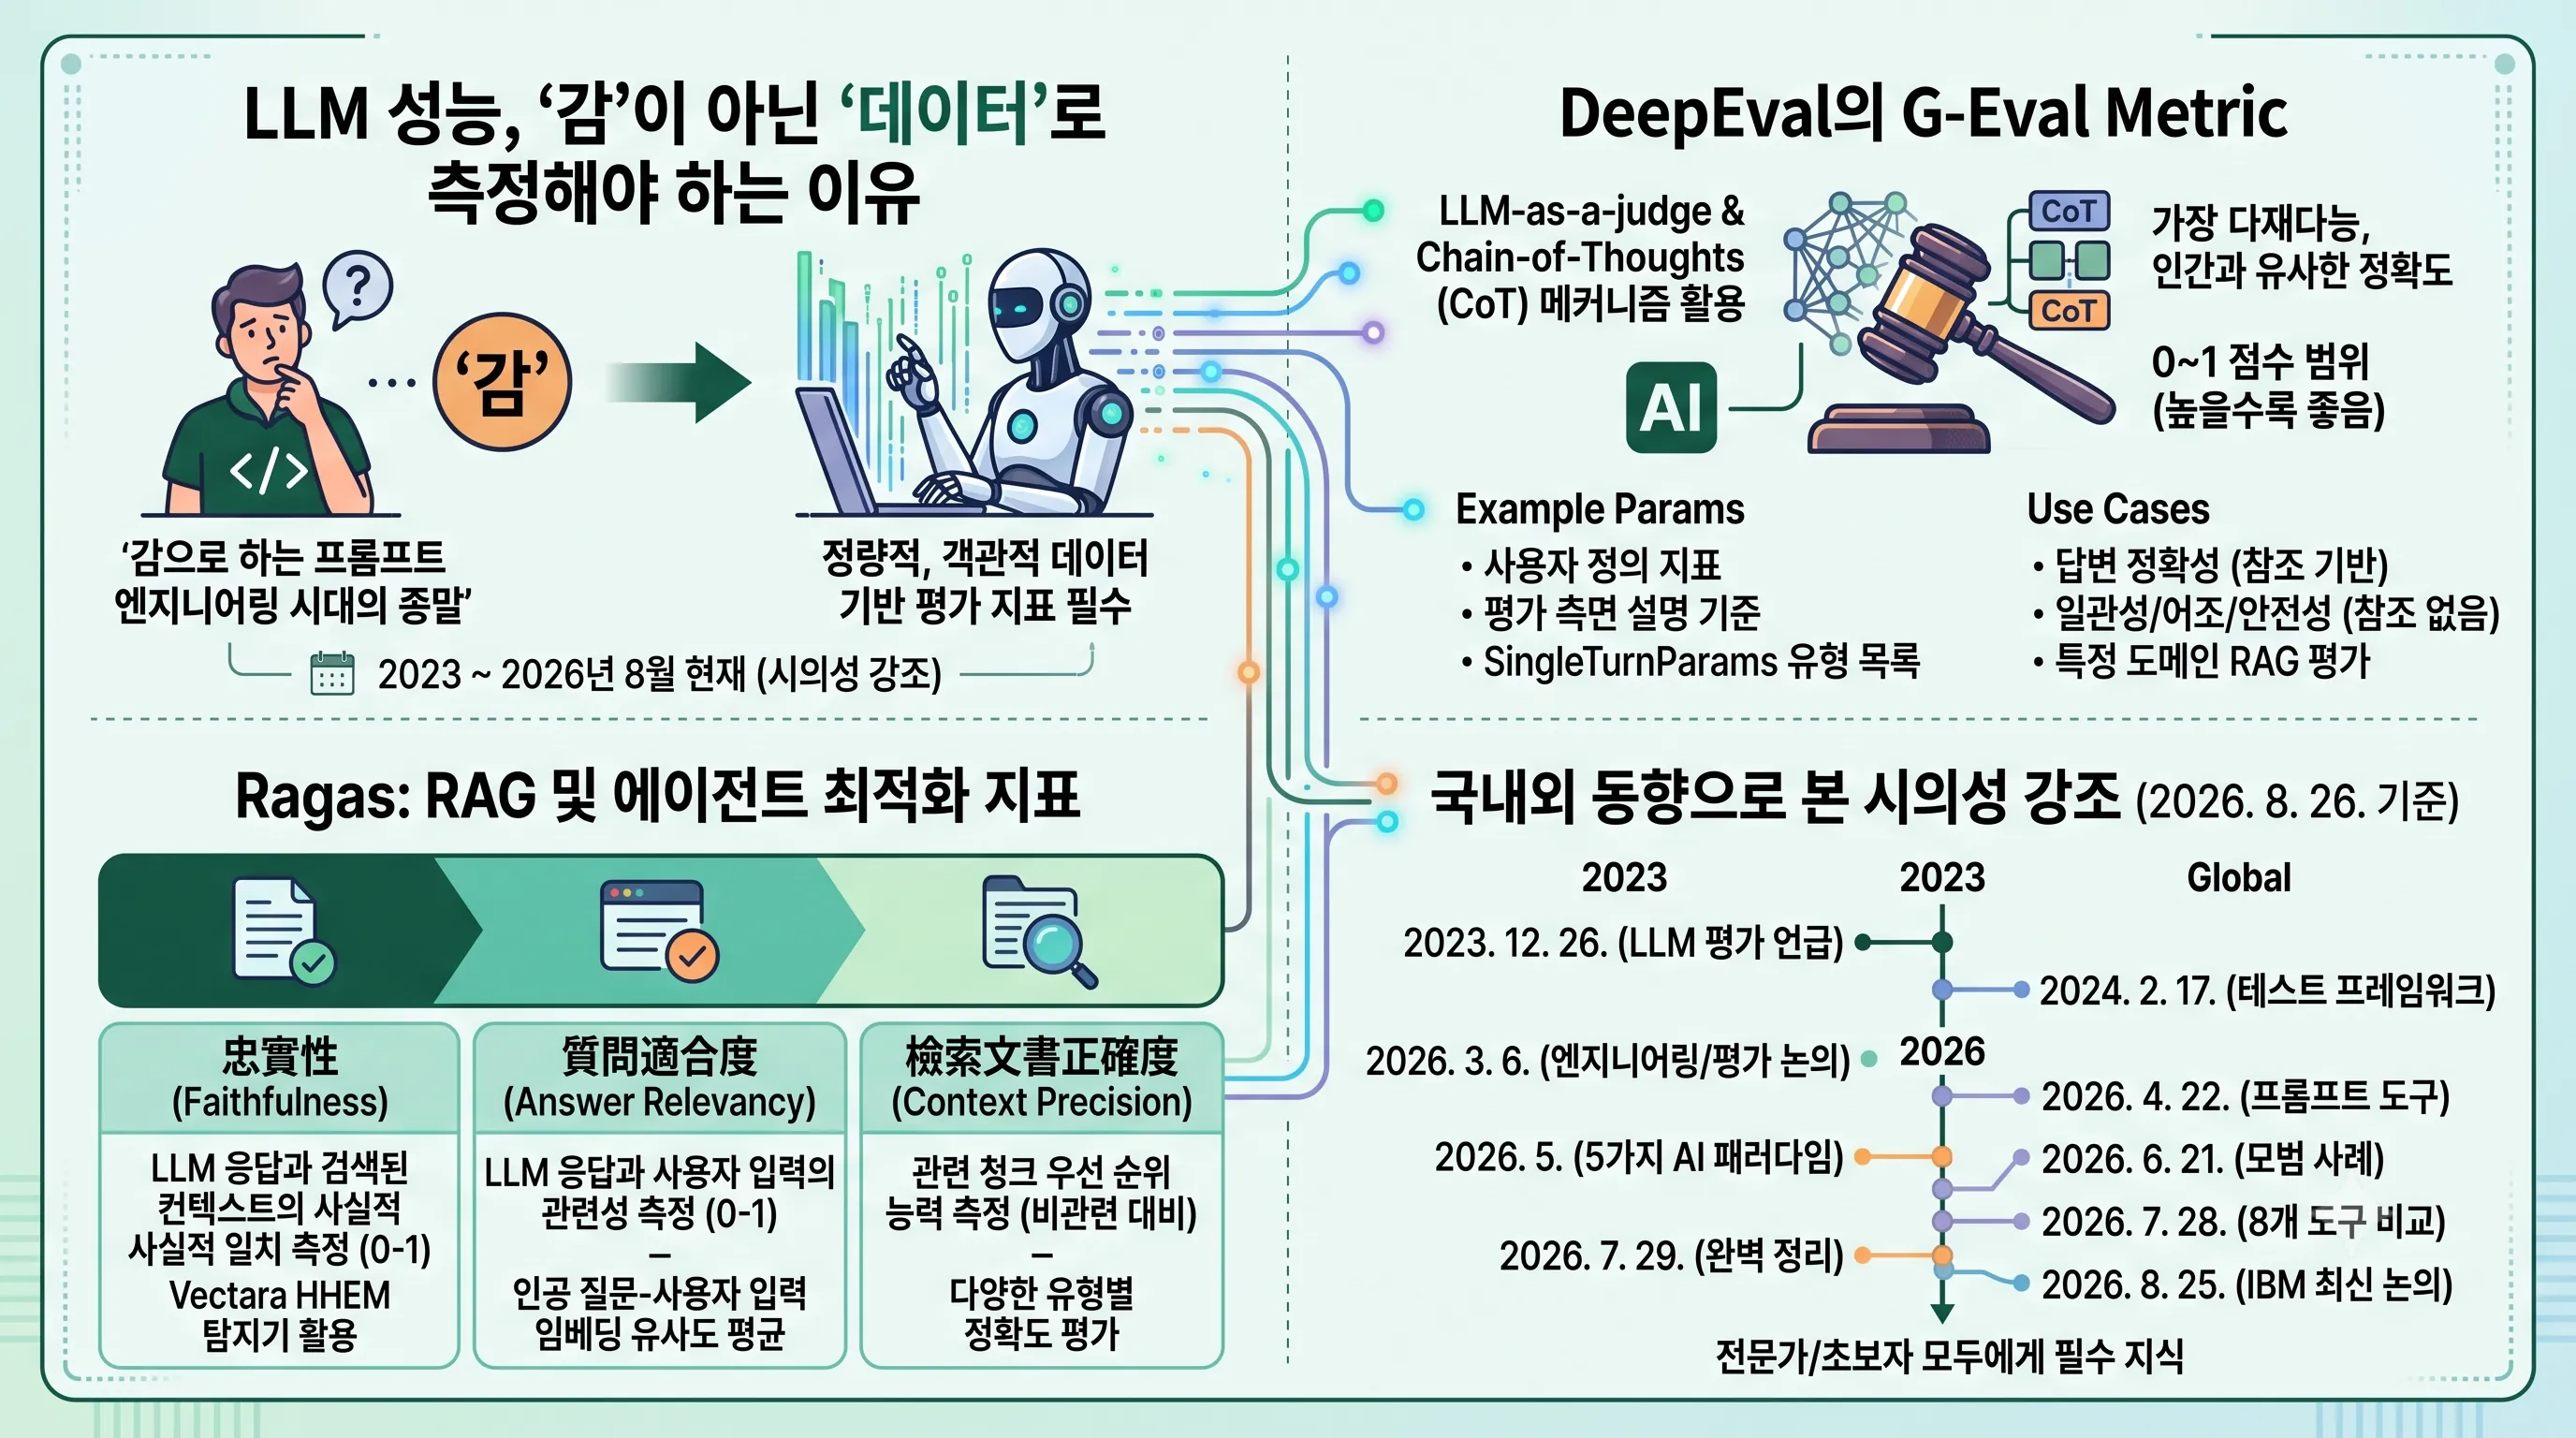
- LLM 성능 평가는 이제 '감'이 아닌 정량적이고 객관적인 데이터 기반 지표가 필수적입니다.
- 주요 LLM 평가 프레임워크로는 DeepEval G-Eval과 Ragas가 있습니다.
- DeepEval G-Eval은 LLM-as-a-judge와 Chain-of-Thoughts(CoT) 메커니즘을 활용하여 인간과 유사한 정확도를 제공하며, 답변 정확성, 일관성, 어조, 안전성, 사용자 정의 RAG 평가 등 광범위한 시나리오에 적용됩니다.
- G-Eval의 점수 일관성 문제는 명시적인
evaluation_steps제공,rubric(점수 범위 0-10 제한),strict_mode(1 또는 0의 이진 점수)를 통해 해결할 수 있습니다. - Ragas는 특히 검색 증강 생성(RAG) 및 에이전트 워크플로우에 최적화된 평가 프레임워크로, 핵심 지표는 충실성(Faithfulness), 질문 적합도(Answer Relevancy), 검색 문서 정확도(Context Precision)입니다.
- 충실성 지표는 LLM 응답이 검색된 컨텍스트와 얼마나 사실적으로 일치하는지 (환각 현상) 측정하며, FaithfulnesswithHHEM은 Vectara의 HHEM-2.1-Open 모델을 활용합니다.
- 질문 적합도 지표는 LLM 응답이 사용자 입력에 얼마나 관련성이 있는지 측정하며, 응답의 사실적 정확도를 평가하지 않고 코사인 유사도로 계산됩니다.
- 검색 문서 정확도 지표는 검색기가 주어진 쿼리에 대해 관련 청크를 비관련 청크보다 높게 순위 매기는 능력을 측정하며, ContextPrecision, ContextUtilization 등 6가지 유형이 있습니다.
- Ragas의 레거시 Metrics API는 버전 0.4에서 폐기 예정이며, 버전 1.0에서는 완전히 제거될 예정이므로 컬렉션 기반 API로의 마이그레이션이 권장됩니다.
- 이러한 정량적 평가 지표의 중요성은 2023년부터 2026년 8월 26일 현재까지 국내외에서 활발하게 논의되고 있는 최전선의 과제입니다.
1. LLM 성능, '감'이 아닌 '데이터'로 측정해야 하는 이유
인공지능(AI) 기술, 특히 대규모 언어 모델(LLM) 분야의 폭발적인 발전은 이제 '감(感)으로 하는 프롬프트 엔지니어링' 시대의 종말을 고하고 있습니다.
2010년대 후반부터 본격적으로 개발되어 2020년대에 들어서면서 급부상한 LLM들은 이제 단순한 실험 단계를 넘어 다양한 산업과 일상생활에 깊숙이 침투하며 핵심적인 역할을 수행하고 있습니다.
이러한 발전 속에서, LLM의 성능을 측정하고 개선하는 방식 역시 과거의 비정량적인 접근 방식을 탈피하여 정량적이고 객관적인 데이터 기반의 평가 지표를 필수적으로 요구하게 되었습니다.
최근 국내외 자료 출처 시점을 보면 2023년부터 2026년 8월 현재까지 이 주제가 얼마나 시의적절하고 중요한지 명확히 드러나고 있습니다.
이에 따라, 정량적 평가 지표 세팅 가이드가 제공되며, LLM 애플리케이션의 성능을 명확하게 이해하고 최적화하기 위한 노력이 가속화되고 있습니다.
'감'의 시대를 넘어선 LLM 평가의 필요성
과거에는 프롬프트 엔지니어링이나 LLM 모델의 성능을 평가할 때 개발자나 사용자의 '감' 또는 제한적인 수동 테스트에 의존하는 경향이 있었습니다.
하지만 LLM들이 "유명세를 얻으며" 다양한 사용 사례에서 복잡한 작업을 수행하게 되면서, 이러한 주관적인 평가는 더 이상 효과적이지 않다는 사실이 명백해졌습니다.
2026년 5월 기준으로 5가지 AI 모델 패러다임이 확인될 정도로 AI 모델의 복잡성과 다양성은 증가했으며, 2026년 7월 28일 기준으로는 이미 8개의 프롬프트 실험 도구가 비교될 정도로 평가 환경 역시 고도화되었습니다.
이처럼 급변하는 환경 속에서, LLM의 답변 품질, 일관성, 정확성, 안전성 등을 객관적으로 측정하고 비교하기 위한 표준화된 정량적 지표의 도입은 선택이 아닌 필수가 되었습니다.
DeepEval의 G-Eval: 인간과 유사한 평가의 새로운 기준
정량적 LLM 평가 지표의 선두 주자 중 하나는 DeepEval의 G-Eval Metric입니다.
이 지표는 'LLM-as-a-judge(평가자 LLM)' 접근 방식과 Chain-of-Thoughts(CoT) 메커니즘을 활용하여, 특정 사용자 정의 기준에 기반해 LLM 출력을 평가하는 혁신적인 프레임워크입니다.
G-Eval은 'NLG Evaluation using GPT-4 with Better Human Alignment' 논문에서 기원했으며, 가장 다재다능하며 인간과 유사한 정확도를 제공하여 전통적인 비LLM 평가 방식을 능가하는 것으로 평가받고 있습니다.
점수 범위는 0-1로, 높을수록 좋으며, 임계값(threshold)을 설정하여 통과 여부를 결정할 수 있습니다.
예를 들어, 사용자 정의 지표 이름(name), 특정 평가 측면을 설명하는 기준(criteria), 평가에 관련된 SingleTurnParams 유형의 목록(evaluation_params)과 같은 필수 매개변수를 통해 유연하게 설정할 수 있습니다.
또한, 명시적인 evaluation_steps를 제공하거나 rubric 또는 strict_mode를 추가하여 G-Eval 점수의 일관성 부족이라는 잠재적 제한 사항을 해결할 수 있습니다.
G-Eval은 답변 정확성(참조 기반), 일관성(참조 없음, 예: 명확성), 어조(참조 없음, 예: 전문성), 안전성(예: PII 유출 방지), 그리고 특정 도메인(예: 의료 분야 RAG에서 환각에 대한 높은 페널티 부여)에서의 사용자 정의 RAG 평가 등 매우 광범위한 사용 사례에 적용될 수 있습니다.
Ragas: RAG 및 에이전트 워크플로우에 최적화된 지표
또 다른 중요한 평가 프레임워크는 Ragas입니다.
Ragas는 특히 검색 증강 생성(RAG) 및 에이전트 워크플로우와 같은 다양한 LLM 애플리케이션의 성능을 측정하기 위한 포괄적인 평가 지표를 제공합니다.
핵심적인 Ragas 지표로는 충실성(Faithfulness), 질문 적합도(Answer Relevancy), 검색 문서 정확도(Context Precision)가 있습니다.
충실성 (Faithfulness)
충실성 지표는 LLM 응답이 검색된 컨텍스트와 얼마나 사실적으로 일치하는지를 측정합니다.
점수 범위는 0에서 1까지이며, 높을수록 응답의 모든 주장이 검색된 컨텍스트에 의해 뒷받침됨을 의미합니다.
이 지표는 응답 내의 주장을 식별하고, 각 주장이 검색된 컨텍스트로부터 추론 가능한지 확인함으로써 계산됩니다.
특히, FaithfulnesswithHHEM 옵션을 사용하면 Vectara의 HHEM-2.1-Open 모델(환각 탐지 T5 분류기)을 활용하여 LLM의 환각(Hallucination) 현상을 더욱 정교하게 탐지할 수 있습니다.
질문 적합도 (Answer Relevancy)
질문 적합도 지표는 LLM 응답이 사용자 입력에 얼마나 관련성이 있는지를 측정합니다.
이 지표 역시 일반적으로 0에서 1 사이의 값을 가지며, 높을수록 응답이 사용자 입력과 잘 정렬되어 있음을 나타냅니다.
원래 질문의 의도에 직접적이고 적절하게 부합하는 응답에 높은 점수를 부여하고, 불완전하거나 불필요한 세부 사항에 대해서는 페널티를 부과합니다.
흥미로운 점은 이 지표가 응답의 사실적 정확도를 평가하지 않으며, 응답 기반으로 인공 질문(기본 3개)을 생성한 후 사용자 입력 임베딩과의 코사인 유사도 평균을 산출하여 계산된다는 것입니다.
검색 문서 정확도 (Context Precision)
검색 문서 정확도 지표는 검색기가 주어진 쿼리에 대해 검색된 컨텍스트에서 관련 청크를 비관련 청크보다 높게 순위 매기는 능력을 측정합니다.
이는 컨텍스트 내 각 청크에 대한 precision@k의 평균으로 계산되며, ContextPrecision(참조 답변 있을 때), ContextUtilization(참조 답변 없고 생성 응답 있을 때), LLMContextPrecisionWithoutReference/WithReference, NonLLMContextPrecisionWithReference, IDBasedContextPrecision 등 다양한 유형으로 나뉩니다.
이 지표는 RAG 시스템에서 검색 모듈의 효율성을 평가하는 데 매우 중요합니다.
Ragas는 'evaluate' 함수를 사용하여 충실성, 질문 적합도, 검색 문서 정확도 등의 지표로 LLM 평가를 수행하며, 질문, 모델 답변, 참고 문서, 정답 기준을 포함하는 데이터셋을 활용할 수 있습니다.
다만, Ragas의 레거시 Metrics API는 버전 0.4에서 Deprecated 예정이며, 버전 1.0에서는 완전히 제거될 예정이므로, 컬렉션 기반 API로의 마이그레이션이 권장됩니다.
국내외 동향으로 본 시의성 강조
정량적 LLM 평가 지표의 중요성은 최근 국내외에서 쏟아져 나오는 관련 자료들을 통해 더욱 강조됩니다.
오늘 날짜인 2026년 8월 26일을 기준으로, 이 주제는 지속적으로 논의되고 심층적으로 다루어지고 있습니다.
국내에서는 이미 2023년 12월 26일 한 블로그(blog.naver.com/klovex2)에서 LLM 평가의 중요성이 언급되었으며, 2026년 3월 6일(orbanisltd.tistory.com)과 2026년 5월(sieos.tistory.com)에는 프롬프트 엔지니어링 및 LLM 평가 방법에 대한 구체적인 논의가 이루어졌습니다.
특히 2026년 7월 29일 나무위키 자료에서는 LLM 테스트 및 평가 프레임워크에 대한 정보가 '완벽 정리'되어 게재되었습니다.
해외에서는 더욱 활발한 논의가 진행되어, 2024년 2월 17일(blog-ko.engram.us)부터 LLM 테스트 프레임워크에 대한 소개가 시작되었고, 2026년 4월 22일(sureprompts.com)에는 프롬프트 평가 도구에 대한 논의가 있었습니다.
2026년 6월 21일(braintrust.dev)에는 LLM 평가의 모범 사례가 제시되었으며, 2026년 7월 20일(testomat.io)과 2026년 7월 28일(confident-ai.com)에는 각각 'Top LLM Testing Frameworks & Tools'와 'Best Prompt Evaluation Tools'에 대한 포괄적인 가이드가 발행되었습니다.
가장 최근에는 2026년 8월 25일, 즉 불과 하루 전 IBM의 스니펫에서도 LLM 평가의 중요성을 다루는 등, 이 분야의 연구와 실제 적용은 현재 진행형이자 최전선의 과제로 인식되고 있습니다.
이러한 자료들은 '최고의 LLM 사용 사례', '쉽게 이해하는 초보자 가이드', '완벽 정리' 등의 표현에서 알 수 있듯이, LLM 평가가 전문가와 초보자 모두에게 필수적인 지식이 되었음을 시사합니다.
2. '인간처럼 평가' DeepEval G-Eval 핵심 기능 분석
대규모 언어 모델(LLM)의 성능을 정교하게 평가하기 위한 도구 중, 인간의 판단과 유사한 정확도를 제공하는 지표로 DeepEval의 G-Eval이 주목받고 있습니다.
이는 특히 주관적이며 특정 사용 사례에 최적화된 평가가 필요할 때 그 진가를 발휘합니다.
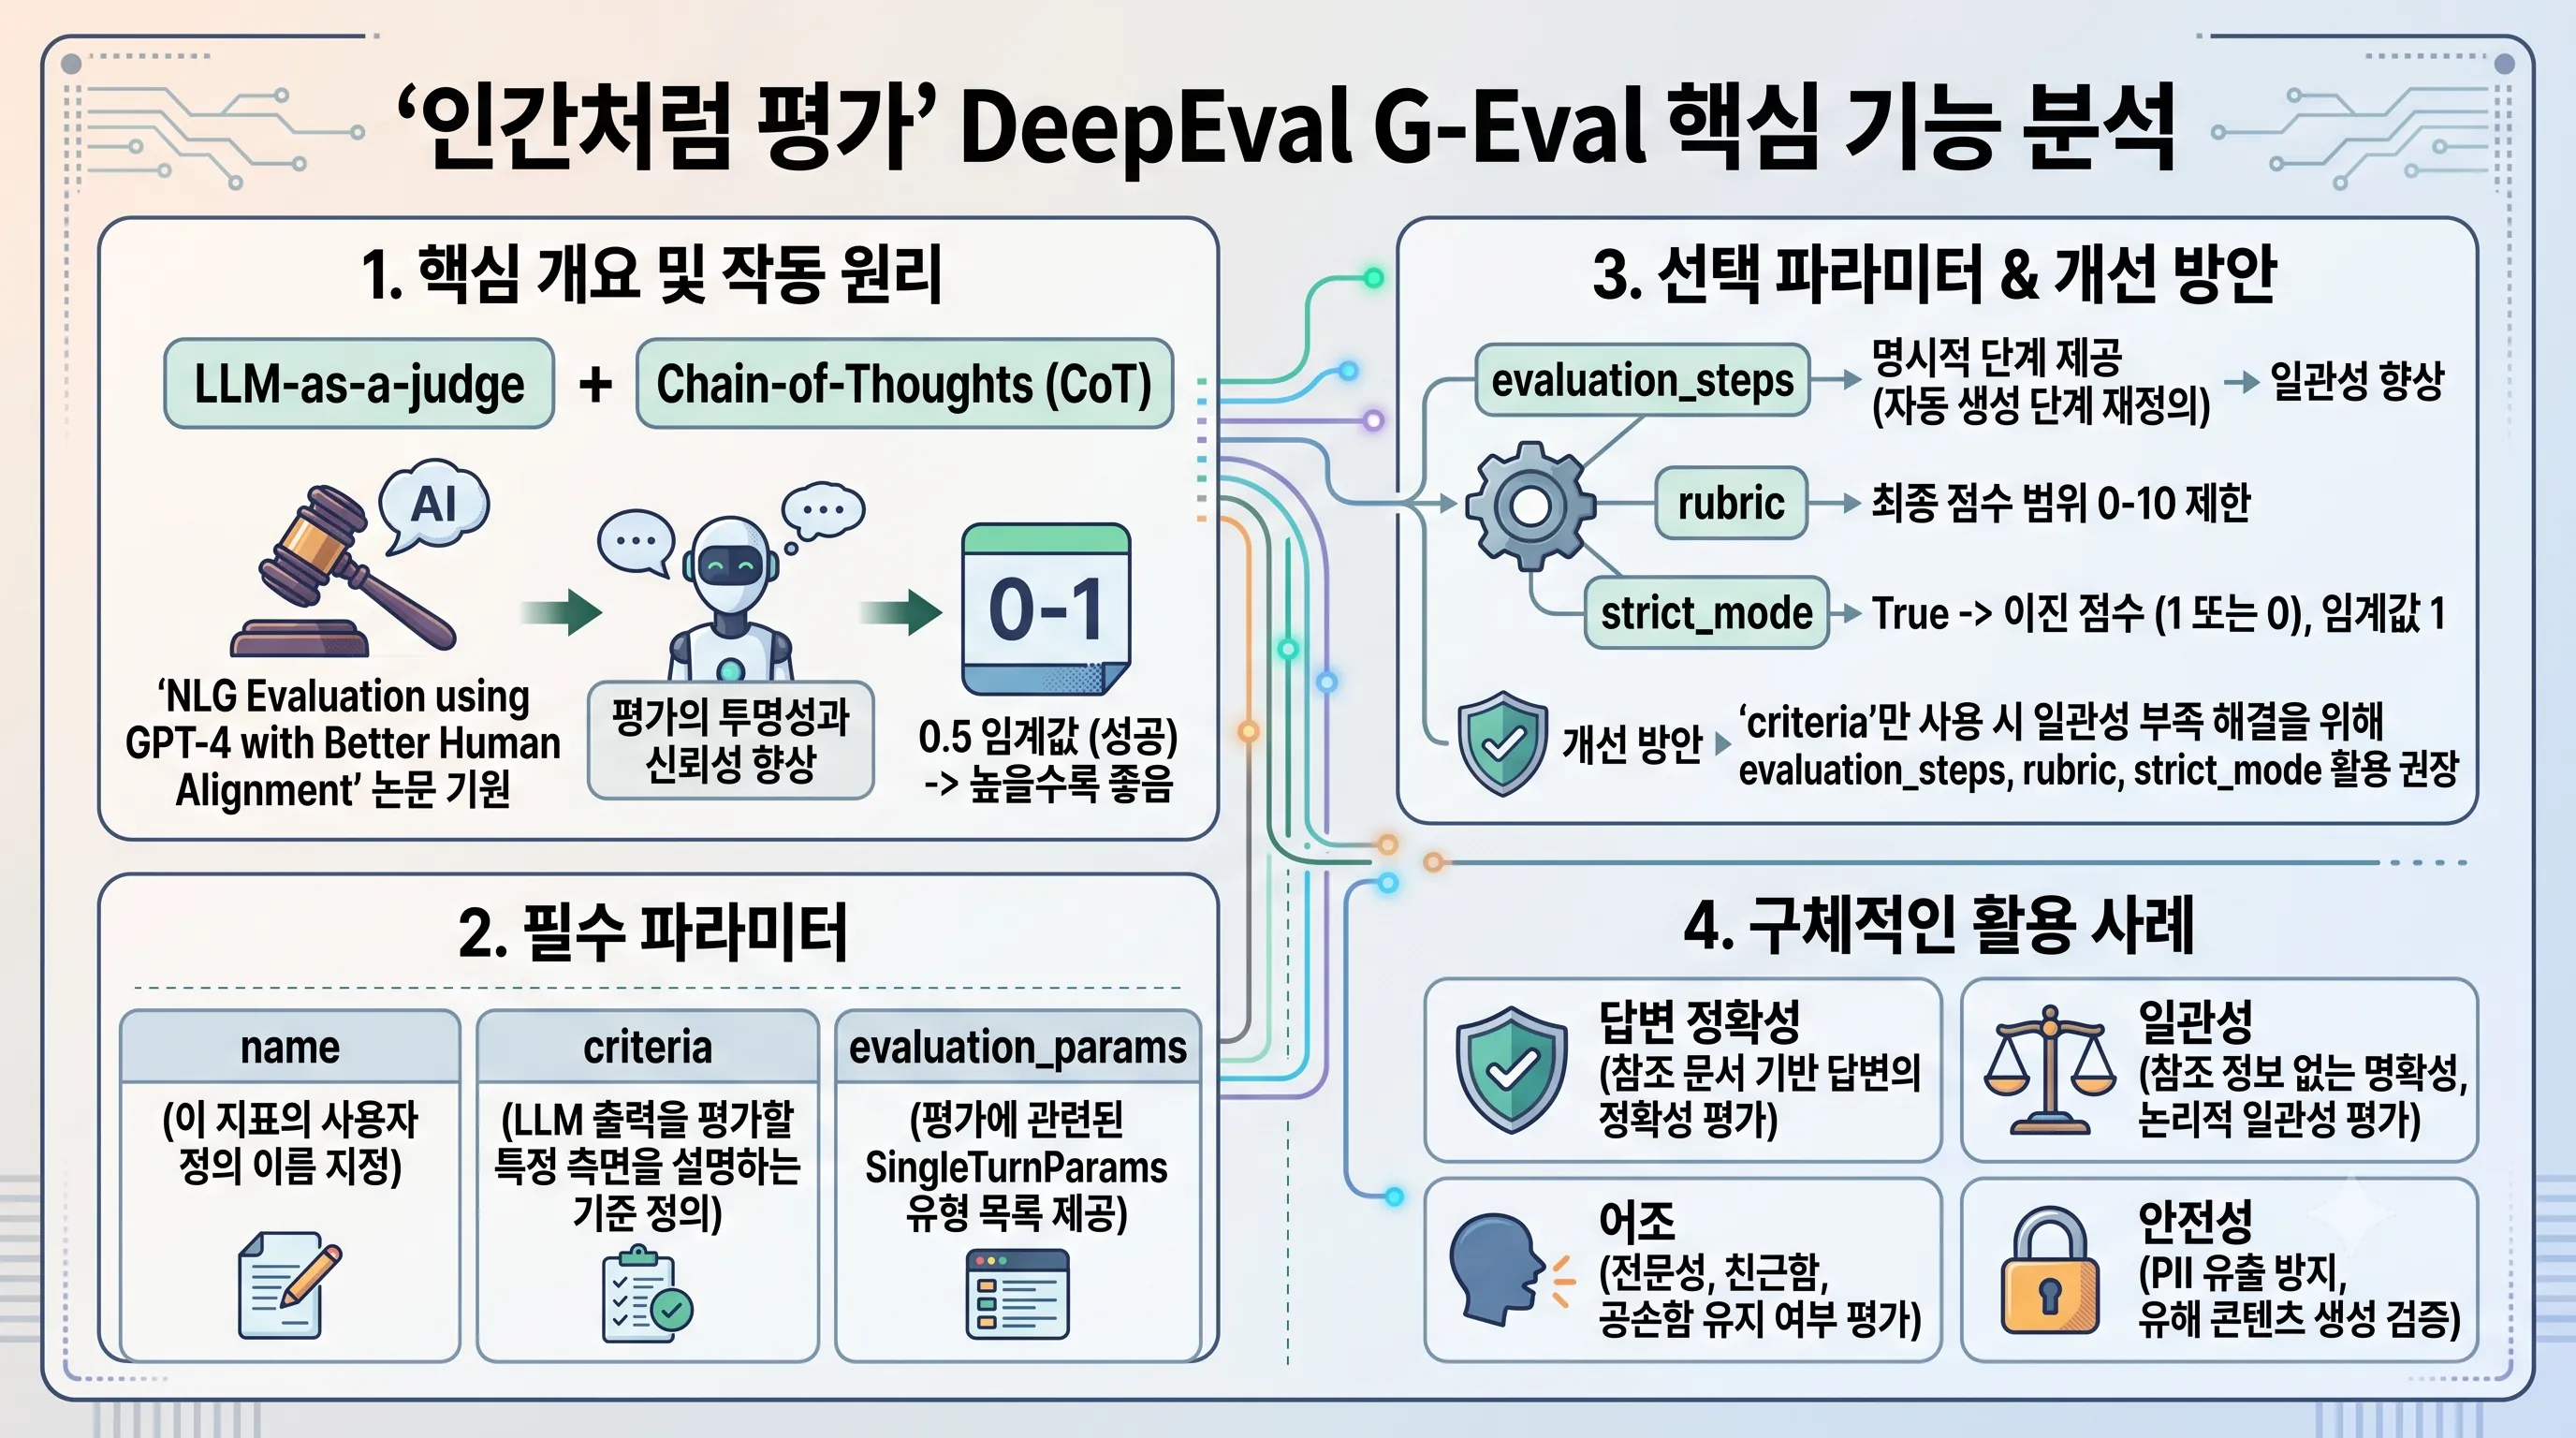
DeepEval G-Eval의 핵심 개요 및 작동 원리
DeepEval G-Eval은 LLM-as-a-judge와 Chain-of-Thoughts(CoT)를 핵심 메커니즘으로 활용하는 혁신적인 프레임워크입니다.
이 프레임워크는 어떤 사용자 정의 기준에 기반하여 LLM의 출력을 평가하도록 설계되었으며, 그 유연성과 정확성 덕분에 '가장 다재다능하며 인간과 유사한 정확도를 제공한다'는 평가를 받고 있습니다.
실제로 전통적인 비LLM 평가 방식을 능가하는 성능을 보인다고 알려져 있습니다.
이러한 접근 방식은 'NLG Evaluation using GPT-4 with Better Human Alignment' 논문에서 기원한 것으로, 오늘날 LLM 평가의 새로운 표준을 제시하고 있습니다.
평가 메커니즘: LLM-as-a-judge와 CoT
DeepEval G-Eval의 평가 방식은 LLM 스스로가 또 다른 LLM의 출력을 심사하는 LLM-as-a-judge 패러다임을 따릅니다.
여기에 CoT(Chain-of-Thoughts) 기법이 결합되어, 평가 LLM이 단순히 점수만 내는 것이 아니라 그 점수에 도달하기까지의 사고 과정을 명확하게 보여줍니다.
이러한 방식은 평가의 투명성과 신뢰성을 크게 향상시킵니다.
G-Eval의 점수 범위는 0에서 1 사이이며, 점수가 높을수록 더 좋은 성능을 의미합니다.
사용자는 특정 임계값(threshold)을 설정하여 이 값 이상일 때 '성공'으로 간주하도록 할 수 있습니다.
G-Eval의 구체적인 활용 사례
DeepEval G-Eval은 다양한 평가 시나리오에 적용될 수 있는 매우 유연한 지표입니다.
대표적인 활용 사례는 다음과 같습니다.
답변 정확성: 특정 참조 문서나 정보를 기반으로 LLM 답변의 정확성을 평가합니다.
일관성: 참조 정보가 없는 상황에서도 LLM 답변의 명확성이나 논리적 일관성을 평가합니다.
어조: 답변의 전문성, 친근함, 공손함 등 특정 어조 유지 여부를 평가합니다.
안전성: 개인 식별 정보(PII) 유출 방지나 유해 콘텐츠 생성 여부와 같은 LLM 답변의 안전성을 검증합니다.
사용자 정의 RAG: 특정 도메인, 예를 들어 의료 분야에서 환각(hallucination)에 대해 더 높은 페널티를 부여하는 등, 산업별 맞춤형 RAG(Retrieval Augmented Generation) 평가 기준을 적용할 수 있습니다.
필수 및 선택 파라미터 상세 분석
DeepEval G-Eval 지표를 인스턴스화할 때에는 몇 가지 필수 파라미터와 주요 선택 파라미터를 이해하는 것이 중요합니다.
필수 파라미터:
| 파라미터 | 설명 |
|---|---|
name |
이 지표의 사용자 정의 이름을 지정합니다. |
criteria |
LLM 출력을 평가할 특정 측면을 설명하는 기준을 정의합니다. |
evaluation_params |
평가에 관련된 SingleTurnParams 유형의 목록을 제공하여, 평가의 컨텍스트를 상세히 설정합니다. |
주요 선택 파라미터:
| 파라미터 | 설명 | 기본값/범위 |
|---|---|---|
evaluation_steps |
LLM이 평가를 수행할 때 따라야 할 구체적인 단계를 명시합니다. 이것이 제공되지 않으면 criteria에 기반하여 단계가 자동으로 생성됩니다. |
자동 생성 |
rubric |
최종 지표 점수 범위를 0-10 사이로 제한할 수 있습니다. 이는 점수의 스케일을 조절하는 데 유용합니다. | - |
threshold |
통과 여부를 결정하는 임계값입니다. None으로 설정하면 점수만 제공하는 score-only 모드로 작동합니다. |
0.5 |
model |
평가를 수행할 LLM 모델을 지정합니다. OpenAI GPT 모델이나 DeepEvalBaseLLM을 사용할 수 있습니다. | gpt-5.4 |
strict_mode |
True로 설정하면 점수가 이진 점수(1 또는 0)로만 반환되며, 임계값은 자동으로 1로 재정의됩니다. |
False |
async_mode |
measure() 메서드 내에서 비동기 동시 실행을 가능하게 할지 여부를 결정합니다. |
True |
evaluation_template |
기본 프롬프트를 재정의하여 평가 LLM에게 전달될 지침을 사용자가 직접 제어할 수 있습니다. | - |
G-Eval의 장점과 한계 및 개선 방안
DeepEval G-Eval은 그 강력한 기능과 인간과 유사한 평가 능력으로 LLM 개발에 필수적인 도구로 자리매김했습니다.
모든 지표 점수는 높을수록 좋다는 통일된 원칙을 따르며, 이는 사용자가 평가 결과를 직관적으로 이해하는 데 도움을 줍니다.
그러나 criteria만 사용하는 경우 G-Eval 점수의 일관성이 부족할 수 있다는 한계도 존재합니다.
이는 실행마다 CoT 단계가 재생성되기 때문입니다.
이러한 문제를 해결하기 위해 DeepEval은 명시적인 evaluation_steps를 제공하거나, rubric 또는 strict_mode와 같은 추가 파라미터를 활용하여 평가의 일관성과 신뢰도를 높일 것을 권장합니다.
3. RAG 시스템 평가 전문 프레임워크, Ragas 주요 지표 3가지
대규모 언어 모델(LLM) 기반 애플리케이션, 특히 검색 증강 생성(RAG) 시스템의 성능을 정량적으로 평가하기 위한 전문 프레임워크인 Ragas는 개발자들이 모델의 신뢰성과 효율성을 측정할 수 있도록 다양한 평가 지표를 제공합니다.
이 프레임워크는 RAG 시스템은 물론, 에이전트 워크플로우 등 다양한 LLM 애플리케이션 및 작업에 폭넓게 활용되고 있습니다.
Ragas가 제공하는 여러 지표 중 RAG 시스템의 핵심 성능을 진단하는 세 가지 주요 지표는 다음과 같습니다.
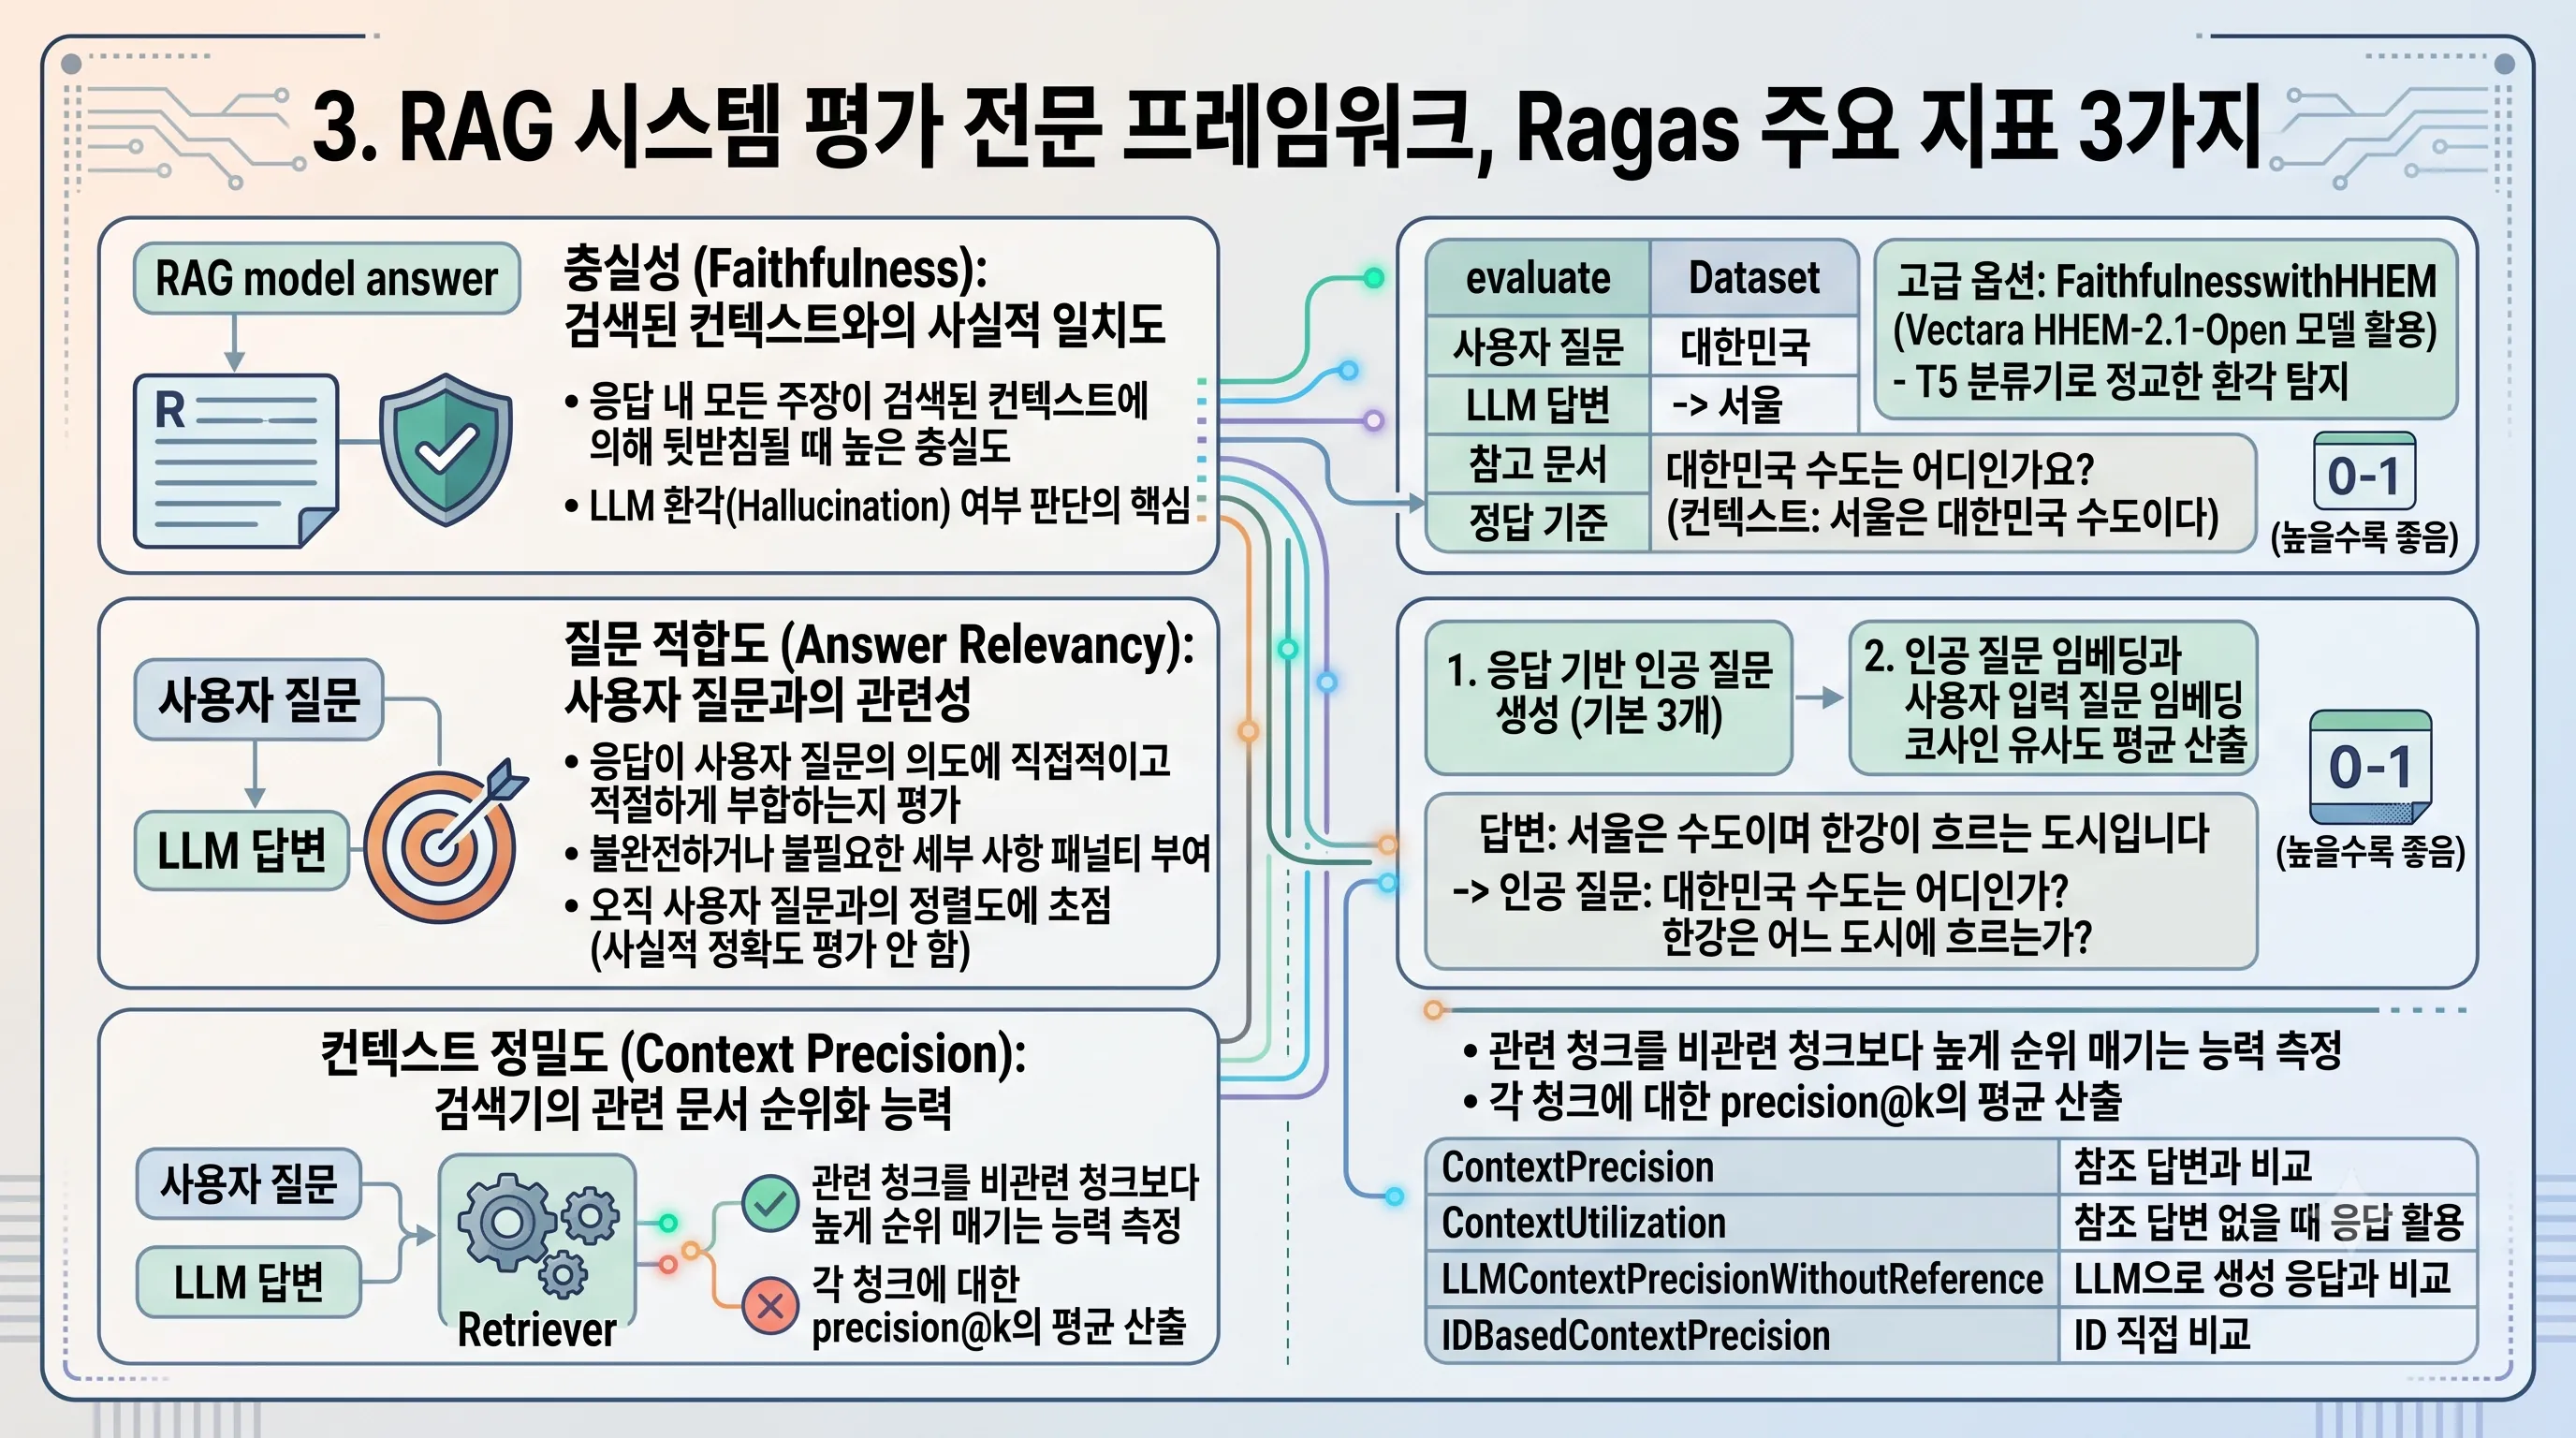
1. Faithfulness (충실성): 검색된 컨텍스트와의 사실적 일치도
Faithfulness(충실성) 지표는 LLM 응답이 검색된 컨텍스트(retrieved context)와 얼마나 사실적으로 일치하는지를 측정합니다.
이 지표는 응답 내의 모든 주장이 검색된 컨텍스트에 의해 뒷받침될 때 높은 충실도를 가진다고 간주합니다.
점수 범위는 0에서 1 사이이며, 점수가 높을수록 응답이 검색된 정보에 더 충실하다는 것을 의미합니다.
이 지표의 계산은 응답 내에서 주장들을 식별하고, 각 주장이 검색된 컨텍스트로부터 추론 가능한지 여부를 확인하는 방식으로 이루어집니다.
이는 LLM이 제공하는 정보의 환각(hallucination) 여부를 판단하는 데 결정적인 역할을 합니다.
특히 FaithfulnesswithHHEM 옵션을 사용하면 평가의 정확도를 더욱 높일 수 있습니다.
이 고급 옵션은 Vectara의 HHEM-2.1-Open 모델을 활용하는데, 이 모델은 LLM의 환각을 탐지하기 위해 특별히 설계된 T5 분류기입니다.
이를 통해 시스템은 단순히 사실적 일치 여부를 넘어, 모델이 생성한 내용이 검색된 정보와 다르게 생성된 환각성 정보인지를 더욱 정교하게 파악할 수 있습니다.
한국어 환경에서의 활용을 예로 들자면, Ragas의 'evaluate' 함수를 통해 충실성(faithfulness) 지표를 포함한 LLM 평가를 수행할 수 있습니다.
이 과정에서는 사용자 질문, LLM 모델의 답변, 그리고 답변의 근거가 된 참고 문서, 마지막으로 정답 기준을 포함하는 데이터셋이 필수적으로 활용됩니다.
예를 들어, "대한민국 수도는 어디인가요?"라는 질문에 대해 LLM이 "대한민국의 수도는 서울입니다"라고 답변하고, 검색된 컨텍스트에 '서울은 대한민국 수도이다'라는 내용이 있다면, 높은 충실성 점수를 받게 됩니다.
만약 컨텍스트에 없는 내용을 추가하여 답변한다면, 충실성 점수는 낮아집니다.
2. Answer Relevancy (질문 적합도): 사용자 질문과의 관련성
Answer Relevancy(질문 적합도) 지표는 LLM의 응답이 사용자의 원래 질문(user input)에 얼마나 관련성이 있는지를 측정합니다.
이 지표는 응답이 원래 질문의 의도에 직접적이고 적절하게 부합하는지를 평가하며, 불완전하거나 불필요한 세부 사항에 대해서는 패널티를 부여합니다.
중요한 점은 이 지표가 응답의 사실적 정확도를 평가하지 않는다는 것입니다.
오직 사용자 질문과의 정렬도에 초점을 맞춥니다.
일반적으로 점수 범위는 0에서 1 사이이며, 점수가 높을수록 사용자 입력과 응답 간의 정렬도가 높음을 의미합니다.
다만, 코사인 유사도(cosine similarity)에 기반한 계산 방식에서는 -1에서 1 사이의 값을 가질 수도 있습니다.
질문 적합도는 주로 다음과 같은 방식으로 계산됩니다.
먼저, LLM의 응답을 기반으로 인공적인 질문을 여러 개 생성합니다(기본적으로 3개).
예를 들어, "서울은 대한민국의 수도이며, 한강이 흐르는 도시입니다"라는 답변이 있다면, 여기서 "대한민국의 수도는 어디인가?", "한강은 어느 도시에 흐르는가?"와 같은 인공 질문을 생성하는 것입니다.
그 다음, 이렇게 생성된 인공 질문의 임베딩과 사용자 입력 질문의 임베딩 사이의 코사인 유사도를 계산하여 그 평균을 산출합니다.
이 평균값이 높을수록 응답이 사용자 질문에 더 적합하다고 판단합니다.
이 과정은 LLM 응답이 질문에 대한 핵심 정보를 담고 있는지, 혹은 불필요하거나 맥락과 맞지 않는 정보를 포함하는지를 효과적으로 진단하는 데 기여합니다.
3. Context Precision (컨텍스트 정밀도): 검색기의 관련 문서 순위화 능력
Context Precision(컨텍스트 정밀도) 지표는 RAG 시스템의 검색기(retriever) 성능을 평가하는 데 초점을 맞춥니다.
이 지표는 검색기가 주어진 쿼리에 대해 검색된 컨텍스트에서 관련 청크(relevant chunks)를 비관련 청크(irrelevant chunks)보다 얼마나 더 높게 순위 매기는 능력을 가지고 있는지를 측정합니다.
즉, 사용자의 질문에 답변하는 데 필요한 정보가 담긴 문서를 얼마나 정확하고 효율적으로 찾아내어 상위에 배치했는지를 평가합니다.
이 지표의 계산은 검색된 컨텍스트 내 각 청크에 대한 precision@k의 평균을 산출하는 방식으로 이루어집니다.
여기서 'k'는 검색된 상위 k개의 문서 또는 청크를 의미합니다.
Ragas는 컨텍스트 정밀도를 평가하기 위해 다양한 유형의 지표를 제공하여, 특정 상황에 맞는 유연한 평가를 가능하게 합니다.
주요 유형은 다음과 같습니다:
| 유형 | 설명 | 주요 활용 조건 |
|---|---|---|
| ContextPrecision | 각 컨텍스트 청크를 참조 답변(reference answer)과 비교하여 관련성을 판단합니다. | 참조 답변 있을 때 |
| ContextUtilization | 참조 답변이 없는 경우에 사용되며, 검색된 각 컨텍스트 청크가 LLM이 생성한 응답에 얼마나 활용되었는지를 기반으로 평가합니다. | 참조 답변 없고 생성 응답 있을 때 |
| LLMContextPrecisionWithoutReference | LLM을 평가 도구로 활용하여, 검색된 컨텍스트의 각 청크를 생성 응답과 비교하여 관련성을 판단합니다. | 참조 답변 없음 |
| LLMContextPrecisionWithReference | 마찬가지로 LLM을 평가 도구로 사용하지만, 검색된 각 컨텍스트 청크를 참조 답변과 비교합니다. | 참조 답변 있음 |
| NonLLMContextPrecisionWithReference | LLM을 사용하지 않고, Levenshtein 거리와 같은 텍스트 유사도 측정 방법을 활용하여 retrieved_contexts를 reference_contexts와 비교합니다. | 비LLM 기반 평가, 'rapidfuzz' 라이브러리 필요 |
| IDBasedContextPrecision | retrieved_context_ids와 reference_context_ids를 직접 비교하여 컨텍스트의 관련성을 평가합니다. | ID 기반 컨텍스트 평가 |
이처럼 Context Precision은 검색기가 사용자의 질문에 가장 적합한 정보를 얼마나 잘 찾아내어 제공하는지를 다각도로 평가하며, 이는 RAG 시스템의 전반적인 성능과 사용자 경험에 직접적인 영향을 미칩니다.
이러한 지표들을 통해 개발자들은 RAG 시스템의 각 구성 요소가 얼마나 효율적으로 작동하는지 심층적으로 분석하고 개선 방향을 모색할 수 있습니다.
4. 정량 평가 도입 전 확인사항: 주요 한계점과 해결 팁
정량적 평가 지표를 도입하는 것은 LLM(Large Language Model) 애플리케이션의 품질을 객관적으로 측정하고 개선하는 데 필수적입니다. 그러나 각 평가 프레임워크가 가진 고유의 특성 때문에 도입 전 반드시 확인해야 할 주요 한계점들이 존재하며, 이를 미리 인지하고 적절한 해결책을 적용하는 것이 중요합니다.
DeepEval G-Eval 지표의 점수 일관성 문제와 해결책
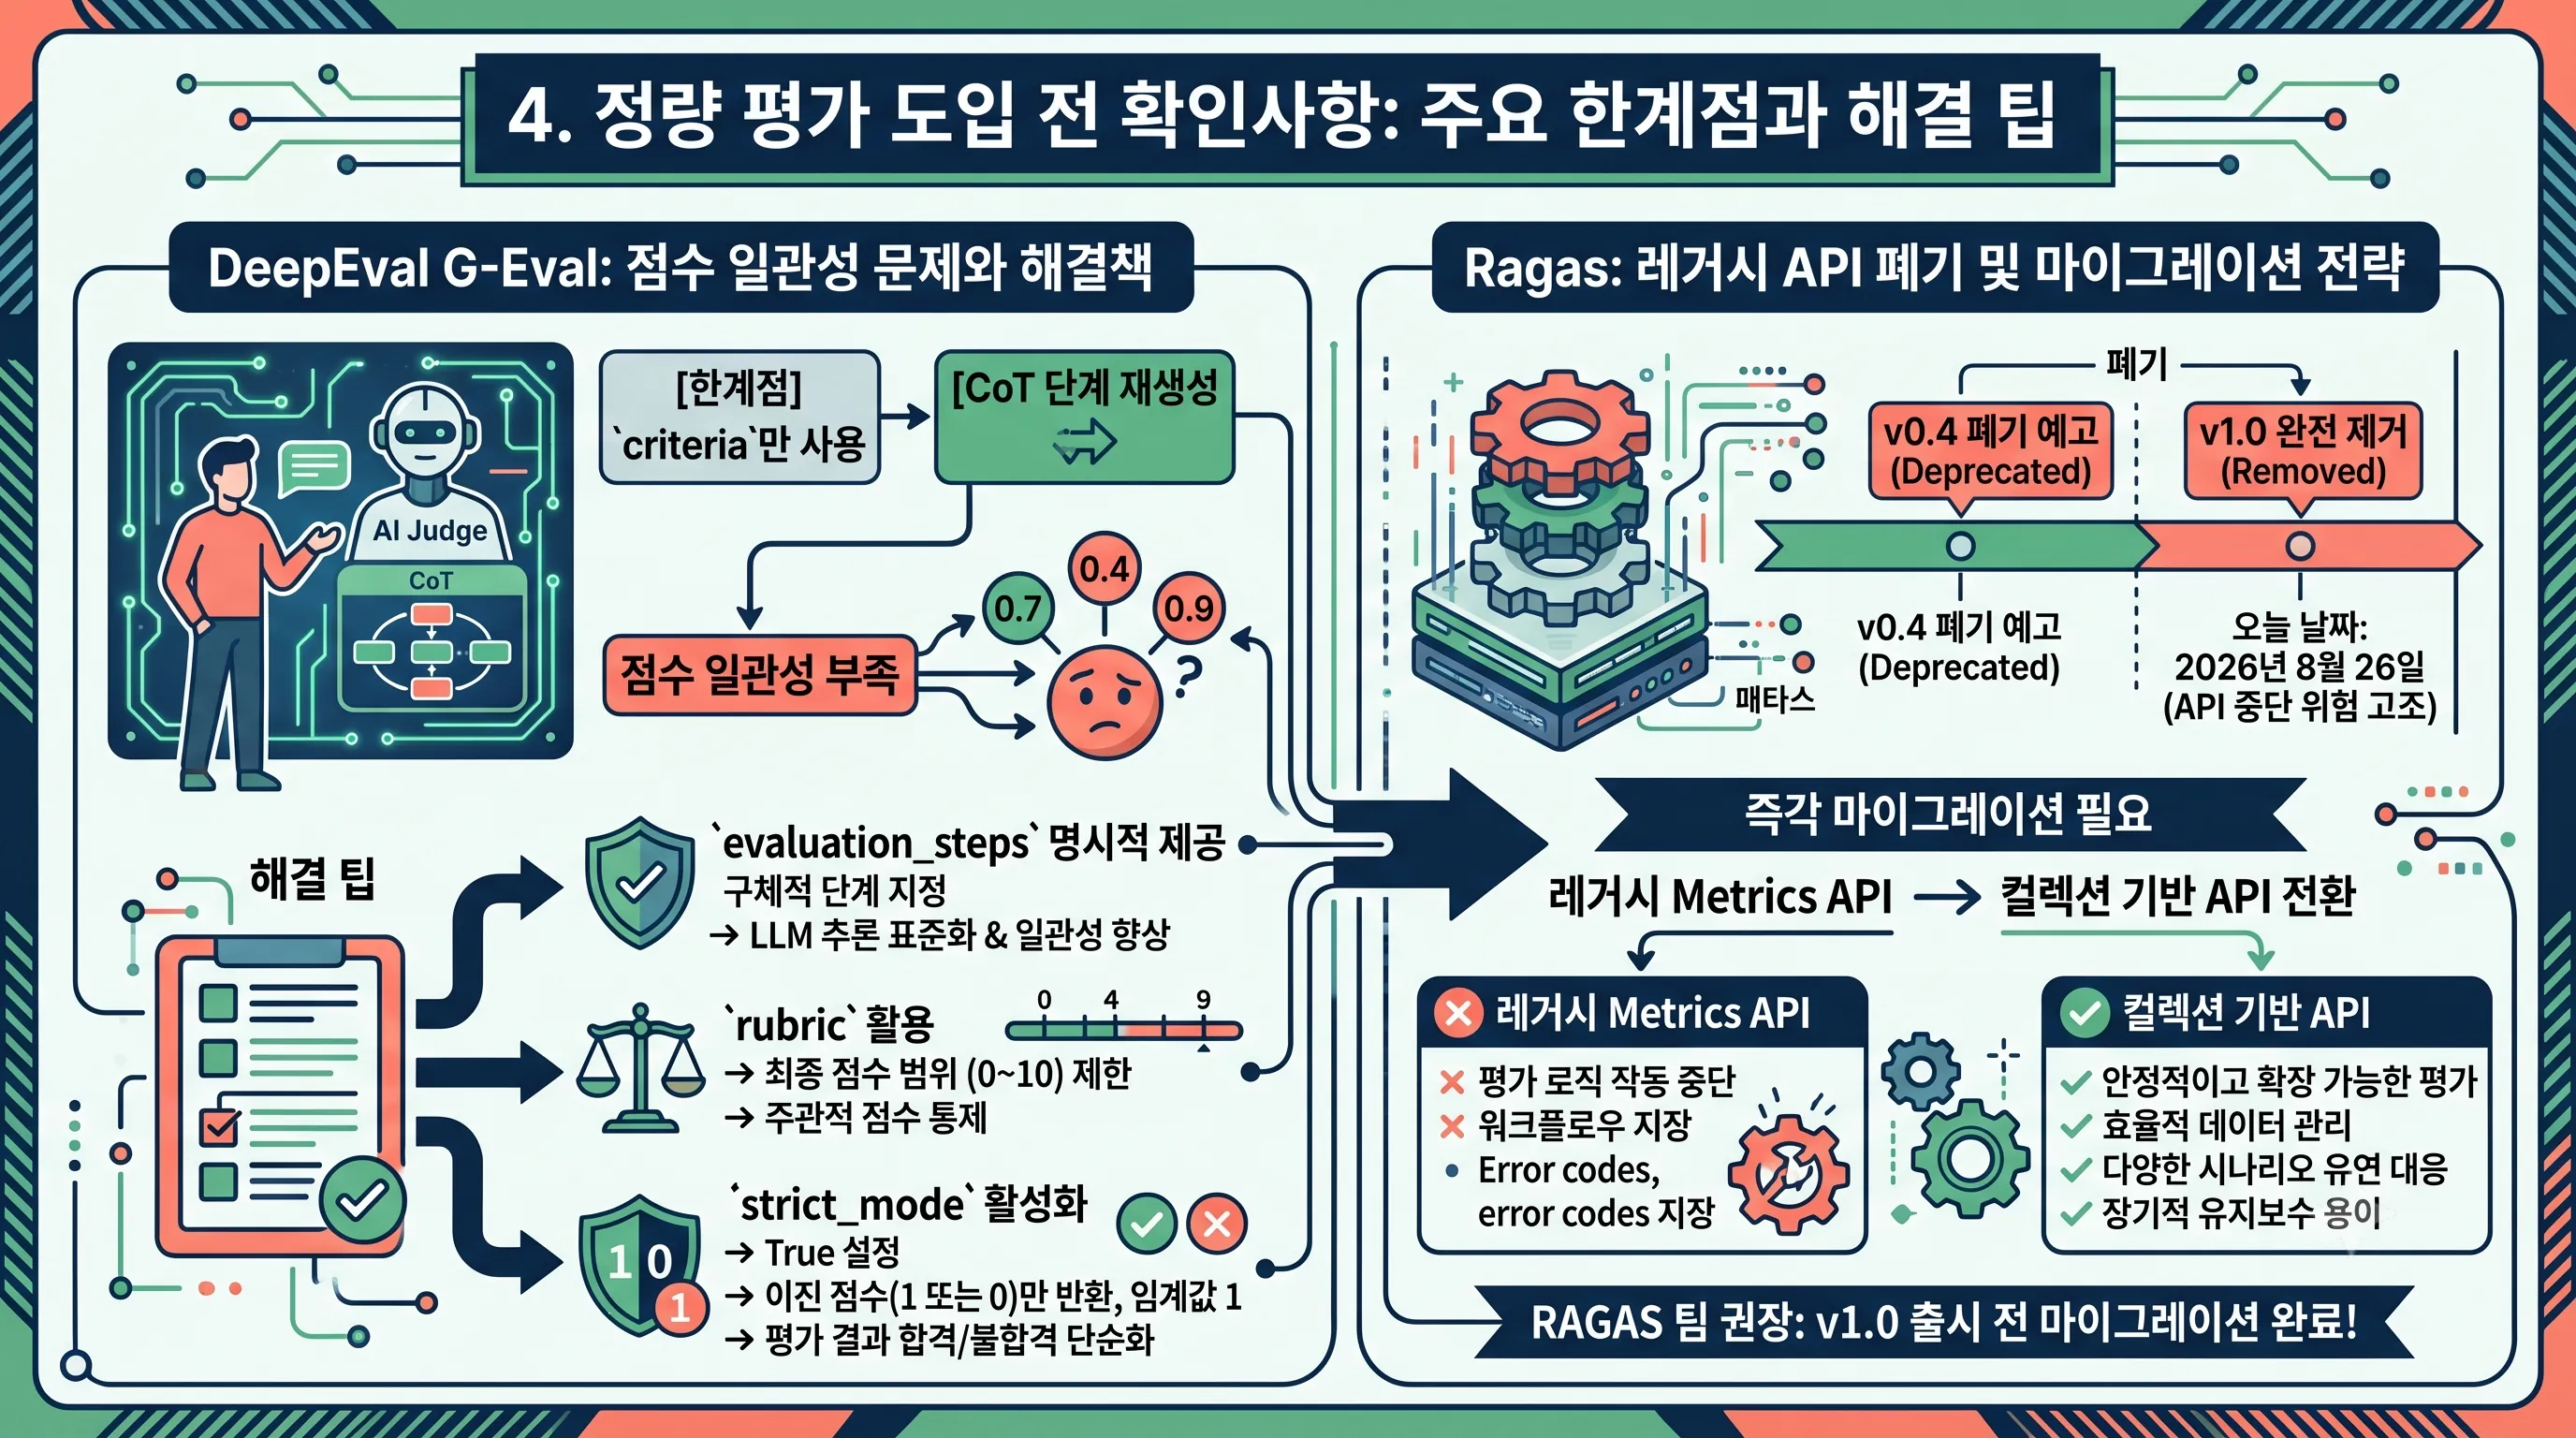
DeepEval의 G-Eval 지표는 LLM-as-a-judge와 CoT(Chain-of-Thoughts)를 활용하여 LLM 출력을 평가하는 강력하고 다재다능한 프레임워크로, 인간과 유사한 정확도를 제공합니다. 하지만 criteria 매개변수만 사용하여 평가를 수행할 경우, G-Eval 점수의 일관성 부족이라는 실용적인 한계에 직면할 수 있습니다.
이러한 점수 일관성 문제는 평가 과정에서 LLM이 따르는 CoT 단계가 실행마다 재생성되기 때문에 발생합니다. 동일한 입력에 대해서도 LLM이 매번 다른 추론 과정을 거칠 수 있으며, 이는 최종 점수의 편차로 이어질 수 있습니다. 특히 주관적인 평가 기준이 적용될 때 이러한 현상은 더욱 두드러질 수 있습니다.
이를 해결하기 위한 첫 번째 팁은 명시적인 evaluation_steps를 제공하는 것입니다. DeepEval의 G-Eval Metric은 evaluation_steps 매개변수를 통해 LLM이 평가를 수행해야 할 구체적인 단계를 명시할 수 있도록 지원합니다. 이 매개변수를 제공하지 않으면 시스템이 criteria를 기반으로 CoT 단계를 자동으로 생성하지만, 명시적으로 단계를 지정함으로써 LLM의 추론 과정을 표준화하고 평가 일관성을 크게 향상시킬 수 있습니다.
두 번째 해결책은 rubric 또는 strict_mode 매개변수를 활용하는 것입니다. rubric은 최종 지표 점수의 범위를 0에서 10 사이로 제한하여 LLM의 주관적인 점수 부여를 어느 정도 통제할 수 있도록 돕습니다. 예를 들어, 0.7이라는 점수가 LLM마다 다르게 해석될 수 있는 상황에서, rubric을 통해 점수 범위를 강제함으로써 평가의 객관성을 보완할 수 있습니다.
strict_mode를 True로 설정하는 것은 또 다른 강력한 해결책입니다. 이 모드를 활성화하면 G-Eval 지표가 이진 점수(1 또는 0)만 반환하도록 강제되며, 통과 임계값(threshold)은 자동으로 1로 재정의됩니다. 이는 미세한 점수 차이로 인한 일관성 문제를 완전히 제거하고, 평가 결과를 명확한 합격/불합격 여부로 단순화하여 극단적인 일관성을 확보하는 데 기여합니다.
Ragas 레거시 Metrics API의 폐기 예정과 마이그레이션 전략
Ragas는 LLM 애플리케이션의 성능 측정을 위한 다양한 평가 지표를 제공하는 강력한 프레임워크입니다. 그러나 Ragas 사용자들은 레거시 Metrics API의 폐기(Deprecation)와 관련된 중요한 변경 사항에 주목해야 합니다. 팩트 JSON에 따르면, 레거시 Metrics API는 버전 0.4에서 폐기(Deprecated)가 예고되었으며, 향후 버전 1.0에서는 완전히 제거될 예정입니다.
오늘 날짜인 2026년 8월 26일을 기준으로 볼 때, 버전 0.4는 이미 배포되었을 가능성이 높으며, 많은 사용자들이 현재 사용 중인 API가 조만간 지원이 중단되거나 기능이 제거될 위험에 처해 있음을 의미합니다. 이러한 변화는 기존 Ragas를 활용하여 LLM 평가 파이프라인을 구축한 사용자들에게는 즉각적인 마이그레이션 필요성을 제기합니다.
레거시 API가 제거되면, 해당 API를 사용하여 구현된 모든 평가 로직은 더 이상 작동하지 않게 됩니다. 이는 LLM 개발 및 운영 워크플로우에 심각한 지장을 초래할 수 있으므로, 컬렉션 기반 API로의 전환을 서두르는 것이 필수적입니다. Ragas 개발팀은 안정적이고 확장 가능한 평가를 위해 컬렉션 기반 API를 새로운 표준으로 제시하고 있습니다.
컬렉션 기반 API는 데이터를 더욱 효율적으로 관리하고 다양한 평가 시나리오에 유연하게 대응할 수 있도록 설계되었습니다. 마이그레이션 과정에서 기존 평가 코드의 상당 부분을 수정해야 할 수 있지만, 이는 장기적인 관점에서 더욱 안정적이고 유지보수가 용이한 평가 시스템을 구축하는 데 기여할 것입니다. 따라서 Ragas를 적극적으로 사용 중인 개발팀은 버전 1.0 출시 전에 반드시 컬렉션 기반 API로의 전환 계획을 수립하고 실행해야 합니다.
- https://deepeval.com/docs/metrics-llm-evals
- https://docs.ragas.io/en/stable/concepts/metrics/available_metrics/faithfulness/
- https://docs.ragas.io/en/stable/concepts/metrics/available_metrics/answer_relevance/
- https://docs.ragas.io/en/stable/concepts/metrics/available_metrics/context_precision/
- https://docs.ragas.io/en/stable/concepts/metrics/available_metrics/
- LLM 뜻과 특징 쉽게 이해하는 초보자 가이드
- Top LLM Testing Frameworks & Tools for QA (2026 Guide)
- Prompt Evaluation: The Complete 2026 Guide to Measuring Prompt Qu…
- Best Prompt Evaluation Tools in 2026 (Tested & Compared)
관련 글